原論文
Matching Anything by Segmenting Anything
- 発表先
- CVPR 2024国際会議
- arXiv への初回投稿
- arXiv:2406.04221
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingmasa2024,
  title = {{Matching Anything by Segmenting Anything}},
  author = {Siyuan Li and Lei Ke and Martin Danelljan and Luigi Piccinelli and Mattia Segu and Luc Van Gool and Fisher Yu},
  year = {2024},
  eprint = {2406.04221},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2406.04221}
}
2023 年前後、検出とセグメンテーションには「何でも見分けられる」基盤モデルが現れた。SAM は一枚の画像の中のあらゆるものを切り出せるし、Detic や Grounding-DINO はテキストに従って千を超えるカテゴリを検出できる。
ところが追跡は足踏みしたままだった。関連付けを学ぶ手法は、ほとんどが ID をアノテーションした動画で訓練する必要があり、そうしたデータは高くつくうえに範囲も狭い。MOT17 は歩行者だけ、BDD100K は路上の八種類のものだけだ。歩行者のデータで学んだ外観特徴は、動物やアニメのキャラクターを追わせると通用しない。
ETH チューリッヒの Siyuan Li、Lei Ke、Fisher Yu らは、関連付けも検出と同じように「何でも追える」ようにする方法を探した。彼らは動画を一切使わず、アノテーションのない写真の山だけを使った。
問題の定義
関連付けを学ぶには、「このフレームのこれと、あのフレームのあれは同じものだ」とわかっている必要がある。これが ID アノテーションで、追跡データの中で最も高くつく部分だ。
これまでにもアノテーションなしで済ませようとした人はいる。UniTrack のような手法は、自己教師ありで学んだ画像特徴をそのまま関連付けに使う。問題は、こうした特徴がたいてい ImageNet のような「一枚に主役が一つ」のデータで訓練され、画像全体の類似度を学んでいることだ。一枚に何十ものものが写る街の映像になると、どれが誰なのかをうまく見分けられない。
著者らが解こうとしたのは二つのことだ。
- 対応関係はどこから来るのか。 動画がないのに、二つのものが同じだとどうやってわかるのか?
- 既存のモデルにどうつなぐか。 検出とセグメンテーションにはすでに強力な基盤モデルがある。関連付けの能力はそこにそのまま足せるのが望ましく、もとの能力には手を触れたくない。
問題を解く
一枚の写真、二つの視点
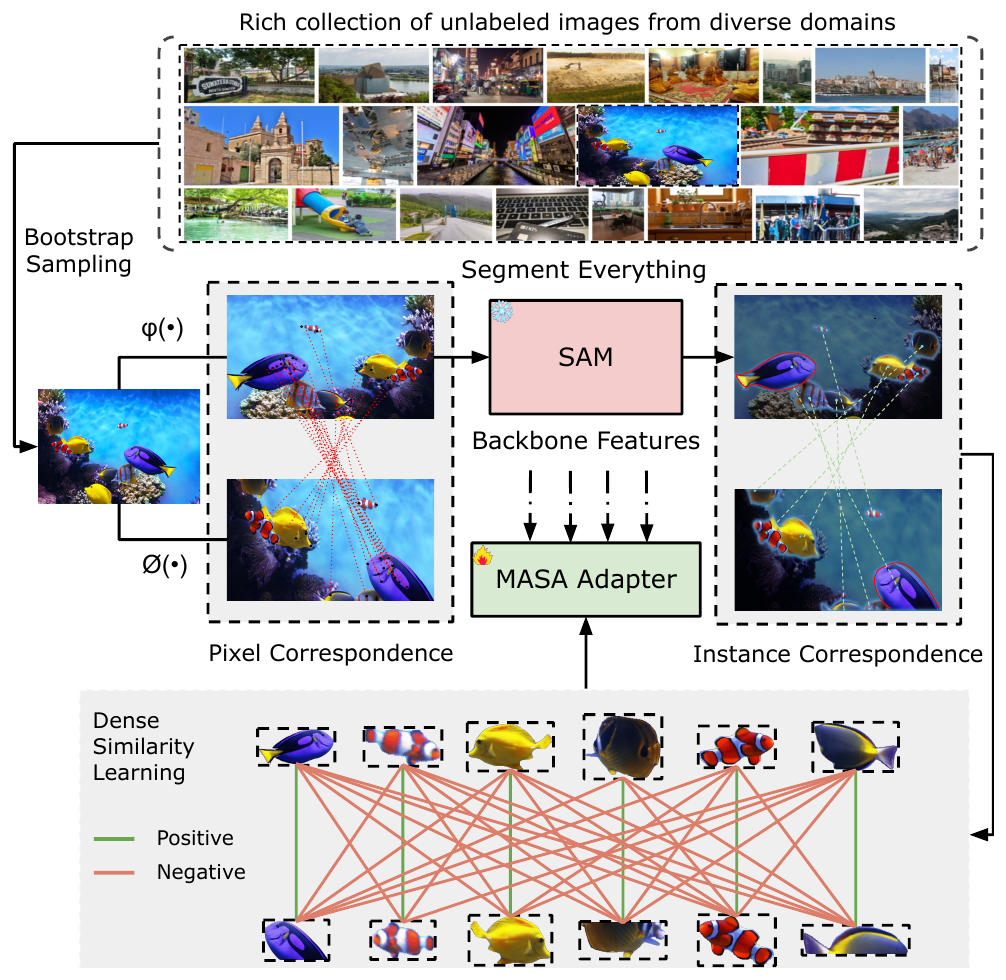
MASA は写真を一枚取り、異なる二種類の強いデータ拡張をかける。たとえば片方は拡大、平行移動、色の変更、もう片方は縮小、反転、別の画像の混ぜ込み、といった具合だ。二つの視点は見た目がずいぶん違うが、自分たちで変換したのだから、どのピクセルがどのピクセルに対応するかはわかっている。
これは、動画の中で同じ物体が二フレームのあいだに見せる変化を模している。位置が変わり、大きさが変わり、光の当たり方が変わっても、ものは同じだ。
ピクセルの対応だけでは足りず、必要なのは「物体」の対応だ。SAM は写真の中のものを一つひとつマスクとして切り出す。同じマスクの中のピクセルは同じ物体に属するので、ピクセルの対応が物体の対応に変わる。
同じ魚は近づけ、違う魚は遠ざける
物体の対応が得られれば、訓練は標準的な対照学習になる。同じ物体の二つの視点での特徴は正例で、引き寄せる。ほかのすべての物体とは負例で、押し離す。
はコサイン類似度で、温度は だ。
ここでの SAM の価値は負例にある。複雑な写真なら SAM は百を超える物体を切り出せ、各物体はほかの物体の負例になる。温度がこれほど低いと、いちばん似ている負例のいくつかが損失を支配する。数字で確かめてみよう。
| 状況 | 正例の類似度 | 負例の類似度 | 損失 |
|---|---|---|---|
| 負例がどれも似ていない | 0.80 | 0.30、0.20、0.10 | 0.001 |
| よく似た負例が一つある | 0.80 | 0.75、0.20、0.10 | 0.40 |
本稿で整理した計算例。
負例を一つ「よく似た別の魚」に替えただけで、損失は 400 倍近くに膨らむ。モデルは似た物体を見分けられる細部を学ばざるをえない。追跡で最も難しいのは、まさによく似たものを見分けることだ。
基盤モデルの後ろにつなぐアダプター
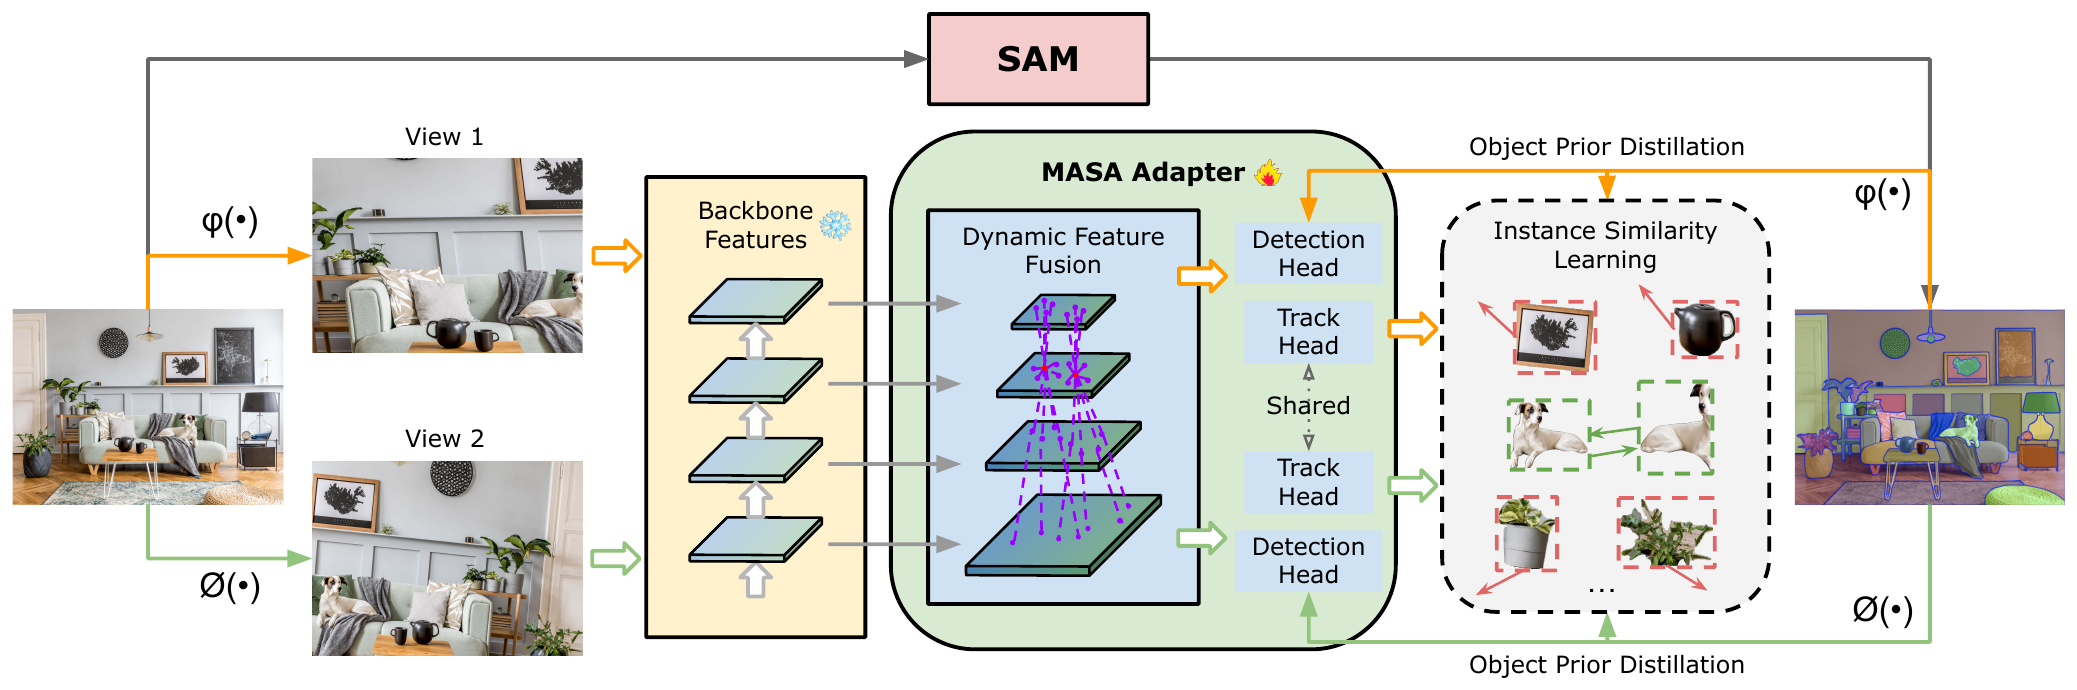
学んだ関連付けの能力は、どんな検出モデルやセグメンテーションモデルにも足せなければならない。著者らは MASA アダプターを設計し、凍結したバックボーンの後ろにつないだ。バックボーンに手を触れないので、もとの検出やセグメンテーションの能力は影響を受けない。
アダプターがやることは三つある。
- 特徴ピラミッドを作る。 Swin Transformer はもともと多スケールの特徴を持っているので、そのまま FPN をつなぐ。SAM の ViT は単一スケールしかないので、転置畳み込みとプーリングで四つのスケールを作り出す。
- 動的特徴融合。 変形可能畳み込みで、位置とスケールをまたいで情報を集約する。著者らの理屈では、異なる物体を見分けるには、各位置の特徴がほかの場所の様子も知っているほうがいい。
- 追跡ヘッド。 物体のボックスに従って RoI-Align で特徴を取り出し、4 層の畳み込みと 1 層の全結合を経て、物体ごとの埋め込みベクトルを出力する。
訓練時には補助タスクがもう一つある。検出ヘッドが、SAM のマスクの外接ボックスを予測するよう学ぶ。これは、「何を一つの物体とみなすか」についての SAM の知識を、アダプターの特徴に蒸留するのに等しい。
推論時の二つの使い方
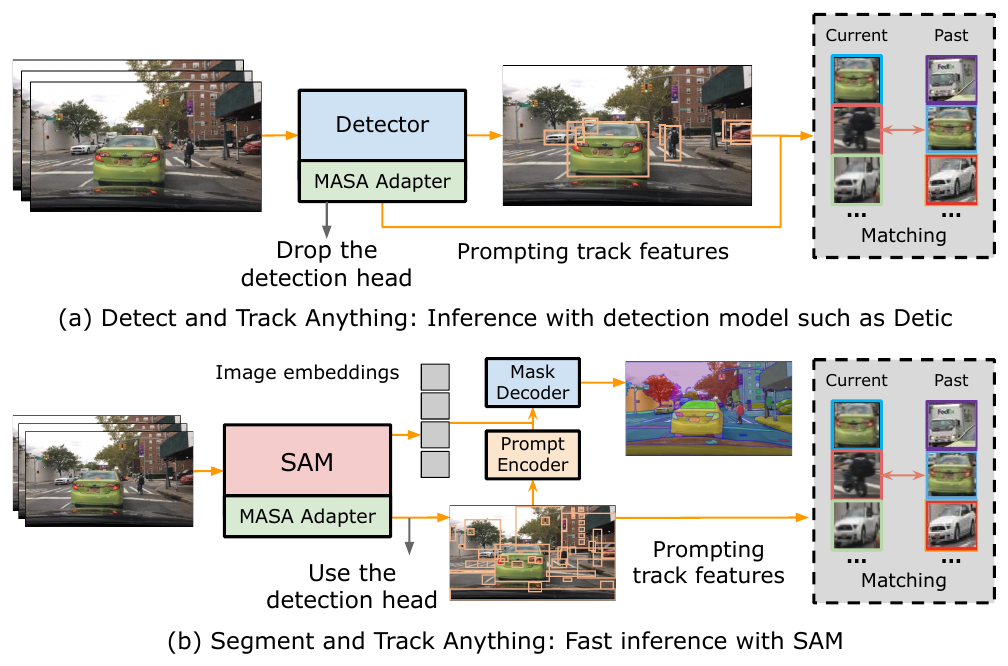
検出器につなぐときは、訓練用の検出ヘッドは捨ててしまう。検出器がどんなボックスを出しても、アダプターはそのボックスに対して追跡特徴を作る。
SAM につなぐときは、逆に検出ヘッドが役に立つ。SAM はもともと「すべてを切り出す」ために、画面に約千個の点をばらまいてプロンプトにし、さらに面倒な後処理をしなければならない。MASA の検出ヘッドは物体のボックスを直接プロンプトとして出す。著者らが UVO で測ったところ、同じ再現率に達するのに、速度はおよそ 10 倍速かった。
マッチングは QDTrack 系列の双方向 softmax を踏襲する。ある物体とある軌跡のスコアは、「この軌跡のすべての候補」と「この物体のすべての軌跡」の両方向で同時に高くなければ、マッチしたとはみなされない。そのうえでコサイン類似度と平均を取る。
訓練データは SA-1B から抜き出した 50 万枚の写真だ。すべてのベンチマークで同じ一組の重みを使い、どのテスト領域でも訓練していない。つまりゼロショットの関連付けだ。
議論
領域内で訓練した手法と比べる
関連付けの能力だけを比べるために、著者らは各ベンチマークで当時最強の手法と同じ検出結果を使っている。
| ベンチマーク | 相手(領域内訓練) | 相手 AssocA | MASA AssocA |
|---|---|---|---|
| TAO TETA | TETer | 36.7 | 37.6 |
| BDD MOTS | UNINEXT-H | 53.2 | 54.5 |
| BDD MOT | ByteTrack | 51.5 | 52.9 |
TAO は原論文 Table 1、BDD MOTS は原論文 Table 4、BDD MOT は原論文 Table 5 をもとに整理。いずれも検証セット。MASA は表内で最良の変種を取った。
これらの相手はどれもそれぞれの領域で完全な動画アノテーションを使っている。MASA は TAO や BDD の画像を一枚も見ていないのに、関連付けのスコアはわずかに高い。差は大きくないが、向きは一貫している。
BDD MOT の mMOTA は、ByteTrack が 45.5、MASA が約 44.5 だ。ByteTrack は低スコアのボックスも軌跡につなぐので、検出寄りの指標に有利になる。
同じ検出を与えず、Detic につないだ MASA に自分で検出させ、自分で追跡させると、TAO の TETA は 46.3 で、表内のほかの手法の 34.6 を大きく上回る。この部分はおもに Detic 自身の検出能力から来ていて、MASA はそれをそのまま追跡に使えるようにしている。
見たことのないカテゴリ
オープンボキャブラリ追跡のベンチマークでは、よく見るカテゴリのアノテーションだけで訓練することが許され、まれなカテゴリは「新規カテゴリ」としてテストされる。Detic につないだ MASA は、新規カテゴリで TETA 40.8、AssocA 41.2 で、このタスク専用に設計された OVTrack は 32.0 と 33.2 だ。
各設計の寄与
アブレーションは BDD と COCO の元の写真で訓練し、BDD MOT でテストする。
| 設定 | AssocA | mIDF1 |
|---|---|---|
| SAM の特徴をそのまま使う | 32.9 | 37.3 |
| +MASA の訓練と追跡ヘッド | 48.5 | 51.7 |
| +動的特徴融合 | 50.1 | 53.3 |
| +物体事前知識の蒸留 | 51.9 | 54.9 |
原論文 Table 8 をもとに整理。BDD MOT 検証セット。
SAM のもとの特徴はセグメンテーションのために最適化されたもので、そのまま個体の識別に使うと AssocA は 32.9 しかない。MASA の訓練方式を加えたとたん、15.6 増える。これが論文全体で最大の伸びだ。
ほかのいくつかのアブレーションも、前の分析と呼応している。
- 提案の出どころ。 SAM を COCO で訓練した Mask2Former に替えると、TAO の AssocA は 34.1 から 29.8 に落ちる。SAM のほうが細かく、多様に切り出すので、より良い負例を提供する。
- 提案の数。 バッチごとの物体の上限を 64 から 256 に増やすと、TAO の AssocA は 31.5 から 35.8 に上がる。
- データ拡張の強さ。 反転や切り抜きのような基本的なデータ拡張だけだと、BDD の mIDF1 は 48.2 だ。ランダムなアフィン変換、MixUp、大きなスケールのジッターを加えると 54.9 に上がる。写真を十分に変化させてはじめて、動画の中の変化を模せる。
ほかの自己教師あり手法と比べると、同じ BDD、COCO の写真で訓練して、BDD MOT の AssocA は MoCo v2 が 42.7、DINO はわずか 23.1、MASA は 51.9 だ。これらの手法が学ぶのは画像全体の類似度で、物体が多い場面は得意ではない。
限界
付録で著者らは二つの点を挙げている。第一に、基盤モデルの検出は隣り合うフレームのあいだで一貫するとは限らない。このフレームで切り出されたものが次のフレームでは消えていることがあり、追跡結果がちらつく。MASA が担うのは関連付けだけで、検出の誤りは直せない。第二に、MASA には長期記憶がなく、各物体の埋め込みを入れておくキューが一つあるだけなので、ひどい遮蔽のときに失敗しやすい。
結論
MASA は、追跡の関連付けを学ぶのに動画は必ずしも要らず、ID アノテーションはなおさら要らないことを示した。一枚の写真に二回変換をかけ、SAM の助けでピクセルの対応を物体の対応に格上げすれば、対照学習には大量の正例と負例がそろう。
アダプターの設計のおかげで、この能力は SAM、Detic、Grounding-DINO といった基盤モデルにつなげられ、それらのもとの検出やセグメンテーションには手を触れない。TAO や BDD のように一度も見たことのない領域で、ゼロショットの関連付けのスコアが、領域内で完全なアノテーションを使って訓練した手法をわずかに上回る。
検出の不安定さと長すぎる遮蔽、この二つについては、相変わらず前段の基盤モデルと単純なキュー一つに任せている。もっと長く追いたければ、記憶を別に補う必要がある。