原始論文
Matching Anything by Segmenting Anything
- 發表版本
- CVPR 2024會議
- arXiv 首次提交
- arXiv:2406.04221
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingmasa2024,
  title = {{Matching Anything by Segmenting Anything}},
  author = {Siyuan Li and Lei Ke and Martin Danelljan and Luigi Piccinelli and Mattia Segu and Luc Van Gool and Fisher Yu},
  year = {2024},
  eprint = {2406.04221},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2406.04221}
}
2023 年前後,偵測和分割有了「什麼都認得」的基礎模型。SAM 能把一張圖裡所有東西都切出來;Detic、Grounding-DINO 能依文字偵測上千種類別。
追蹤卻還停在原地。學關聯的方法,幾乎都要用標好 ID 的影片來訓練,而這種資料很貴,也很窄:MOT17 只有行人,BDD100K 只有路上的八類東西。在行人資料上學到的外觀特徵,拿去追動物、追卡通人物,就不靈了。
ETH 蘇黎世的 Siyuan Li、Lei Ke、Fisher Yu 等人想找一個辦法,讓關聯也能像偵測一樣「什麼都追得了」。他們完全不用影片,只用一堆沒有標註的照片。
定義問題
學關聯,需要知道「這一幀的這個東西,和那一幀的那個東西,是同一個」。這就是 ID 標註,是追蹤資料裡最貴的部分。
過去也有人試過不用標註。UniTrack 這類方法,直接拿自監督學到的影像特徵來做關聯。問題是這些特徵通常在 ImageNet 這種「一張圖一個主角」的資料上訓練,學的是整張圖的相似度。到了一張圖裡有幾十個東西的街景,它們分不太清楚誰是誰。
作者要解決的是兩件事:
- 對應關係從哪裡來。 沒有影片,怎麼知道兩個東西是同一個?
- 怎麼接到現有的模型上。 偵測和分割已經有很強的基礎模型,關聯的能力最好能直接加上去,不要動到它們原本的能力。
解決問題
一張照片,兩個視角
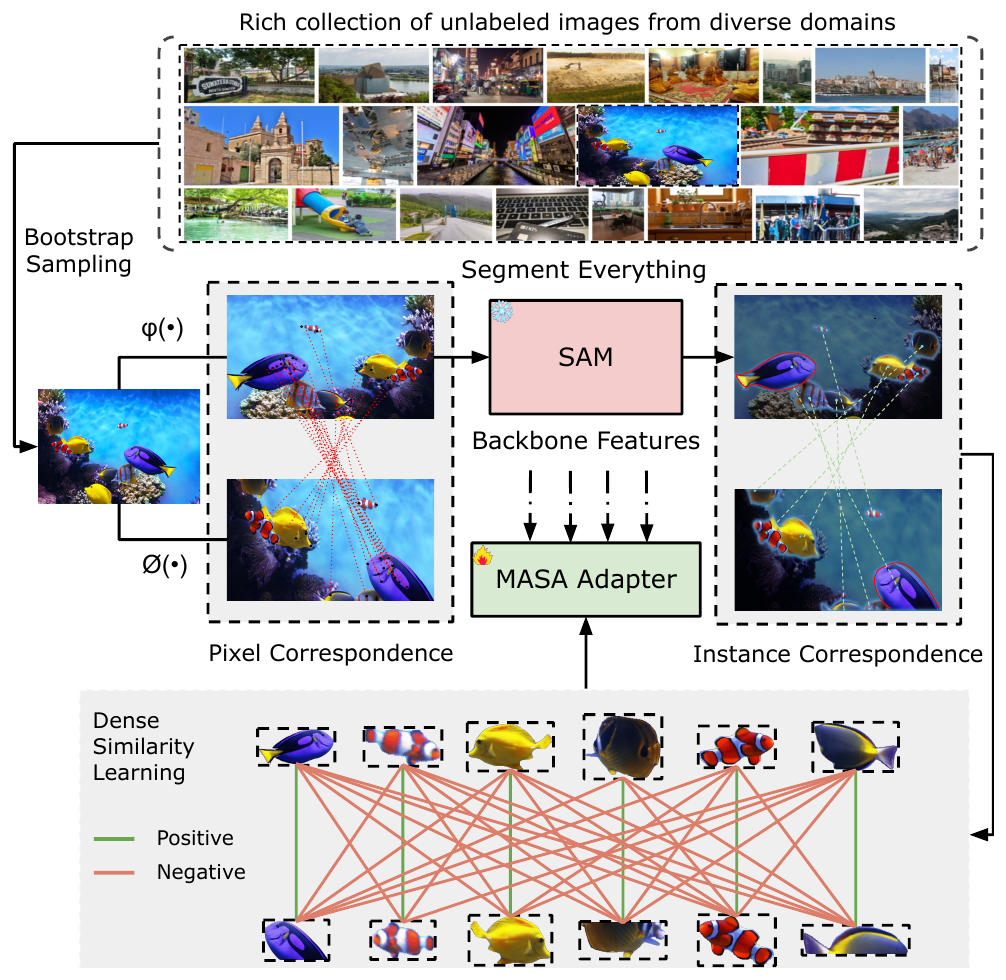
MASA 拿一張照片,做兩種不同的強增強,例如一邊放大、平移、改顏色,另一邊縮小、翻轉、加別的圖混進來。兩個視角看起來差很多,但因為是我們自己變換的,哪個像素對到哪個像素都知道。
這模擬的是影片裡同一個物體在兩幀之間的變化:位置變了、大小變了、光線變了,東西還是同一個。
光有像素對應還不夠,要的是「物體」的對應。SAM 會把照片裡的每個東西都切成一塊遮罩。同一塊遮罩裡的像素屬於同一個物體,像素對應就變成了物體對應。
讓同一隻魚靠近,不同的魚遠離
有了物體對應,訓練就是標準的對比學習。同一個物體在兩個視角的特徵是正樣本,要拉近;和其他所有物體都是負樣本,要推遠:
是餘弦相似度,溫度 。
這裡 SAM 的價值在於負樣本。一張複雜的照片,SAM 可以切出上百個物體,每個物體都是其他物體的負樣本。溫度這麼低,最像的那幾個負樣本會主導損失,用幾個數字算算看。
| 情況 | 正樣本相似度 | 負樣本相似度 | 損失 |
|---|---|---|---|
| 負樣本都不像 | 0.80 | 0.30、0.20、0.10 | 0.001 |
| 有一個很像的 | 0.80 | 0.75、0.20、0.10 | 0.40 |
本文整理的算例。
只把一個負樣本換成「長得很像的另一隻魚」,損失就大了將近 400 倍。模型被迫去學那些能分辨相似物體的細節。追蹤最難的,正是分辨長得很像的東西。
接在基礎模型後面的轉接器
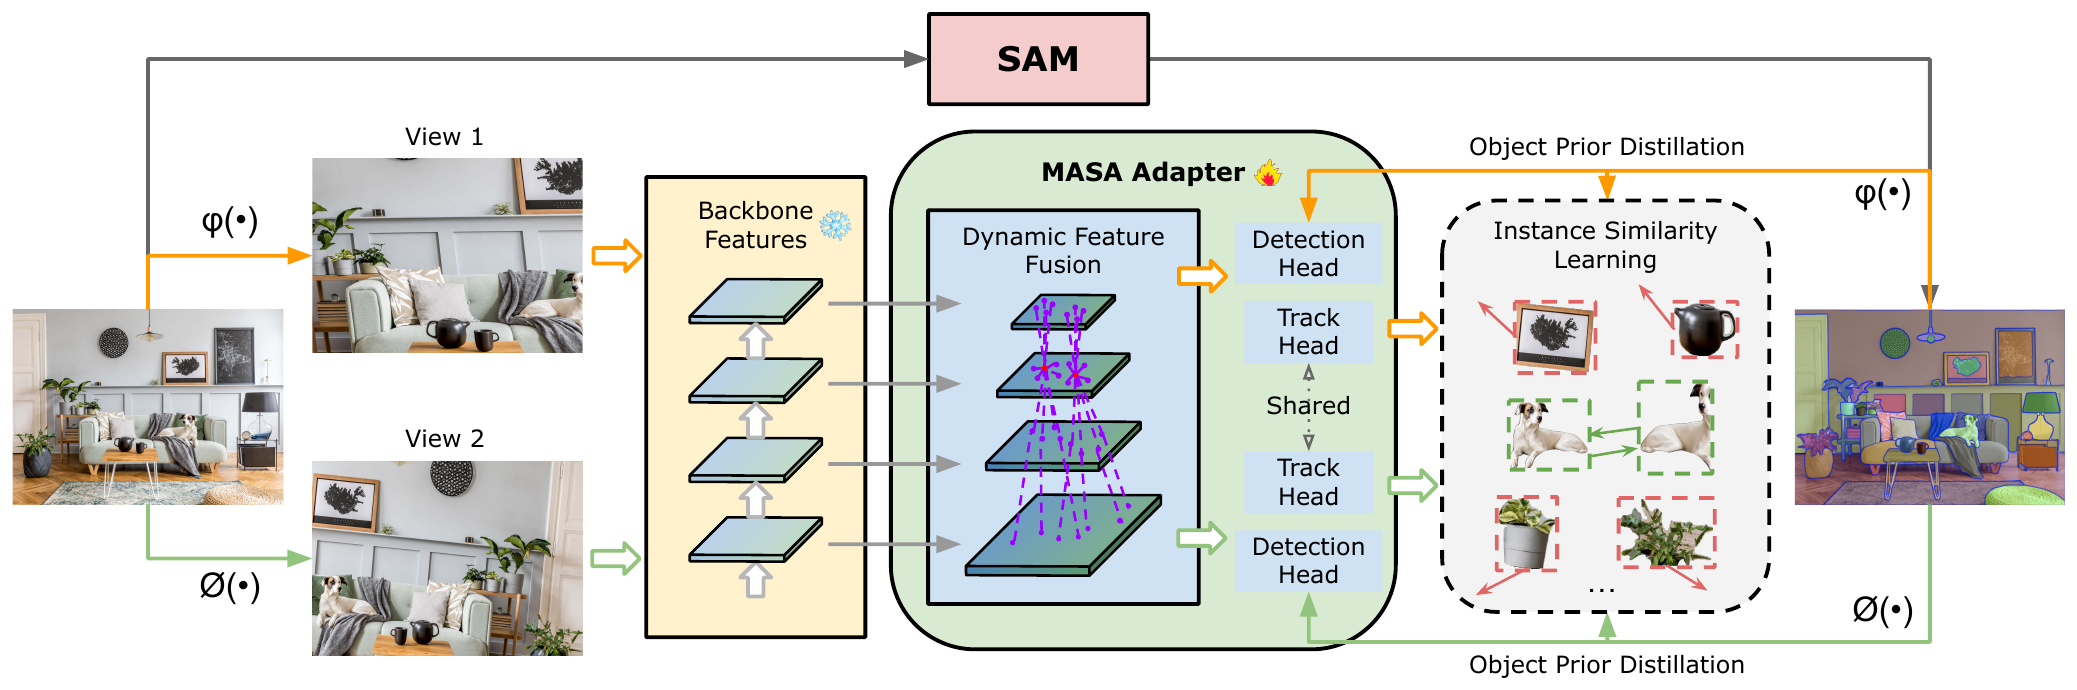
學到的關聯能力,要能加到任何偵測或分割模型上。作者設計了一個 MASA 轉接器,接在凍結的骨幹網路後面。骨幹不動,原本的偵測、分割能力就不受影響。
轉接器做三件事:
- 建特徵金字塔。 Swin Transformer 本身有多尺度特徵,直接接 FPN;SAM 的 ViT 只有單一尺度,就用轉置卷積和池化造出四個尺度。
- 動態特徵融合。 用可變形卷積跨位置、跨尺度聚合資訊。作者的理由是,要分辨不同的物體,每個位置的特徵最好也知道別的地方長什麼樣子。
- 追蹤頭。 依物體框用 RoI-Align 取出特徵,經過 4 層卷積和 1 層全連接,輸出每個物體的嵌入向量。
訓練時還有一個輔助任務:一個偵測頭,學著預測 SAM 遮罩的外框。這等於把 SAM 對「什麼算一個物體」的知識,蒸餾到轉接器的特徵裡。
推論時的兩種用法
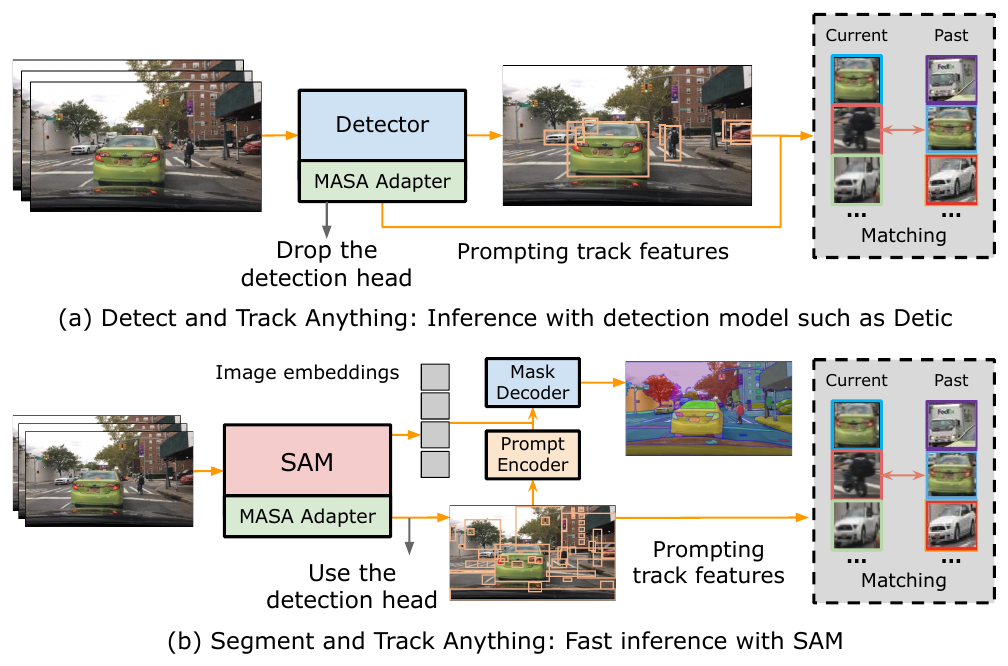
接偵測器的時候,訓練用的偵測頭就丟掉,偵測器給什麼框,轉接器就為那些框產生追蹤特徵。
接 SAM 的時候,偵測頭反而派上用場。SAM 原本要「切出所有東西」,得在畫面上撒大約一千個點當提示,再做繁瑣的後處理。MASA 的偵測頭直接給出物體框當提示,作者在 UVO 上量到,達到同樣的召回率,速度大約快 10 倍。
匹配的方式沿用 QDTrack 系列的雙向 softmax:一個物體和一條軌跡的分數,要同時在「這條軌跡的所有候選」和「這個物體的所有軌跡」兩個方向都高,才算配得上;再和餘弦相似度平均。
訓練資料是從 SA-1B 抽出的 50 萬張照片。所有基準測試用的都是同一組權重,沒有在任何一個測試領域上訓練過,也就是零樣本關聯。
討論
和領域內訓練的方法比
為了只比較關聯能力,作者在每個基準上都使用和當時最強方法相同的偵測結果:
| 基準 | 對手(領域內訓練) | 對手 AssocA | MASA AssocA |
|---|---|---|---|
| TAO TETA | TETer | 36.7 | 37.6 |
| BDD MOTS | UNINEXT-H | 53.2 | 54.5 |
| BDD MOT | ByteTrack | 51.5 | 52.9 |
TAO 整理自原論文 Table 1,BDD MOTS 整理自原論文 Table 4,BDD MOT 整理自原論文 Table 5,皆為驗證集;MASA 各取表中最佳的變體。
這些對手都在各自的領域裡用了完整的影片標註,MASA 一張 TAO、BDD 的圖都沒看過,關聯的分數還是略高。差距不大,但方向一致。
BDD MOT 上的 mMOTA,ByteTrack 是 45.5,MASA 約 44.5。ByteTrack 會把低分框也接進軌跡,這對偵測導向的指標有利。
如果不給相同的偵測,讓接上 Detic 的 MASA 自己偵測、自己追蹤,在 TAO 上的 TETA 是 46.3,遠高於表中其他方法的 34.6。這部分主要來自 Detic 本身的偵測能力,MASA 讓它可以直接拿來追蹤。
沒看過的類別
開放詞彙追蹤的基準只允許用常見類別的標註訓練,罕見類別當作「新類別」來測。MASA 接 Detic,新類別的 TETA 是 40.8、AssocA 41.2,專為這個任務設計的 OVTrack 是 32.0 和 33.2。
每個設計的貢獻
消融用 BDD 和 COCO 的原始照片訓練,在 BDD MOT 上測:
| 設定 | AssocA | mIDF1 |
|---|---|---|
| 直接用 SAM 的特徵 | 32.9 | 37.3 |
| +MASA 訓練與追蹤頭 | 48.5 | 51.7 |
| +動態特徵融合 | 50.1 | 53.3 |
| +物體先驗蒸餾 | 51.9 | 54.9 |
整理自原論文 Table 8,BDD MOT 驗證集。
SAM 原本的特徵是為了分割最佳化的,直接拿來分辨個體,AssocA 只有 32.9。MASA 的訓練方式一加上去,就多了 15.6,這是整篇論文最大的一筆。
其他幾個消融也呼應前面的分析:
- 提案來源。 把 SAM 換成在 COCO 上訓練的 Mask2Former,TAO 的 AssocA 從 34.1 掉到 29.8。SAM 切得更細、更多樣,提供的負樣本更好。
- 提案數量。 每批的物體上限從 64 增加到 256,TAO 的 AssocA 從 31.5 升到 35.8。
- 增強強度。 只用翻轉、裁切這類基本增強,BDD 的 mIDF1 是 48.2;加上隨機仿射、MixUp 和大尺度抖動,升到 54.9。照片要變得夠多,才模擬得出影片裡的變化。
和其他自監督方法比,在同樣的 BDD、COCO 照片上訓練,MoCo v2 的 BDD MOT AssocA 是 42.7,DINO 只有 23.1,MASA 是 51.9。這些方法學的是整張圖的相似度,不擅長多物體的場景。
限制
附錄裡作者列了兩點。第一,基礎模型在相鄰幀之間的偵測不一定一致,這一幀切出來的東西,下一幀可能就不見了,追蹤結果會閃爍;MASA 只管關聯,修不了偵測的錯。第二,MASA 沒有長期記憶,只有一個存放每個物體嵌入的佇列,嚴重遮擋時容易失敗。
結論
MASA 證明了學追蹤的關聯不一定要影片,更不一定要 ID 標註。一張照片做兩次變換,SAM 幫忙把像素對應升級成物體對應,對比學習就有了大量的正負樣本。
轉接器的設計,讓這個能力可以接到 SAM、Detic、Grounding-DINO 這些基礎模型上,不動它們原本的偵測和分割。在 TAO、BDD 這些它從沒見過的領域,零樣本的關聯分數還略高於在領域內用完整標註訓練的方法。
至於偵測不穩、遮擋太久這兩件事,它還是交給前端的基礎模型和一個簡單的佇列處理;要追得更久,還得另外補上記憶。