原始論文
MambaMOT: State-Space Model as Motion Predictor for Multi-Object Tracking
- 發表版本
- ICASSP 2025會議
- arXiv 首次提交
- arXiv:2403.10826
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingmambamot2024,
  title = {{MambaMOT: State-Space Model as Motion Predictor for Multi-Object Tracking}},
  author = {Hsiang-Wei Huang and Cheng-Yen Yang and Wenhao Chai and Zhongyu Jiang and Jenq-Neng Hwang},
  year = {2024},
  eprint = {2403.10826},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.10826}
}
2023 年底,Mamba 以「選擇性狀態空間模型」的身分登場,在長序列上和 Transformer 分庭抗禮,計算量卻只隨序列長度線性增長。接下來的幾個月,各個領域都有人試著把它搬進來。
多目標追蹤裡,最適合放序列模型的位置,是運動預測。給定一條軌跡過去幾幀的框,預測下一幀的框,這本來就是一個序列問題,從 SORT 以來一直由卡爾曼濾波負責。
華盛頓大學的 Hsiang-Wei Huang、Jenq-Neng Hwang 等人做的,就是把卡爾曼濾波換成 Mamba。論文只有四頁,想法也很直接,但它剛好可以拿來和早不到兩週出現的 DiffMOT 對照:同一個問題,一個用擴散模型,一個用狀態空間模型。
定義問題
卡爾曼濾波假設物體在短時間內等速直線前進。行人大致符合這個假設,舞者和球員就不行了。
OC-SORT 曾經分析過卡爾曼濾波在這類場景的兩個弱點。一是對狀態雜訊敏感:速度的估計只要有一點偏差,物體幾幀沒被偵測到,預測位置就會偏得很遠。二是誤差會隨時間放大:沒有新觀測的時候,卡爾曼濾波只能沿著舊的速度一直推下去。
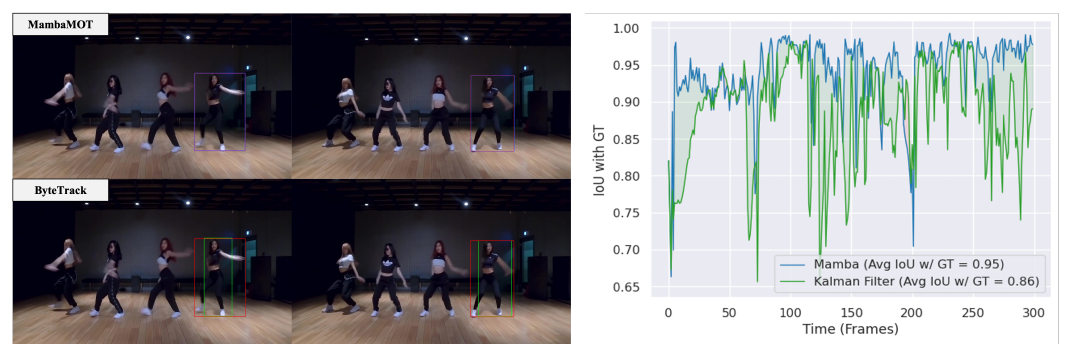
右邊的曲線很能說明問題。卡爾曼濾波大部分時候也預測得不錯,但每當舞者突然改變動作,綠線就往下掉,有好幾次掉到 0.75 以下。對 IoU 關聯來說,這種突然的失準就是軌跡斷掉的時候。
作者的想法是,與其假設運動是線性的,不如讓模型從資料學:舞者通常怎麼動、球員通常怎麼動。
解決問題
用 Mamba 預測下一個框
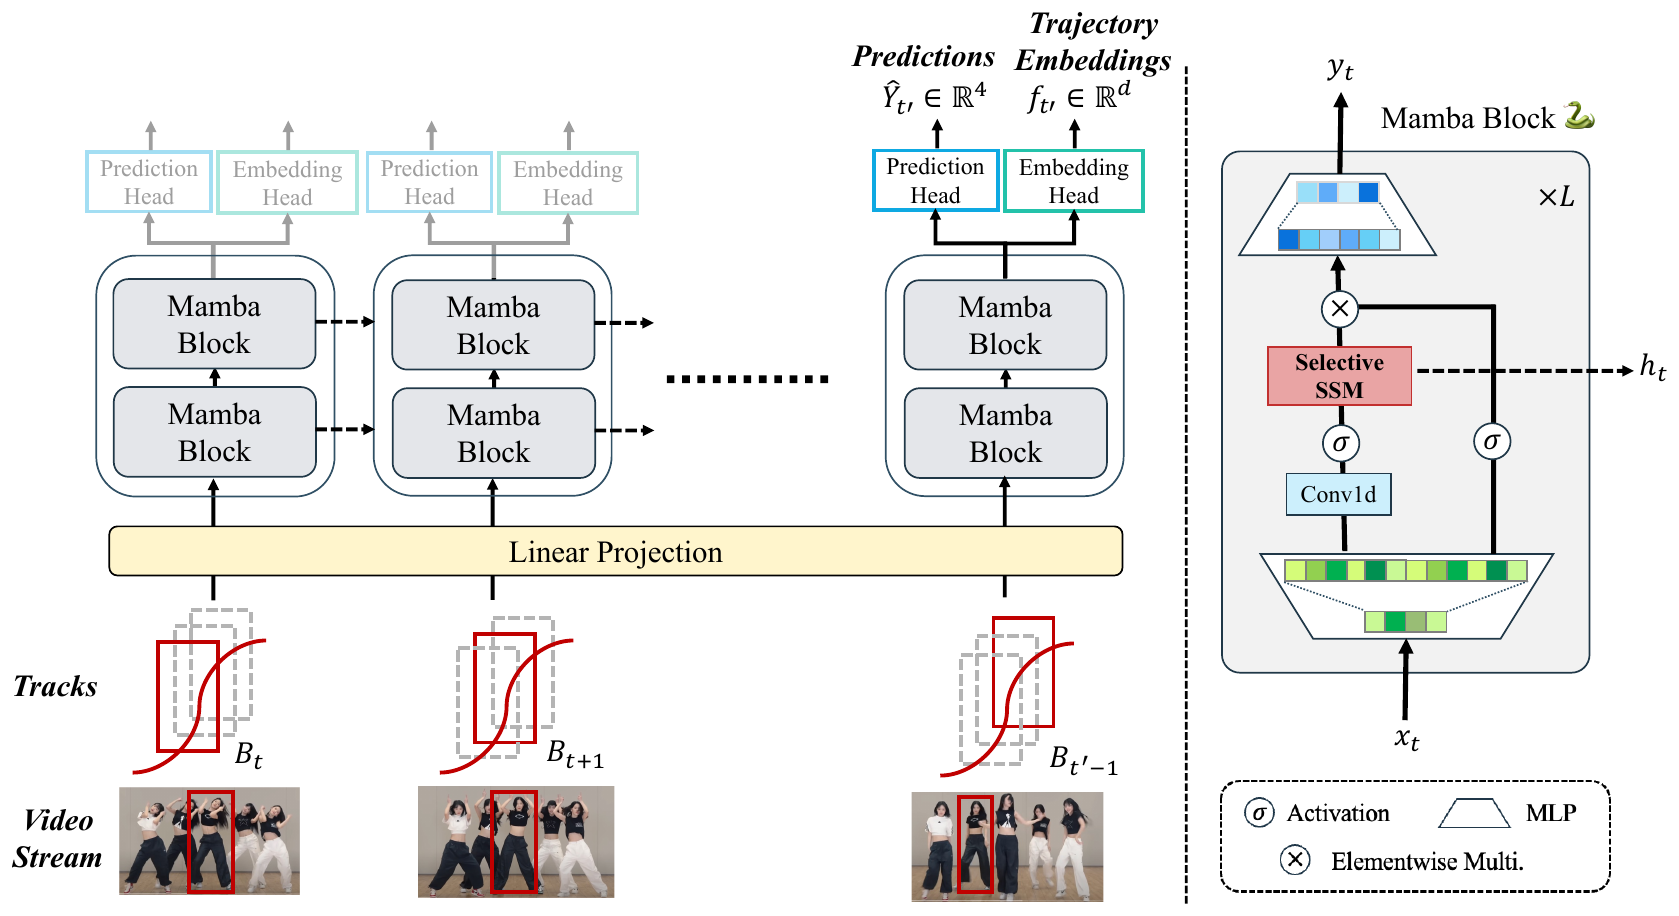
MambaMOT 的運動模型很小。輸入是一條軌跡過去 幀的框,每個框四個數字;先用一層線性投影升到 64 維,經過兩個 Mamba 區塊,最後一個 MLP 輸出下一幀的框。訓練的損失是預測框和真值框之間的 GIoU 加上均方誤差。
關聯完全沿用 ByteTrack:高分框先和預測框用 IoU 配對,剩下的軌跡再和低分框配一次。所以 MambaMOT 和 ByteTrack 的差別,只有運動模型這一個元件。
選擇性是什麼意思
Mamba 的核心是一個遞迴:
隱藏狀態 是過去所有輸入的摘要,每來一個新輸入,就決定舊的摘要留多少、新的輸入收多少。
傳統的狀態空間模型裡,、 是固定的,每一步留多少、收多少都一樣。Mamba 讓它們隨著輸入改變,所以叫「選擇性」。論文裡把這兩個量寫成 和 ,兩者加起來剛好是 1。
把這個式子簡化成一維,就看得出它在運動預測上的意義。令 ,遞迴就變成:
這是一個指數移動平均,只是平滑係數 由輸入決定。
一個轉身的例子
我們把輸入簡化成舞者每一幀的水平速度。前幾幀她一直往右,每幀 10 像素,記憶裡的 。這一幀她突然轉身,速度變成 。
| 做法 | 平滑係數 | 更新後的記憶 | 預測的方向 |
|---|---|---|---|
| 固定係數 | 0.2 | 仍然往右 | |
| 選擇性 | 0.8 | 改往左 |
本文整理的算例;實際模型的隱藏狀態是高維向量,輸出還要經過 MLP。
固定係數的模型,對每個輸入一視同仁,舊的趨勢要好幾幀才會被新資訊蓋過去。選擇性的模型可以學到:看到這種輸入時,舊的趨勢不可信,要大幅採納新的觀測。
卡爾曼濾波其實也會依觀測調整,但它的調整幅度由事先設定的雜訊參數決定,而且背後永遠是等速模型。Mamba 的調整方式則是從資料學來的。
MambaMOT+:順便學一個軌跡特徵
Mamba 的隱藏狀態既然記住了整條軌跡的運動模式,作者想進一步利用它。MambaMOT+ 在 Mamba 區塊的輸出上多接一個嵌入頭,輸出這條軌跡的特徵向量。
訓練這個特徵用的是餘弦嵌入損失:同一條軌跡切出來的兩段,特徵要相似;不同軌跡的兩段,相似度要壓到 0 以下。
追蹤結束後,把所有 tracklet 的特徵兩兩比較,用階層式分群把運動模式相似的接起來。為了避免接上不合理的組合,時間差超過 50 幀、空間距離超過 50 像素的不接。
作者強調,傳統的 tracklet 合併要另外訓練一個孿生網路,每一對 tracklet 都要跑一次,計算量是 ;MambaMOT+ 每條 tracklet 只要跑一次前向,是 。不過分群時兩兩比較餘弦相似度,這一步仍然是 ,只是向量內積比跑網路便宜得多。
另外要注意,這個合併是在整段影片追完之後才做的,所以 MambaMOT+ 不再是線上方法。
訓練資料
運動模型的訓練資料,取自 MOT17、DanceTrack、SportsMOT 的訓練集軌跡。每次隨機切一段長度在 2 到 之間的片段,不足 的補齊,目標是下一幀的真值框。單張 RTX 4080 訓練 500 個 epoch。
討論
DanceTrack 和 SportsMOT
| 方法 | HOTA | AssA | IDF1 |
|---|---|---|---|
| ByteTrack | 47.3 | 31.4 | 52.5 |
| OC-SORT | 54.6 | 40.2 | 54.6 |
| MambaMOT | 55.5 | 38.3 | 53.9 |
| MambaMOT+ | 56.1 | 39.0 | 54.9 |
整理自原論文 Table I,DanceTrack 測試集。
和使用同一組偵測的 ByteTrack 相比,MambaMOT 的 HOTA 高了 8.2,這是論文的主要賣點。
不過拆開來看,這 8.2 裡有不少來自偵測那一側:ByteTrack 的 DetA 是 71.6,MambaMOT 是 80.8,AssA 則是 31.4 對 38.3。運動模型主要影響的是關聯,同一組偵測、DetA 卻差了 9 分以上,代表表中兩者的設定可能不只運動模型不同。OC-SORT 的 DetA 是 80.4,和 MambaMOT 接近,拿它當對照比較公平。
和 OC-SORT 比,故事就不太一樣。OC-SORT 是在卡爾曼濾波上動手腳的方法,MambaMOT 的 HOTA 只比它高 0.9,AssA 和 IDF1 反而比它低。加上軌跡合併的 MambaMOT+,IDF1 才以 0.3 小勝。
SportsMOT 上的情況類似。用同一個 YOLOX 偵測器,MambaMOT 的 HOTA 是 70.4,OC-SORT 是 70.2;MambaMOT+ 到 71.3。MambaMOT 和 ByteTrack 的 62.0 比,差距是 8.4。
少了什麼
這篇論文的篇幅很短,有幾件事沒有交代:
- 沒有消融。 輸入幾幀、用幾個 Mamba 區塊、拿掉 GIoU 損失會怎樣,都沒有實驗。換成 LSTM 或 Transformer 會不會一樣好,也沒有比較。
- 沒有行人資料集的結果。 訓練資料裡有 MOT17 的軌跡,測試卻只報告了 DanceTrack 和 SportsMOT。
- 沒有跨資料集的實驗。 運動模型在三個資料集的訓練軌跡上一起訓練,再在其中兩個的測試集上評估。換到沒看過的運動類型時表現如何,論文沒有測。
- 比較對象不完整。 表中最強的對手是 OC-SORT。同期的 DiffMOT 在 DanceTrack 上的 HOTA 是 62.3,Deep OC-SORT 是 61.3,都沒有列入。這些方法還用了外觀特徵,不能直接比,但讀者很難從這篇論文判斷 Mamba 本身的位置。
DiffMOT 的消融倒是提供了一個側面的參考。在 DiffMOT 的框架裡,同樣是學習式的運動模型,LSTM 的 HOTA 是 51.2,Transformer 是 54.6,擴散模型是 55.7,卡爾曼濾波是 46.8。學習式的運動模型確實比卡爾曼濾波好,至於用哪一種序列模型,差距就小得多。
速度
MambaMOT 在單張 GPU 上跑 28.8 FPS。作者拿它和 MOTR 這類端到端方法比,後者通常不到 10 FPS。運動模型只有兩個 64 維的 Mamba 區塊,本身非常輕。
結論
MambaMOT 把卡爾曼濾波換成一個小型的 Mamba,看追蹤會不會變好。在舞者和球員身上,答案是會,和 ByteTrack 相比,HOTA 一口氣多了 8 分以上。
選擇性狀態空間模型的好處,在於它能依輸入決定要相信舊的趨勢還是新的觀測,而這正是不規則運動最需要的。不過它和 OC-SORT 這類改良過的卡爾曼濾波方法相比,優勢就只剩一點點;至於它是不是比其他序列模型更適合這個任務,這篇論文沒有給出答案。