原始論文
DiffusionTrack: Diffusion Model For Multi-Object Tracking
- 發表版本
- AAAI 2024會議
- arXiv 首次提交
- arXiv:2308.09905
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingdiffusiontrack2023,
  title = {{DiffusionTrack: Diffusion Model For Multi-Object Tracking}},
  author = {Run Luo and Zikai Song and Lintao Ma and Jinlin Wei and Wei Yang and Min Yang},
  year = {2023},
  eprint = {2308.09905},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2308.09905}
}
擴散模型最有名的用途是生成圖片:從一張純雜訊開始,一步一步去掉雜訊,最後得到一張清楚的圖。
2022 年底,DiffusionDet 把這個想法搬到物件偵測。它不生成圖片,而是生成框:在畫面上撒一堆隨機框,讓網路一步一步把它們修正到物體上。
深圳先進院和華中科大的 Run Luo、Zikai Song 等人想再往前一步。如果一次生成的不是一個框,而是一對框,一個在前一幀、一個在這一幀,而且兩個框框住的是同一個人,那偵測和追蹤就在同一個去噪過程裡一起完成了。
定義問題
作者把當時的追蹤器分成兩類,認為它們有三個共同的毛病:
- 不一致。 先偵測再追蹤的方法,偵測器和追蹤器是分開訓練的。聯合偵測與追蹤的方法雖然放在同一個網路裡,偵測和追蹤還是各走各的分支。
- 穩健性和複雜度難兩全。 先偵測再追蹤的方法結構簡單,但偵測一有偏差,追蹤就跟著出錯。聯合的方法比較穩,結構卻複雜,偵測準確度也比不上專門的偵測器。
- 不夠彈性。 同一部影片裡,有的片段人很少、有的很擠,有的人走得慢、有的跑得快,但大部分方法整部影片只能用同一組設定。
DiffusionTrack 想用一個統一的框架同時處理這三件事。
解決問題
一次生成一對框
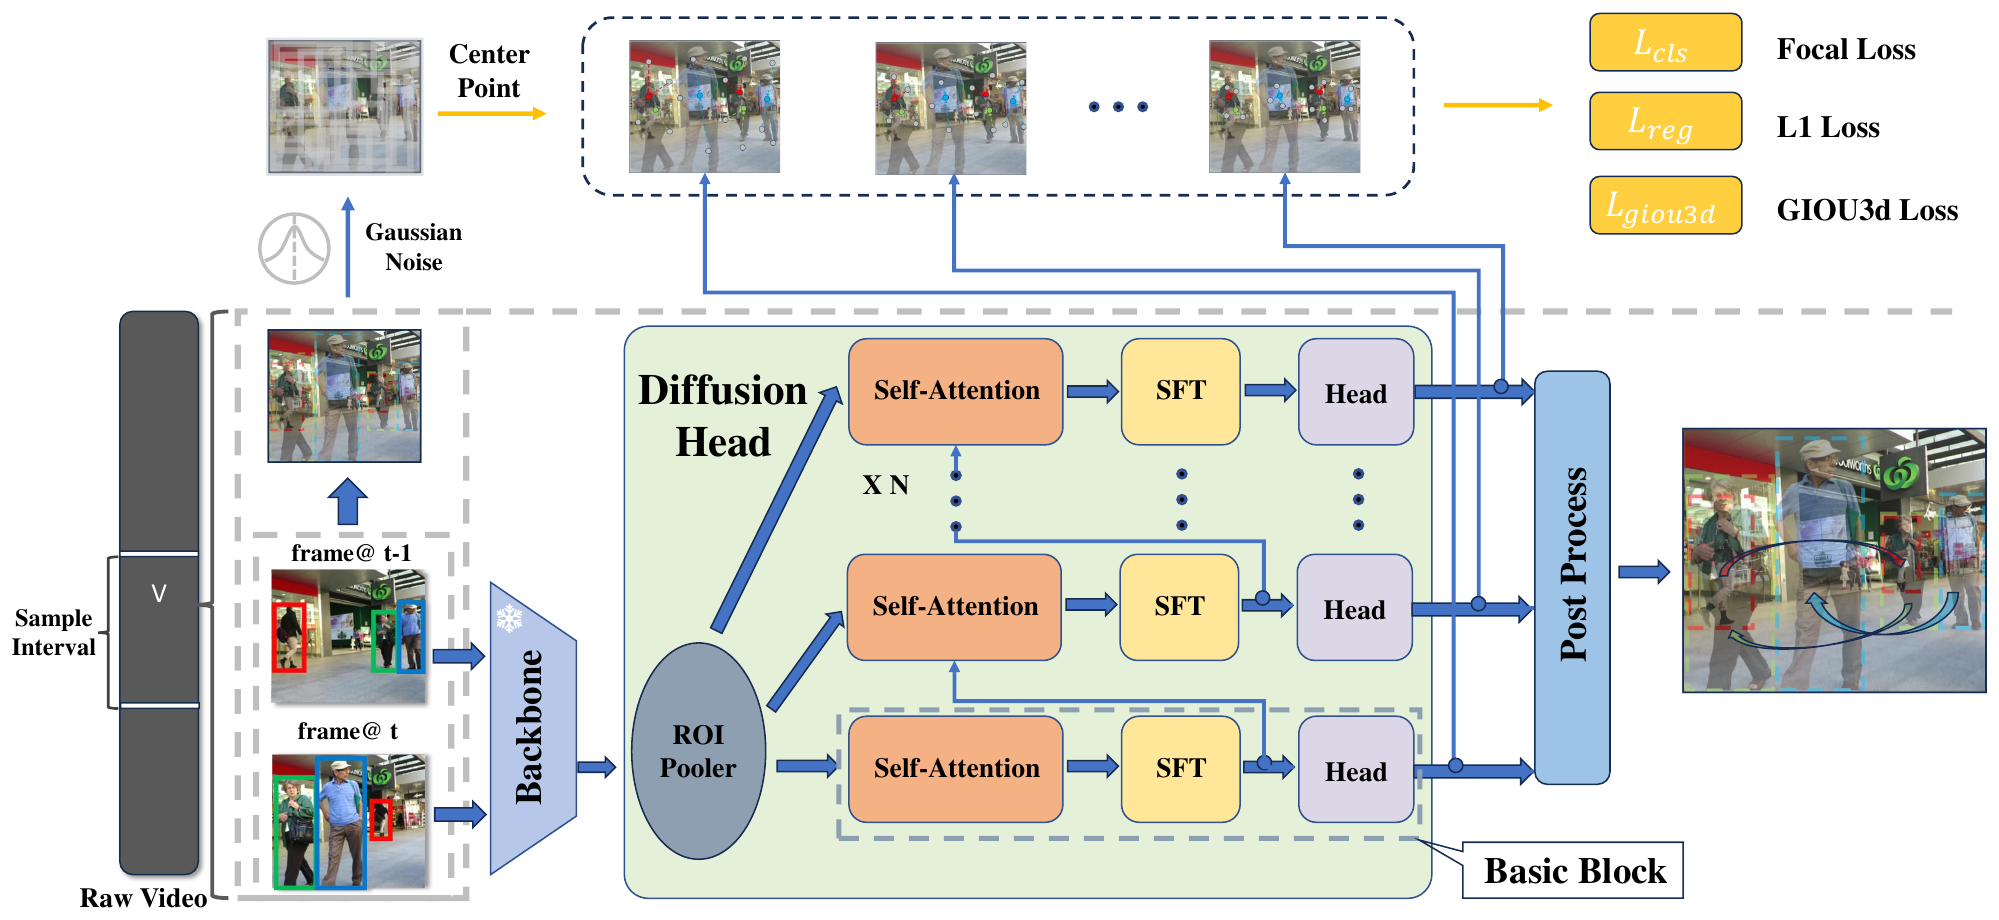
DiffusionTrack 處理的資料單位是一對框:同一個物體在第 幀和第 幀的框,八個數字。網路的工作,是從一對被雜訊弄亂的框,還原出真正的那一對。
如果兩幀是同一張圖,這個問題就退化成一般的物件偵測。作者強調這點,因為它代表偵測和追蹤真的在同一個模型、同一個目標下訓練。
網路分成兩部分:
- 骨幹網路。 用 ByteTrack 預訓練好的 YOLOX,加上 FPN,兩幀各跑一次,之後凍結不動。
- 擴散頭。 依照每一對雜訊框,從兩幀的特徵圖上各取一塊 RoI 特徵,經過好幾個區塊反覆修正。每個區塊輸出框的位置、類別,和一個關聯分數,表示這對框是不是同一個物體。
每個區塊裡有一個時空融合模組,讓配對的兩個框交換資訊。前一幀的框看得到這一幀,這一幀的框也看得到前一幀,兩邊一起決定這對框該往哪裡修。
訓練:把正確答案弄髒
訓練時,從同一部影片裡取兩幀,相隔最多 5 幀。兩幀都出現的物體,各組成一對正確的框,再補一些額外的框,湊滿 500 對。
接著依照擴散模型的排程,在這 500 對框上加入不同程度的高斯雜訊,讓網路學著把它們還原。匹配時用匈牙利演算法,損失有三項:類別用 focal loss、座標用 L1,還有一項 3D GIoU。
3D GIoU 是 GIoU 的延伸。一對框在時間軸上疊起來,像一個方台;兩個方台的交集和聯集,用兩幀的面積加總來算。這讓網路同時顧及兩幀的框,而不是各算各的。
推論:用上一幀的框起頭
偵測從純隨機的框開始;追蹤不必,因為上一幀已經知道每個人在哪裡。
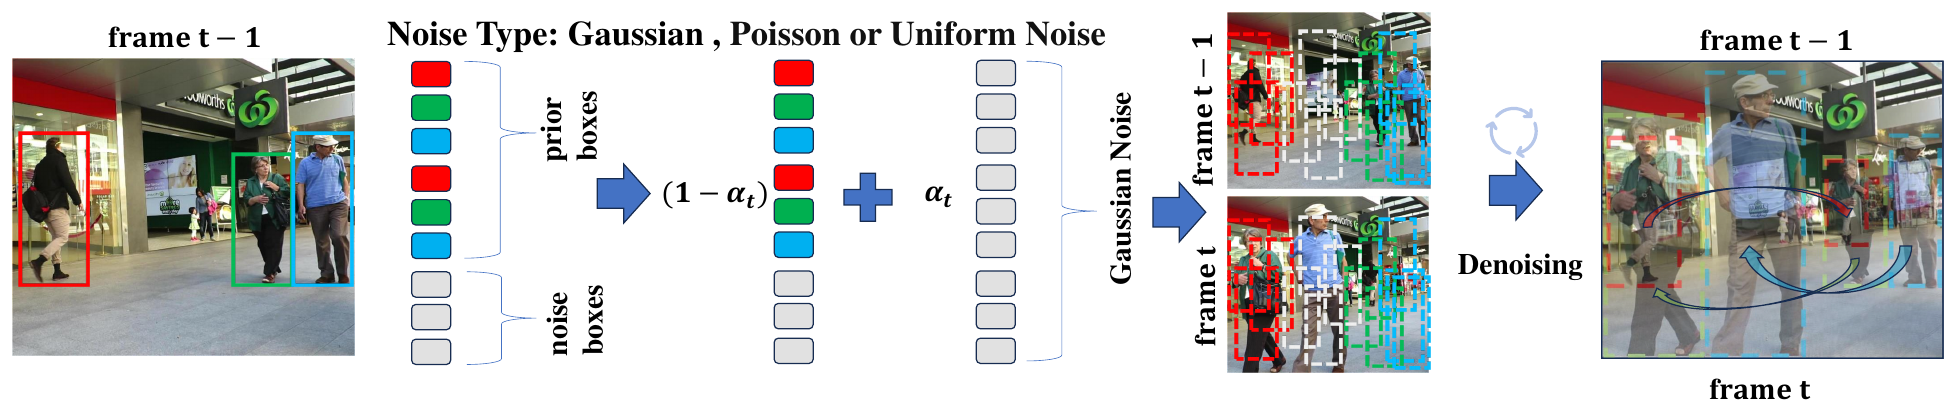
推論分三步:
- 湊框。 把上一幀的框重複幾次,剩下的位置補上隨機的高斯框,湊滿固定數量。
- 加雜訊。 依照 混入雜訊。
- 去噪。 用 DDIM 跑幾步,得到配對框。
舉個例子。MOT17 上設定 800 個框,其中 25% 用上一幀的框。如果上一幀追到 40 個人,就有 200 個先驗框,每個人重複 5 次;剩下 600 個是隨機框。
從先驗框出發的那幾對,負責把已經在追的人延續到這一幀;從隨機框出發的那幾對,負責找新出現的人,或把之前跟丟的人撿回來。
本文整理的算例。
去噪之後,關聯分數低於 0.25 的配對先丟掉,再做兩次 NMS 去掉重複。剩下的配對,用 IoU 接上既有的軌跡。被遮擋而跟丟的軌跡,則用一個簡單的卡爾曼濾波推估位置,和新找到的框再配一次。
雜訊要加多少,取決於物體動得多快。作者讓擴散的時間步 隨著兩幀之間的平均移動量變化:動得越多,雜訊越大,讓網路有更大的空間去修正。同一部影片的不同片段,因此可以用不同的雜訊量,這就是前面說的「彈性」。
討論
多少先驗、什麼雜訊
消融都在 MOT17 的訓練集前半訓練、後半測試:
| 先驗框比例 | MOTA | IDF1 | HOTA |
|---|---|---|---|
| 0% | 71.2 | 65.9 | 58.1 |
| 25% | 73.6 | 70.0 | 60.7 |
| 50% | 74.5 | 71.2 | 61.8 |
| 75% | 74.1 | 71.4 | 61.9 |
| 100% | 72.9 | 66.8 | 58.4 |
整理自原論文 Table 1(a),MOT17 驗證集。
0% 等於完全不用上一幀的資訊,每一幀都從頭偵測;100% 則完全不補隨機框。兩個極端都比較差,中間的比例最好。前者少了追蹤的線索,後者沒有隨機框去找新出現的人。
補框用什麼雜訊也有差。高斯雜訊最好,HOTA 60.7;改成泊松或均勻分布,或乾脆補整張圖大小的框,HOTA 都掉到 59 以下。
雜訊量和移動量的關係,用對數函數最好,HOTA 62.6;用線性函數是 60.7,用固定值是 58.2。
框越多、步數越多
| 框數 | 去噪步數 | MOTA | HOTA | 計算量 | FPS |
|---|---|---|---|---|---|
| 500 | 1 | 71.5 | 58.4 | 229.6G | 21.05 |
| 500 | 2 | 71.7 | 59.5 | 459.2G | 10.47 |
| 800 | 1 | 73.6 | 60.7 | 367.3G | 15.89 |
| 1000 | 1 | 74.1 | 61.3 | 459.1G | 13.37 |
整理自原論文 Table 1(d),MOT17 驗證集,單張 RTX 3090、FP16。
擴散模型的一個好處是,訓練完之後,框的數量和去噪步數都可以在推論時調整。多一點框、多走幾步,成績就好一點,速度就慢一點,不用重新訓練。
不過從表上看,加框比加步數划算。同樣大約 459G 的計算量,1000 個框走 1 步的 HOTA 是 61.3,500 個框走 2 步只有 59.5。附錄裡作者也承認,多步去噪帶來的提升有限。
偵測被干擾的時候
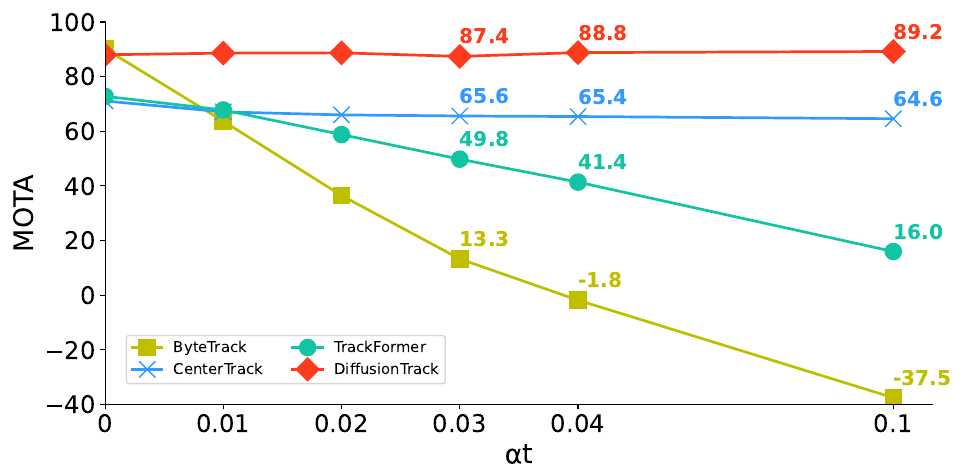
這是論文最醒目的一張圖。作者在偵測框上混入雜訊,比例從 0 加到 0.1。ByteTrack 完全依賴偵測框,擾動到 0.04 時 MOTA 已經變成負的;DiffusionTrack 幾乎不受影響。
這個結果不難理解。對 DiffusionTrack 來說,帶雜訊的框本來就是它的輸入,去噪是它每天在做的事。
讀這張圖時要注意實驗設定。依照圖說,四個追蹤器都用 MOT17 訓練集訓練,再在 val-half 上評估,而 val-half 本來就是訓練集的後半。所以 DiffusionTrack 在沒有擾動時的 MOTA 接近 89,比前面消融的 73.6 高出許多。能比較的是曲線的走勢,數值本身不能和其他表格對照。
和其他方法比
| 資料集 | 方法 | MOTA | IDF1 | HOTA | AssA |
|---|---|---|---|---|---|
| MOT17 | ByteTrack | 80.3 | 77.3 | 63.1 | 62.0 |
| MOT17 | DiffusionTrack | 77.9 | 73.8 | 60.8 | 58.8 |
| MOT20 | ByteTrack | 77.8 | 75.2 | 61.3 | 59.6 |
| MOT20 | DiffusionTrack | 72.8 | 66.3 | 55.3 | 51.3 |
| DanceTrack | OC-SORT | 89.6 | 54.6 | 54.6 | 40.2 |
| DanceTrack | DiffusionTrack | 89.3 | 47.5 | 52.4 | 33.5 |
MOT17、MOT20 整理自原論文 Table 2,DanceTrack 整理自原論文 Table 3,皆為測試集、私有偵測。
在聯合偵測與追蹤的方法裡,DiffusionTrack 是原論文表上最好的:MOT17 的 MOTA 77.9,高於 TrackFormer 的 74.1 和 MOTR 的 71.9。但和先偵測再追蹤的 ByteTrack、OC-SORT 相比,三個資料集都還落後。
拆開來看,DiffusionTrack 強在偵測。DanceTrack 上它的 DetA 是 82.2,比 OC-SORT 的 80.4 還高;AssA 卻只有 33.5,比 OC-SORT 低了 6.7。MOT17 上它的 ID 切換是 3,819 次,ByteTrack 只有 2,196 次。
作者也做了只在第 幀加雜訊的基準版本。它在 MOT17 上的 HOTA 是 55.9,比 DiffusionTrack 低 4.9;到了擁擠的 MOT20 只有 42.5,到了動作複雜的 DanceTrack 只有 44.0。作者的解釋是,基準版本只學到從上一幀的框回歸到這一幀,兩幀一起加雜訊的過程,則逼著網路學會分辨不同的物體。
代價
擴散頭有 2.36 億個可訓練參數,在 8 張 RTX 3090 上要訓練約 30 小時。推論時 800 個框走一步,每幀 367G 的計算量,大約 16 FPS。作者在附錄裡也提到,MOT20 的小物體處理得不好。
結論
DiffusionTrack 把追蹤寫成一個去噪問題:同一個人在兩幀的框,是從一對雜訊框慢慢修出來的。偵測和追蹤用同一個網路、同一個目標訓練;框的數量和去噪步數可以在推論時調;偵測框被干擾時也很穩。
它的弱點在關聯。偵測的指標很好,身分的指標卻還追不上幾個靠卡爾曼濾波和 IoU 的方法,而它自己最後也用了 IoU 和卡爾曼濾波來接軌跡。
擴散模型在追蹤裡還有另一種用法。半年後的 DiffMOT 不拿它來生成框,而是拿來預測人下一步往哪裡走。