原論文
Evaluating Multiple Object Tracking Performance: The CLEAR MOT Metrics
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@article{multiobjecttrackingclearmot2008,
  title = {{Evaluating Multiple Object Tracking Performance: The CLEAR MOT Metrics}},
  author = {Keni Bernardin and Rainer Stiefelhagen},
  year = {2008},
  journal = {EURASIP Journal on Image and Video Processing},
  url = {https://doi.org/10.1155/2008/246309},
  doi = {10.1155/2008/246309}
}
追跡論文のメインの表では、最初の列はほぼ決まって MOTA だ。
SORT も DeepSORT も FairMOT も、これで順位を決めてきた。それが HOTA の論文では分解されて批判の的になる。ID が三回入れ替わっても 3 ポイントしか引かれず、スコアのほとんどは検出に食われてしまう、と。
これほど問題があるのなら、そもそもなぜこう設計されたのか?
今回は源流に戻る。2008 年、ドイツのカールスルーエ大学の Keni Bernardin と Rainer Stiefelhagen が MOTA と MOTP という二つの指標を提案した。論文タイトルにある CLEAR は、2006 年と 2007 年に開かれた二回の国際評価の名前だ。
面白いことに、当時評価しようとしていた対象は、私たちが見慣れた歩行者追跡とはずいぶん違う。主なタスクはセミナー室で何台ものカメラを使い、各人が床のどこに立っているかをセンチメートル単位で推定するものだった。ほかにも顔の追跡、街頭の歩行者と車両、さらにはマイクロホンアレイで誰が話しているかを突き止める音響追跡まであった。MOTA の設計の多くは、こうしたタスクに迫られて生まれたものだ。
問題の定義
単一物体の追跡なら評価は簡単で、各フレームの位置誤差を測ればそれで済む。複数の物体となると厄介だ。トラッカーが出力する軌跡の数は実際の物体より多いこともあれば少ないこともあり、軌跡どうしが入れ替わったりもする。
当時、指標に不足はなかった。欠けていたのは合意だ。著者らは既存の評価方式をいくつか整理している。
- Li らは複数カメラによるサッカー選手の追跡のために三つの尺度を設計したが、そのうち二つはサッカーにしか使えず、比較的汎用的な残りの一つは、誤検出の軌跡も位置の誤差も考慮していない。
- ETISEO プロジェクトは 8 個の指標を提案したが、指標どうしが依存し合っていて、多くは別の一つか二つと組み合わせないと読み解けない。
- Smith らはこの論文の考え方にいちばん近いが、9 個の尺度を使っている。5 個は物体の配置の誤りを、4 個はラベル付けの不一致を測るものだ。尺度によってはトラッカー側と物体側でそれぞれ一回ずつ定義されていて、たとえば MT/MO、FIT/FIO がそうだ。
指標が多すぎると、大規模な評価で何十ものシステムを比べるとき、読者にはどれが良くてどれが悪いのかまるで見えない。その結果、多くの論文は定量評価そのものをやめてしまうか、めいめいが独自の尺度を作り出していた。
著者らはまず、理想的な複数物体トラッカーを描いてみせる。どの時刻でも正しい数の物体を見つけ、位置をできるだけ正確に推定し、各物体には最初から最後まで変わらない ID が一つだけついている。一時的に隠れて戻ってきても、それは同じだ。輪郭、向き、速度といったものは考慮の対象外だ。
そこから、指標に求める条件を定める。
- 位置がどれだけ正確に推定できているかを判断できる。
- トラッカーが各物体を一貫して追い続けているか、一つの物体にちょうど一本の軌跡が対応しているかを反映できる。
- 調整できるパラメータやしきい値は少ないほどよい。
- 直感的であること。何種類もの誤りが同時に起きたり、誤りが時間的に偏って分布したりしても、数字が妥当であること。
- 汎用的であること。2D でも 3D でも、中心点だけを推定するトラッカーでもボックスを推定するトラッカーでも比べられること。
- 数は少なく、それでいて十分に多くを語ること。
最初の二つが目標で、残りの四つが制約だ。本当に難しいのは「誤りをどう数えるか」にある。先に一つ考えてみてほしい。あるトラッカーが一本の動画の中で、同じ人の ID を一回入れ替えた。これは何回の誤りと数えるべきか?
問題を解く
評価全体は、各フレームで三つのことを行う。
- トラッカーが出力した仮説 と実際の物体 の間で、最良の対応を見つける。
- 対応の一組ごとに、位置の誤差を計算する。
- 三種類の誤りを累計する。どの仮説とも対応しなかった物体は検出漏れ(miss)、どの実際の物体とも対応しなかった仮説は誤検出(false positive)とし、物体が今回対応した仮説が以前と違えば、誤対応(mismatch)を一回と数える。
最終的には、トラッカーの性能を二つの数字だけで表す。位置がどれだけ正確に推定できたかと、全部でどれだけ誤ったかだ。
この手順の細部は、ほとんどが第一段階に詰まっている。
遠すぎれば数えない
いちばん直感的なのは、各物体を最も近い仮説に割り当て、残った物体を検出漏れ、残った仮説を誤検出とするやり方だ。最初に処理しなければならないのは、最も近い仮説でさえ遠く離れている場合だ。
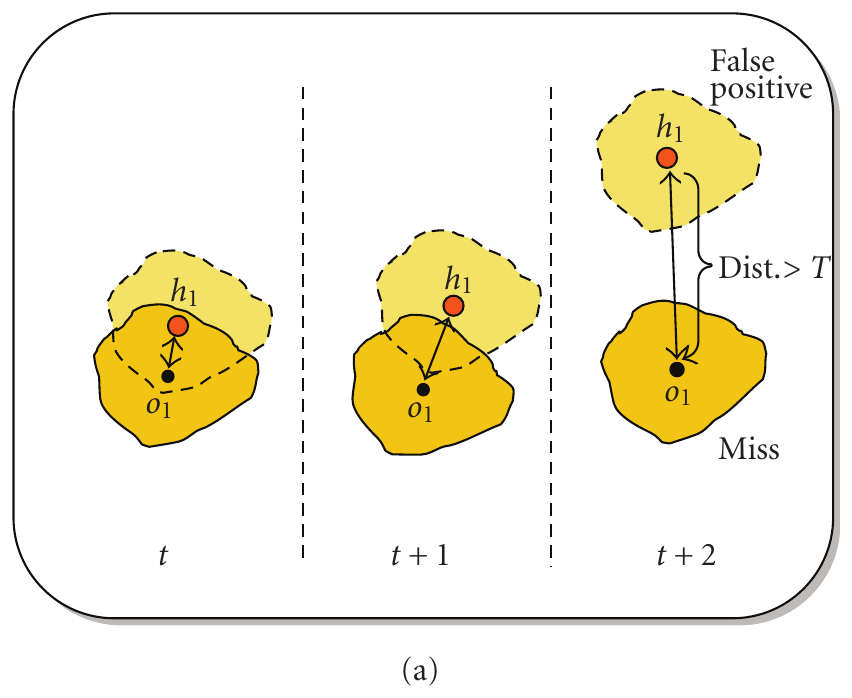
図の は三フレーム目で上へ流れてしまった。まだ を追っているのだろうか? 著者らの考えでは、距離がある程度以上大きくなれば、もう「位置の推定が不正確」とは言えず、トラッカーはこの物体を見失って別のものを追っている。だから距離が の対応だけを有効とし、しきい値を超えれば、物体は検出漏れ一回、仮説は誤検出一回と数える。
しきい値 をどう決めるかは、タスクと距離の計算方法による。ボックスを推定するトラッカーなら重なりの度合いを使い、しきい値を「まったく重ならない」に設定できる。中心点だけを推定するトラッカーならユークリッド距離を使い、しきい値は人一人の平均の幅にすればよく、単位はピクセルかセンチメートルだ。著者らは、 にあらゆる場合に通用する値を与えることはできないと明言しており、データから自動で決める方法もこの論文では研究していない。
相手が替わったら、誤りは何回?
次は時間的な一貫性だ。
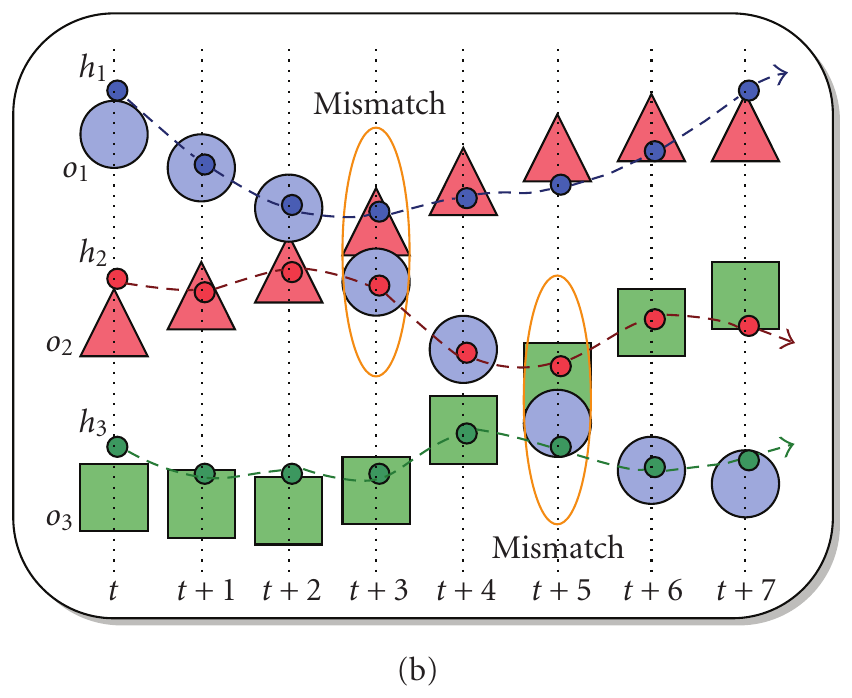
最初、、、 はそれぞれ 、、 を追っている。 で青い と赤い が近づき、離れたあとは が に、 が についていく。 では がまた緑の と交差し、今度は が に、 が についていく。
こういう誤りはどう数えればいいのか?
一つの考え方は、まず各物体に「最良」の仮説を一つ決めておくことだ。たとえば最初に対応したものや、動画全体でいちばん多く対応したものだ。そのうえで、この組み合わせに反するフレームをすべて誤りと数える。著者らは次の図で、このやり方の問題を説明している。
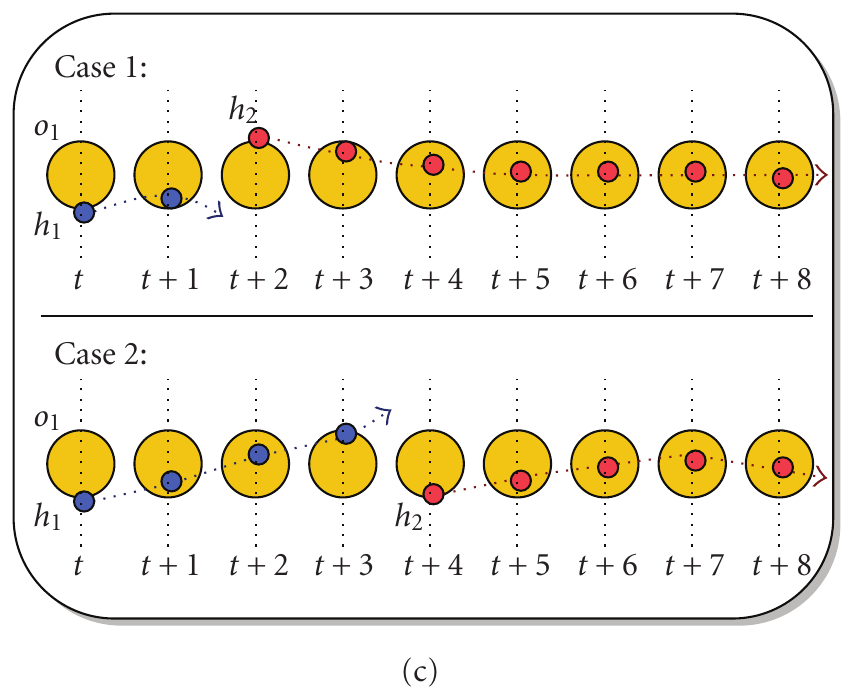
どちらの状況でも仮説が入れ替わったのは一回だけで、犯した誤りは同じ種類だ。ところが はどちらの状況でも最も多く対応した仮説なので、「最良の組み合わせ」で数えると、Case 1 は最初の 2 フレームだけが反していて誤り 2 回、Case 2 は最初の 4 フレームがすべて反していて誤り 4 回になる。誤りの多さが、入れ替わりが早く起きたか遅く起きたかで決まってしまう。
そこで著者らは、対応が変わったそのフレームでだけ誤対応を一回と数え、その間の区間はすべて正しいとすることにした。一回入れ替われば、一回だ。
このルールで Figure 2(b) を数え直してみよう。 の交差では と がそれぞれ仮説を替えたので二回、 では と が一回ずつ替えたのでまた二回、合わせて四回の誤対応だ。その後 は最後までずっと についていくが、「違う人を追っている」という理由で毎フレーム減点されることはない。
以前の相手を覚えておく
「対応が変わった」とわかるには、以前の対応を覚えておかなければならない。著者らは対応表 を保持し、時刻 までのすべての組み合わせを記録する。最初は空の だ。 で が と対応し、表にある と矛盾すれば、誤対応を一回と数え、表の組み合わせを に置き換える。
この表には二つ目の用途もある。有効な候補がいくつもあるとき、どれに割り当てるかを決めるのに使うのだ。
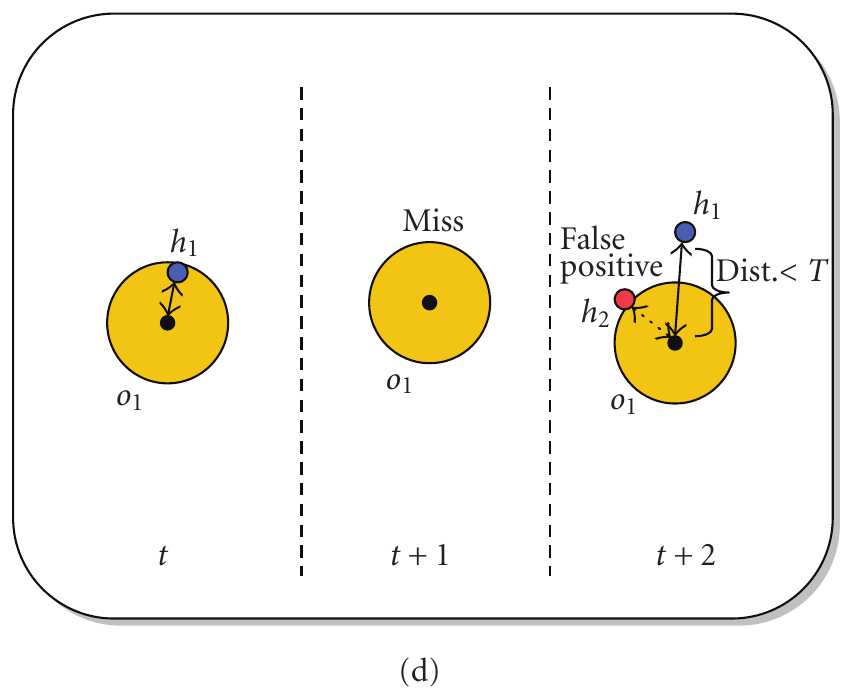
は で見失い、 でまた戻ってきたが、同時にそばにはもっと近い が現れた。距離だけを見れば に割り当てるべきだ。しかし表には が記録されていて、著者らはこの組み合わせを優先して引き継ぐ。それこそが正しい軌跡である可能性が最も高いからだ。 は誤検出と数える。トラッカーが同じ人に余分な仮説を一つ出力したのかもしれないし、もともと別の人を追っていた仮説がたまたま流れてきたのかもしれない。
対応付けの手順の全体
ここまでの設計をまとめると、各フレームの手順は次のようになる。
- まず古い対応を引き継ぐ。 表 にある各組 について、物体がまだ存在し、仮説もまだ存在し、距離が を超えていなければ、このフレームでもそのまま対応させる。
- 残りを改めて対応付ける。 まだ対応していない物体と仮説について、一対一で距離が を超えないという制約のもとで、距離の合計が最小になる組み合わせを見つける。これは最小重み割当問題で、Munkres のアルゴリズム(つまりハンガリアン法)で解く。新しい組み合わせが と矛盾すれば、表を更新して誤対応を一回記録する。このフレームの誤対応数を とする。
- 距離を計算する。 このフレームで対応した組は全部で 組あり、各組について物体 と仮説との距離 を計算する。
- 残りを誤りと数える。 対応しなかった仮説はすべて誤検出で、その数は 。対応しなかった物体はすべて検出漏れで、その数は 。このフレームの実際の物体の数を とする。
- 次のフレームに進む。最初のフレームでは表が空なので、組み合わせはすべて新しく、誤対応は生じない。
手順全体の要は第一段階だ。古い組み合わせがまだ有効である限り、ハンガリアン法に決め直させることはしない。たとえ対応付けをやり直せば距離の合計が小さくなるとしてもだ。こうすれば、トラッカーが同じ物体を一貫して追い続けたことが、評価で報われる。
二つの指標
各フレームの計数がそろったところで、一つ目の指標は複数物体追跡精密度(MOTP)だ。
対応したすべての組の、位置誤差の平均だ。答えているのは「対応したとき、位置がどれだけ正確に推定できたか」だけで、トラッカーが物体の数を正しく見つけたか、ID を入れ替えたかとは関係がない。ユークリッド距離を使うなら小さいほど良く、ボックスの重なりの度合いを使うなら大きいほど良い。
二つ目の指標は複数物体追跡正確度(MOTA)だ。
分子は全フレームの検出漏れ、誤検出、誤対応の合計で、分母は全フレームの実際の物体数だ。分解してみると、三つの誤り率の和になる。
MOTA は 1 から全体の誤り率を引いたものだ。著者らはこれを音声認識の単語誤り率(WER)になぞらえている。抜けたもの、余分なもの、取り違えたものを全部足し合わせ、正解の長さで割るわけだ。
単語誤り率は 100% を超えることがあるので、MOTA も当然マイナスになりうる。誤検出が多いと、分子が分母より大きくなることがあるのだ。
先に合計してから割る
式では、合計は分子と分母のそれぞれの中に置かれていて、各フレームの比率を先に出してから平均するのではない。この順序は意図的なものだ。
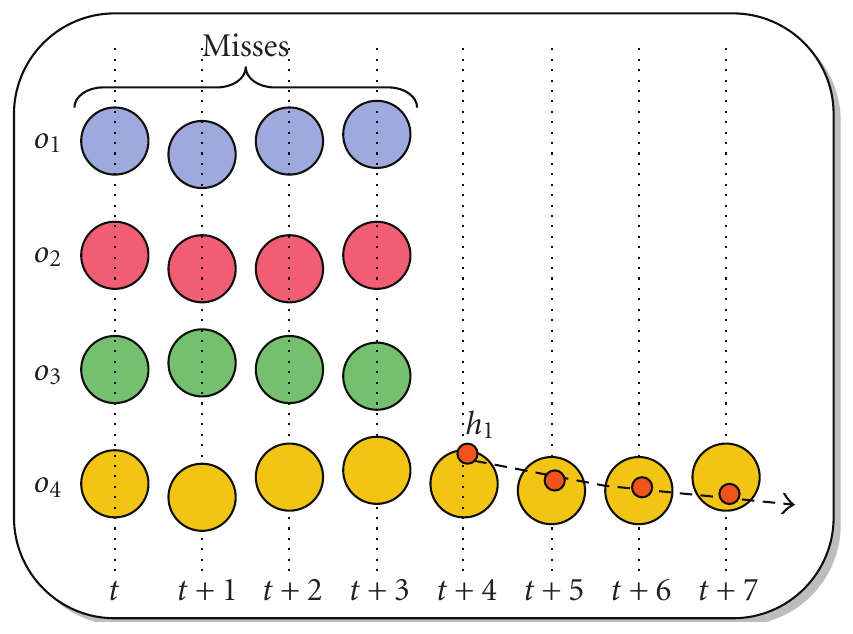
この図で検出漏れ率を計算してみよう。
最初の 4 フレームでは 4 つの物体がどれも追跡されておらず、各フレームの検出漏れ率は 100% だ。後半の 4 フレームでは物体が一つだけ残っていて、しかも追跡できているので、検出漏れ率は 0% になる。各フレームの比率を先に出して平均すると、次のようになる。
先に誤りを合計してから割ると、最初の 4 フレームで漏れたのは合わせて 16 個、全 8 フレームの物体は合わせて 個なので、検出漏れ率は だ。
このトラッカーは明らかに物体の大半を見逃しているのに、フレームごとの平均では半分しか見逃していないことになる。著者らの指摘では、Smith らの誤検出と検出漏れの尺度はまさにフレームごとの平均を使っているので、こういう直感に反する結果が出てしまう。
CLEAR の評価で実際に使ってみる
CLEAR の正式名称は Classification of Events, Activities and Relationships で、EU の CHIL プロジェクト、米国の VACE プロジェクト、米国国立標準技術研究所(NIST)が共催し、2007 年には AMI プロジェクトも加わった。2006 年の評価ではまだ別の指標を使うタスクもあったが、2007 年には追跡に関わるすべてのタスクが、単一物体か複数物体か、映像か音声かを問わず、MOT 指標で評価された。
タスクごとに変えるのは、距離の計算方法としきい値だけだ。
- 3D 視覚人物追跡: セミナーや会議の場面で、複数のカメラを使って各人の床の上での位置を推定する。距離は床面上のユークリッド距離で、しきい値は 50 センチメートル。2D の画像追跡でよく見られる軌跡の併合や分裂は、こうした複数カメラの 3D の状況ではあまり意味がなく、むしろ位置の誤差、誤検出、人の取り違えを注意深く区別する必要がある。著者らによれば、MOT 指標の設計の大部分はこのタスクが主導した。
- 2D 顔追跡: 各視点で顔の位置と範囲を推定する。距離にはボックスの重なりを使い、しきい値はまったく重ならないことだ。
- 2D 歩行者・車両追跡: 屋外の交通の場面で、同じくボックスの重なりを使う。
- 3D 音響・マルチモーダル人物追跡: 分散配置したマイクロホンアレイで、話している人がどこにいるかを突き止める。検出漏れと誤検出はちょうど音声区間の分割の誤りに対応し、MOTP は位置推定の精度に対応する。音響追跡では話者が誰かを見分けることは求められないので、誤対応は数えない。この版を A-MOTA と呼ぶ。
七つのシステム、三つが横並び
2007 年の 3D 複数人物視覚追跡の結果は次のとおりだ。
| システム | MOTP | 検出漏れ率 | 誤検出率 | 誤対応数 | MOTA |
|---|---|---|---|---|---|
| A | 92 mm | 30.86% | 6.99% | 1,139 | 59.66% |
| B | 91 mm | 32.78% | 5.25% | 1,103 | 59.56% |
| C | 141 mm | 20.66% | 18.58% | 518 | 59.62% |
| D | 155 mm | 15.09% | 14.5% | 378 | 69.58% |
| E | 222 mm | 23.74% | 20.24% | 490 | 54.94% |
| F | 168 mm | 27.74% | 40.19% | 720 | 30.49% |
| G | 147 mm | 13.07% | 7.78% | 361 | 78.36% |
原論文 Figure 7 をもとに整理。CLEAR 2007 3D 複数人物視覚追跡。
まず MOTP を見よう。ほとんどのシステムの平均位置誤差は 20 センチメートル以内に収まっていて、どれも正確そうに聞こえる。なにしろ真の位置は頭部の中心を床に投影したもので、それ自体 5 から 8 センチメートルの精度でしかアノテーションされていない。ただし著者らは、50 センチメートルのしきい値があると MOTP はなかなか大きくならないと注意を促している。50 センチメートルを超えたものは検出漏れとしてはじかれてしまうので、誤差がしきい値内で一様に分布していても、MOTP は 25 センチメートルにしかならない。そう考えると、E の 222 mm は実はあまり正確ではなく、B の 91 mm はかなり精密だ。
次に MOTA を見る。最も良い G は 78%、最も悪い F は 30% で、ひと目でわかる。ところが A、B、C の三つのシステムは、使っている特徴もアルゴリズムもまるで違うのに、MOTA はどれも 59.6% 前後だ。
MOTA だけを見れば、この三つのシステムは同じくらい良い。スコアを分解すると、B は位置が最も正確で誤検出も最も少ないが、検出漏れは最も多く、誤対応の回数は C の二倍を超える。C は漏れが少なく、誤検出が多く、誤対応が少ない。二つのトラッカーの得意分野はまったく違う。そこで評価では最終的に、MOTP と MOTA に加えて、検出漏れ、誤検出、誤対応という三つの内訳も合わせて公開することにした。
誤対応は安すぎる
表の誤対応は回数であって、比率ではない。その背後には、著者らが 2006 年にはすでに気づいていながら、論文の発表時点でもまだ解決していなかった問題がある。
CLEAR のデータは一本が何分もあり、アノテーションは 1 秒に一回しかない。まともなトラッカーなら、誤対応の回数は実際の物体の総数に比べてごくわずかだ。誤対応率はたいてい 2% に満たないのに、検出漏れと誤検出は 20% から 40% もある。一人がしばらく見逃されるだけで、ID を何回も入れ替えるより多く減点され、身元の取り違えが MOTA に与える影響はとても小さい。
著者らはこの点について結論を出していない。身元の取り違えを比較的軽い誤りとみなすかどうかは用途しだいだ。ただ、評価ワークショップでの合意は、身元の誤りにもっと重みを与えたいというものだった。たとえば軌跡全体を単位とする誤りの尺度に切り替え、フレームごとの検出漏れと誤検出が支配する状況から抜け出すことだ。
この文章が書かれたのは 2008 年だ。八年後の IDF1 は軌跡全体で対応付けを行い、さらに四年後の HOTA は検出と関連付けを二つのスコアに分けた。やったのは、まさにこのことだ。
のちの MOTChallenge は全フレームにアノテーションをつけている。ここからは本稿の推測だ。全フレームにアノテーションをつけると、検出漏れと誤検出はフレーム数に比例して増えるのに、身元の入れ替わりは一回なら一回としか数えられない。CLEAR が当時すでに見ていた不均衡は、ひどくなる一方だ。HOTA の論文にある「ID が三回入れ替わっても 3 ポイントしか引かれない」例は、この不均衡の縮図だ。
しきい値がすべてを決める
というパラメータの影響も大きい。 を無限大にすると、対応は一度できればずっと有効で、仮説がどれだけ遠くへ流れても関係がない。MOTA には「物体の数が合っているか」という意味しか残らず、MOTP も役に立たなくなる。 をゼロに近づけると、最後にはすべての物体が検出漏れと数えられ、どちらの指標も意味を失う。
50 センチメートルは直感で決めた値で、結果はまずまず妥当だった。最適なしきい値をどう決めるかについては、まだ答えのない問題だと著者らは述べている。
MOTA はなぜマイナスになりうるのか
2006 年の単一人物 3D 追跡では、壇上の講演者だけを追う。表で最も悪いシステム A の MOTA は だ。
その平均位置誤差は 246 mm で、距離が 50 センチメートルを超えたために検出漏れと数えられた割合は 88.75% にのぼる。仮説をそもそも出力しなかった本当の検出漏れは 2.28% しかない。
これが MOTA がマイナスになる理由だ。位置の誤差がしきい値を超えるたびに、物体は検出漏れ一回、仮説は誤検出一回と数えられ、同じ一つの誤りが二度罰せられる。
著者らによれば、これは意図的なものだ。トラッカーによっては、信頼度にもとづいて、推定が不正確なときにはいっそ出力しない。一方で、間違った位置をずっと出力し続けるトラッカーもある。前者のほうが良いはずだ。論文の言い方を借りれば、半分の時間講演者を検出できなかったトラッカーは、同じ長さの時間、誰もいない黒板をずっと追っていたトラッカーよりも良い。
誤りをどんな種類に分けるかももちろん重要だが、時系列の上で誤りをどう数えるかも、指標のふるまいに同じくらい大きく影響する。これが論文全体で最も重要な観察だ。
音響追跡も同様で、最も良い G は A-MOTA 54.63% を得て、最も悪い B は だった。2007 年の顔追跡では、二つのシステムの MOTP(ボックスの重なり)はそれぞれ 0.66 と 0.68 で、顔を見つけたあとのボックスの正確さは同じくらいだ。ところが MOTA は 33.07% 対 68.81% で、差はすべて、顔を見つけられたか、ずっと追い続けられたかにある。
結論
この論文は明確な対応付けの手順によって、複数物体追跡の誤りを検出漏れ、誤検出、誤対応の三種類に分け、二つの数字でまとめた。MOTP は位置がどれだけ正確に推定できたかを、MOTA は全部でどれだけ誤ったかを測る。
この論文の価値は手順にある。距離がしきい値を超えれば対応とはみなさない。古い組み合わせは有効である限り優先して引き継ぐ。誤対応は変化したフレームでだけ一回数える。比率は先に合計してから割る。どのルールにも、背後に具体的な反例が控えている。
その問題点も、著者らは当時の評価の中で目にしていた。やり方のまったく違う三つのシステムがほぼ同じ MOTA を取りうる。誤対応は検出漏れや誤検出と釣り合っておらず、身元の取り違えはスコアにほとんど影響しない。しきい値 をどう決めるかには答えがない。のちの MOTChallenge はしきい値を IoU 0.5 に統一したが、身元の誤りの重みの問題に正面から取り組むのは、IDF1 と HOTA を待たなければならなかった。
今度 MOTA がマイナスになっているのを見ても、評価プログラムのバグを疑うのはちょっと待ってほしい。この論文がとうに言っているとおり、黒板をずっと追いかけているトラッカーは、何も出力しないトラッカーより悪くて当然なのだ。