原始論文
BoT-SORT: Robust Associations Multi-Pedestrian Tracking
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:2206.14651
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingbotsort2022,
  title = {{BoT-SORT: Robust Associations Multi-Pedestrian Tracking}},
  author = {Nir Aharon and Roy Orfaig and Ben-Zion Bobrovsky},
  year = {2022},
  eprint = {2206.14651},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2206.14651}
}
ByteTrack 證明了,偵測器夠強的時候,卡爾曼濾波加 IoU 就能在 MOT17 上拿到 80.3 的 MOTA。
但「IoU 夠用」的前提是,上一幀預測的框要和這一幀的偵測框對得上。只要拍攝的人轉個身、車子轉個彎,畫面裡所有的東西都會一起移動,卡爾曼濾波預測的框就全部落在錯的位置。行人自己根本沒動,追蹤器卻跟丟了一整群人。
以色列特拉維夫大學的 Nir Aharon、Roy Orfaig 和 Ben-Zion Bobrovsky 整理了 SORT 這一類追蹤器的幾個老毛病,把對應的改進一個一個裝到 ByteTrack 上。名字裡的 BoT 是 bag of tricks,一整包小技巧的意思。
定義問題
作者指出 SORT 類追蹤器的三個限制。
卡爾曼濾波的狀態向量。 SORT 用 :中心、面積、寬高比;DeepSORT 之後的多數追蹤器,包括 ByteTrack,改用 :中心、寬高比、高度。這兩種表示都是在估計寬高比,寬度得從寬高比搭配面積或高度推回來。作者發現,這樣推出來的寬度常常不準,框對不上人。
相機的移動。 IoU 配對完全依賴預測框的位置。相機一動,預測框和偵測框的重疊就變小,造成 ID 切換或漏檢。就算是固定相機,風吹或震動也會讓畫面晃動,在擁擠場景裡一樣會出問題。
IoU 和外觀的取捨。 用 IoU 配對,MOTA 通常比較好;用 re-ID 特徵配對,IDF1 通常比較好。兩種線索怎麼結合,才不會顧此失彼?
解決問題
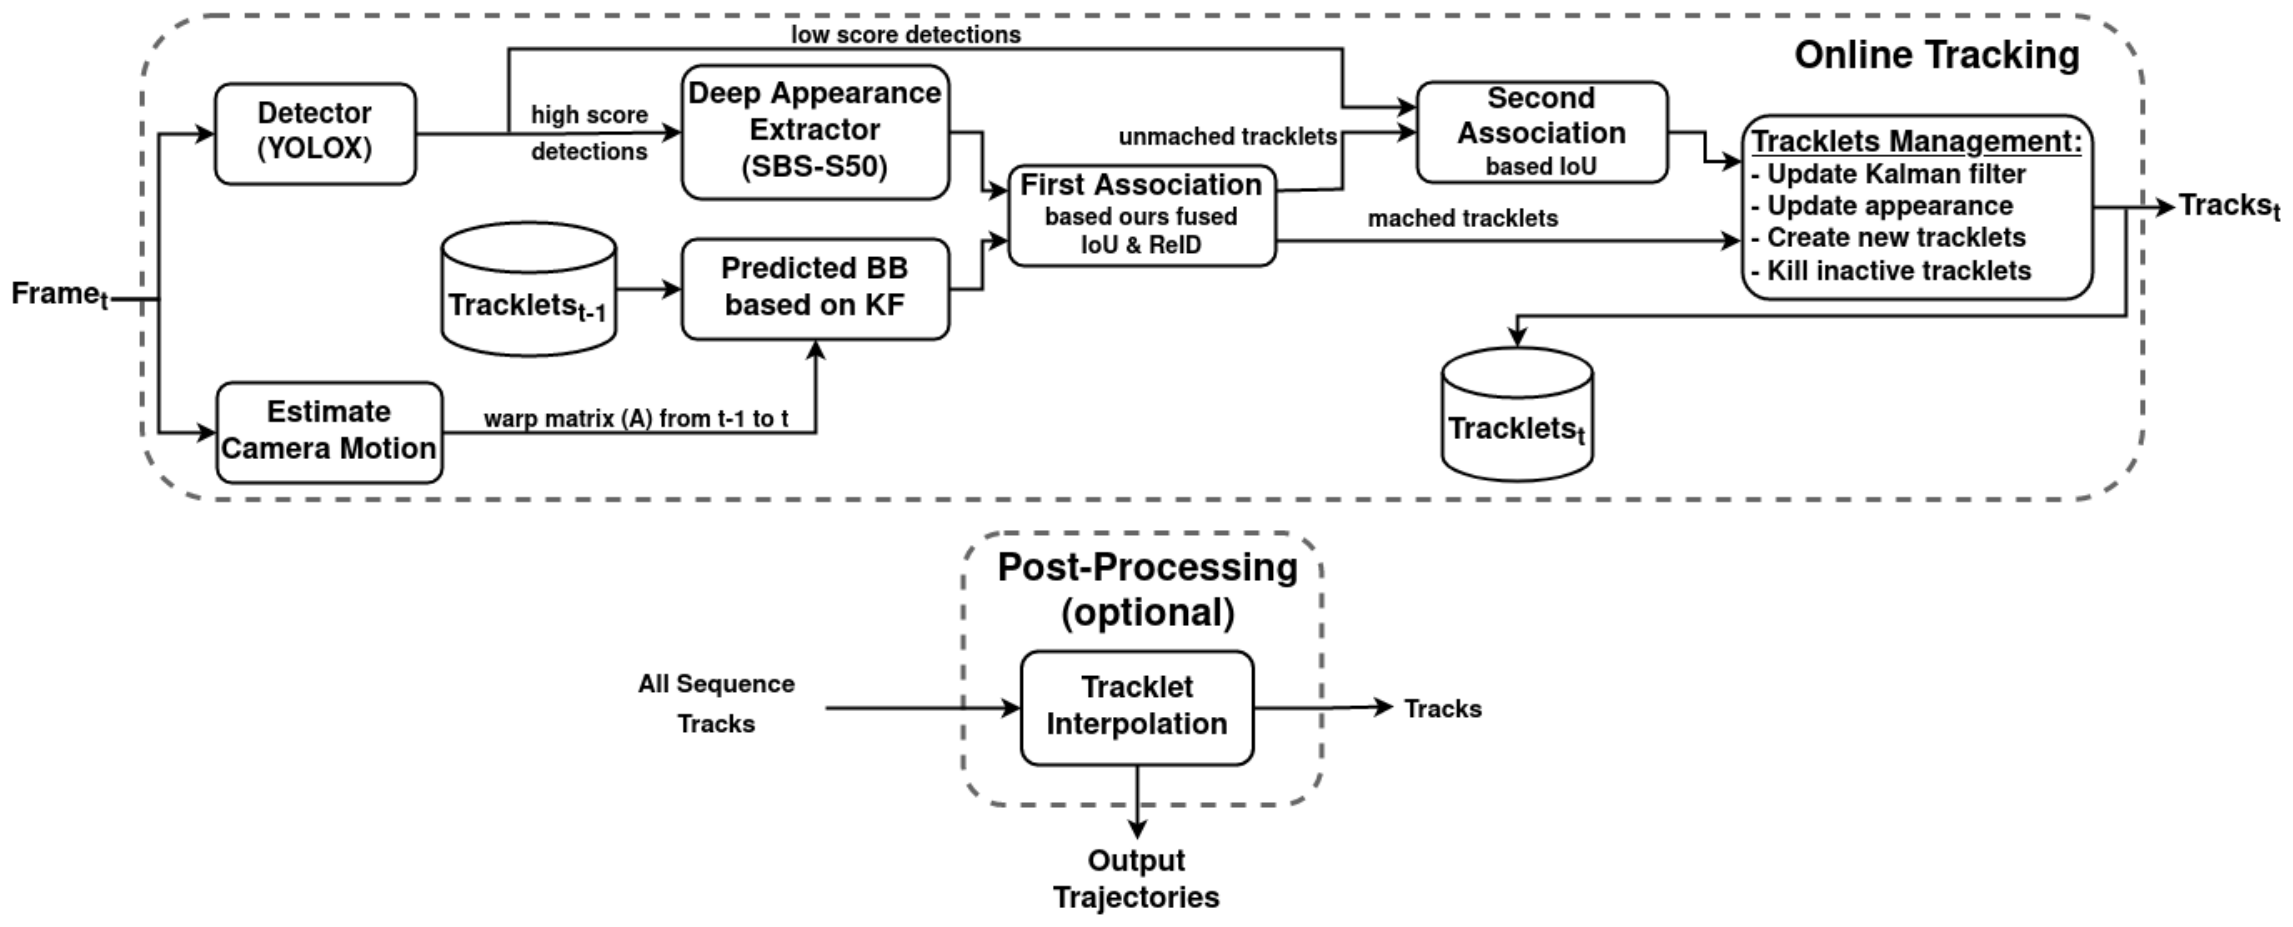
整體骨架就是 ByteTrack,高分框和所有軌跡做第一次關聯,低分框和剩下的軌跡用 IoU 做第二次關聯。BoT-SORT 在這個骨架上改了三個地方,加上 re-ID 的版本叫 BoT-SORT-ReID。
一、直接估計寬和高
作者把卡爾曼濾波的狀態向量改成直接包含寬和高:
雜訊矩陣沿用 DeepSORT 的思路,讓雜訊隨框的大小縮放,但改成分別跟著寬和高走:
、、,分別就是 DeepSORT 程式裡的 1/20 和 1/160。
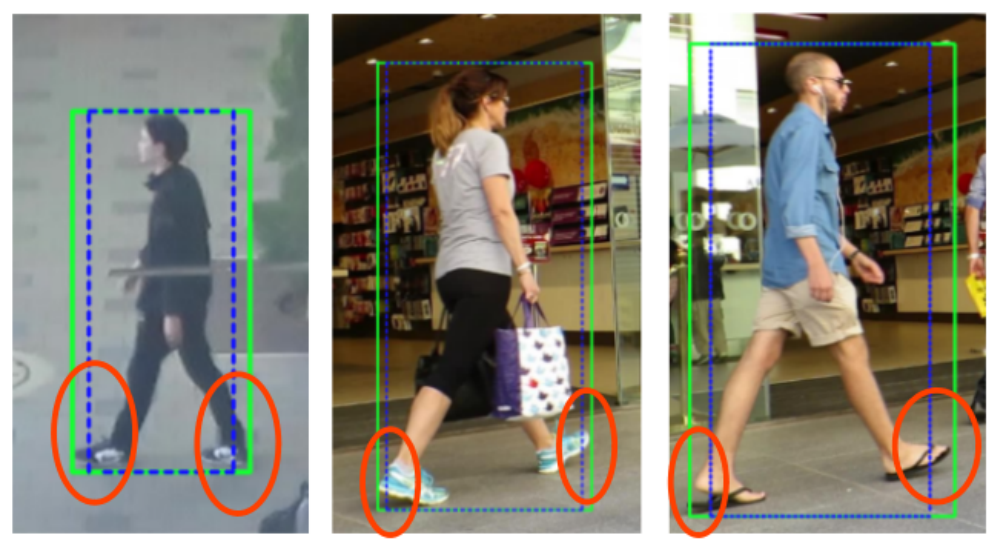
這張圖裡,藍色虛線框把行人的腳切掉了,綠色框則把整個人包進去。走路時腳步張開又合起,寬度變化很大,從寬高比推回來的寬度跟不上。
作者在論文裡很坦白,這個改動確實讓 HOTA 上升,但嚴格來說,他們也不清楚原因,只能推測是框的寬度更貼合物體。
二、相機運動補償(CMC)
沒有 IMU 或導航資訊,也不知道相機內參的情況下,相鄰兩幀之間的影像對齊,是相機剛體運動投影到影像平面上的好近似。
作者沿用 OpenCV 影片穩定模組裡的全域運動補償(Global Motion Compensation, GMC):
- 在上一幀抽出影像關鍵點。
- 用稀疏光流追蹤這些關鍵點到這一幀,並剔除局部的離群點。
- 用 RANSAC 估計一個 的仿射矩陣:
是縮放和旋轉, 是平移。作者也提到,偵測框所在的區域是動態物體,可以在估計時排除,讓估計只反映背景的運動。
有了 ,就把卡爾曼濾波的預測搬到新的座標系。作者用一個小技巧,把 擺成 的區塊對角矩陣 ,把 補零成 8 維的 (只有中心位置那兩維有值):
我們拆開看這條式子對狀態向量做了什麼。八維狀態可以兩兩分組:中心 、寬高 、中心速度 、寬高速度 。 對每一組都乘上同一個 ,所以相機一旋轉,中心、框的大小和速度方向都跟著轉; 只加在中心上,因為相機平移只會讓物體的位置移動,不會改變它的大小或速度。共變異數也一起轉換,讓濾波器的不確定性跟著新的座標系走。
補償完的預測,才拿去和這一幀的偵測做 IoU 配對。
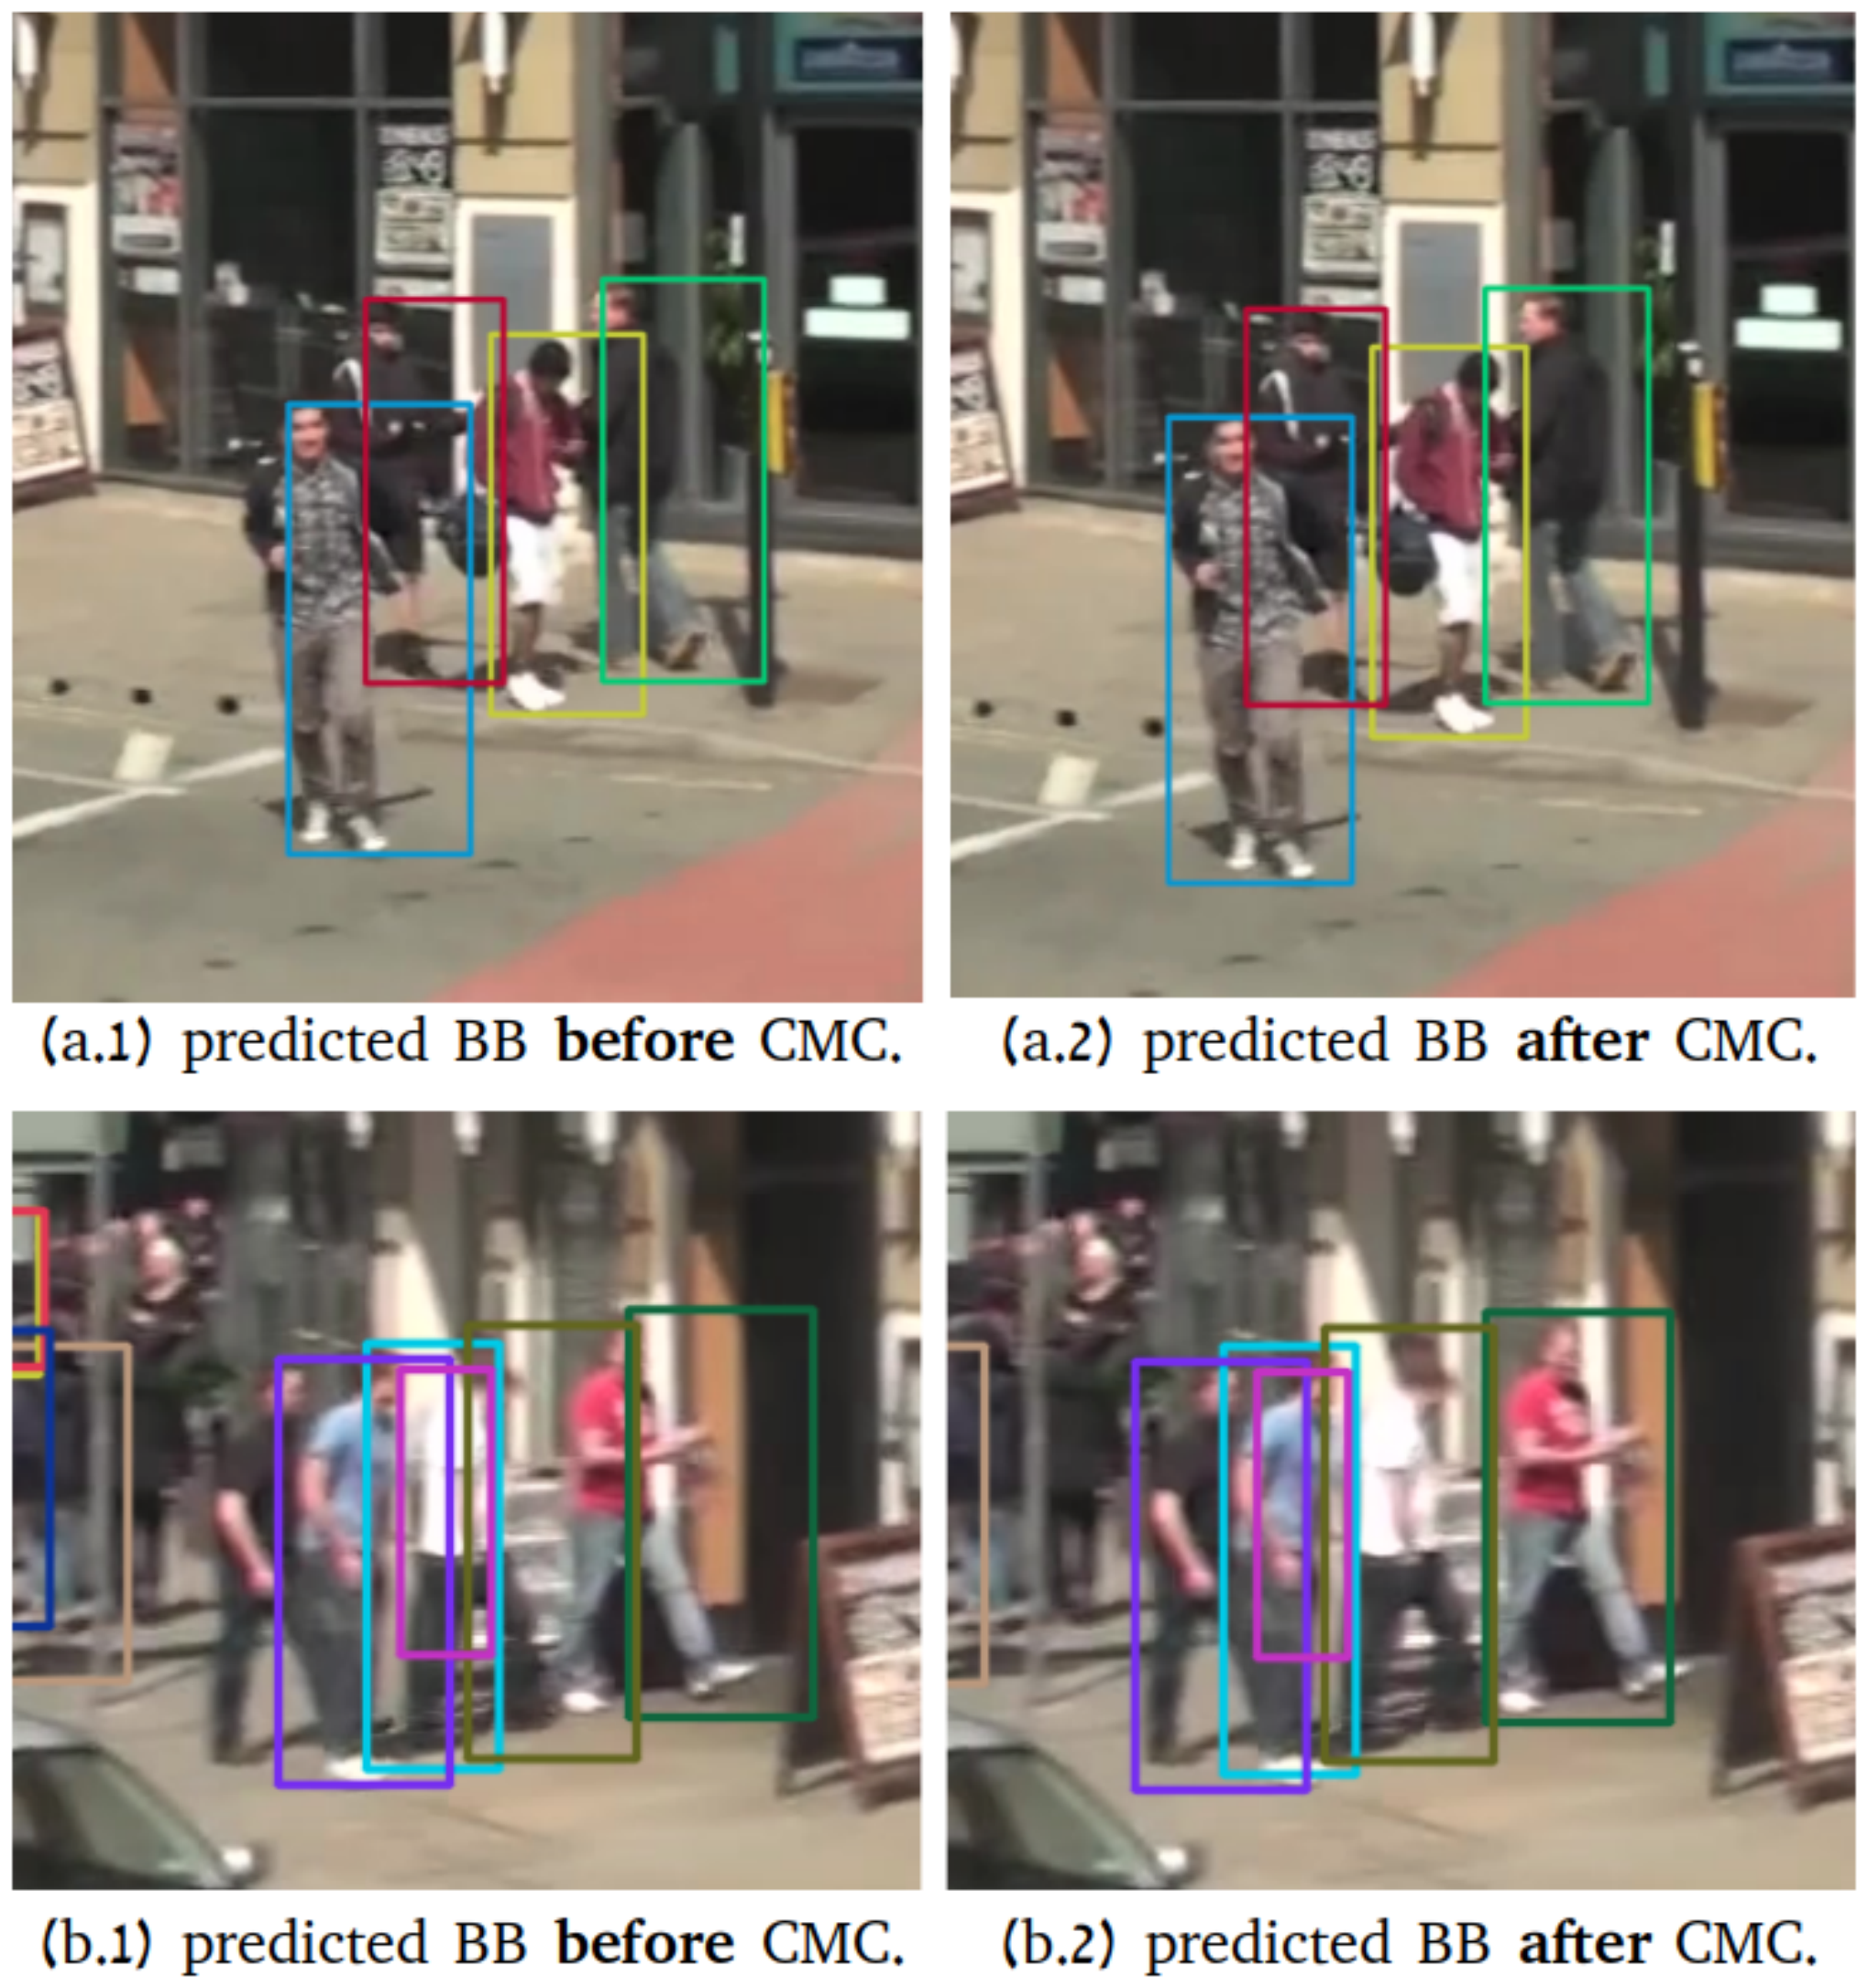
這是 MOT17-13 的畫面,相機架在一輛正在右轉的車上。補償前,預測框整排偏到行人旁邊,IoU 配對一定失敗;補償後,框落回人身上。
三、IoU 與 re-ID 的融合
外觀特徵用 FastReID 函式庫裡的 SBS(stronger baseline on top of BoT),骨幹是 ResNeSt50。和 StrongSORT 一樣,每條軌跡的外觀用 EMA 更新,。為了避免被遮擋或模糊的框污染外觀,只有高分偵測才抽特徵。
常見的作法是把外觀距離和運動距離加權相加,FairMOT 和 StrongSORT 都用 。作者改用另一種組合:先過濾,再取最小值。
是 IoU 距離(1 減 IoU), 是軌跡外觀和偵測特徵的餘弦距離。,。
這個式子讀起來有點繞,我們用三組軌跡和偵測框代進去看:
- 位置近、長得像。 IoU 是 0.7,所以 ;餘弦距離 0.1。兩個條件都成立,,成本取較小的 0.05。外觀和位置都同意,成本壓得很低,這一對幾乎一定會配上。
- 位置近、長得不像。 IoU 0.8,;餘弦距離 0.4,超過 0.25。外觀不算數,,成本取 0.2。外觀沒有扣分,只是不幫忙,配對完全看 IoU。
- 長得像、位置遠。 IoU 0.3,,超過 0.5;餘弦距離 0.05。位置太遠,外觀也不算數,成本取 0.7。
外觀只有在「位置也說得過去」的時候才能幫忙壓低成本。長得像但離很遠的人,不會因為穿了同樣的衣服就被接起來。
這個門檻,是作者在 MOT17 驗證集上畫出同一人與不同人的外觀距離分布後選的:同一人的距離集中在很小的範圍,不同人則大多在更遠的地方。
順便一個除錯工具:cMOTA
作者還提出一個分析工具,叫 current-MOTA。 就是從第一幀算到第 幀為止的 MOTA;算到最後一幀,就是一般的 MOTA。
把它畫成隨時間變化的曲線,追蹤器在哪一段開始出錯,一眼就看得到。
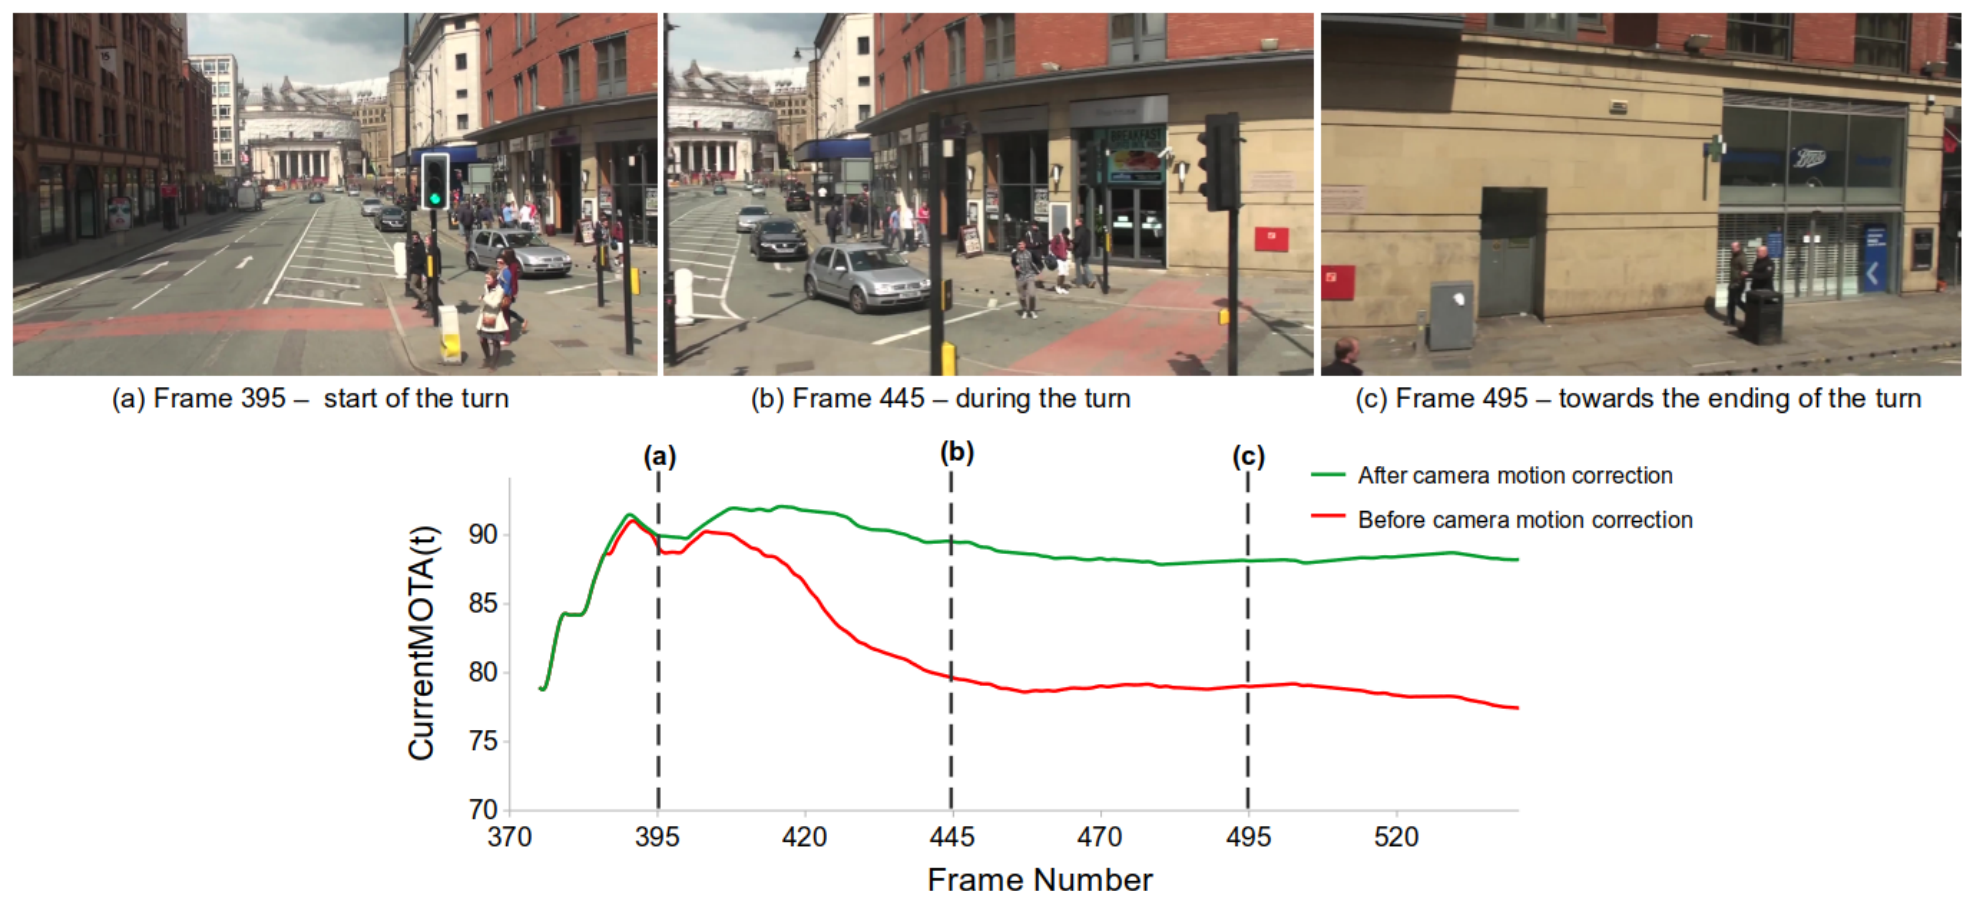
紅線在第 400 到 470 幀之間急速下降,對照上面的畫面,正好是相機轉彎的那一段。加上相機運動補償後,綠線幾乎沒有掉。
討論
偵測器直接用 ByteTrack 公開的 YOLOX 權重,re-ID 模型是 FastReID 的 SBS-50,訓練 60 個 epoch。追蹤參數沿用 ByteTrack:分數門檻 0.6、相似度低於 0.2 拒絕配對、遺失軌跡保留 30 幀。為了公平比較,也和 ByteTrack 一樣使用最大間隔 20 幀的線性插值。實驗在一張 RTX 3060 上跑。
每一項改動的貢獻
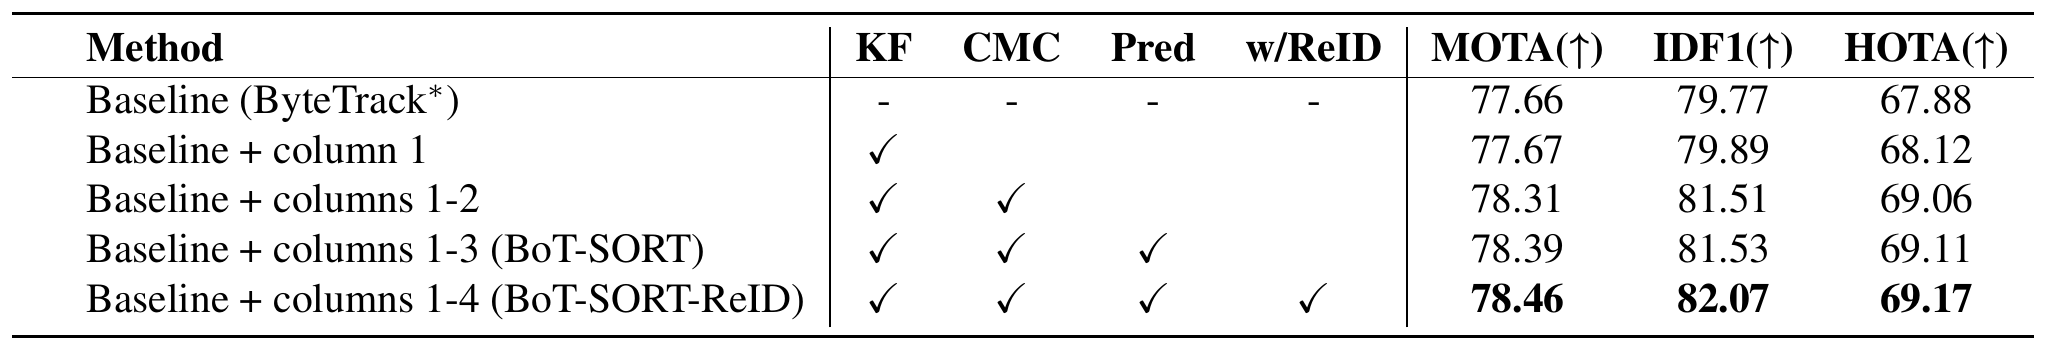
表中的 Pred 是另一個小改動。在高幀率影片中,軌跡短暫沒配到偵測時,用卡爾曼濾波的預測框繼續輸出,而不是讓它消失。
從基準一路加上去:
- 新的卡爾曼濾波: HOTA +0.24,MOTA 和 IDF1 幾乎不變。
- 相機運動補償: MOTA +0.64、IDF1 +1.62、HOTA +0.94,是四項中最大的一步。
- 預測輸出: 三項都只多一點點。
- re-ID: IDF1 再 +0.54,MOTA 和 HOTA 小幅上升。
從 ByteTrack 到 BoT-SORT-ReID,HOTA 多了約 1.3,IDF1 多了約 2.3,其中超過一半來自相機運動補償。
作者也比較了第一次關聯該怎麼用外觀特徵。只用 IoU 是 MOTA 78.4、IDF1 81.5、HOTA 69.1;只用餘弦距離掉到 73.7、70.0、62.4;JDE 式的「外觀距離加卡爾曼濾波門檻」是 77.7、80.1、68.2;用 IoU 過濾後只看餘弦距離是 78.3、81.0、68.7。除了作者提出的融合方式(78.5、82.1、69.2),其他用到 re-ID 的作法都輸給單純的 IoU。作者因此建議,資源有限的應用,只用 IoU 就是不錯的選擇。
排行榜
MOT17 測試集上:
- BoT-SORT:MOTA 80.6、IDF1 79.5、HOTA 64.6。
- BoT-SORT-ReID:MOTA 80.5、IDF1 80.2、HOTA 65.0。
作者說,BoT-SORT-ReID 是第一個在 MOT17 上 IDF1 超過 80 的追蹤器。和 ByteTrack 的 80.3、77.3、63.1 相比,MOTA 差不多,IDF1 和 HOTA 都明顯提升;ID 切換從 ByteTrack 的 2196 次降到 1212 次。
MOT20 測試集上,BoT-SORT-ReID 是 MOTA 77.8、IDF1 77.5、HOTA 63.3;ByteTrack 是 77.8、75.2、61.3。MOTA 持平,IDF1 和 HOTA 一樣有進步。
速度是代價。表中 BoT-SORT 在 MOT17 上是 6.6 FPS,BoT-SORT-ReID 是 4.5 FPS,ByteTrack 則是 29.6 FPS。不過作者也提醒,各方法量速度的硬體不同,大多也不計入偵測時間,FPS 很難直接比較。
作者承認的限制
- 相機運動補償可能失敗。 畫面裡動態物體太多時,背景的關鍵點不夠,相機運動估計就會出錯;錯的補償可能讓追蹤器做出預期外的行為。
- 運算時間。 大尺寸影像的全域運動估計很花時間。作者認為,和偵測器的推論時間相比,這部分可以忽略,也可以用多執行緒平行計算。
- 外觀特徵讓追蹤器變慢。 他們只對高分偵測抽特徵來降低成本;必要時,也可以把特徵抽取併進偵測器的輸出頭,改成 JDE 那種聯合架構。
後來
BoT-SORT 後來成了 Ultralytics YOLO 追蹤模組的預設追蹤器,另一個選項是 ByteTrack。Ultralytics 的說明建議,手持、空拍或車載這類移動相機的影片用 BoT-SORT;只求速度、相機固定的話,ByteTrack 的負擔最小。它的設定檔把相機運動估計做成可替換的選項,預設是稀疏光流,也能換成 ORB、SIFT、ECC 或關閉;re-ID 則是選配。
Roboflow 的追蹤器文件也給了類似的建議,移動相機要開相機運動補償,固定相機若需要最快的速度可以關掉;在缺乏紋理的背景上,以稀疏特徵為基礎的運動估計可能不可靠。這和論文自己寫的第一個限制是同一件事。
結論
卡爾曼濾波直接估計寬和高,預測框跟著相機一起搬,IoU 和外觀先過濾、再取最小,BoT-SORT 在 ByteTrack 上就做了這三件事。消融顯示,最大的一步是相機運動補償;再加上 re-ID 的 BoT-SORT-ReID,MOT17 的 IDF1 越過了 80。
手機、無人機或車上拍的影片,相機運動補償大概是最該先打開的開關。監視器鎖在牆上不動的話,就把它關掉,把那幾毫秒留給偵測器吧!