原始論文
What is being transferred in transfer learning?
- 發表版本
- NeurIPS 2020會議
- arXiv 首次提交
- arXiv:2008.11687
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modeltuningwhatistransferred2020,
  title = {{What is being transferred in transfer learning?}},
  author = {Behnam Neyshabur and Hanie Sedghi and Chiyuan Zhang},
  year = {2020},
  eprint = {2008.11687},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2008.11687}
}
拿 ImageNet 預訓練權重來微調,幾乎是電腦視覺的標準起手式。
照片分類用它,醫學影像用它,連手繪塗鴉也用它。大家都知道有效,常見的解釋是「特徵重用」:預訓練學會了邊緣、紋理、形狀,下游任務直接拿來用。
可是這個解釋有一個明顯的漏洞。胸腔 X 光和 ImageNet 的照片長得一點都不像,塗鴉更是幾條線而已,為什麼預訓練還是有幫助?
Google 的 Neyshabur、Sedghi、Zhang 三人設計了一組實驗,把「預訓練到底帶過去了什麼」拆成幾個可以量的問題。其中一個答案,後來成了模型合併的重要依據。
定義問題
作者把模型分成四種,後面會一直用到這組縮寫:
- P:ImageNet 預訓練好的模型。
- RI:隨機初始化的模型。
- P-T:從 P 出發,在目標資料上微調(fine-tune)後的模型。
- RI-T:從 RI 出發,直接在目標資料上訓練的模型。
目標任務選了四個和 ImageNet 距離不同的資料集。DomainNet 的 real(真實照片)、clipart(美工圖案)、quickdraw(Google「Quick, Draw!」遊戲裡玩家的塗鴉),以及 CheXpert 的胸腔 X 光,越往後越不像自然照片。
DomainNet 每個領域有 345 個物件類別,作者各抽 5 萬張訓練、5 萬張測試;CheXpert 則從訓練集抽兩組各 5 萬張,當作訓練與測試,任務是判斷五種胸腔病徵。
模型一律是 ResNet-50,搭配 Fixup 初始化,拿掉了所有 BatchNorm 層。
要回答的問題有三個。預訓練的好處有多少來自特徵重用?P-T 和 RI-T 在參數空間裡有什麼不同?網路的哪些部分真正在轉移?
解決問題
先看學習曲線
在四個目標任務上,P-T 都比 RI-T 好,而且收斂快很多。差距最大的是 real,這符合特徵重用的直覺,畢竟真實照片和 ImageNet 最像。
但 CheXpert 和 quickdraw 上也有提升。至少在這兩個任務上,「重用視覺特徵」似乎解釋不了全部。
把圖片打散
為了把特徵重用拆出來,作者做了一個很直接的實驗。把目標資料的影像切成大小相同的方塊,隨機打亂位置。
224×224 的方塊等於沒打亂;方塊越小,物體的形狀和結構就被破壞得越徹底。1×1 時每個像素都被打散,但一個像素的 RGB 三個值仍綁在一起移動,所以作者又多做一種「*」設定,讓每個通道的像素各自亂跑,甚至跑到別的通道去。
到了「*」,影像只剩下一堆像素值的分布,任何視覺結構都沒了,預訓練學到的邊緣和紋理不可能派上用場。
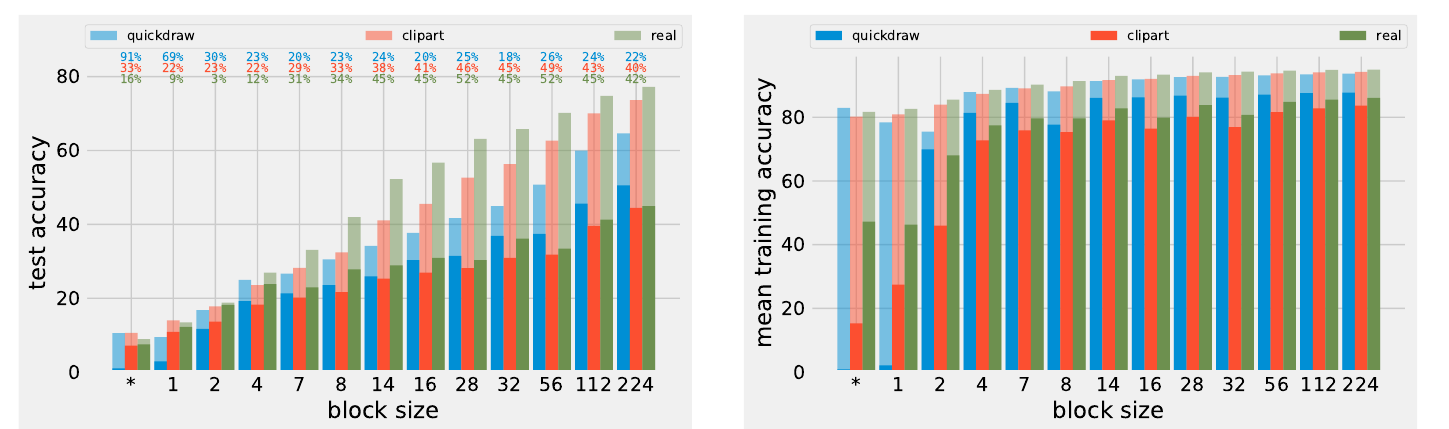
左圖上方那三排小數字最值得看。它們是相對準確率差距 ,也就是預訓練帶來的好處佔了多少比例。
real(綠色)在沒打亂時是 42%,方塊縮到 2 時剩下 3%。clipart(紅色)也從 40% 左右降到 20% 出頭。方塊越小,預訓練的好處越少,這是特徵重用的證據。
quickdraw(藍色)不一樣。它在大部分方塊大小都維持在 20% 到 25% 左右,沒有隨方塊變小而下降;到了 1×1 和「*」,數字反而衝到 69% 和 91%。這兩組 RI-T 幾乎學不起來,相對差距才會這麼大。
右圖是訓練速度。P-T 的訓練準確率不管方塊多小都很穩定,RI-T 則在小方塊時大幅下降。在「*」設定下,quickdraw 的 RI-T 平均訓練準確率接近零,P-T 仍在 80% 以上。
這張圖把預訓練的好處拆成兩部分:
- 特徵重用:和預訓練資料越像,貢獻越大,影像結構被破壞後就消失。
- 低階統計:即使只剩下像素值的分布,預訓練權重仍然讓訓練快很多,有時也讓最終準確率更好。
作者用「低階統計」稱呼後者,強調它不帶任何視覺或語意結構。至於預訓練權重的哪種性質在幫忙最佳化,例如權重的尺度,論文沒有進一步拆解。
打開模型看看
接著作者比較訓練好的模型本身。
錯誤的重疊。 兩個 P-T(不同隨機種子微調)犯的錯很像;P-T 和 RI-T 之間不一致的錯誤多很多。作者看了 DomainNet 上的例子,P-T 錯、RI-T 對的樣本多半是模稜兩可的圖;P-T 對、RI-T 錯的樣本則包含不少簡單的圖。
特徵相似度。 作者用 CKA(centered kernel alignment)比較兩個模型在同一層輸出的特徵。CheXpert 上的 Table 1:
| 比較對象 | conv1 | layer 1 | layer 2 | layer 3 | layer 4 |
|---|---|---|---|---|---|
| P-T & P | 0.6225 | 0.4592 | 0.2896 | 0.1877 | 0.0453 |
| P-T & P-T | 0.6710 | 0.8230 | 0.6052 | 0.4089 | 0.1628 |
| P-T & RI-T | 0.0036 | 0.0011 | 0.0022 | 0.0003 | 0.0808 |
| RI-T & RI-T | 0.0016 | 0.0088 | 0.0004 | 0.0004 | 0.0424 |
兩個 P-T 在每一層都很像;兩個 RI-T 準確率也不差,特徵卻幾乎不相似。越往輸出端,P-T 和 P 的相似度越低,表示微調主要改動高層。
參數距離。 兩個 P-T 在參數空間裡也很近。CheXpert 上兩個 P-T 的 距離約 200,兩個 RI-T 約 255;DomainNet 三個領域的差距更明顯,兩個 P-T 在 178 到 219 之間,兩個 RI-T 則在 777 到 822 之間。
同一個盆地
這是和模型合併最相關的一節。作者在兩個解 和 之間做線性插值,看路徑上的模型表現:
如果兩個解在同一個平坦的盆地裡,插值路徑也會留在盆地內,表現不會掉下去。
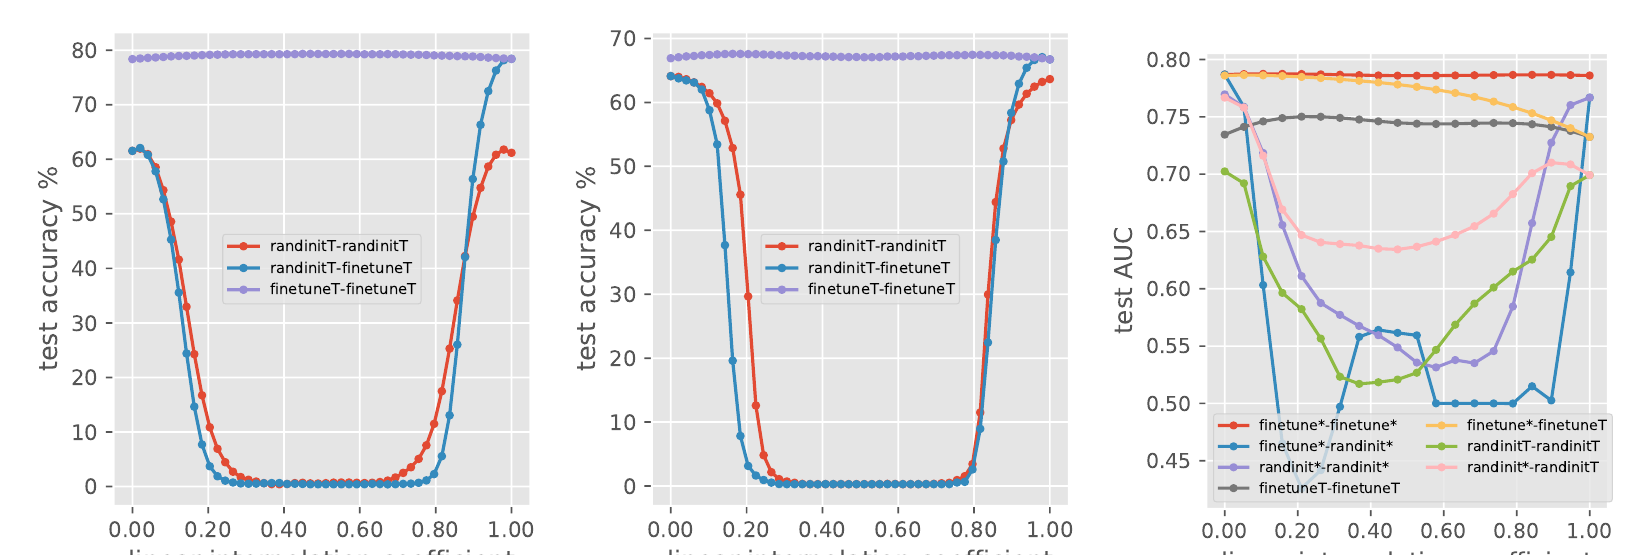
左邊兩張圖很好讀。real 上兩個 P-T 之間的紫色線從頭到尾都在 80% 附近,兩個 RI-T 之間的紅線在中段掉到接近零。quickdraw 也一樣。
更有意思的是,作者讓兩個 RI-T 使用完全相同的隨機初始值,只有訓練過程的隨機性不同,結果還是有障礙。共享起點本身不夠,這個起點必須是預訓練過的。CheXpert 上 RI-T 甚至在同一條訓練軌跡的最佳 checkpoint 和最終 checkpoint 之間,也有一個小障礙;P-T 則沒有。
作者也試著把「盆地」寫成正式定義,稱為 -basin。一個凸集合要算盆地,裡面多數點的損失要接近平均;在集合邊界加高斯雜訊或往外延伸,損失必須明顯上升。用測試錯誤率當損失,兩個 P-T 所在的盆地參數,real 是 、clipart 是 、quickdraw 是 ;兩個 RI-T 則找不到合理的 讓它們落在同一個盆地。
插值路徑中段的模型,有時還比兩端稍好一點。這是本文對後續研究最有用的觀察,同一個預訓練起點出發的微調模型,可以直接取平均。
哪些層在轉移
作者沿用 Zhang 等人的做法,把訓練好的網路中某一個模組倒帶回初始值,其他模組維持訓練後的值,看表現掉多少。掉很多的模組叫做「關鍵」模組。
在 CheXpert 上,P-T 的關鍵模組分布和一般監督式訓練差不多,差別只在全連接層對 P-T 變得關鍵,這很合理,因為分類頭是新任務才訓練的。
作者再擴充 Chatterji 等人的模組關鍵度定義,量測從初始值走到最佳值的路徑上,模組參數能承受多大的雜訊。越靠近輸出的模組,谷地越窄,越不能亂動;靠近輸入的模組比較寬鬆。這呼應了「低層學通用特徵、高層學任務專屬特徵」的舊觀察,也指出特徵重用主要發生在靠近輸入的層。
RI-T 的模組在路徑上還會出現一個轉折點,谷地在那裡忽寬忽窄。作者猜測可能和訓練中途換了盆地有關,但也說不清楚。
預訓練要練到多久
最後一個實驗很實用。作者拿 ImageNet 預訓練過程中每個 epoch 的 checkpoint 來微調;預訓練在第 30、60 個 epoch 衰減學習率。
整體趨勢是越後面的 checkpoint 越好,但有幾個細節:
- 學習率衰減的前後幾個 checkpoint(例如 29、30、31),微調結果差不多。預訓練準確率在衰減時跳了一大截,對下游的幫助卻沒有同步跳升。
- 訓練速度的好處大約在 checkpoint 10 就飽和了;最終準確率則在 real 和 clipart 上一直進步到 checkpoint 60 左右。quickdraw 的最終準確率很早就停在 checkpoint 10。
- 因此,預訓練模型自己的準確率,不一定是轉移效果的可靠指標。
作者把這些結果和盆地的觀察連起來。預訓練早期的 checkpoint 還在最終盆地之外,進入盆地之後,從哪個 checkpoint 出發差不多,所以可以從比較早的 checkpoint 開始微調。
討論
這篇是分析型論文,沒有提出新方法,它的價值在於幾個可以拿去用的觀察。
證據的範圍要記住。所有實驗只有一個架構(無 BatchNorm 的 ResNet-50)、一個預訓練來源(ImageNet),目標任務是四個影像資料集。作者在相關研究中明說,NLP 的轉移學習在資料性質、預訓練方式和分布差距上都不同,這篇只研究視覺。
「低階統計」也只是一個描述。它告訴我們打散影像後還剩下某種好處,至於是像素分布、權重尺度還是其他最佳化上的性質在起作用,論文沒有分開驗證。模組關鍵度的轉折點,作者也只留下猜測。
「同一個盆地」這個觀察的影響最大。作者在結論只用一句話提到,同一盆地內的模型取平均不會破壞表現。兩年後,Model Soups 把它變成一個實際的做法,把許多用不同超參數微調的模型直接平均,並引用這篇作為平均可行的依據。
結論
預訓練帶過去的東西有兩種。一種是視覺特徵,下游資料越像 ImageNet 越有用;另一種是連像素都打散了還在的低階統計,它主要讓訓練變快。
從同一個預訓練權重出發的微調模型,彼此特徵相近、參數距離近,線性插值沒有障礙。從頭訓練的模型就算共用同一組隨機初始值,也做不到這一點。
下次拿到兩個從同一個預訓練模型微調出來的權重,先別急著挑一個。把它們平均一下試試,說不定兩個都比不上中間那一個。