原論文
DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models
- 発表先
- 正式な発表先は未確認
- arXiv への初回投稿
- arXiv:2402.03300
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{deepseekdeepseekmath2024,
  title = {{DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models}},
  author = {Zhihong Shao and Peiyi Wang and Qihao Zhu and Runxin Xu and Junxiao Song and Xiao Bi and Haowei Zhang and Mingchuan Zhang and Y. K. Li and Y. Wu and Daya Guo},
  year = {2024},
  eprint = {2402.03300},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2402.03300}
}
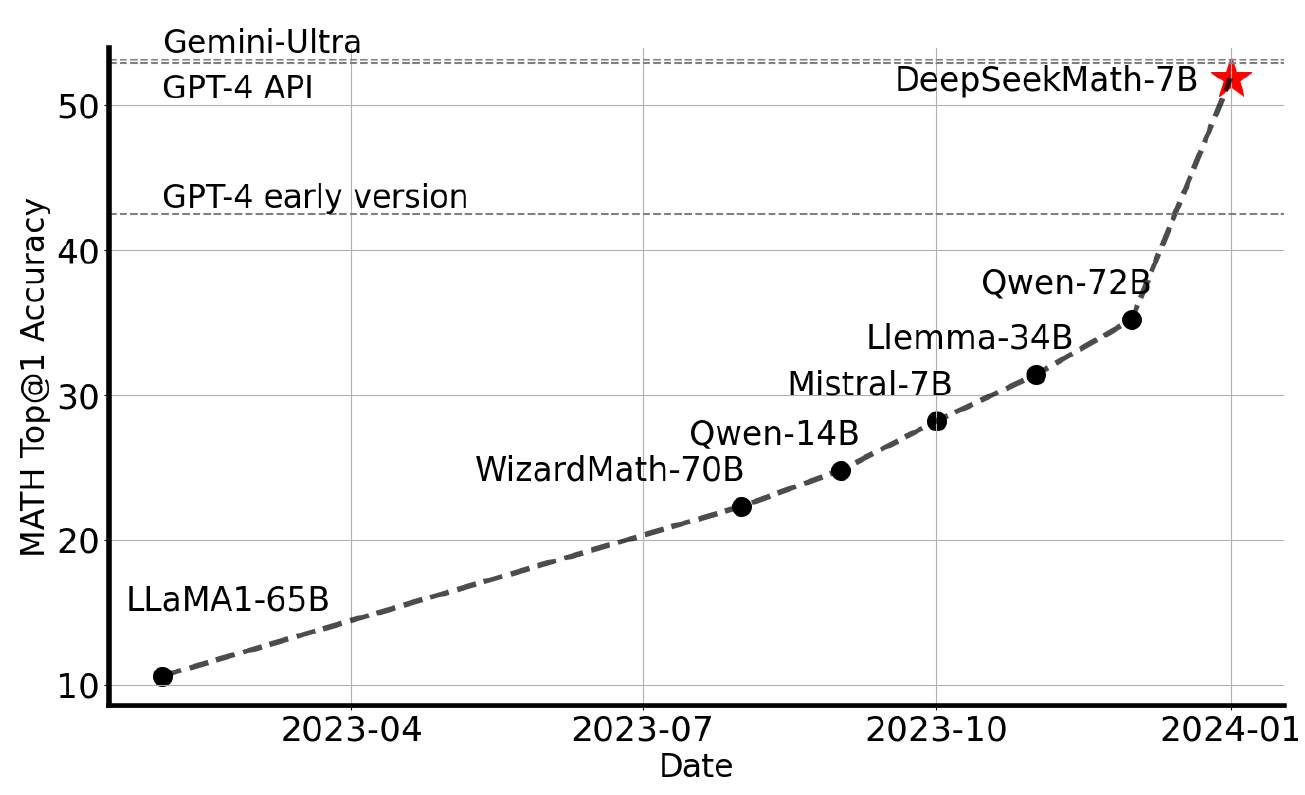
2024 年初め、競技数学の評価 MATH で、GPT-4 と Gemini Ultra はすでに 50% を超えていたが、オープンソースのモデルはまだはるかに及ばなかった。これらのクローズドなモデルがどんなデータを使い、どう訓練したのかは、外からはわからない。
DeepSeek の Shao、Wang、Zhu らは、オープンソースの数学モデルを、しかも 7B のパラメータだけで作ろうとした。彼らがしたことは二つある。公開されている Common Crawl のウェブページから、1,200 億 token の数学データをすくい上げたこと。そして PPO より資源を食わない強化学習アルゴリズム、GRPO を提案したことだ。
その結果、DeepSeekMath 7B は外部ツールも投票も使わずに MATH で 51.7% を取り、Gemini Ultra と GPT-4 に迫った。64 回サンプリングして投票すると 60.9% になる。
問題の定義
この論文が答えようとする問いは二つある。
第一に、良い数学データはどこから来るのか? 既存の数学コーパスの多くは、arXiv の論文か、規模の小さいウェブページの集まりから来ている。公開のウェブページに、十分な量と質の数学コンテンツは本当にあるのか?
第二に、教師あり微調整の後、強化学習でさらにどこまで押し上げられるのか? PPO は当時最もよく使われていたやり方だが、モデルと同じ大きさの価値モデルを追加で訓練する必要があり、コストが高い。
問題を解く
その1:Common Crawl から数学のウェブページをすくい上げる
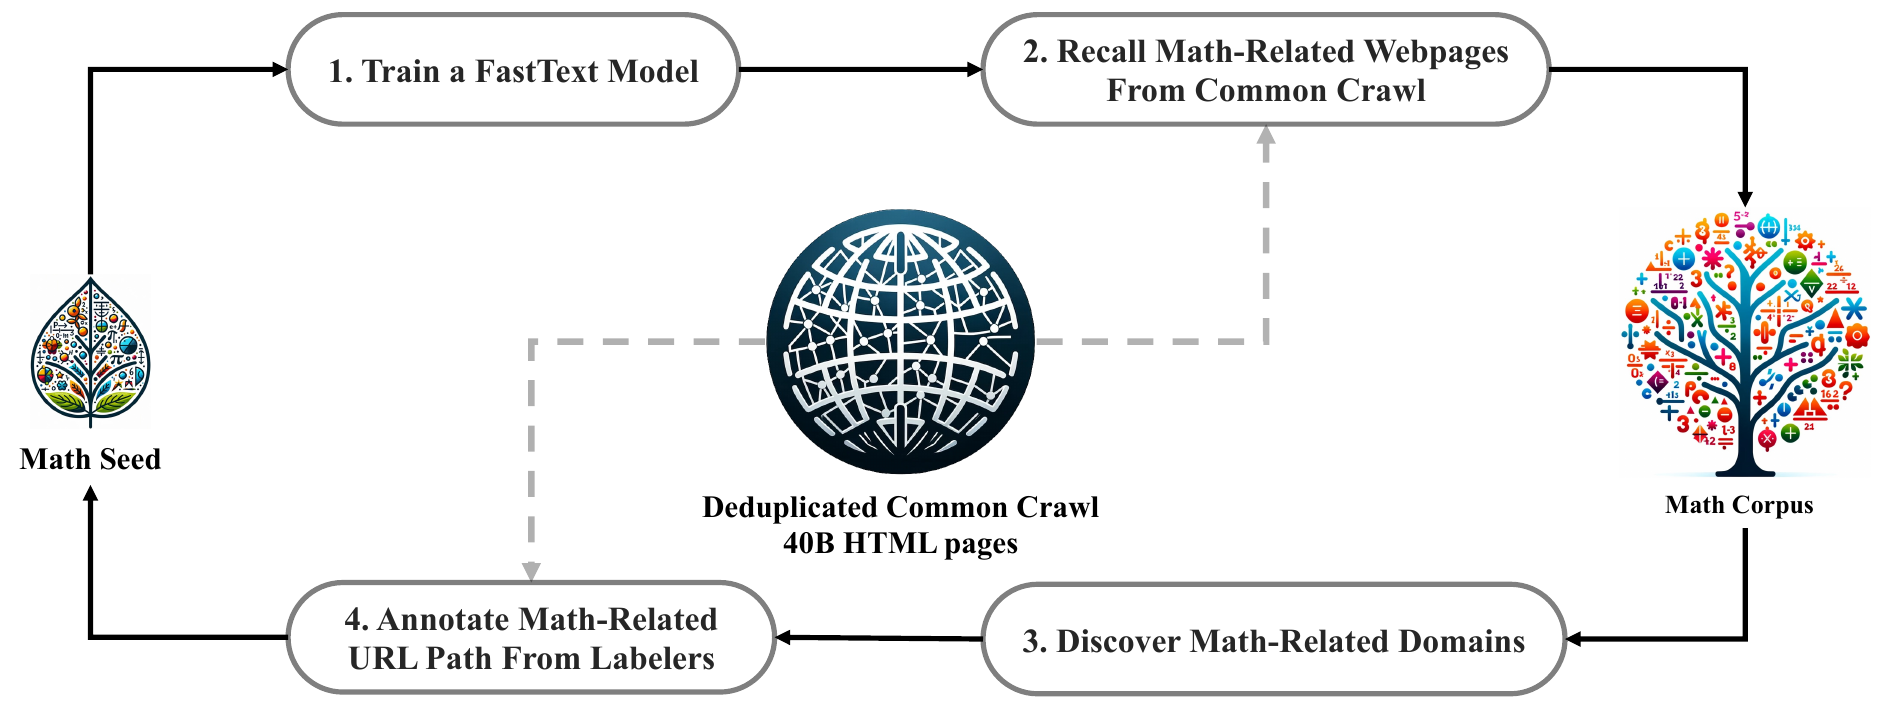
流れはループになっている。
- 分類器を訓練する:高品質な数学のウェブページ集 OpenWebMath をシードとして、そこから無作為に 50 万件を取って正例とし、Common Crawl から無作為に 50 万ページを取って負例として、fastText の分類器を訓練する。
- ページを拾い上げる:まず Common Crawl の重複を除くと、400 億個の HTML ページが残る。分類器で採点し、スコアが最も高い一部だけを残す。第一ラウンドでは上位 400 億 token を残した。
- 数学のドメインを見つける:第一ラウンドの分類器は OpenWebMath しか見ていないので、正例の多様性が足りず、多くの数学のページを取りこぼしていた。著者らはページをドメインごとにまとめ、あるドメインのページの 10% 以上が集められていれば、そのドメインを数学関連とみなした。たとえば mathoverflow.net だ。
- URL を人手でラベルづけする:これらのドメインの中で、どの URL パスが数学の内容かを人が印をつける。たとえば mathoverflow.net/questions だ。これらのパスの下でまだ集められていないページをシードデータに戻し、分類器を訓練し直す。
四ラウンド回した後、3,550 万ページ、1,200 億 token が得られた。第四ラウンドで集めたデータの 98% 近くは第三ラウンドですでに集められていたので、ここで止めた。
評価の問題が訓練データに紛れ込むのを避けるため、ある文章の断片が GSM8K、MATH、CMATH、AGIEval といった評価のどれかの部分文字列と 10 語連続で完全に一致したら、その断片を丸ごと削除した。評価の文章が 10 語に満たないが 3 語以上ある場合は、完全一致で照合した。
データの良し悪しは小さいモデルで試す
著者らは 1.3B の DeepSeek-LLM を、各数学コーパスでそれぞれ 1,500 億 token 訓練して、効果を比べた。
| 数学コーパス | サイズ | GSM8K | MATH | CMATH |
|---|---|---|---|---|
| 数学の訓練なし | - | 2.9 | 3.0 | 12.3 |
| MathPile | 8.9B | 2.7 | 3.3 | 1.2 |
| OpenWebMath | 13.6B | 11.5 | 8.9 | 16.8 |
| Proof-Pile-2 | 51.9B | 14.3 | 11.2 | 19.9 |
| DeepSeekMath Corpus | 120.2B | 23.8 | 13.6 | 41.5 |
原論文 Table 1 をもとに整理。一部の列を抜粋。少数ショットの思考の連鎖、単位は %。
DeepSeekMath Corpus はどの項目でも先頭に立っている。中国語の数学のウェブページも含んでいるので、中国語の CMATH での向上が特に大きい。英語だけのコーパスは中国語の評価にはほとんど役に立たず、MathPile にいたっては CMATH を 12.3% から 1.2% に下げてしまった。
もう一つの強みは大きさだ。ほかのコーパスは比較的小さく、1,500 億 token 訓練するには何周も繰り返し読ませることになり、モデルの性能はすぐに頭打ちになった。
DeepSeekMath-Base 7B
ベースモデルは DeepSeek-Coder-Base-v1.5 7B から始め、さらに 5,000 億 token の訓練を続けた。データの比率は、DeepSeekMath Corpus が 56%、数学のコード AlgebraicStack が 4%、arXiv が 10%、GitHub のコードが 20%、中国語と英語の一般のウェブページが 10% だ。
| モデル | サイズ | GSM8K | MATH |
|---|---|---|---|
| Minerva | 540B | 58.8 | 33.6 |
| Mistral | 7B | 40.3 | 14.3 |
| Llemma | 34B | 54.0 | 25.3 |
| DeepSeekMath-Base | 7B | 64.2 | 36.2 |
原論文 Table 2 をもとに整理。一部の行と列を抜粋。少数ショットの思考の連鎖、単位は %。
MATH では、DeepSeekMath-Base はほかのオープンソースのベースモデルを 10 ポイント以上上回り、Google の Minerva 540B も超えている。Minerva は PaLM をもとに数学のデータで追加訓練したもので、パラメータは DeepSeekMath の 77 倍だ。
数学の訓練は一般的な能力も高めた。出発点の DeepSeek-Coder-Base-v1.5 と比べると、MMLU は 42.9% から 54.9% に、BBH は 42.9% から 59.5% に上がった。訓練データにはコードも含まれているので、プログラミングの能力もおおむね保たれた。
コードを先に、数学を後に
「プログラミングを学ぶと推論能力が上がる」というのはよく耳にする説だが、きちんと検証されてはいなかった。著者らは 1.3B のモデルで比較実験を行った。
| 訓練のしかた | GSM8K | MATH | GSM8K(Python 使用) | MATH(Python 使用) |
|---|---|---|---|---|
| 一般のテキスト 400B → 数学 150B | 19.1 | 14.4 | 14.3 | 6.7 |
| コード 400B → 数学 150B | 21.9 | 15.3 | 17.4 | 9.4 |
| 数学だけを訓練 150B | 20.5 | 13.1 | 11.4 | 6.5 |
| コード 400B と数学 150B を混ぜて訓練 | 17.6 | 12.1 | 19.7 | 13.5 |
原論文 Table 6 をもとに整理。一部の行と列を抜粋。単位は %。
先にコードを学んでから数学を学ぶと、Python で解くかどうかにかかわらず、先に一般のテキストを学ぶより良い。著者らがコードモデルから訓練を始めることにしたのも、これが理由だ。
コードと数学を混ぜて訓練すると、Python で解く能力は最も高く、コードの書き方も忘れにくい。ただ、ツールを使わないときの数学的推論はむしろ悪くなった。著者らは、1.3B のモデルは小さすぎて、二種類のデータを同時に吸収するのが難しかったのだろうと推測している。
arXiv の論文は役に立たない:数学コーパスにはよく arXiv の論文が含まれるが、著者らが調べたところ、arXiv だけで訓練しても、1.3B でも 7B でも、さまざまな数学の評価で目立った向上はなく、ときには後退することもあった。著者らは、この結論には限界があるとも注意している。これらの評価では測れていないだけかもしれないし、ほかのデータと混ぜたり、モデルがもっと大きかったりすれば、結果が変わる可能性もある。
教師あり微調整
数学の指示データは 77.6 万件で、中国語と英語の、小学校から大学レベルまでの問題を含む。解答には三つの形式がある。思考の連鎖、プログラムによる思考(Python のプログラムを書いて解く)、そして自然言語の推論とプログラムツールを交互に使う形式だ。500 ステップ、バッチ 256、学習率 で訓練して DeepSeekMath-Instruct 7B を得た。MATH はツールなしで 46.8%、ツールありで 57.4% だった。
その2:GRPO、価値モデルを外す
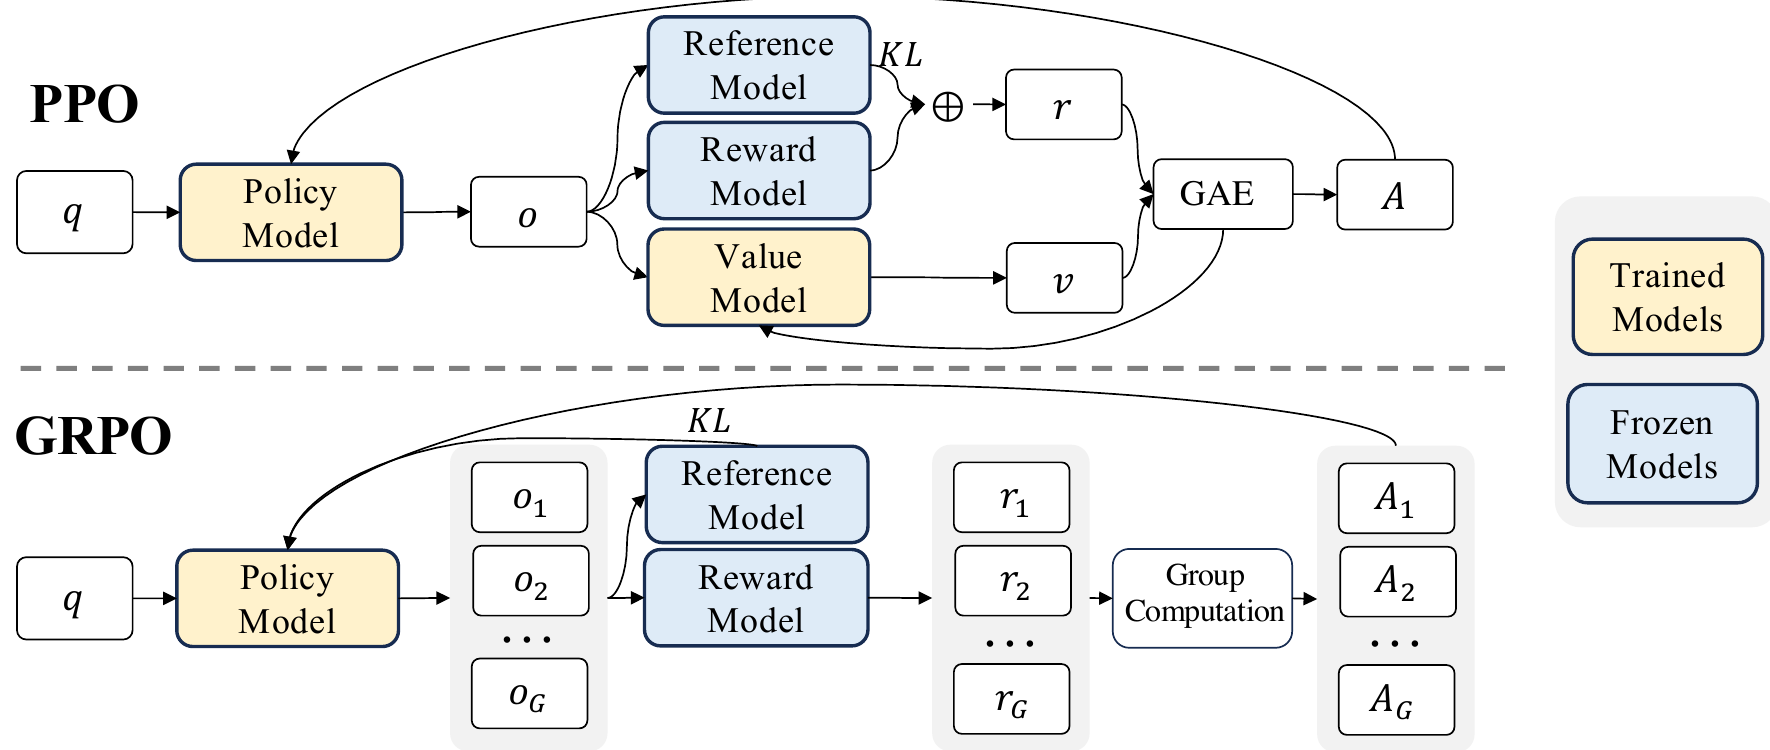
PPO の目的関数は次のとおりだ。
ここでアドバンテージ は GAE で計算する必要があり、学習した価値関数が要る。この価値モデルはたいてい方策モデルと同じ大きさで、メモリも計算量も倍になる。しかも言語モデルの報酬はふつう最後の token でしか与えられないので、各 token で正確な価値関数を訓練すること自体が難しい。
GRPO の発想は単純だ。同じ問題に対してモデルに 個の回答を書かせ、この回答群の平均報酬を基準にする。平均より良いものは後押しし、平均より悪いものは罰する。これで価値モデルはもう要らない。
ここで は、 番目の回答の 番目の token における、新旧の方策の確率比だ。
結果監督では、報酬モデルが各回答に一つの点数をつけ、それをグループ内の平均と標準偏差で標準化する。その回答のすべての token が、同じ値をアドバンテージとして使う。
正解なら 1 点、不正解なら 0 点の報酬で計算してみよう。
import statistics

def group_advantages(rewards, eps=1e-8):
    """GRPO の結果監督:同じ問題に対する G 個の回答の報酬を、グループ内の平均と標準偏差で標準化する"""
    mean = statistics.mean(rewards)
    std = statistics.pstdev(rewards)          # ここでは母標準偏差を使う
    return [round((r - mean) / (std + eps), 2) for r in rewards]

# 同じ問題から回答を 8 個サンプリングし、正解なら 1 点、不正解なら 0 点
for rewards in ([1, 0, 0, 1, 0, 0, 0, 0], [1, 1, 1, 1, 1, 1, 1, 0], [1] * 8):
    print(rewards, "→", group_advantages(rewards))

# [1, 0, 0, 1, 0, 0, 0, 0] → [1.73, -0.58, -0.58, 1.73, -0.58, -0.58, -0.58, -0.58]
# [1, 1, 1, 1, 1, 1, 1, 0] → [0.38, 0.38, 0.38, 0.38, 0.38, 0.38, 0.38, -2.65]
# [1, 1, 1, 1, 1, 1, 1, 1] → [0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0]
難しい問題で数少ない正解の回答は、大きな正のアドバンテージを得る。簡単な問題でただ一つ間違えた回答は、重く罰せられる。すべて正解(またはすべて不正解)の問題では、どの回答のアドバンテージも 0 になり、その問題は訓練にまったく寄与しない。サンプリングに使った計算はまるごと無駄になる。
プロセス監督では、プロセス報酬モデルが各回答の各ステップに点数をつけ、同じくすべてのステップの点数の平均と標準偏差で標準化する。ある token のアドバンテージは、それより後のすべてのステップの標準化された点数の合計だ。
KL の扱いも違う。PPO は KL ペナルティを各 token の報酬に加える。GRPO は KL を損失関数に直接加え、アドバンテージの計算を乱さないようにする。KL には次の推定式を使う。これは不偏で、しかも 0 を下回らない。
二つの確率の対数比をそのまま使う場合と比べてみよう。
import math

def kl_estimate(p_theta, p_ref):
    """原論文の式 (4):π_ref/π_θ − log(π_ref/π_θ) − 1。0 を下回ることはない"""
    ratio = p_ref / p_theta
    return ratio - math.log(ratio) - 1

for p_theta, p_ref in [(0.5, 0.5), (0.6, 0.5), (0.4, 0.5), (0.9, 0.3)]:
    print(f"π_θ={p_theta}  π_ref={p_ref}  log(π_θ/π_ref)={math.log(p_theta / p_ref):+.3f}  式(4)={kl_estimate(p_theta, p_ref):.3f}")

# π_θ=0.5  π_ref=0.5  log(π_θ/π_ref)=+0.000  式(4)=0.000
# π_θ=0.6  π_ref=0.5  log(π_θ/π_ref)=+0.182  式(4)=0.016
# π_θ=0.4  π_ref=0.5  log(π_θ/π_ref)=-0.223  式(4)=0.027
# π_θ=0.9  π_ref=0.3  log(π_θ/π_ref)=+1.099  式(4)=0.432
対数比は正にも負にもなるので、一つの token についての推定値が負になることがある。式 (4) は二つの分布が同じとき 0 で、それ以外ではつねに正になり、差が大きいほど値も大きくなる。
反復 GRPO:訓練が長くなると、古い報酬モデルは方策モデルについていけなくなることがある。著者らは方策モデルの新しいサンプリング結果から報酬モデルの新しい訓練データを作り、10% の古いデータと合わせて報酬モデルの訓練を続け、さらに参照モデルを現在の方策モデルに置き換えて訓練を続けた。
訓練設定
- データ:SFT データのうち、GSM8K と MATH に関連する思考の連鎖形式の約 14.4 万問だけを使う。ほかの問題はわざと使わず、強化学習が訓練していない評価にどんな影響を与えるかを観察できるようにした。
- 報酬モデル:Math-Shepherd のやり方で訓練データを構築し、DeepSeekMath-Base 7B から学習率 で訓練する。
- 方策モデル:学習率 、KL 係数 0.04、各問につき 64 個の回答をサンプリングし、最大 1,024 token、バッチサイズ 1,024。サンプリングのたびに一回だけ更新する。
議論
結果
| モデル | GSM8K | MATH | MGSM-zh | CMATH |
|---|---|---|---|---|
| Gemini Ultra | 94.4 | 53.2 | - | - |
| GPT-4 | 92.0 | 52.9 | - | 86.0 |
| DeepSeek-LLM-Chat 67B | 84.1 | 32.6 | 74.0 | 80.3 |
| Instruct 7B | 82.9 | 46.8 | 73.2 | 84.6 |
| RL 7B | 88.2 | 51.7 | 79.6 | 88.8 |
原論文 Table 5 の、思考の連鎖でツールを使わない部分をもとに整理。一部の行を抜粋。Instruct 7B と RL 7B は DeepSeekMath の二つの 7B モデル。単位は %。
GRPO で GSM8K は 82.9% から 88.2% に、MATH は 46.8% から 51.7% に上がり、7B から 70B までのすべてのオープンソースモデルを上回り、クローズドなモデルの大半も超えた。ただし GPT-4 と Gemini Ultra にはまだわずかに届かない。
強化学習に使ったのは GSM8K と MATH の英語の問題だけなのに、中国語の MGSM-zh と CMATH も一緒に良くなった。ツールの使用を許すと、MATH は 57.4% から 58.8% に上がり、こちらも向上している。強化学習のデータはすべて思考の連鎖形式だったにもかかわらず、だ。
統一的な見方
著者らはさまざまな微調整の手法を同じ形式で書いた。その勾配はどれも次の形をしている。
違いは三か所だけだ。データの出どころ (問題と回答がどこから来るか)、報酬関数 (信号がどこから来るか)、そして勾配係数 (各 token をどれだけ後押しし、あるいは罰するか)。
- SFT:人が用意したデータで、各 token の係数はすべて 1。
- 棄却サンプリング微調整(RFT):SFT モデル自身からサンプリングし、正解したものだけを残す。正解なら係数 1、不正解なら 0。これは STaR の選別と同じことだ。
- オンライン RFT:同じ規則だが、訓練中のモデルからサンプリングする。
- DPO:SFT モデルから回答の組をサンプリングし、ペアの損失で訓練する。
- PPO と GRPO:訓練中のモデルからサンプリングし、係数は報酬で決まる。正にも負にもなり、大きさも違う。
1.3B の Instruct モデルでこれらの手法を比べ、著者らはいくつかの観察を得た。
- オンラインのサンプリングはオフラインより良い:オンライン RFT は最初は RFT とほぼ同じだが、訓練の後半になるとはっきり勝つ。モデルと SFT モデルの差がどんどん開いていくので、自分でサンプリングしたデータでないとついていけないからだ。
- 間違いを罰するほうが、正解を後押しするだけより良い:GRPO はオンライン RFT に勝つ。オンライン RFT は間違った回答を罰さず、正解した回答もすべて同じように扱う。GRPO は報酬の大きさに応じて、後押しと罰の強さを調整する。
- プロセス監督は結果監督より良い:プロセス監督と組み合わせた GRPO は、結果監督と組み合わせたものに勝つ。
- 反復は効く:この項目は 7B の Instruct モデルに替えて試したもので、反復的な強化学習は性能をはっきり高め、特に最初のラウンドの効果が大きい。
強化学習はいったい何を変えたのか
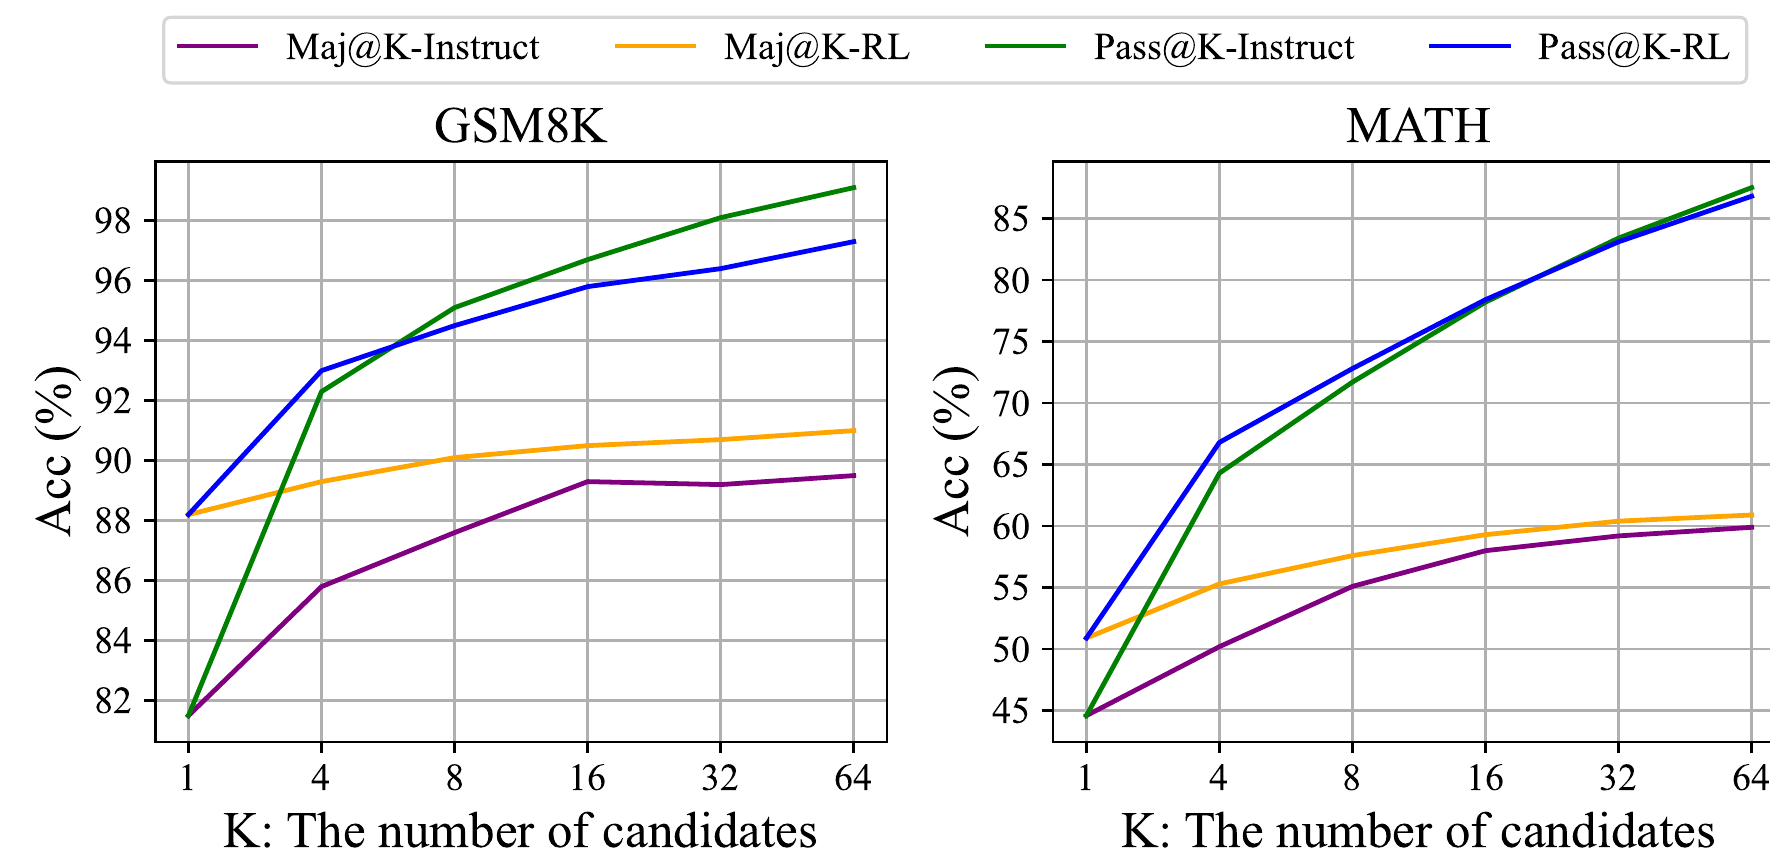
この図は、論文全体で最もじっくり見る価値がある。Maj@K は 回サンプリングして投票で選んだ答えが正しいかどうか、Pass@K は 回サンプリングして一回でも正解すれば正解とみなすものだ。
強化学習は Maj@K を上げたが、Pass@K は上げなかった。サンプリング回数が十分に多ければ、元の Instruct モデルでも同じだけの問題に正解できる。著者らの解釈では、強化学習は出力の分布をより安定させ、もともと上位にあった正しい答えを先頭に押し出した。もともとまったく解けなかった問題を、新たに解けるようにしたのではない。
著者らは結びでも、SFT 段階の問題と最も単純な nucleus サンプリングしか使っていないことが、Maj@K だけが向上した原因かもしれないと述べている。今後は、分布外の問題や、木探索と組み合わせたより高度なサンプリング方法を試したいという。
限界
- 幾何と証明が弱い:モデルは三角形や楕円に関する問題を扱えない。著者らは、事前学習と微調整のデータの選び方に偏りがあったのかもしれないと考えている。
- 少数ショットの能力が GPT-4 に及ばない:GPT-4 は例を与えると良くなるが、DeepSeekMath は例があってもなくてもほとんど変わらない。著者らはこれをモデルの規模のせいだとしている。
- 報酬の信号が当てにならない:既存の手法はどれも報酬モデルの信号を完全に信じているが、人手で丁寧にラベルづけされた PRM800K でさえ、約 20% のラベルが間違っていることがわかっている。著者らは、ノイズのある報酬に耐えられる強化学習アルゴリズムが必要だと考えている。
その後
一年もたたないうちに、DeepSeek-R1 は GRPO を使ったが、報酬を単純なルールに置き換えた。答えが正しいか、形式が正しいか、だ。ニューラルネットワークの報酬モデルを使わないので、報酬モデルの抜け穴を突かれる問題もない。DeepSeek-R1-Zero にいたっては教師あり微調整を飛ばし、ベースモデルから直接強化学習を始めている。GRPO はその後、オープンソースの推論モデルで最もよく使われる強化学習アルゴリズムの一つになった。
GRPO そのものも詳しく検証された。2025 年 3 月の Dr. GRPO は、GRPO の目的関数には最適化上の偏りがあり、訓練中に回答を人為的に長くしてしまい、間違った回答では特にそれが目立つと指摘し、偏りのない修正版を提案した。
Figure 7 の観察も、一年後に拡大して検証された。2025 年 4 月、Yue らは Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model? で、より大きな を使って強化学習の前後のモデルを比べた。 が小さいときは強化学習後のモデルのほうが良いが、 が大きいときはベースモデルの pass@k のほうがむしろ高い。彼らの結論は、この種の強化学習で得られる推論能力はベースモデルから来ていて、ベースモデルに制約されている、というものだ。これは、この論文自身が 2024 年に描いたあの図が言っていることと同じだ。
結論
DeepSeekMath は 7B のパラメータで、MATH でツールも投票も使わずに 51.7% を取り、当時の GPT-4 に迫った。手柄は半分ずつに分けられる。半分は Common Crawl から反復的にすくい上げた 1,200 億 token の数学のウェブページ、もう半分は価値モデルを外し、同じ問題に対する一組の回答を互いに比べる GRPO だ。
この論文の分析の部分は見過ごされがちだが、実はかなり読みごたえがある。コードを先に学ぶほうが良い、arXiv はあまり役に立たない、オンラインのサンプリングはオフラインに勝つ、間違いを罰するほうが正解に報酬を与えるだけより効く。どれも、後の人たちが繰り返し使うことになった知見だ。
最も誠実なのは Figure 7 だ。著者ら自身が、強化学習は投票の正解率を上げただけで、「少なくとも一回は正解する」割合は上げていないことを図に描き、進歩は能力が強くなったからではなく、正しい答えを前に押し出したことから来ているのかもしれないと、正直に書いている。一年後、分野全体がかなりの労力をかけて、このことをもう一度確かめ直した。