原論文
Self-Instruct: Aligning Language Models with Self-Generated Instructions
- 発表先
- ACL 2023国際会議
- arXiv への初回投稿
- arXiv:2212.10560
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{modeltuningselfinstruct2022,
  title = {{Self-Instruct: Aligning Language Models with Self-Generated Instructions}},
  author = {Yizhong Wang and Yeganeh Kordi and Swaroop Mishra and Alisa Liu and Noah A. Smith and Daniel Khashabi and Hannaneh Hajishirzi},
  year = {2022},
  eprint = {2212.10560},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2212.10560}
}
指示チューニングには指示データが要る。そして当時の指示データは、ほぼすべて人が書いたものだった。
学術界のやり方は、FLAN や T0 のように既存の NLP データセットを指示の形に書き直すか、研究者が集まって 1,600 種類以上のタスクを書き上げた Super-NaturalInstructions(以下 SuperNI)のようなものだった。産業界の InstructGPT は、実際のユーザーのプロンプトを大量に使い、アノテーターにデモンストレーションを書いてもらったが、そのデータは一件も公開されていない。
前者には二つの問題がある。書けるタスクの多くは研究者になじみのある分類、質問応答、要約で、普通の人が実際にモデルに尋ねることとは距離がある。しかも、人に新しいタスクを考えてもらい、さらに良い答えを書いてもらうには、創造性も専門性も必要で、大量にこなすのは難しい。
2022 年 12 月、ワシントン大学の Wang らは、ちょっと手抜きにも見える方法を思いついた。GPT-3 は何でも書けるのだから、いっそ自分で問題を出させ、自分で答えさせて、そのデータで GPT-3 自身を微調整すればいい。
問題の定義
まず、指示データの形をはっきりさせておこう。一つのタスク には指示 が一つと、入力と出力の組 が一つ以上あり、モデルは を満たさなければならない。
指示と入力の境界は、はっきりしないことが多い。「学校の安全についての文章を書け」は、文全体を指示にして入力なしにすることもできるし、「次のテーマについて文章を書け」を指示、「学校の安全」を入力にすることもできる。著者らは入力が空でもよいことにして、データの形式をより多様にした。
この論文が答えようとしているのは、指示チューニングをしていない言語モデルと、ごく少量の人手によるシードだけで、十分に良い指示データを作り、そのモデル自身に指示に従うことを教えられるのか、という問いだ。
問題を解く
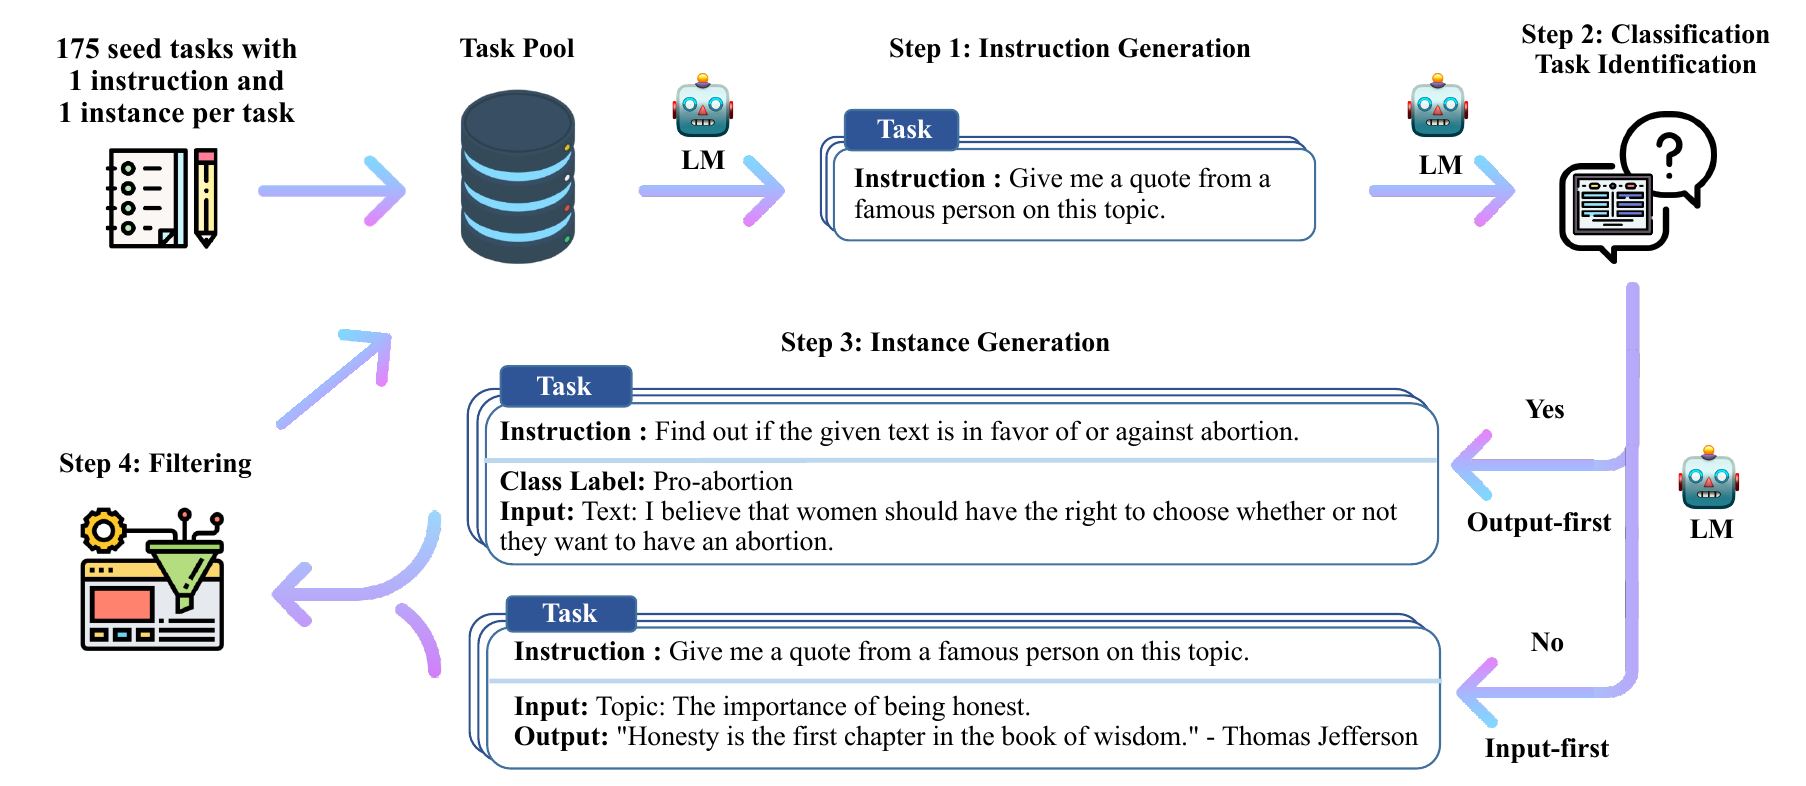
流れ全体は一つのループだ。著者らと研究室の同僚がまず 175 個のシードタスクを手で書き、それぞれに指示一つと入出力の組一つを用意して、タスクプールに入れる。その後の四つのステップはすべて GPT-3(OpenAI API で最大の davinci)に任せ、生成された新しいタスクはフィルタを通ったらタスクプールに戻して、次の一群の生成に使う。
ステップ 1:新しい問題を出す
毎回タスクプールから 8 つの指示を例として取り出す。うち 6 つは人が書いたシード、2 つはそれまでにモデルが生成したタスクで、モデルにはその続きとして新しい指示を書かせる。モデル自身の産物を混ぜるのは、問題が回を重ねるごとに多様になるようにするためだ。人が書いたシードを多数派に保つのは、品質がぶれていかないようにするためだ。
ステップ 2:分類問題かどうかを判定する
次は各指示に入力と出力を生成するのだが、分類問題とそれ以外とではやり方が違うので、先に見分けておく必要がある。著者らは少数ショットのプロンプトでモデルに 12 個の分類の指示と 19 個の非分類の指示を見せ、新しい指示がどちらに属するかを判定させる。ここでいう分類問題とは、出力が少数のラベルに限られるタスクのことだ。
ステップ 3:例を生成する
一般の問題には入力優先を使う。指示に基づいてまず入力を書き、それから出力を書く。普段モデルを使うときと同じ順序だ。
分類問題で同じことをすると、問題が起きる。文法の誤り検出を例にとると、モデルが書く入力はほぼすべて文法的に正しい文になり、ラベルがひどく一方に偏る。そこで分類問題では出力優先に切り替え、まずありうるラベルを列挙し、ラベルごとに対応する入力を書かせる。たとえば「この文章は中絶の権利に賛成か反対かを判定せよ」という問題なら、モデルはまずラベル「Pro-abortion」を決め、それから中絶の権利を支持する文章を生成する。
ステップ 4:フィルタリング
モデルは同じことを繰り返すので、新しい指示はタスクプールのすべての指示と ROUGE-L で比べ、類似度がどれとも 0.7 未満のときだけ受け入れる。ROUGE-L は二つの文の最長共通部分列を見る指標だ。論文の流れ図にある「Give me a quote from a famous person on this topic.」を例にすると、候補「Give me a famous quote on this topic.」は元の文を言い換えただけなので、はじかれる。「Find out if the given review is positive or negative.」は流れ図のもう一つの指示「Find out if the given text is in favor of or against abortion.」と同じ構文だが、タスクが立場の判定からレビューの肯定・否定に変わっているので、残る。
ほかのフィルタリングのルールもある。image、picture、graph のように言語モデルが扱えないキーワードを含むものは捨てる。同じ指示の下でまったく同じ例や、入力が同じなのに出力が違う例も捨てる。さらにいくつかの経験則で、長すぎるもの、短すぎるもの、出力が入力を繰り返しているだけの生成結果を削除する。
微調整
データができたら、それを生成したのと同じ GPT-3 を、OpenAI の微調整 API で微調整する。プロンプトの部分は損失に含めず、2 エポック訓練する。モデルが形式を選り好みしないように、指示と入力はさまざまなテンプレートでつなぐ。たとえば指示の前に「Task:」をつけるかどうか、入力の前に「Input:」をつけるかどうか、間に何行空けるか、といった具合だ。得られたモデルを GPT3Self-Inst と呼ぶ。
何ができたか
最終的に、52,445 個の指示と 82,439 組の例ができた。そのうち 11,584 個が分類問題で、35,878 組の例には入力がない。
これらの問題はシードとどれくらい違うのか? 著者らは、新しい指示それぞれと最も似たシードとの ROUGE-L を計算した。大半は 0.2 から 0.45 の間に収まり、ピークは 0.3 前後で、0.6 を超えるものはわずかだった。つまり多くは、シードにはない新しい問題だ。動詞と目的語の分布もよく散らばっており、最も多い 20 個の動詞と、それぞれで最も多い 4 個の目的語を合わせても、指示全体の 14% にしかならない。
品質はまた別の話だ。著者らは 200 個の指示を、それぞれ例一組とともにランダムに抜き出し、自分たちで一つずつ確認した。
| 確認項目 | 合格 |
|---|---|
| 指示が有効なタスクを記述している | 92% |
| 入力がその指示にふさわしい | 79% |
| 出力が正しく、受け入れられる回答である | 58% |
| 三つとも問題なし | 54% |
原論文 Table 2 をもとに整理。
例の半分近くに誤りがある。著者らの見方では、内容が間違っていても形式はたいてい正しいか、少なくとも部分的には正しいので、モデルに「指示にどう応じるか」を教えるにはやはり役に立つ。
議論
SuperNI:InstructGPT001 にほぼ追いつく
最初の実験では、SuperNI の評価タスク 119 個を、それぞれ 100 件ずつ使う。タスクの定義だけを与えてゼロショットで答えさせ、出力と正解の ROUGE-L を見る。
| モデル | パラメータ | ROUGE-L |
|---|---|---|
| GPT-3 | 175B | 6.8 |
| T0 | 11B | 33.1 |
| GPT-3 + T0 訓練データ | 175B | 37.9 |
| GPT3Self-Inst | 175B | 39.9 |
| InstructGPT001 | 175B | 40.8 |
| Tk-Instruct(SuperNI で訓練) | 11B | 46.0 |
| GPT-3 + SuperNI 訓練データ | 175B | 49.5 |
| GPT3Self-Inst + SuperNI 訓練データ | 175B | 51.6 |
原論文 Table 3 をもとに整理。
素の GPT-3 は指示にほとんど従えず、無関係な内容や繰り返しをよく書き、いつ止めればいいかわからない。自分で生成したデータで微調整すると、ROUGE-L は 33.1 上がり、InstructGPT001 との差は 1 ポイントもない。InstructGPT001 のほうは、非公開のユーザーデータと人間のアノテーションを使っている。ここで 001 版とだけ比べているのは、より新しい版は最新のユーザーデータを使っており、SuperNI のテストセットを見ている可能性が高いからだ。
SuperNI 自身の訓練データを使えば、問題の作風も形式も同じなので、強いのは当然だ。それでも SuperNI の訓練データに Self-Instruct のデータを加えると、49.5 から 51.6 にさらに上がる。二種類のデータは補い合えるということだ。
実際の用途:252 問の新しい問題
SuperNI のタスクは多くが研究用に設計されたもので、分類に偏っている。著者らは別に、言語モデルが役に立ちそうな分野をブレインストーミングで挙げ、メールの作成、SNS、生産性ツール、エンターテインメント、プログラミングといった分野ごとに指示を書いた。合計 252 問だ。
これらの問題は自動で採点するのが難しく、プログラムを書く問題や一階論理を自然言語に直す問題などは、普通のクラウドワーカーにも採点できない。そこで問題を書いた著者自身が採点し、四段階に分けた。A:正しく、満足できる。B:許容範囲だが、小さな瑕疵がある。C:指示には応じているが、内容に明らかな誤りがある。D:無関係または無効。
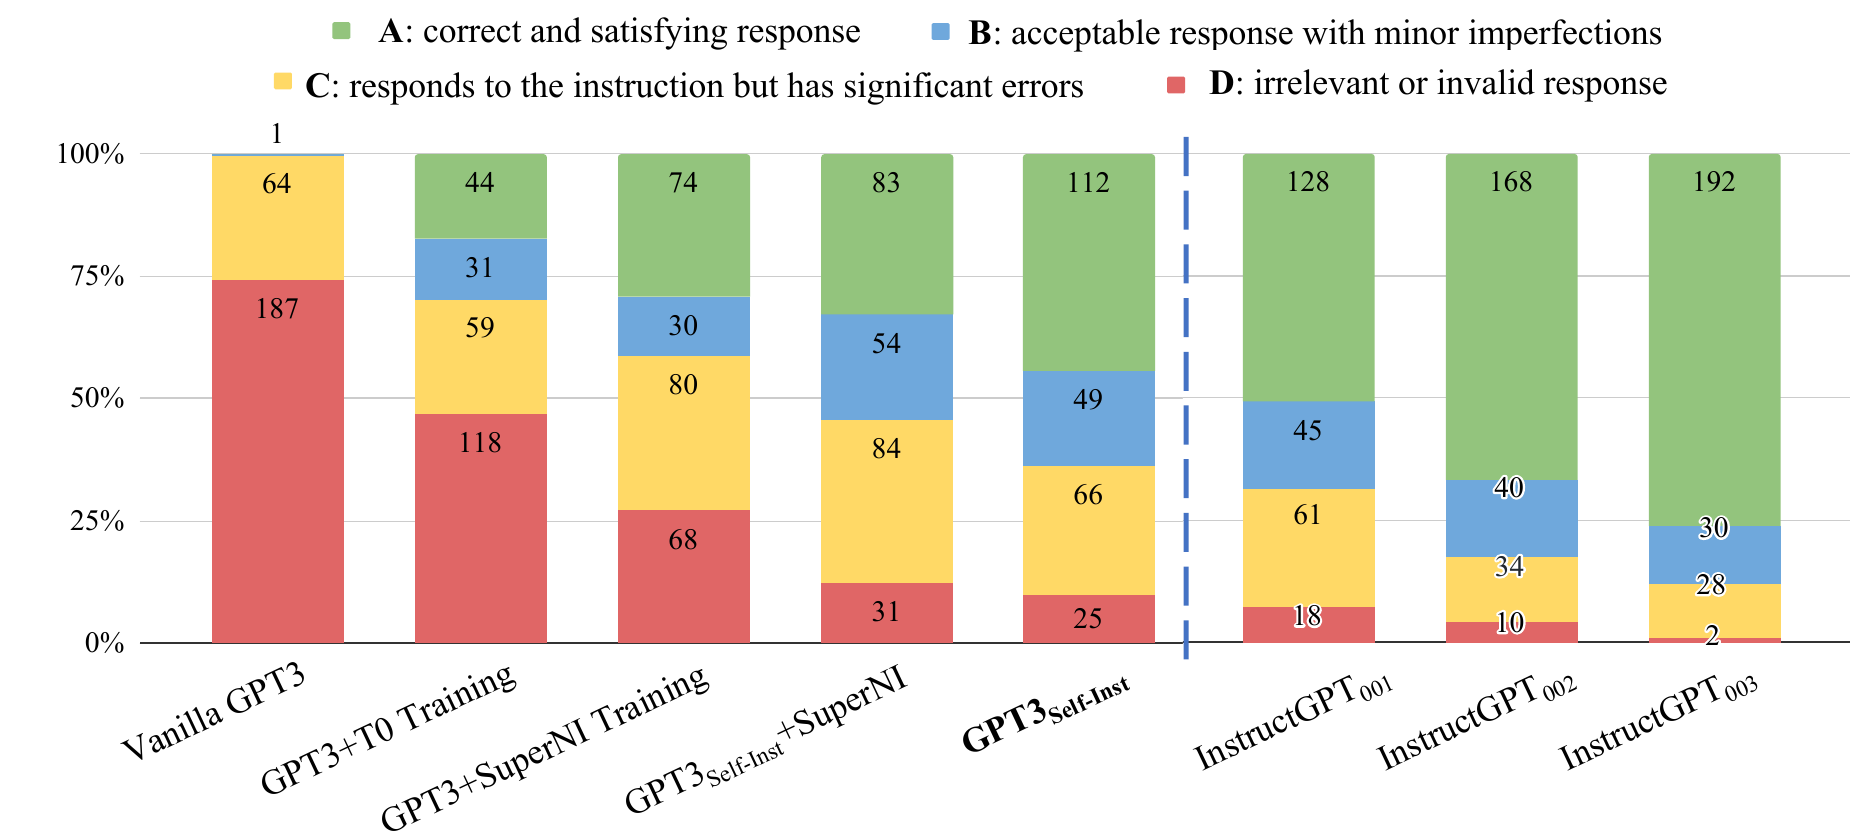
破線の左側は GPT-3 とそのさまざまな微調整版、右側は OpenAI の三世代の InstructGPT だ。どのモデルも同じ 252 問に答えており、A と評価された割合は GPT3Self-Inst が 44.4%、InstructGPT001 が 50.8% だ。
B も使えるものとして数えると、GPT3Self-Inst は 63.9%、InstructGPT001 は 68.7% で、差は 5 ポイントに満たない。これが論文の要旨で言う「差はわずか 5%」だ。T0 や SuperNI のデータで微調整した GPT-3 にもはっきり勝っている。ただし InstructGPT002 と 003 は格が違い、003 は回答の 4 分の 3 以上が A と評価された。
データは多いほど良いが、品質はもっと大事
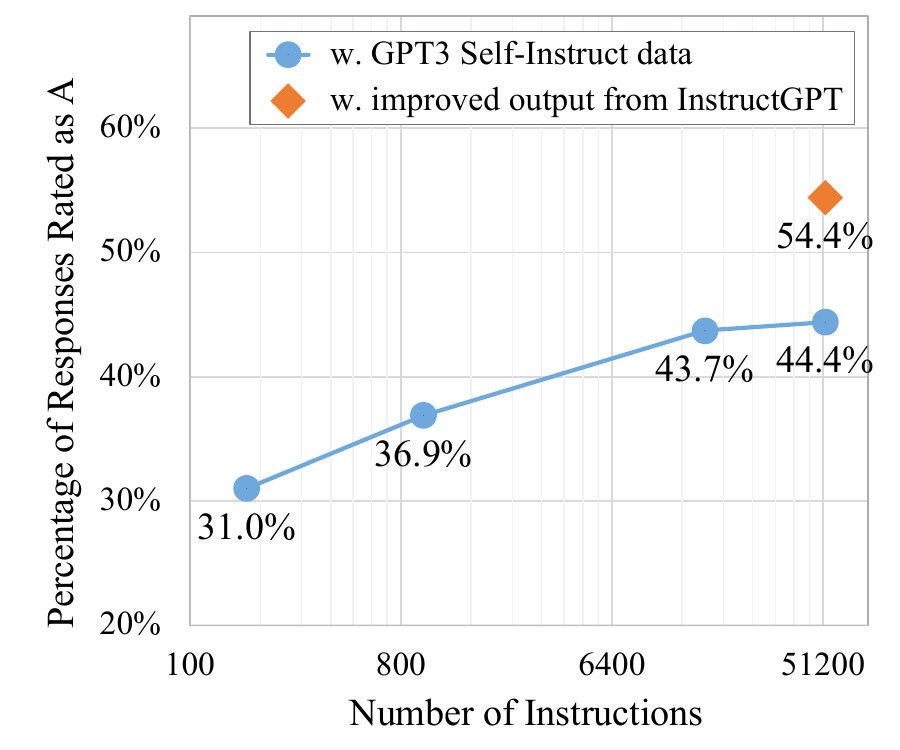
青線は Self-Instruct の指示を異なる数だけ使って微調整したもので、A と評価された割合は 31.0% から 44.4% に上がるが、約 1.6 万個を過ぎるとほとんど動かなくなる。SuperNI ではもっと早く飽和し、数百個の指示で頭打ちになる。著者らは、このデータが典型的な NLP タスクとかなり違うためだろうと推測している。
もっと面白いのはオレンジの点だ。著者らはすべての指示と入力をそのまま残し、出力だけを InstructGPT003 に書き直させてから GPT-3 を微調整した。すると A の割合は一気に 54.4% に跳ね上がり、10 ポイント増えた。言い換えれば、InstructGPT003 の能力をこの問題群に蒸留したわけだ。
この実験の費用も付録に書かれている。当時の davinci は 1,000 token あたり 0.02 ドルで、データ全体の生成に約 600 ドルかかった。全データで GPT-3 を微調整するのにかかったのは 338 ドルだ。
限界
著者ら自身が三点を挙げている。
- ロングテール:モデルが得意なのは事前学習データによく出てくるものなので、Self-Instruct の効果もよくあるタスクに集中しているかもしれない。まれな指示や独創的な指示に出会うと、うまくいかなくなりやすい。
- 大きなモデルへの依存:この方法は言語モデル自体の帰納バイアスに頼っているので、大きなモデルでしか効かないかもしれず、計算資源が足りない人には使えない。
- バイアスの増幅:自己生成を繰り返すと、社会的な偏見がどんどん増幅されるおそれがある。分類問題のラベルの釣り合いが取りにくいのも、モデルがもともと持っている好みの表れだ。
もう一点、補足しておきたい。Self-Instruct はモデルに新しい知識をもたらしていない。問題も答えも GPT-3 自身から出てきたものだ。教えたのは「指示を見たらどう応じるか」である。出力を InstructGPT003 に書き直させるだけで A の割合が 44.4% から 54.4% に跳ね上がったことも、それを物語っている。
その後
三か月後、Stanford の Alpaca がこの流れを LLaMA に持ち込んだ。同じ 175 個のシードから出発し、text-davinci-003 で 52,000 件の指示デモンストレーションを生成した。データ生成にかかったのは 500 ドル未満、LLaMA-7B の微調整は 100 ドル未満だった。Alpaca の説明は、学術研究での利用に限るとはっきり書いている。理由の一つは LLaMA 自体が非商用ライセンスであること、もう一つは OpenAI の利用規約が、その出力を使って OpenAI と競合するモデルを開発することを禁じていることだ。
その後、強いモデルで指示データを生成するのは一般的なやり方になり、手法もどんどん凝ったものになった。2024 年の Tülu 3 は、まず大量の「ペルソナ」を用意し、GPT-4o にそれらの人物になりきって問題を出させることで、問題の多様性を高めた。Self-Instruct がモデルの産物を混ぜた発想と同じ系譜にある。
結論
Self-Instruct は、人が書いた 175 個のシードタスクだけで GPT-3 に 5 万個あまりの指示を生成させ、微調整後は SuperNI で InstructGPT001 の水準に追いつき、実際の用途を想定した 252 問でも差は 5 ポイント未満だった。データの生成には約 600 ドルかかり、全データでの GPT-3 の微調整は 338 ドルだった。
自分で指示データを作りたいなら、この論文の四つのステップはいま見てもかなり実用的だ。少量のモデルの産物を混ぜて多様性を増やし、分類問題はラベルを先に決めてから入力を書き、類似度で重複をはじき、ルールで明らかなゴミを掃除する。いちばん気をつけるべきは品質で、著者らが 200 個を抜き取り検査したところ、指示、入力、出力の三つとも問題がなかったのは 54% だけだった。使えはするが、信用しすぎないこと。
後に続いた人たちの多くは、この出題の流れだけを残し、「自分」をもっと強い先生に取り替えた。Alpaca は text-davinci-003 に出題と解答を頼み、Tülu 3 は GPT-4o にさまざまな人物を演じさせて出題させた。論文の中で出力を InstructGPT003 に書き直させただけで A の割合が 10 ポイント増えたことが、この一歩をとっくに予告していた。