原始論文
Assembly of Experts: Linear-time construction of the Chimera LLM variants with emergent and adaptable behaviors
- 發表版本
- 正式發表資訊尚未核實
- arXiv 首次提交
- arXiv:2506.14794
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingassemblyofexperts2025,
  title = {{Assembly of Experts: Linear-time construction of the Chimera LLM variants with emergent and adaptable behaviors}},
  author = {Henrik Klagges and Robert Dahlke and Fabian Klemm and Benjamin Merkel and Daniel Klingmann and David A. Reiss and Dan Zecha},
  year = {2025},
  eprint = {2506.14794},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2506.14794}
}
DeepSeek 曾經同時有兩個很像、個性卻很不一樣的模型。
一個是 DeepSeek-R1,推理模型,回答前會先在 <think> 和 </think> 之間寫一大段思考過程,數學題做得很好,但話很多。另一個是 2025 年 3 月更新的 DeepSeek-V3-0324,一般的對話模型,不寫思考過程,回答直接,速度快。
兩者的架構完全相同,都從 DeepSeek-V3 的基底出發,總共 6,710 億個參數。如果能把 R1 的推理能力和 V3-0324 的簡潔合在一起,不用重新訓練,那就太划算了。
德國的軟體顧問公司 TNG Technology Consulting 真的這樣做了。他們在 2025 年 4 月把合併出來的 DeepSeek-R1T-Chimera 放上 Hugging Face,一個多月後才補上這篇論文,說明他們怎麼做、以及沿途看到的現象。
定義問題
先回顧一下 DeepSeek-V3 的架構,這是理解整篇論文的關鍵。
它是一個混合專家(MoE)Transformer,共 61 個解碼器層。前 3 層是一般的稠密層,後 58 層的前饋網路換成專家:每層有共享專家,每個 token 都會經過;還有 256 個路由專家,由一個路由器替每個 token 挑出 8 個來用。所以總參數 671B,每個 token 實際用到的只有約 37B。
一個模型拆開來,就是一堆張量檔案。DeepSeek-V3 家族的 safetensors 權重檔裡共有 91,991 個張量,可以分成幾類:前 3 層的稠密層、各層的注意力、共享專家、路由專家,以及路由器的閘門。
合併兩個模型時,每一類張量都可以分開處理。這就是作者說的「組裝」:不只決定兩個模型各給多少權重,還決定哪些零件要合併、哪些直接沿用其中一方。
之前也有人用合併來縮短推理模型的回答,例如 Wu 等人在 7B 到 14B 的模型上做得不錯,但在 32B 以上的模型遇到困難,很難在大幅縮短回答的同時保住推理品質。這篇要回答的是,671B 的模型能不能這樣組裝,組出來的模型行為又會怎麼變。
解決問題
合併規則
令 是基底模型(這裡是 V3-0324), 是其他模型(這裡只有 R1)。對每一個張量 ,合併後的張量是
這裡有三個可以調的東西:
- :各模型的權重,通常是凸組合,、總和為 1。兩個模型時, 就是 R1 的比例。
- :要合併的張量集合。作者比較兩種,一種是全部張量(full merging),一種是只有路由專家,不含閘門(expert merging)。
- :門檻。只有和基底差得夠多的張量才合併,差異以正規化的 Frobenius 範數量測,也就是範數除以張量元素個數的平方根。
門檻借用了 TIES-Merging 的修剪想法,但 TIES 是逐個參數修剪,這裡是整個張量一起決定要不要合併。
實作上就是逐一讀取 91,991 個張量,算出合併結果再寫回同樣格式的檔案,用 vLLM 就能直接載入。運算量和模型大小成正比,所以標題說是「線性時間」,完全不需要梯度計算。
先看看兩個模型差在哪
作者先量了 R1 和 V3-0324 每個張量的差異。結果很有規律。路由專家在整個模型裡的差異都相當平均,只在最前與最後幾層有明顯的模式;共享專家的閘門投影在前面幾層幾乎一樣,到了最後幾層差異很大;注意力層也有類似的趨勢。
這張差異分布,後來成為選擇門檻 的依據。
怎麼評估
每個合併模型都在 8 張 H100 或 8 張 MI325X 上用 vLLM 推論,主要測兩個基準:MT-Bench(多輪對話品質)和 AIME-2024(數學競賽題)。兩者平均起來,作者稱為「智力分數」。
成本則用平均輸出 token 數衡量,以 R1 的輸出量為 100%。
另外還有一個行為指標。作者強制每個回答都以 <think> 開頭,再看回答裡有沒有出現收尾的 </think>。R1 一定會出現,V3-0324 從不出現,這個比例就代表模型有多「像推理模型」。
討論
幾乎每個組合都能用
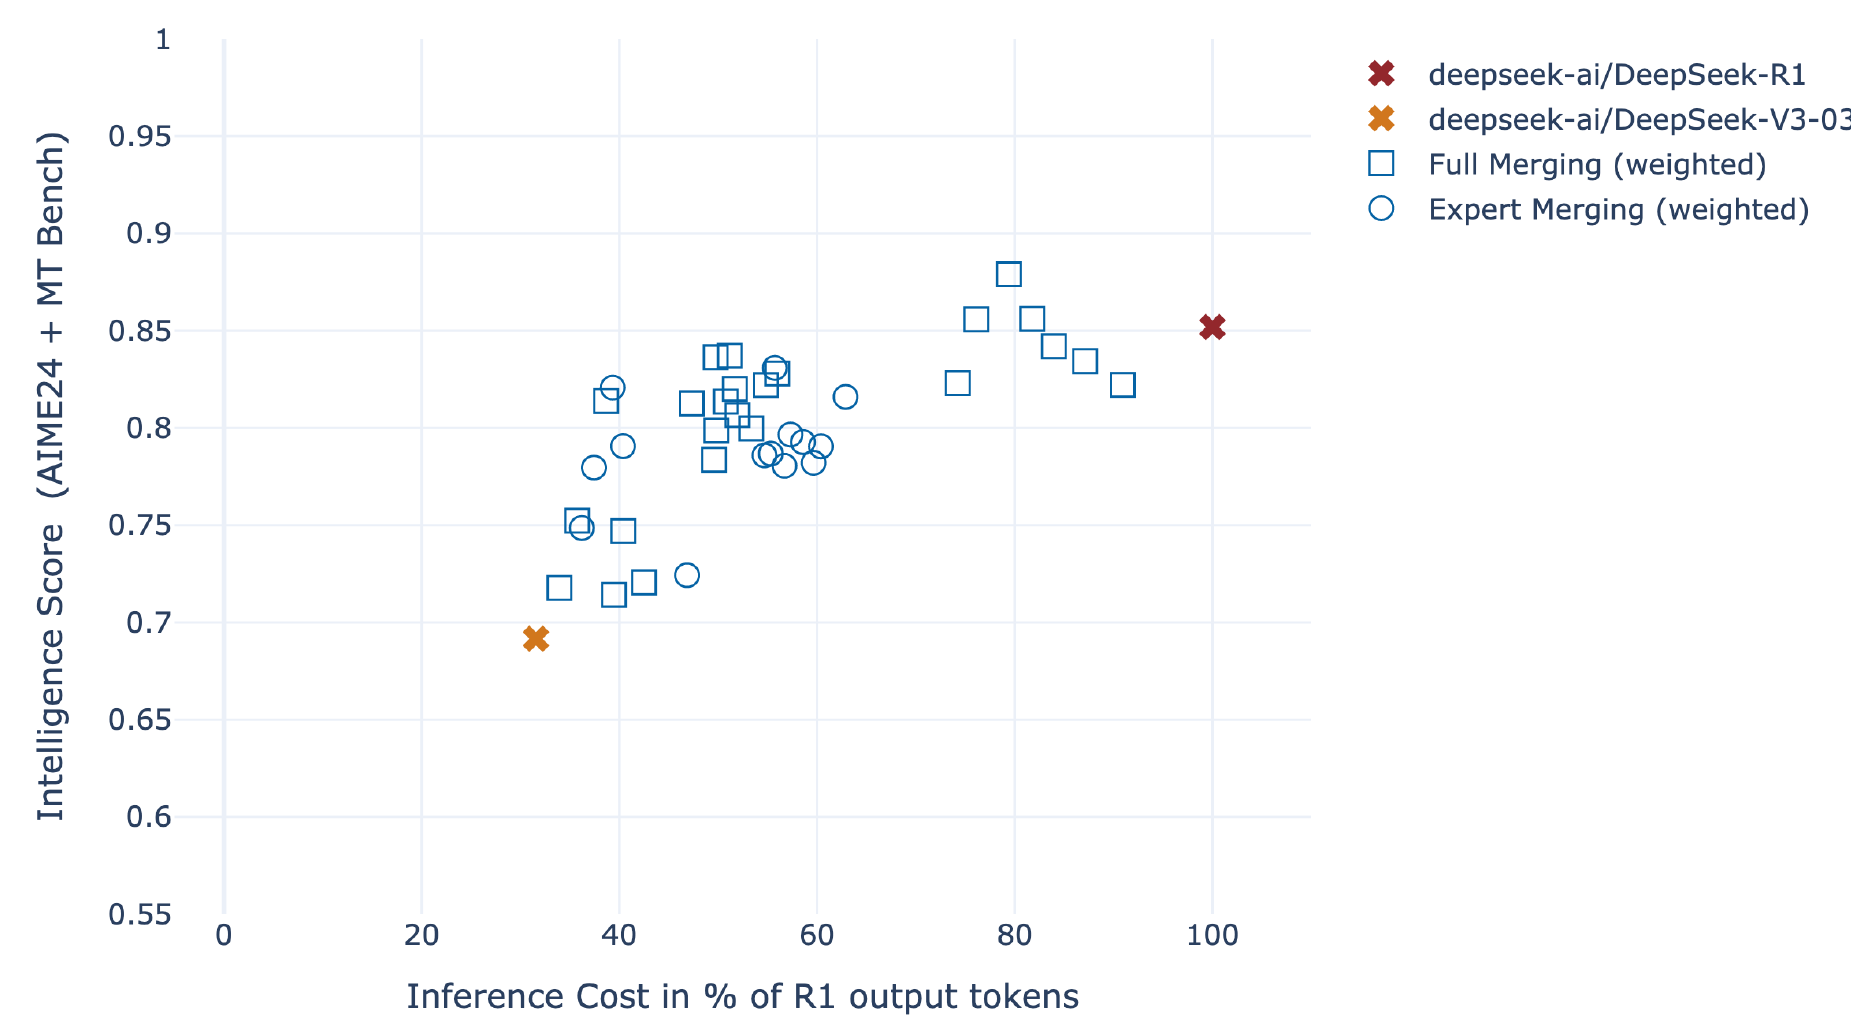
這張圖的理想位置是左上角,分數高、成本低。
R1 在右邊,分數約 0.85,成本 100%;V3-0324 在左下,分數約 0.69,成本約 31%。各種合併模型散在兩者之間,沒有任何一個掉到底下去。作者特別強調,他們搜尋過的整個參數空間裡,沒有出現壞掉的模型。
有好幾個點落在成本 50% 左右、分數 0.82 以上的位置,用一半的 token 拿到接近 R1 的分數。還有一個全張量合併的點,成本約 80%,分數將近 0.88,比 R1 本身還高。
作者把這解釋為 V3、V3-0324、R1 都位在同一個低損失的谷底裡,凸組合不會跑出谷外。這和 Model Soups 的觀察一致,只是規模大了好幾個數量級。
推理行為是突然出現的
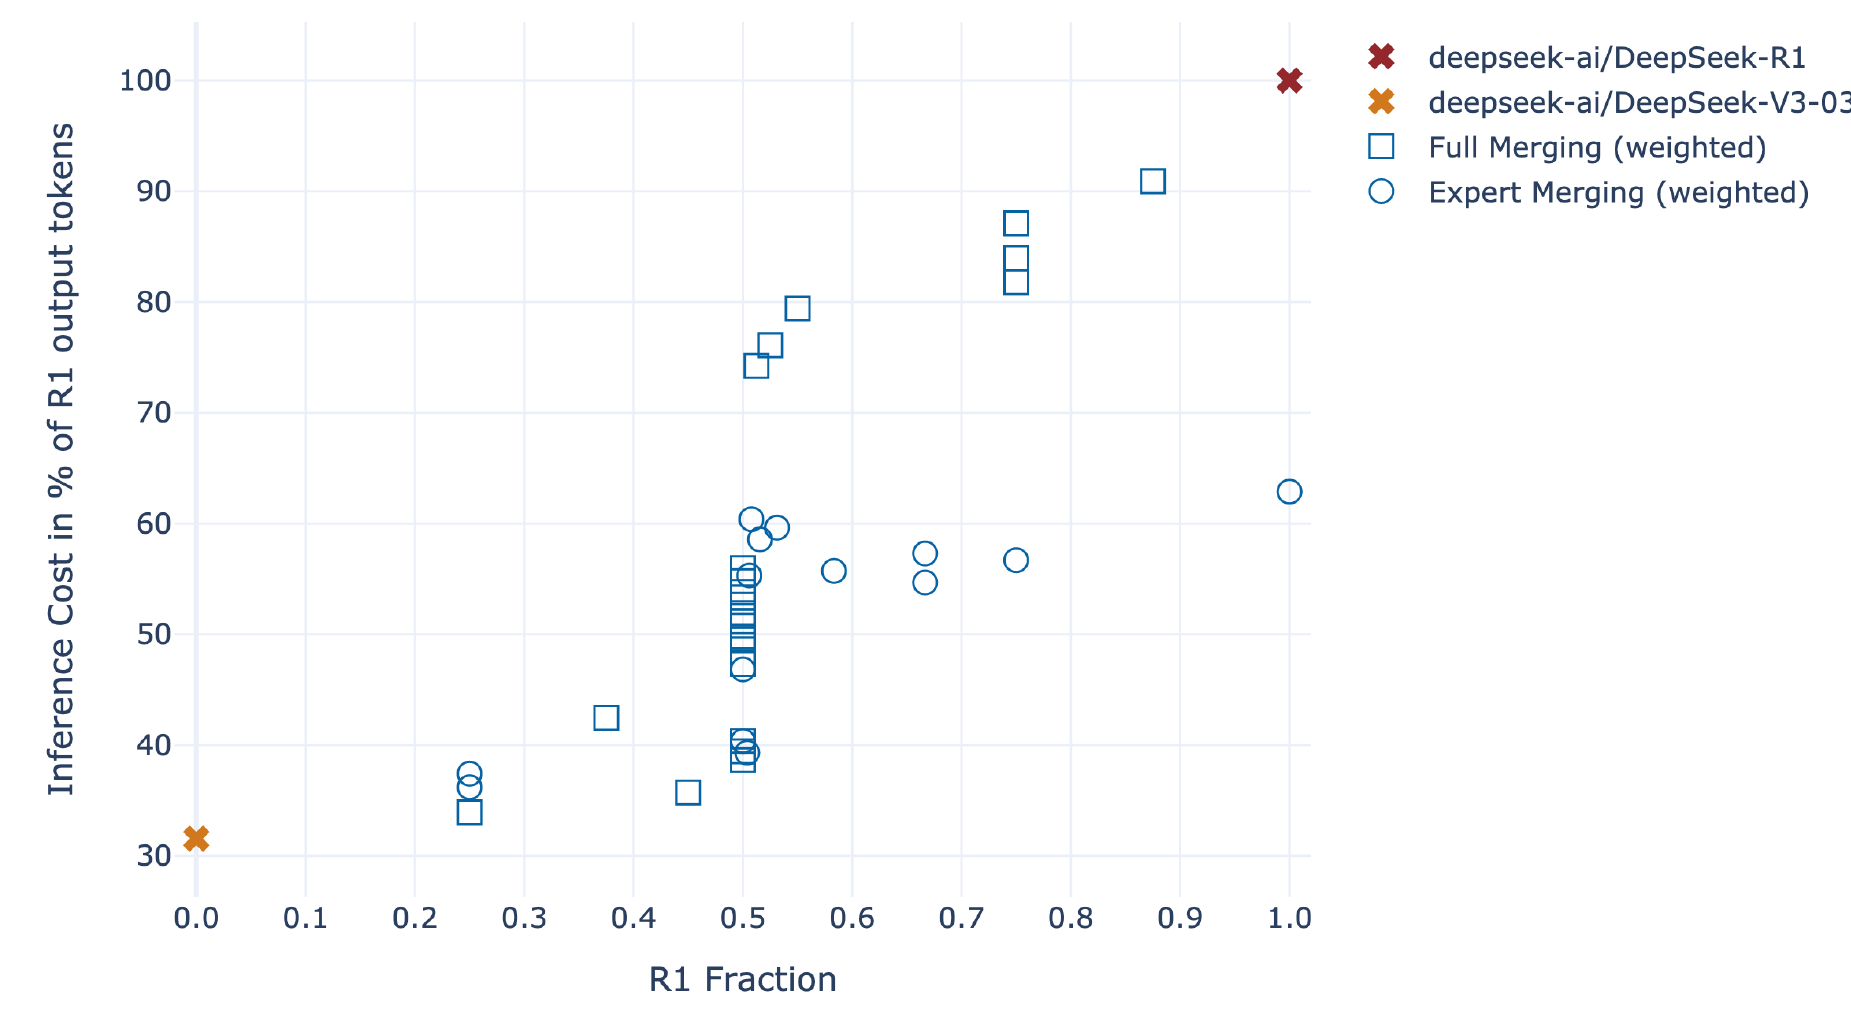
橫軸是 R1 的比例 。輸出長度在 0.5 附近急遽跳升,前後兩段都比較平,形狀像一條 S 形曲線。
</think> 標籤更明顯。R1 比例在 0.504 以上的合併模型,通常會寫出完整的思考過程並以 </think> 收尾;比例低一點點的,通常就不會。這個轉折點只在 0.5 附近一個很窄的範圍內。
所以合併模型的不同性質,變化方式也不同。一般的推理能力隨比例平滑變化,「寫不寫思考過程」這種行為特徵則像開關一樣,越過門檻才出現。
圖中另一個重點是兩種符號的差距。只合併路由專家(圓圈)的成本,整體比全張量合併(方塊)低很多。就算路由專家全部換成 R1 的,成本也只有 R1 的六成左右。
門檻:哪些零件重要
固定 的全張量合併,作者逐步提高門檻 。門檻低時,大部分注意力與路由專家張量都會被合併;門檻提高到某個程度,多數共享專家張量被排除,保留 V3-0324 的值;再提高,注意力張量也被排除,只剩差異最大的路由專家還在合併。
結果是成本隨門檻一路下降,智力分數則一直維持穩定,直到門檻高到開始排除大量 R1 路由專家時,分數才開始掉。
R1T-Chimera
把以上觀察放在一起,作者提出兩個假說。第一,R1 的推理能力主要放在路由專家裡。第二,V3-0324 其餘的部分,包括注意力、共享專家與稠密層,足以和這些專家協作,不會明顯降低表現。
於是他們試了最極端的設定:只合併路由專家,而且 ,路由專家完全換成 R1 的,其他全部沿用 V3-0324。這就是 DeepSeek-R1T-Chimera。
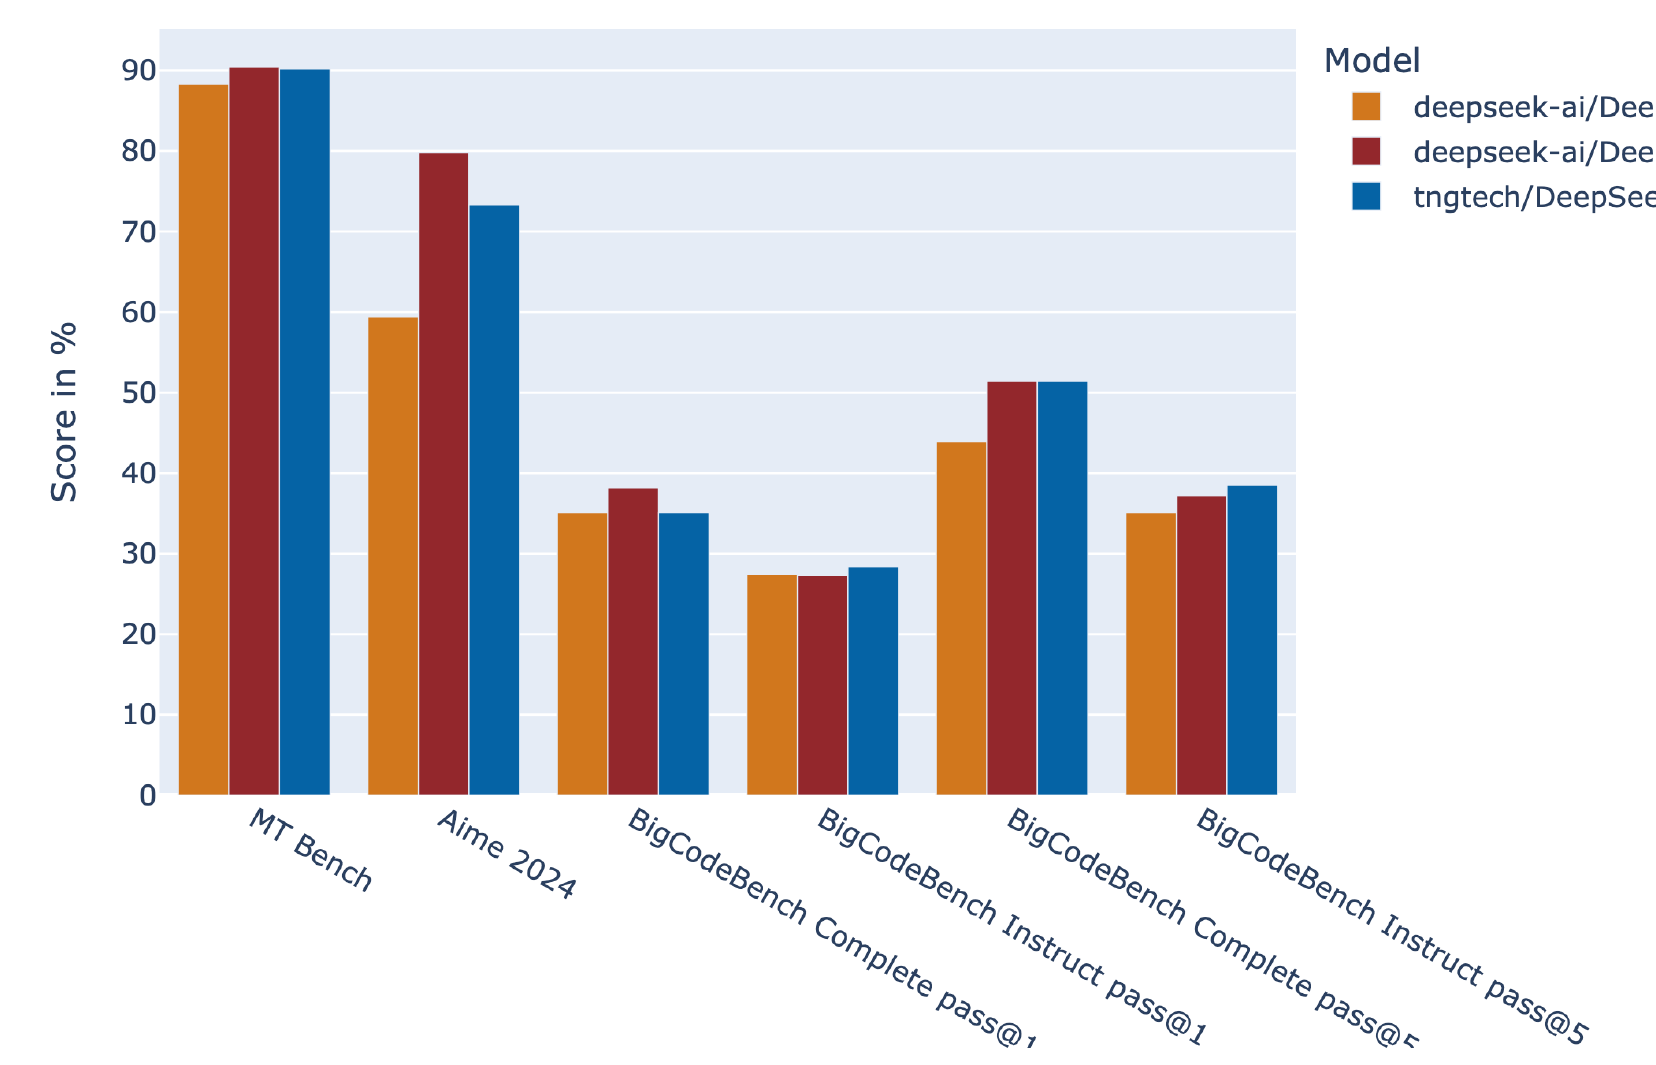
MT-Bench 上三者幾乎一樣。AIME 2024 上 Chimera 約 73 分,比 V3-0324 的約 59 分高很多,但仍落後 R1 的約 80 分。BigCodeBench 的四個子項,Chimera 大致和 R1 持平。輸出 token 則少了大約四成。
作者說 Chimera 的思考過程比兩個父模型都更精簡、更有條理;這是定性的觀察,論文沒有量化。
TNG 先在內部 GPU 叢集上用 Chimera 取代 R1,再公開權重。根據論文,2025 年 5 月底它每天透過 Chutes 這個無伺服器推論平台處理近 50 億個 token。
證據的範圍
這篇的實驗設計相當簡略,有幾件事要記得。
- 評測太少:整個參數搜尋只用 MT-Bench 和 AIME-2024 兩個基準,AIME-2024 只有 30 題,一兩題的差距就是好幾個百分點;論文沒有報告重複次數或變異數。
- 「智力分數」是自訂指標:把一個由模型評審的對話分數和一個數學競賽分數直接平均,用來排序可以,拿來當能力的絕對量尺則太粗。
- 只有一對父模型:所有觀察都來自 V3-0324 和 R1,「推理能力放在路由專家」的假說,在其他模型家族上還沒有驗證。
在相關研究裡作者也提到,Kimi k1.5 的團隊比較過,用長度懲罰的損失來微調,比合併長短兩種推理模型更能產出省 token 的模型。合併的優勢在於便宜,不一定在於最好。
TNG 在 2025 年 7 月又發布了 R1T2 Chimera,改成三個父模型(R1-0528、R1、V3-0324),同樣沿用 V3-0324 的注意力與共享層。
結論
這篇論文把模型合併做到了 671B 的規模,而且利用 MoE 的結構,把「合併」細分成「選零件」。把 R1 的路由專家換進 V3-0324 的身體裡,得到一個推理能力接近 R1、輸出短四成的模型,全程沒有任何梯度計算。
最有意思的是沿途觀察到的相變。推理能力平滑變化,寫思考過程的習慣卻在 R1 比例過半的瞬間突然出現。
MoE 模型的零件可以這樣拆開來換,前提是兩個模型來自同一個基底。拿兩個不同家族的 MoE 來縫,那就真的只是縫合怪了。