原論文
From Intuition to Investigation: A Tool-Augmented Reasoning MLLM Framework for Generalizable Face Anti-Spoofing
- 発表先
- CVPR 2026国際会議
- arXiv への初回投稿
- arXiv:2603.01038
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{faceantispoofingtarfas2026,
  title = {{From Intuition to Investigation: A Tool-Augmented Reasoning MLLM Framework for Generalizable Face Anti-Spoofing}},
  author = {Haoyuan Zhang and Keyao Wang and Guosheng Zhang and Haixiao Yue and Zhiwen Tan and Siran Peng and Tianshuo Zhang and Xiao Tan and Kunbin Chen and Wei He and Jingdong Wang and Ajian Liu and Xiangyu Zhu and Zhen Lei},
  year = {2026},
  eprint = {2603.01038},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2603.01038}
}
2012 年に Idiap が Replay-Attack データセットを発表したとき、ベースラインに使われた手法は LBP だった。各ピクセルについて周囲の 8 近傍と明るさを比べ、近傍が中心より暗くなければ 1、暗ければ 0 として 8 ビットのコードを作り、顔全体のコードをヒストグラムに集計する。紙の繊維も画面の画素の格子も、テクスチャが肌とは違うので、ヒストグラムもそれにつれて違ってくる。
それから十数年、顔のなりすまし検知にもマルチモーダル大規模言語モデルが使われるようになった。I-FAS はモデルに「これは本物の人物ですか?」と問い、まず Yes か No かを答えさせ、続けて一文の説明を添えさせる。ただ、その説明はよくこんな具合だ:
This is a picture of a man wearing glasses.
言っていることは正しいが、真偽とはほとんど関係がない。
中国科学院自動化研究所の雷震(Zhen Lei)のチームと、Baidu で I-FAS を手がけたメンバーが、今回 LBP を呼び戻した。ネットワークに組み込んで特徴量にするのではなく、ツールとして用意し、いつ呼び出して見るかを大規模言語モデル自身に決めさせる。
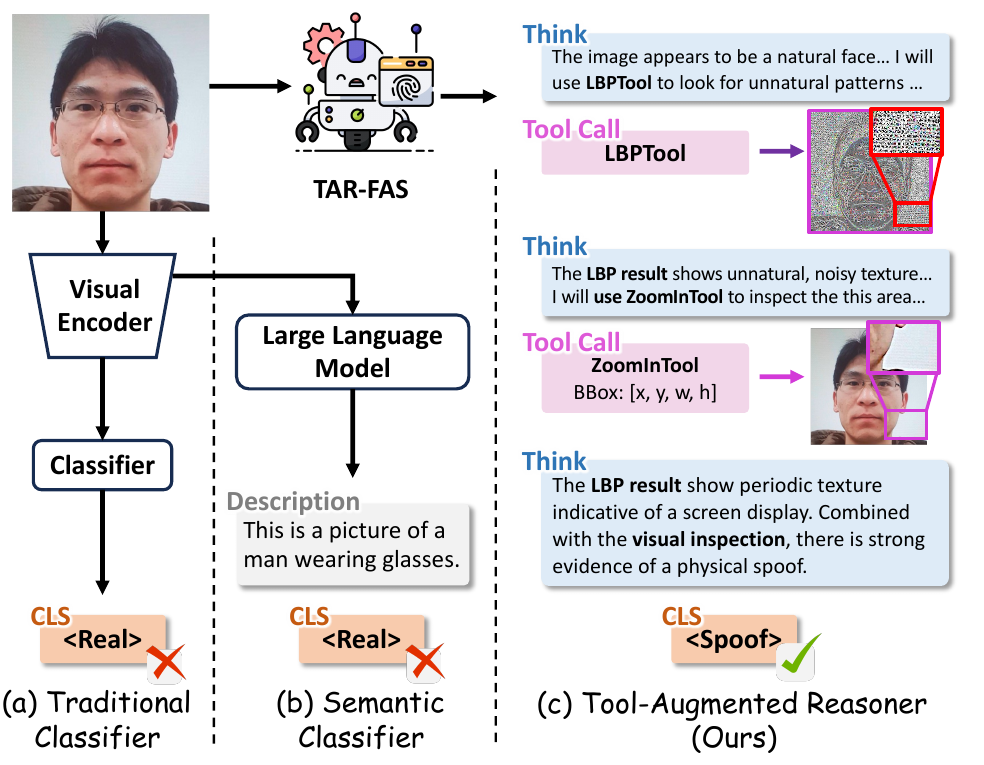
図の中央の列が、I-FAS の出力形式だ。右がこの論文のやり方で、モデルはまず一目見て本物らしいと考え、続いて LBP ツールを呼び出し、出力画像に不自然なテクスチャの部分を見つけ、そこを拡大して、最後に攻撃へと判定を改める。
問題の定義
I-FAS はなりすまし検知を画像についての問答に書き換え、クロスデータセットの成績で CLIP 系の手法を大きく上回った。著者らは、その天井があの一文の説明にあると見る。彼らは先行研究を引いて、マルチモーダル大規模言語モデルはもともと低レベルの視覚特徴に死角があると指摘する。しかも訓練目標は短い説明を一文書くことしか求めないので、モデルが学ぶのは「マスクをかぶっている」「画面を持っている」といった、目に見える意味の手がかりがほとんどになる。画面を撮影したときに出るモアレ、プリンターの網点、マスク素材のかすかな反射は、一文に書き込むのが難しく、そのため学ばれないままになる。
FaceCoT の付録にある表を見ると、このことがもっとはっきりする。汎用モデルにゼロショットで Rose-Youtu の攻撃画像を判定させると、マスクはほとんど見抜けたのに、紙と画面の再生は一枚も捕まえられなかった。
では、大規模言語モデルにピクセル単位の痕跡を見させるには、どうすればいいのか?
従来のなりすまし検知は、ずっとこの問題に取り組んできた。LBP、HOG、FFT は、どれも当時よく使われた手段だ。一方、最近のマルチモーダルモデルは、推論の途中で外部ツールを呼び出せるようになっている。たとえば DeepEyes では、画像のどこを拡大するかをモデル自身が決める。著者らはこの二つをつなぎ、推論中のモデルに、これら定番の画像演算子を呼び出させる。
問題の解決
ツールボックス
著者らは六つのツールを用意し、四つの種類に分けた:
- ZoomIn:枠を一つ指定し、その部分を切り出して拡大する。
- テクスチャ:LBP。肌のテクスチャが自然かどうかを見る。紙やマスクの素材は、ここでぼろが出やすい。
- 周波数:FFT とウェーブレット変換。周波数分布に異常がないかを見る。画面や印刷物は、周期的な信号を帯びていることが多い。
- 構造:HOG と Laplacian エッジ検出。境界と勾配を見る。マスクの縁や画面の枠が、ここに浮かび上がる。
どのツールの出力も一枚の画像で、それがモデルに戻される。つまりモデルが「ツールの結果を見る」というのは、実際には LBP のコード画像、スペクトル画像、あるいはエッジ画像を一枚見ていることになる。
FFT の画像で、なぜ画面だと分かるのか。下の模式図は、64×64 の画像二枚をスペクトルに変換したものだ。上の段は滑らかな明るさの起伏で、直接撮った顔の代わりにしている。下の段では同じ顔に、8 ピクセルごとに繰り返す縦縞を重ね、画面越しに撮影したときに現れる周期的な模様をまねている。
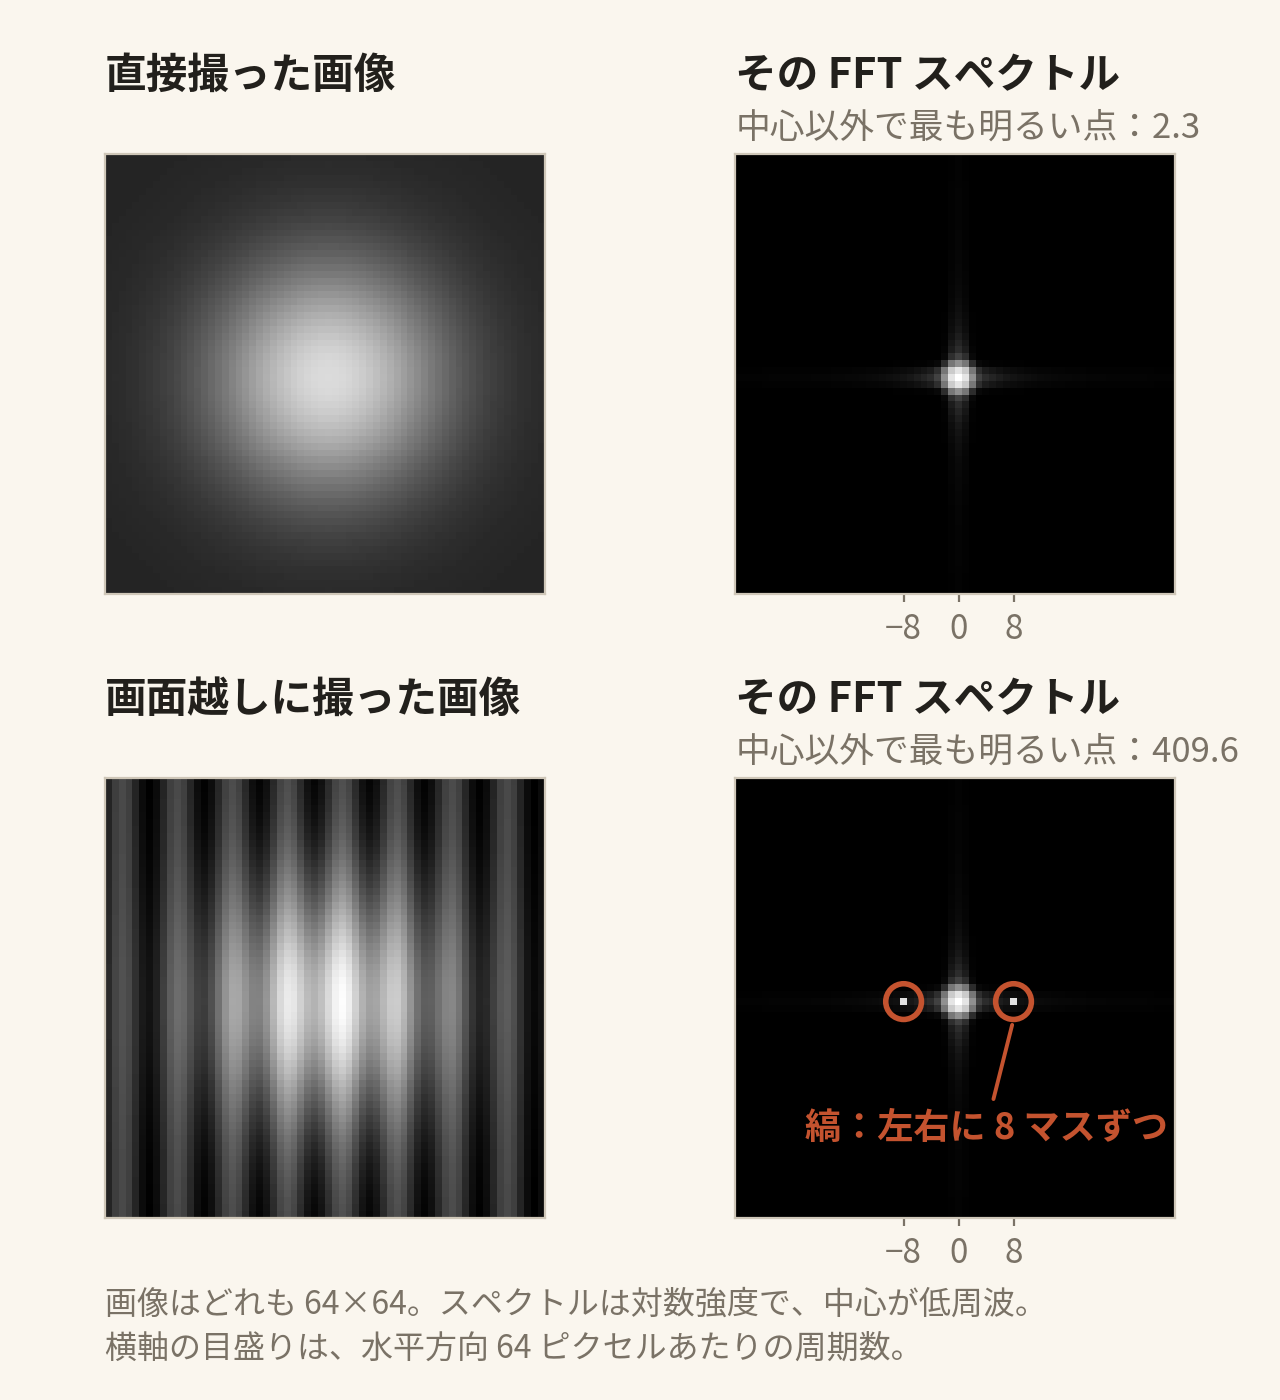
右上のスペクトルには、中心の塊しかない。これは滑らかな明るさの起伏が持つ低周波のエネルギーで、中心から離れるほど暗くなる。右下には小さな輝点が二つ増え、ちょうど横軸の −8 と +8 に乗っている。幅 64 ピクセルで 8 ピクセルごとに 1 周期なので、ちょうど 8 周期になる。だから輝点は中心から 8 マス離れた位置に、左右対称に一つずつ現れ、その強度は、直接撮ったときの中心以外で最も明るい点の百倍以上ある。
左下の画像では、縞が顔の明るさと混ざっていて見分けにくい。スペクトルに移すと二つの点に集まり、一目で分かる。実際のモアレは向きも周期ももっと乱れているので、スペクトル上の輝点も散らばるが、理屈は同じだ。TAR-FAS の FFT ツールが返すのはこの種のスペクトル画像で、モデルが学ぶべきなのは、画像の中で中心から離れた輝点を探すことだ。
論文は各ツールの実装パラメータを示していない。この図は、FFT ツールが返すものがどんな見た目かを説明するためだけのものだ。
ToolFAS-16K:答えを知っている先生に、まず手本を見せてもらう
モデルは最初、ツールの使い方を知らないので、まず手本が要る。著者らは CelebA-Spoof から 16,172 枚の画像を選んだ。半分近くが本物で、残りは 10 種類の攻撃にわたる。そのうえで Gemini-2.5 Pro に、ツールを使う推論の過程をラウンドごとに書かせた。
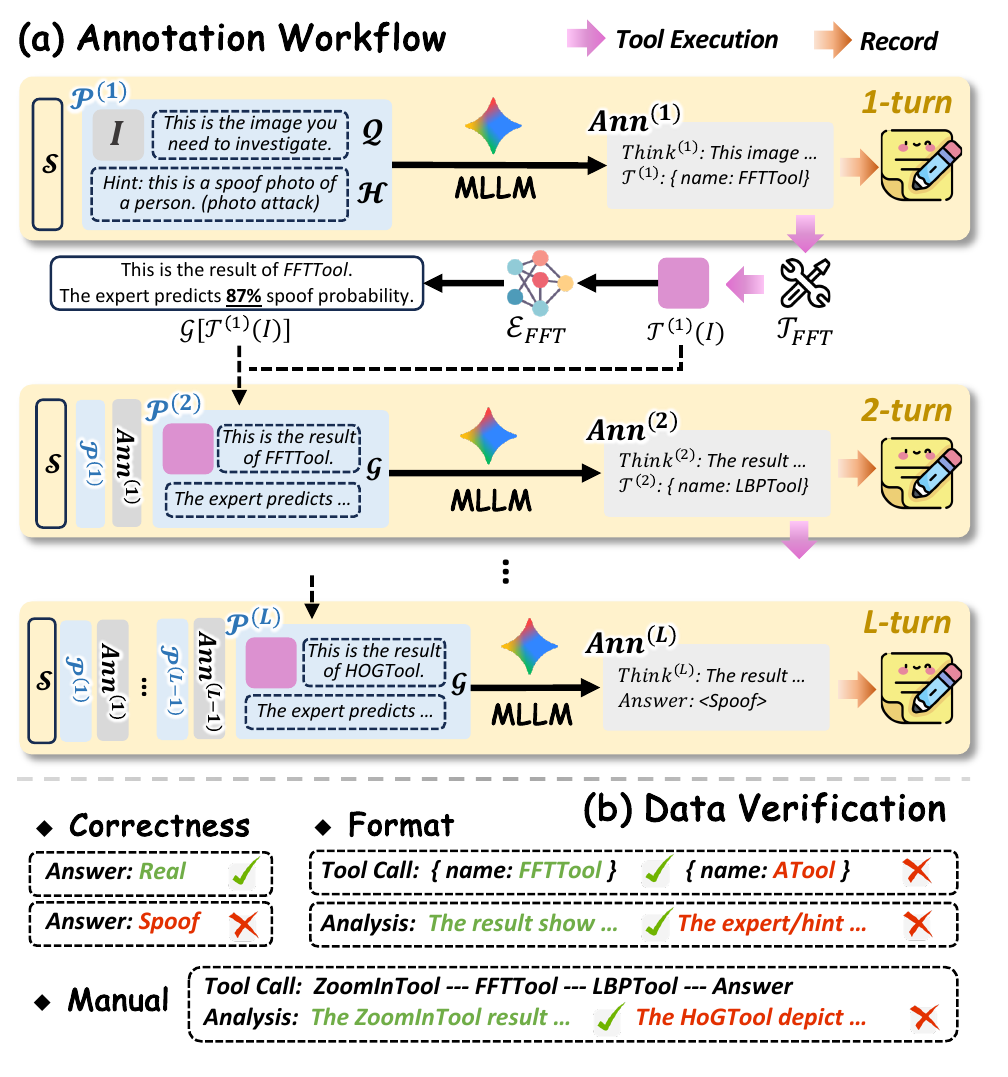
図の 1 ラウンド目から見ていこう。Gemini が受け取るのは、画像と「これがあなたの調べる画像です」という一文に加えて、ヒント が一つ。この画像が本物なのか、どの種類の攻撃なのかを直接書いたものだ。システムプロンプトでも、最終的な分類はヒントと一致しなければならず、しかも推論の中でヒントに触れてはならないと明言している。
Gemini があるツールの呼び出しを求めると、ツールの結果は Gemini に返されるだけでなく、その前に「エキスパートモデル」にも渡される。ツールごとに(ZoomIn を除く)エキスパートが一つずつあり、畳み込み 3 層だけの小さな CNN だ。入力はツールの出力画像だけで、元の画像は見えない。出力は、その画像に攻撃の痕跡がある確率だ。著者らは CelebA-Spoof の 4,000 人分の ID で訓練し、1,000 人分でテストした。これらの小さなモデルは、閾値 0.5 でおよそ 8〜9 割の正解率がある。次のラウンドのプロンプトには、「これは FFTTool の結果です。エキスパートの予測では、攻撃の痕跡がある確率は 87% です」という一文が加わる。
一つのアノテーションは最大 6 ラウンドで、Gemini が答えを出したら終わる。その後に三つのチェックがある。答えがラベルと一致すること。ツール呼び出しが形式に従い、分析にヒントやエキスパートの確率が出てこないこと。最後に、ツールの分析と結論が論理的につながっているかを人が確認する。通らなかったものはもう一度アノテーションし、それでも通らなければ捨てる。
つまりこのデータは、答えを前もって知っていて、隣では助手が確率を読み上げてくれる先生が、生徒のために書いた解答例だ。ヒントとエキスパートの確率はチェックの段階で締め出されていて、生徒の目には入らない。生徒がここから学ぶのは「ツールの呼び出し方と推論の書き方」で、ツールの結果を自分で見て判断する力は、次の段階の強化学習で鍛えることになる。
三段階の訓練
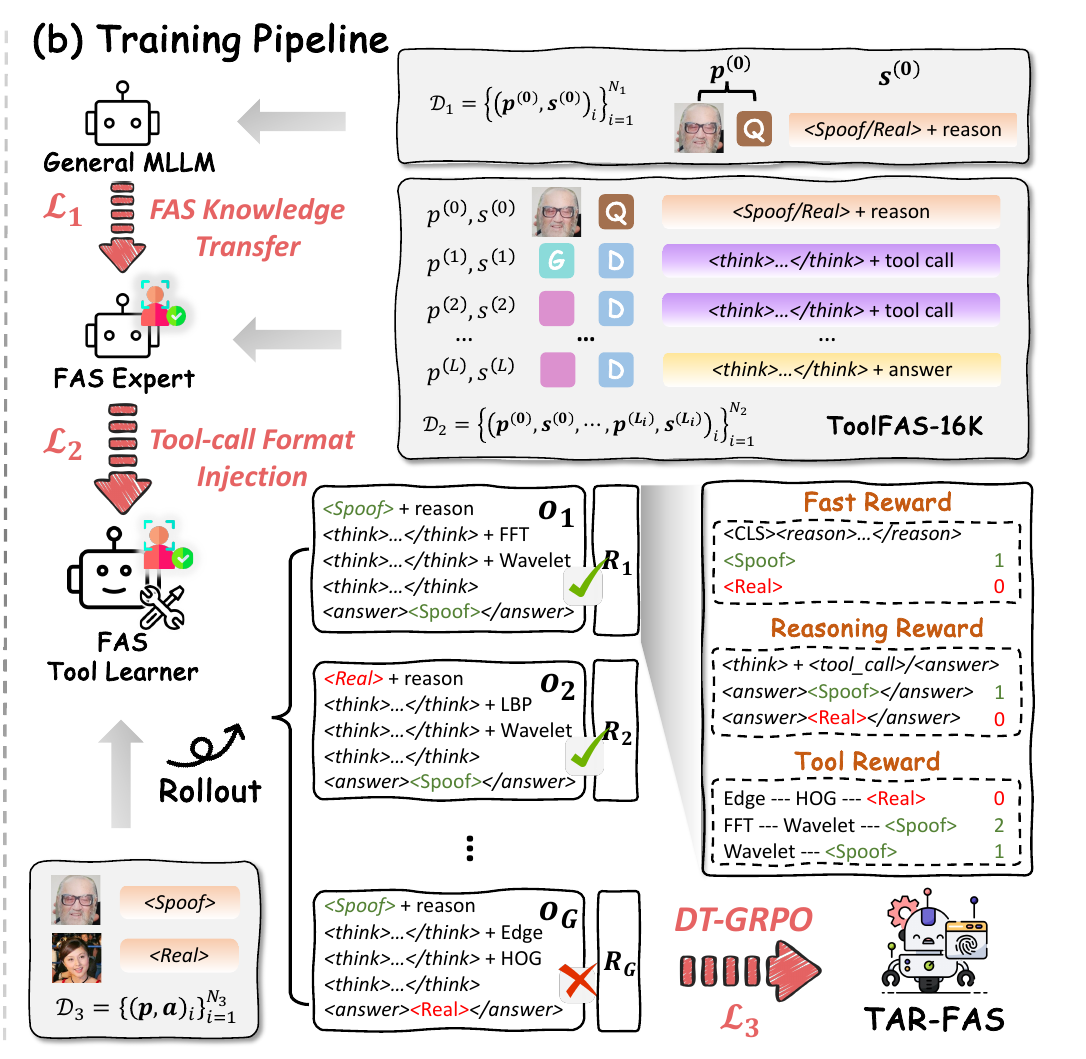
バックボーンは InternVL3-8B。図には上から下へ、三つの段階がある:
-
FAS の知識転移(KT):I-FAS 形式のデータで教師あり微調整を行う。質問は常に「Is this photo of a real person?」で、答えは
<Real>か<Spoof>に一文の理由を付けたもの。この段階で、汎用モデルにまず、なりすまし検知が何を問うているのかを理解させる。 -
ツール呼び出し形式の注入(FI):ToolFAS-16K で微調整する。各データの 1 ラウンド目は前の段階とまったく同じで、即答だ。その後にようやく、ラウンドごとの思考とツール呼び出しが続く。損失関数は次の通り:
1 ラウンド目が重みの 9 割を占める。複数ラウンドのデータは長いので、すべての token を同じ重みにすると、即答の短い部分が薄まりやすい。そうなるとモデルは、ツールの使い方を覚えても、直接分類するやり方を忘れてしまう。
-
DT-GRPO:CelebA-Spoof の画像と真偽ラベルだけで強化学習を行う。推論の手本はもう要らない。
最初の二段階は LoRA(rank 16)で、最大 4,000 ステップ。三段階目は全パラメータを開放し、学習率 1e-6、一つの問題につき 8 個の回答をサンプリングし、最大 300 ステップで、KL ペナルティは 0 に設定する。
DT-GRPO の報酬
GRPO では、同じ問題に対して回答を一組サンプリングし、各回答のスコア を計算する。そこからグループ内の平均を引き、グループ内の標準偏差で割って、アドバンテージ を得る。平均より良い回答は強められ、平均より悪い回答は抑えられる。
この論文のスコアは、三つの項の重み付き和だ:
- :1 ラウンド目の即答。形式が誤っていれば −1 点、そうでなければ正解で 1 点、不正解で 0 点。
- :最終的な答え。推論の形式が誤っているか、ツール呼び出しが無効なら −1 点、そうでなければ正解で 1 点、不正解で 0 点。
- :異なる種類のツールを一つ使うごとに 0.2 を加える。同じ種類のツールを二回呼んでも、一回として数える。最終的に不正解なら、この項はまるごと 0 になる。
攻撃画像一枚と回答五つで、実際に計算してみよう:
import numpy as np

beta_fast, beta_rsn, beta_tool, gamma = 0.1, 0.5, 0.4, 0.2

def reward(fast_ok, tools, final_ok, fmt_ok=True):
    r_fast = 1.0 if fast_ok else 0.0
    if not fmt_ok:                       # 推論の形式が誤り、またはツール呼び出しが無効
        return beta_fast * r_fast + beta_rsn * -1.0
    r_rsn = 1.0 if final_ok else 0.0
    r_tool = gamma * len(set(tools)) if final_ok else 0.0   # 同じ種類のツールは一回だけ数え、不正解なら 0
    return beta_fast * r_fast + beta_rsn * r_rsn + beta_tool * r_tool

# 同じ攻撃画像(ラベル Spoof)からサンプリングした五つの回答
rollouts = [
    ("即答 Real、FFT と Wavelet で調べて Spoof に変更", reward(False, ["FFT", "Wavelet"], True)),
    ("即答 Spoof、ツールを使わずそのまま確定", reward(True, [], True)),
    ("即答 Real、Edge と HOG で調べても Real のまま", reward(False, ["Edge", "HOG"], False)),
    ("即答 Spoof、FFT を二回調べてから LBP も追加", reward(True, ["FFT", "FFT", "LBP"], True)),
    ("即答 Spoof、ツール呼び出しの形式を誤る", reward(True, [], False, fmt_ok=False)),
]
r = np.array([ri for _, ri in rollouts])
adv = (r - r.mean()) / r.std()           # GRPO:グループ内で標準化
for (name, ri), ai in zip(rollouts, adv):
    print(f"R={ri:+.2f}  A={ai:+.2f}  {name}")
R=+0.66  A=+0.75  即答 Real、FFT と Wavelet で調べて Spoof に変更
R=+0.60  A=+0.61  即答 Spoof、ツールを使わずそのまま確定
R=+0.00  A=-0.72  即答 Real、Edge と HOG で調べても Real のまま
R=+0.76  A=+0.97  即答 Spoof、FFT を二回調べてから LBP も追加
R=-0.40  A=-1.61  即答 Spoof、ツール呼び出しの形式を誤る
五つの回答を並べて比べてみる:
- 何より大きいのは正解だ。最終的な正解は 0.5 に相当し、ツールの報酬は最大でも (ツール呼び出しは最大 3 回で、3 種類とも違う場合)にとどまる。ツールを使わずに正解した回答も、アドバンテージは正のままだ。
- ツールは加点問題だ。同じ正解なら、ツールを一種類多く見た回答は 0.08 多くもらえる。1 番目の回答は即答を間違えたが、ツールで逆転し、スコアはそれでも直接正解した回答より高い。
- FFT を二回呼んでも点は増えないので、モデルは「別のツールで見てみる」方向へ押される。名前にある Diverse-Tool はこの意味だ。
- 形式を誤った回答はスコアが負で、アドバンテージも最も低い。
- 報酬のどの項も、ツール呼び出しを減らすようには促していない。正解でありさえすれば、3 回の呼び出しを使い切り、3 種類とも違うときにスコアが最大になる。推論コストの唯一の上限は、ツール呼び出しを最大 3 回とする決まりだ。
推論時
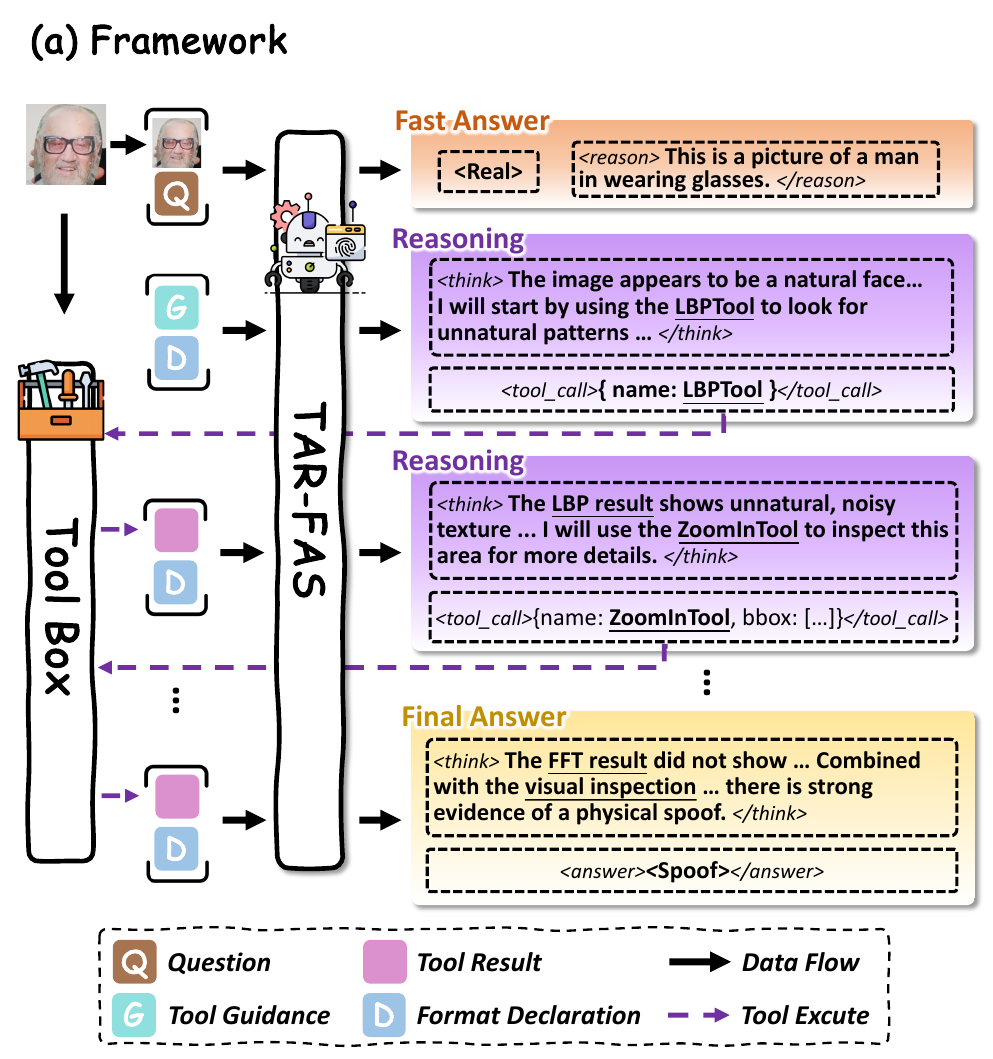
推論は二段階に分かれる。1 ラウンド目は「Is this photo of a real person?(ツールは使わない)」と問い、モデルは I-FAS の形式で即答する。2 ラウンド目には、次のプロンプトを送る:
Wait, you should re-examine the image and give the final answer (use tools if needed).
モデルは <think> を書き始め、必要なら <tool_call> を出力する。外部のプログラムがツールを実行して結果の画像を送り返し、これを繰り返す。ツール呼び出しは最大 3 回で、最後に <answer> を書く。HTER と AUC を計算するときのスコアは、最終回答に含まれる分類 token の logits から取る。
推論時の流れには、エキスパートモデルも、攻撃の種類を示すヒントもない。モデルは自分でツールの出力画像を読むしかない。
討論
One-to-Eleven
主実験は I-FAS の Protocol 2 を踏襲し、CelebA-Spoof だけで訓練して、そのまま 11 のデータセットでテストする。各設定は三つの乱数シードで回して平均を取る。入力は位置合わせして切り出した 224×224 の顔で、InternVL がさらに 448×448 に拡大して処理する。
平均すると、TAR-FAS の HTER は 7.54%、AUC は 96.67%。I-FAS は 11.30% と 93.71%、FLIP は 18.73% と 87.90% だ。
データセットごとの HTER(%)は次の通り:
| テストデータセット | I-FAS | TAR-FAS |
|---|---|---|
| CASIA-MFSD | 1.11 | 0.00 |
| CASIA-SURF-3DMask | 6.18 | 2.09 |
| HKBU-MARs-V1+ | 18.64 | 3.48 |
| HiFiMask | 28.23 | 17.97 |
| MSU-MFSD | 5.63 | 5.71 |
| OULU-NPU | 14.86 | 14.45 |
| Replay-Attack | 9.15 | 5.75 |
| Rose-Youtu | 5.52 | 3.61 |
| SiW | 4.02 | 8.35 |
| SiW-M-V2 | 10.89 | 11.72 |
| WMCA | 20.07 | 9.78 |
| 平均 | 11.30 | 7.54 |
最も改善したのは、マスク攻撃を含むデータセットだ。HKBU-MARs-V1+ は 18.64% から 3.48%、WMCA は 20.07% から 9.78% に下がり、HiFiMask と CASIA-SURF-3DMask もかなり下がった。著者らはとくに、HKBU-MARs-V1+ と CASIA-SURF-3DMask にはソースデータにない攻撃方法と素材が含まれていると指摘している。
面白いことに、論文の冒頭で示された例は画面の周期的なテクスチャで、周波数ツールも紙と画面を狙って用意されたものだ。それなのに、紙と画面の攻撃が中心のデータセットでは、成績が良くなったり悪くなったりしている。Replay-Attack と Rose-Youtu は改善し、MSU-MFSD と OULU-NPU はほとんど動かず、SiW は 4.02% から 8.35% に後退した。攻撃の種類が最も雑多な SiW-M-V2 も、少し悪化している。
ツールと訓練段階
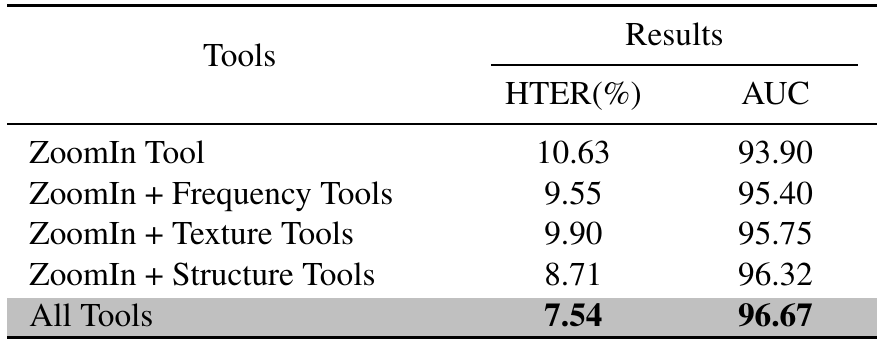
ZoomIn だけを与えた場合の HTER は 10.63% で、すでに I-FAS より少し低い。三種類のツールのうち、単独で加えて最も効いたのは構造ツールで、8.71% まで下がる。すべてそろえると 7.54% だ。
この表から、ツールが役立つことは分かる。同時に、HTER が 11.30% から 7.54% に下がった分のすべてが、ツールによるものではないことにも気づかされる。虫眼鏡しか持たないバージョンが、すでにその一部を稼いでいる。その分は、新しいバックボーンと訓練の流れ全体から来ている。
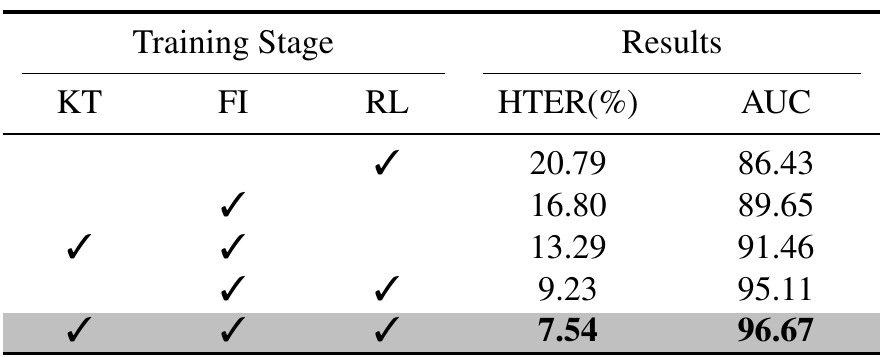
こちらの表のほうが、読みどころが多い。
- 手本を飛ばして直接強化学習をすると、HTER は 20.79%。付録の訓練曲線では、このやり方の訓練中の推論の正解率はずっと 7 割台で上下に揺れ、完全な流れでは 95% 前後だった。モデルはツールの呼び方すら知らないので、報酬で正しい方向へ導くのは難しい。
- Gemini の手本をまねるだけ(FI)だと HTER は 16.80% で、I-FAS よりも悪い。先生の解き方を写すだけでは、汎化する力は身につかない。
- 手本の後に強化学習を続けると、16.80% から 9.23% に下がる。表の中でいちばん大きな一歩だ。
- その前に知識転移を加えると、最終的に 7.54% に届く。
ほかにもいくつかの比較
- 即答と推論後の回答:同じモデルで、1 ラウンド目の即答の HTER は 10.54%、ツールで調べた後の最終回答は 7.54%。即答でもすでに I-FAS より少し良く、ツールで一通り調べると、さらに 3 ポイント下がる。
- 拡大だけを許す:DeepEyes の ST-GRPO は ZoomIn しか許さず、報酬は形式、正解かどうか、ツールを使ったかどうかだけを見る。これに替えると HTER は 9.98% で、DT-GRPO の 7.54% より高い。
- ツール呼び出し回数の上限:付録の曲線では、上限を 1 回から 3 回に緩めると、HTER はおよそ 9.2% から 7.54% まで下がり続ける。4 回まで緩めると、逆に 8% 台前半に戻る。著者らは、回答が長くなり、サンプリングのばらつきが大きくなるためだと考えている。
- バックボーンと解像度:Qwen2.5-VL-7B に替えると、224×224 をそのまま入力した場合の HTER は 9.45%、448×448 に拡大すると 8.60%、InternVL3-8B は 7.54%。解像度とバックボーンがそれぞれ少しずつ寄与しているが、三つの数字はどれも I-FAS より低い。
従来の試験
付録では OCIM(O、C、I、M の四つのデータセットを順にテストセットにする)も試している。平均 HTER は 1.30% で、I-FAS の 1.33% とほぼ互角だ。四組の勝ち負けはまちまちで、OCM→I は 3.22% から 0.43% に下がった一方、OCI→M は 0.32% から 2.86% に上がった。
この試験方式の数字はすでに 1% 前後にひしめいていて、これ以上優劣をつけるのは難しい。訓練ステップ数は上限が決めてあるだけで(SFT は最大 4,000 ステップ、RL は最大 300 ステップ)、ターゲットデータセットでチェックポイントを選んだという記述は、論文にない。HTER に使う閾値をどう決めたかも、説明されていない。
推論はもっともらしく書けているが、そう推論したとは限らない
最後に、論文が選んだ四つの例を見よう。
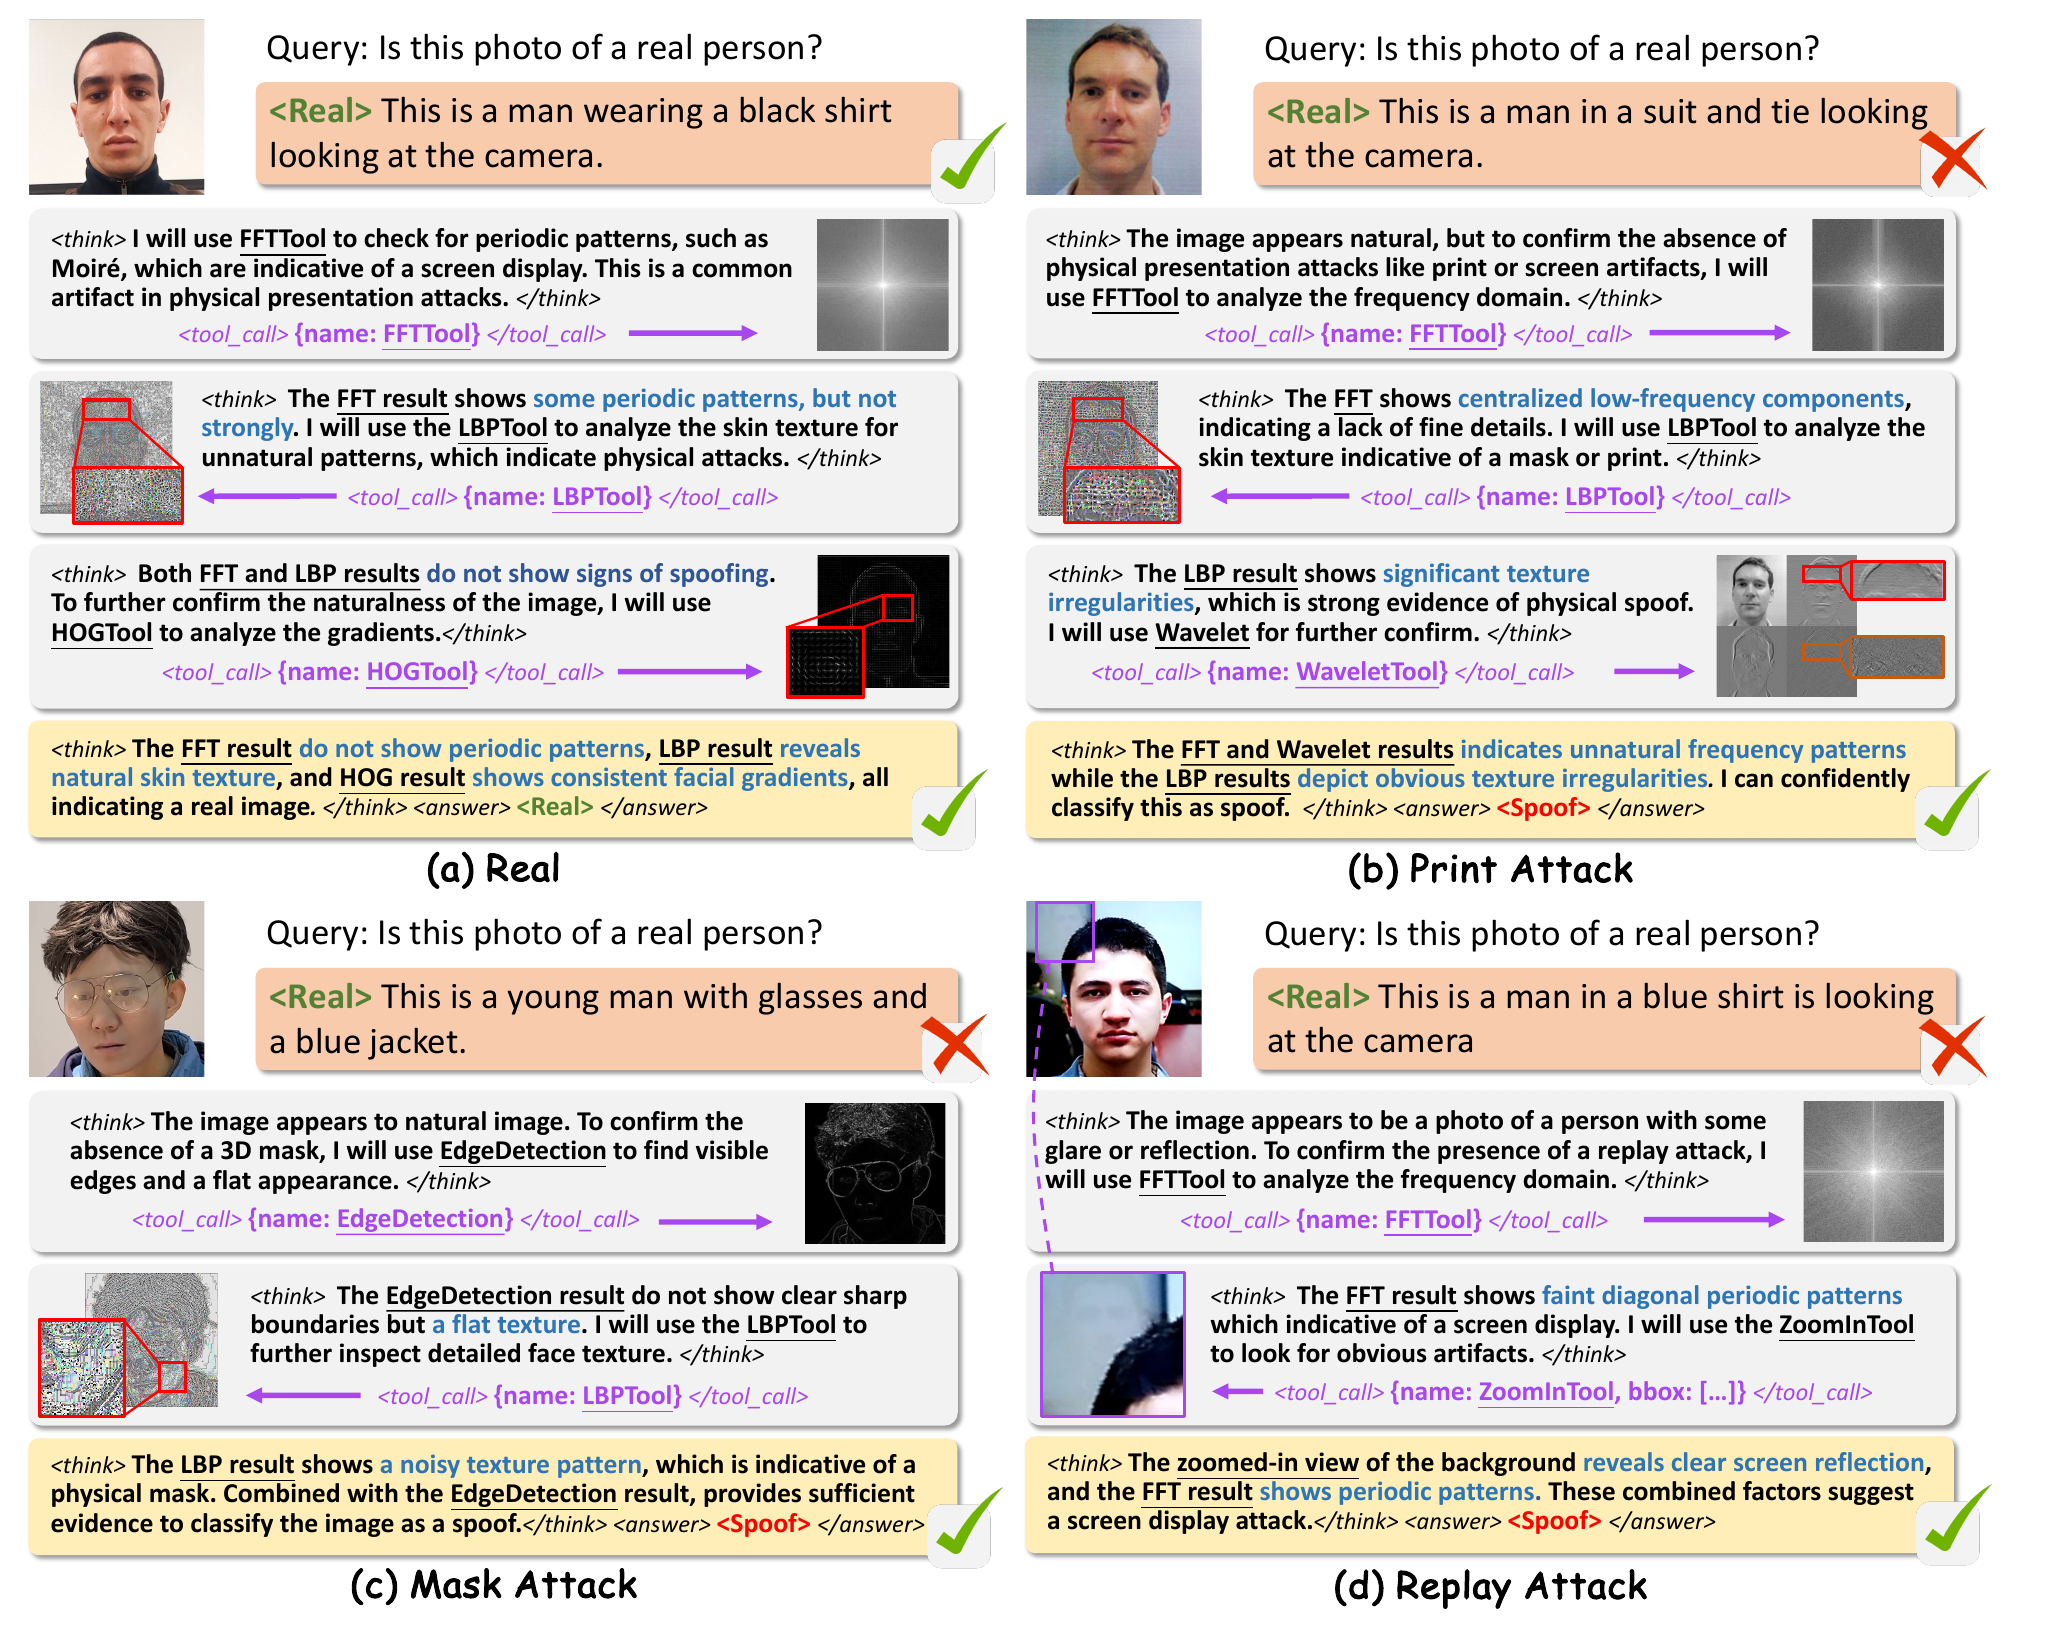
四つの例の即答はすべて Real だ。そのうち三つは攻撃で、ツールによって判定がひっくり返った。著者らの観察では、モデルは紙と画面には周波数ツールを、マスクには構造ツールを好んで使い、テクスチャツールはどの攻撃にも使う。
(a) の本物の例を、もう少し丁寧に読んでみる。FFT を調べた後、モデルは「FFT の結果にはいくらか周期的な模様が見られるが、はっきりしない」と書いている。それが最後のまとめでは、「FFT の結果に周期的な模様は見られない」に変わる。前半の留保は結論で消え、推論全体がきれいな話にまとめられている。
この問題の答えには影響しない。それでも、書かれた推論とモデルが実際に頼った手がかりが同じとは限らないことに、気づかされる。論文は、ツールの結果が本当に判断を左右したのかを検証していない。たとえばツールの出力を無関係な画像に差し替えて、答えが変わるかを見る、といった検証だ。
ほかにも、論文が示していないことが二つあり、デプロイのときには必ず問われる。一つは推論時間だ。8B のモデルがまず一度即答し、さらに最大 3 往復して、そのたびにツールの画像を一枚読み直す。一般的なスマートフォン向けの生体検知モデルなら CNN を一回走らせるだけなので、差は想像がつくが、論文は測っていない。もう一つはコードで、まだ公開されていない。
結論
TAR-FAS は、マルチモーダル大規模言語モデルに、推論の途中で LBP、FFT、HOG といった定番の演算子を呼び出させる。CelebA-Spoof だけで訓練して 11 のデータセットでテストする設定で、平均 HTER を I-FAS の 11.30% から 7.54% に下げ、マスク系のデータセットで最も大きく改善した。
この論文から持ち帰るべきは、アブレーション表のあの一歩だ。Gemini の手本をまねるだけでは、成績は I-FAS より悪い。同じモデルに真偽ラベルだけを見る GRPO を続けると、HTER は 16.80% から 9.23% に下がる。手本が教えるのはツールの使い方で、うまく使えるかどうかは強化学習で鍛えられる。
付録には、もう一つ小さな発見がある。畳み込み 3 層だけで、LBP や FFT の出力画像しか見ないエキスパートの小さなモデルが、CelebA-Spoof ですでに 8〜9 割の正解率を出している。論文の中で彼らの役目は、アノテーションのときに Gemini にこっそりメモを渡すことだけで、推論時には出番がない。
8B のモデルを顔認証のゲートに載せるかどうかは、コードが公開されて、遅延を測ってから考えよう。