原論文
An Unbiased Benchmark for Domain Generalization Face Anti-Spoofing
- 発表先
- SIBGRAPI Workshops 2025ワークショップ
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@inproceedings{faceantispoofingunbiaseddgfas2025,
  title = {{An Unbiased Benchmark for Domain Generalization Face Anti-Spoofing}},
  author = {Raul Almeida and Bruno Kamarowski and Bernardo Biesseck and Luiz Coelho and Roger Granada and David Menotti},
  year = {2025},
  booktitle = {SIBGRAPI Workshops},
  url = {https://sol.sbc.org.br/index.php/sibgrapi_estendido/article/view/38278}
}
クロスデータセットの顔なりすまし検知で、ここ数年最もよく使われてきた試験が OCIM だ。OULU-NPU(O)、CASIA-FASD(C)、Replay-Attack(I)、MSU-MFSD(M)の四つのデータセットから、毎回三つで訓練して一つでテストする。たとえば OCI→M である。2019 年から 2025 年にかけて、この評価の HTER は 18% 近くから 1% 未満まで下がり続けた。
ブラジルのパラナ連邦大学の Raul Almeida、David Menotti らは、ブラジルの本人確認企業 unico の研究者とともに、これらの数字がどう測られてきたのかを振り返った。彼らの答えはタイトルに書いてある。今の試験のやり方には偏りがある、というものだ。
これは進行中の研究をまとめた六ページだけの短い論文で、実験の規模も大きくない。ただ、問いの立て方はとても率直だ。
問題の定義
一般的な機械学習の流れでは、データを三つに分ける。訓練セットで重みを更新し、検証セットでいつ止めるか、どのハイパーパラメータを使うかを決め、テストセットはすべてが確定してから一度だけ見る。
OCIM には二つしかない。三つのソースデータセットで訓練し、四つ目のデータセットが検証セットとテストセットを兼ねる。訓練中は epoch を一つ終えるたびにテストセットで評価し、最後に最も成績のよかった epoch を報告する。著者らは、これは訓練の途中でずっと試験問題を盗み見ているのと同じだと指摘する。
なぜこれが重要なのか。運用の場には、そもそも試験問題がないからだ。本番に出たモデルが出会うのは新しいスマホ、新しい照明、新しい攻撃で、そのデータのラベルを先に渡して、いちばん合う epoch を選ばせてくれる人はいない。テストセット上で選んだ成績は、実際に得られる成績よりもよく見える。
どれくらいよく見えるのか。極端な状況で計算してみよう。モデルの真の誤り率がどの epoch でも 10% に固定され、まったく進歩していないとする。テストセットには本物 40 本、攻撃 80 本があり、HTER を測るたびにサンプリングによって値が上下する。同じ実験を 2,000 回繰り返し、「N 個の epoch から最低のものを選ぶ」と平均でいくつが報告されるかを見る。
import numpy as np

rng = np.random.default_rng(0)
n_live, n_spoof, true_error, trials = 40, 80, 0.10, 2000

def measured_hter(epochs):
    apcer = rng.binomial(n_spoof, true_error, (trials, epochs)) / n_spoof
    bpcer = rng.binomial(n_live, true_error, (trials, epochs)) / n_live
    return (apcer + bpcer) / 2

for epochs in (1, 10, 30, 100):
    best = measured_hter(epochs).min(axis=1)        # 実験ごとに最低の epoch を選ぶ
    print(f"{epochs:>3} 個の epoch から最低を選ぶ:平均 {best.mean():.1%}")
  1 個の epoch から最低を選ぶ:平均 9.9%
 10 個の epoch から最低を選ぶ:平均 5.8%
 30 個の epoch から最低を選ぶ:平均 4.6%
100 個の epoch から最低を選ぶ:平均 3.6%
モデルは少しも変わっていない。テストセットを見る回数が増えるほど、選ばれる数字がきれいになるだけだ。100 回見れば、10% のモデルが 3.6% と報告できる。実際の訓練では epoch ごとのモデルにもともと良し悪しがあり、最良のものを選ぶことには運以外の要素もある。それでも、選ぶ根拠がテストセットである限り、この運の分が報告される数字に紛れ込み、あとから切り分けることもできない。
著者らによれば、この問題に気づいた先行研究もあったが、どれも部分的な手当てにとどまっている。たとえば SA-FAS は最後の 10 epoch の平均も報告し、TPR@FPR のような運用に近い指標を加えて報告する論文もある。こうした工夫で数字は実態に近づくが、テストセットが訓練中に見られていることに変わりはない。著者らの知る限り、この偏りを専門に扱い、代わりの試験方式を提案したのはこれが初めての研究だという。
問題の解決
変更は一つだけ、データセットをもう一つ加えることだ。
この五つ目のデータセットには二通りの使い方がある。
- 検証セットとして加える:OCIM の訓練とテストはそのままに、epoch ごとの評価を新しい検証セットで行い、それで最良の epoch を選ぶ。訓練が終わってから、もとのテストセットで HTER を一度だけ計算する。
- テストセットとして加える:もとの四つ目のデータセットは検証セットに回し、最終成績はこの新しいデータセットで測る。
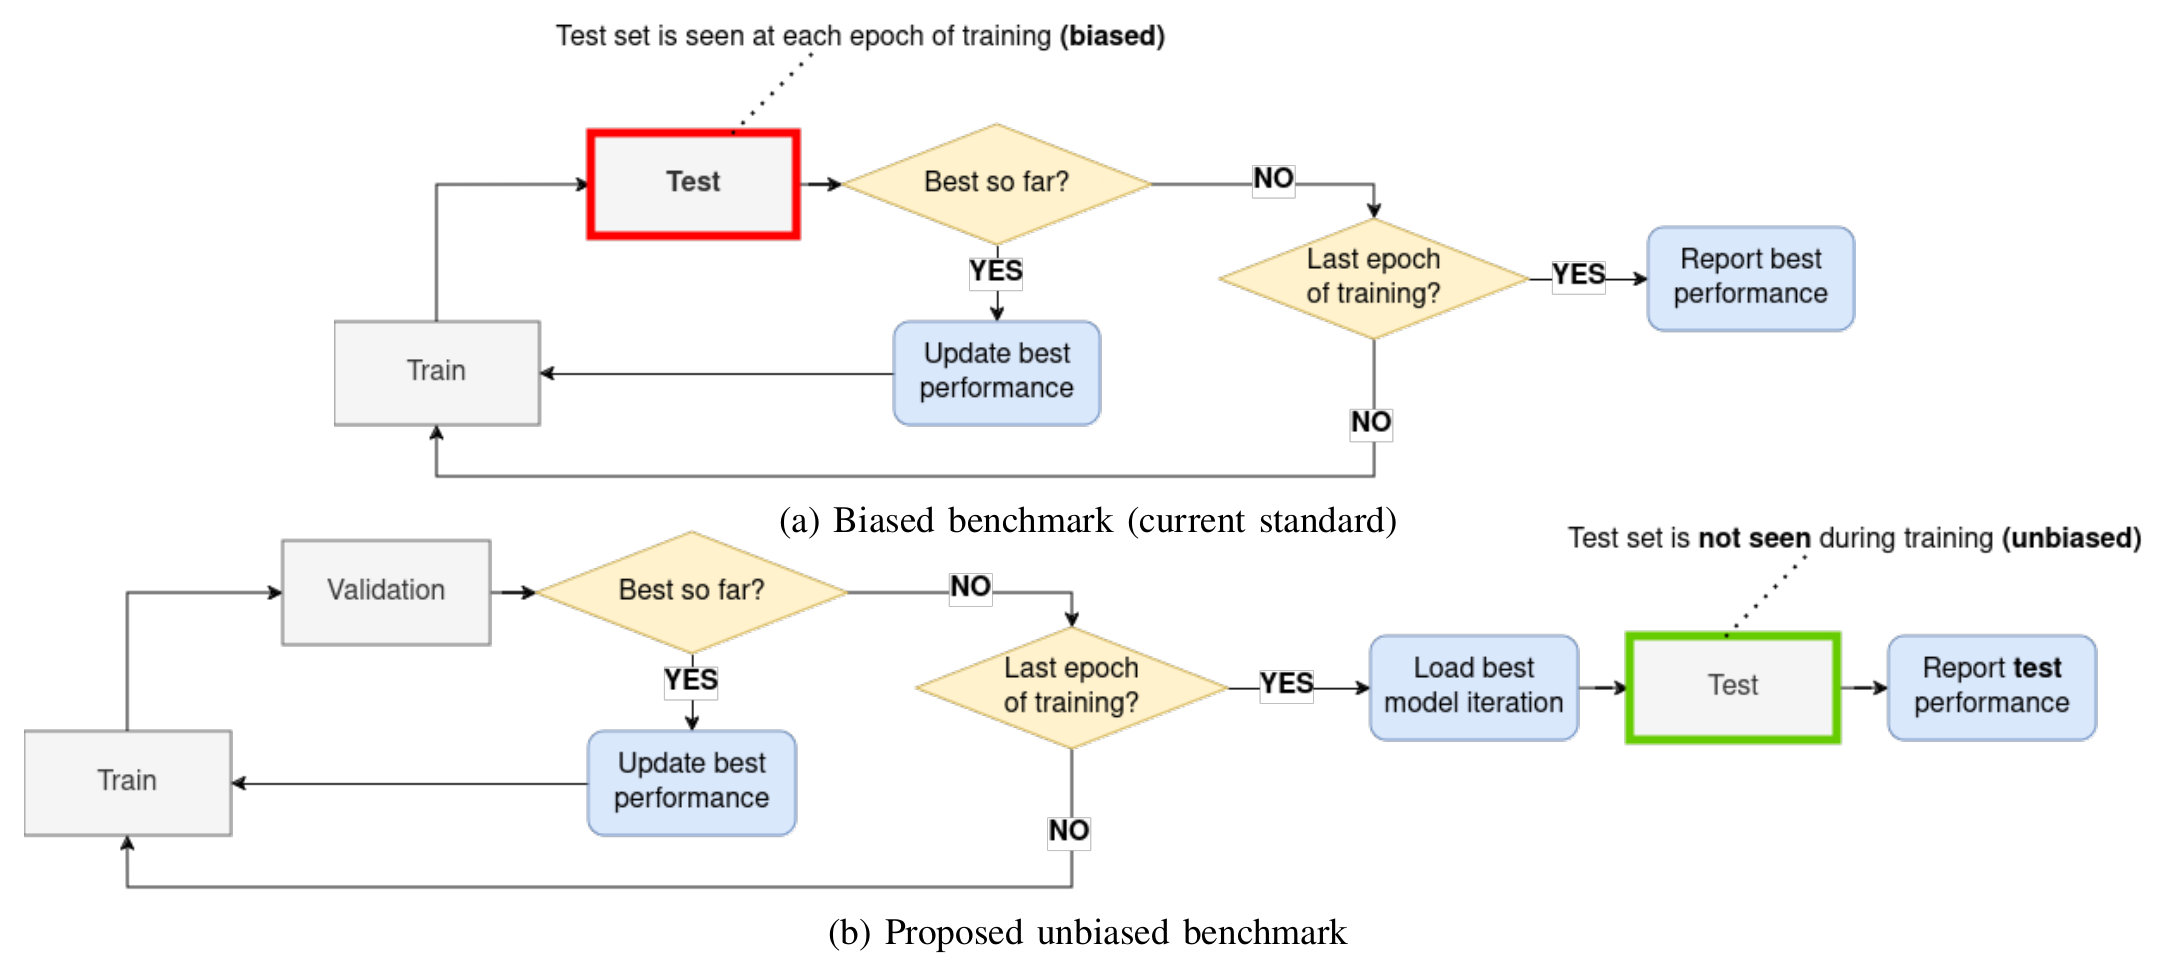
二つのフローチャートのループはほとんど同じで、違いはループ内で「最良を選ぶ」役目のマスにある。上は赤枠の Test で、epoch を一つ終えるたびに一度見る。下ではそれが Validation に替わり、Test はループの外に出て、最後に一度だけ実行される。
どちらの使い方でも、テストセットは訓練中に一切登場しない。著者らは一つ目を推している。やはり誰もが、O、C、I、M というおなじみの四つのデータセットで成績を見たいからだ。
五つ目のデータセットはどう選ぶのか。著者らはデータ量、攻撃の種類、被験者数、サンプルの多様性の四点を考慮し、最終的に二つの候補を選んだ。
| データセット | 年 | 被験者 | 本物 | 攻撃 | 攻撃の種類 |
|---|---|---|---|---|---|
| CASIA | 2012 | 50 | 150 | 450 | 印刷、再生 |
| Replay | 2012 | 50 | 200 | 1,000 | 印刷、再生 |
| MSU | 2014 | 35 | 70 | 210 | 印刷、再生 |
| Oulu | 2017 | 55 | 720 | 2,880 | 印刷、再生 |
| SiW | 2018 | 165 | 1,320 | 3,300 | 印刷、再生 |
| Rose-Youtu | 2018 | 20 | 897 | 1,601 | 印刷、再生、マスク |
SiW と Rose-Youtu は規模が OULU-NPU と同程度で、年も新しく、照明、環境、攻撃に変化がある。SiW にはさらに姿勢と表情の変化もある。Rose-Youtu には紙マスクの攻撃があるが、著者らはこれを除き、評価を印刷と再生だけに保って、新しい攻撃の種類が混ざらないようにした。
モデルは四つ選んだ。ImageNet で事前学習した ResNet-18 と ResNet-50 をベースラインとし、コードが公開されていて再実験の結果が原論文に近い SA-FAS と GAC-FAS の二手法を加える。指標は従来どおり HTER と AUC を使う。
討論
まず、もとの試験方式で再実験する
著者らはまず、もとの試験方式、つまりテストセットが検証セットを兼ねる形で SA-FAS と GAC-FAS を再実験し、GAC-FAS の著者が提供した重みもテストした。元のコードと同じデータを使っても、数字は原論文とずれる。OCI→M を例にとると、GAC-FAS は原論文で 5.00%、提供された重みでも 5.00%、自分たちで訓練し直すと 7.92% だった。OMI→C では、三つの数字はそれぞれ 8.20%、10.00%、12.22% である。
同じコードでも、一度訓練し直すだけで数ポイント違うことがある。以降の比較では、著者らは常に自分たちの再実験の数字どうしを比べている。
検証セットで選び直す
主な結果は Table III にある。以下は SiW を検証セットにした場合の抜粋だ。矢印の左がもとの試験方式、右が SiW で検証したもので、単位は HTER(%)である。
| テストデータセット | SA-FAS | GAC-FAS |
|---|---|---|
| OULU-NPU | 12.13 → 13.81 | 10.52 → 7.91 |
| Replay-Attack | 9.00 → 21.50 | 5.00 → 8.55 |
| CASIA-FASD | 14.00 → 26.67 | 12.22 → 9.14 |
| MSU-MFSD | 11.43 → 11.43 | 7.92 → 7.31 |
SA-FAS は Replay-Attack で 9.00% から 21.50%、CASIA-FASD で 14.00% から 26.67% に上がり、どちらもおよそ倍になった。MSU-MFSD では変わらない。
GAC-FAS はちょうど逆で、四組のうち三組で改善し、ICM→O の 7.91% は原論文が報告した 8.60% より低いほどだ。著者らはこれを予想外の発見として挙げているが、原因をそれ以上は分析していない。少なくとも確かなのは、試験方式を変えたとき、同じ手法の数字がそろって同じ向きに動くとは限らないということだ。
二つの ResNet ベースラインも、それぞれ別の動きをした。ResNet-18 は SiW で検証すると四組すべてで悪化し、たとえば OCM→I は 31.50% から 37.50% に上がった。一方の ResNet-50 は二組で改善し、OCI→M は 32.08% から 25.42%、ICM→O は 33.33% から 32.78% に下がった。著者らはこれを、GAC-FAS とともに改善した例として挙げている。
検証セットにも選び方がある
Rose-Youtu を検証セットにすると、どのモデルも全般に悪くなる。たとえば SA-FAS の OMI→C は、SiW で検証すると 26.67%、Rose-Youtu で検証すると 40.67% だった。Rose-Youtu をテストセットにしても同じで、SiW よりずっと難しい。O、C、I で訓練し、MSU-MFSD を検証セットにした場合、最後に SiW でテストすると SA-FAS と GAC-FAS の HTER は 10.05% と 9.58% だが、Rose-Youtu でテストすると 25.18% と 32.74% になる。同じ二つのモデルが、ある新しいデータセットではまだ使えるのに、別のデータセットに移ると HTER が 25% を超えてしまう。
著者らは、検証セット上の EER とテストセット上の HTER も比べた。普通は検証の成績のほうがテストの成績よりよく、これは機械学習の文献での経験と一致すると著者らは述べる。ところが Rose-Youtu で検証した実験では、逆の傾向が出た。著者らはその原因を検証データとテストデータの間のドメインの差だろうと考え、そこから、SiW のドメインのほうが Rose-Youtu より四つのテストデータセットに近いと推測している。
ここから新しい問題が出てくる。テストセットは伏せたが、どのデータセットを検証セットにするかによっても、選ばれる epoch と最終成績が変わる。著者らの勧めは両方試すことだ。一組しかできないなら、SiW を検証セットにして ICM→S→O、OCM→S→I、OCI→S→M、OMI→S→C の四組を回す。
野外のデータで試す
最後に著者らは、OCIM で訓練した SA-FAS と GAC-FAS を WFAS でテストした。WFAS はウェブのクローリングで作られたデータセットで、1,383,246 枚の画像、469,920 人、17 種類の攻撃を含み、SiW のおよそ 300 倍の大きさがある。テストセットのラベルは公開されておらず、APCER、BPCER、ACER はコンペティションのプラットフォームを通じてしか得られない。
結果は、二つの手法の ACER がどちらも 28.62% から 32.54% の間に収まり、それぞれ二組ずつ勝った。WFAS コンペティションの優勝チームは 2.82% である。著者らは GAC-FAS を WFAS の訓練セットで直接訓練することもしており、最後の iteration のモデルで ACER は 21.51% だった。
WFAS には OCIM にない攻撃の種類が多く、この評価はクロスデータセットと攻撃の種類をまたぐ汎化を同時に問う。そもそも、これらの手法が設計時に想定した問題の外にある。とはいえ、運用で出会うのはまさにこういう状況だ。
結論
この論文が解こうとした問題ははっきりしている。OCIM の慣例ではテストセットが訓練中に繰り返し参照され、報告される数字は運用で実際に得られるものよりよく見える。著者らの修正も単純で、データセットを一つ増やして検証セットにし、テストセットは訓練が終わってから見る。
実験を見る限り、この偏りの大きさは手法によって違う。SA-FAS は二組の評価で HTER がおよそ倍になり、GAC-FAS は逆にほとんどの組で改善した。そのため「どちらが優れているか」という順位そのものも、試験方式によって変わりうる。検証セットの選び方も結果に影響し、SiW と Rose-Youtu では数字が大きく違う。
限界も合わせて見ておきたい。これは進行中の研究で、再実験したのは DG 手法二つと ResNet ベースライン二つだけだ。各実験を何個の乱数シードで回したのかも、論文には書かれていない。再実験の数字自体も原論文とずれている。著者らはコードの置き場所を論文に記し、発表後に公開するとしている。
モデルを本番に出す人なら、このやり方をそのまま自分の評価手順に取り入れられる。epoch と閾値を選ぶときはテストセット以外のデータを使い、テストセットは最後まで開けずにおく。