原論文
Harnessing Chain-of-Thought Reasoning in Multimodal Large Language Models for Face Anti-Spoofing
- 発表先
- CVPR 2026国際会議
- arXiv への初回投稿
- arXiv:2506.01783
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{faceantispoofingfacecot2025,
  title = {{Harnessing Chain-of-Thought Reasoning in Multimodal Large Language Models for Face Anti-Spoofing}},
  author = {Honglu Zhang and Zhiqin Fang and Ningning Zhao and Saihui Hou and Long Ma and Renwang Pei and Zhaofeng He},
  year = {2025},
  eprint = {2506.01783},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2506.01783}
}
再撮影した写真を一枚、汎用のマルチモーダル大規模言語モデルに渡して「これは攻撃ですか?」と聞いたら、どうなるだろう?
この論文の付録が、ちょうどその実験をしている。著者らは Rose-Youtu の攻撃画像を、微調整していないモデルにそのまま渡して、攻撃と判定した割合を種類ごとに数え、FaceCoT で訓練した後の結果と比べた。
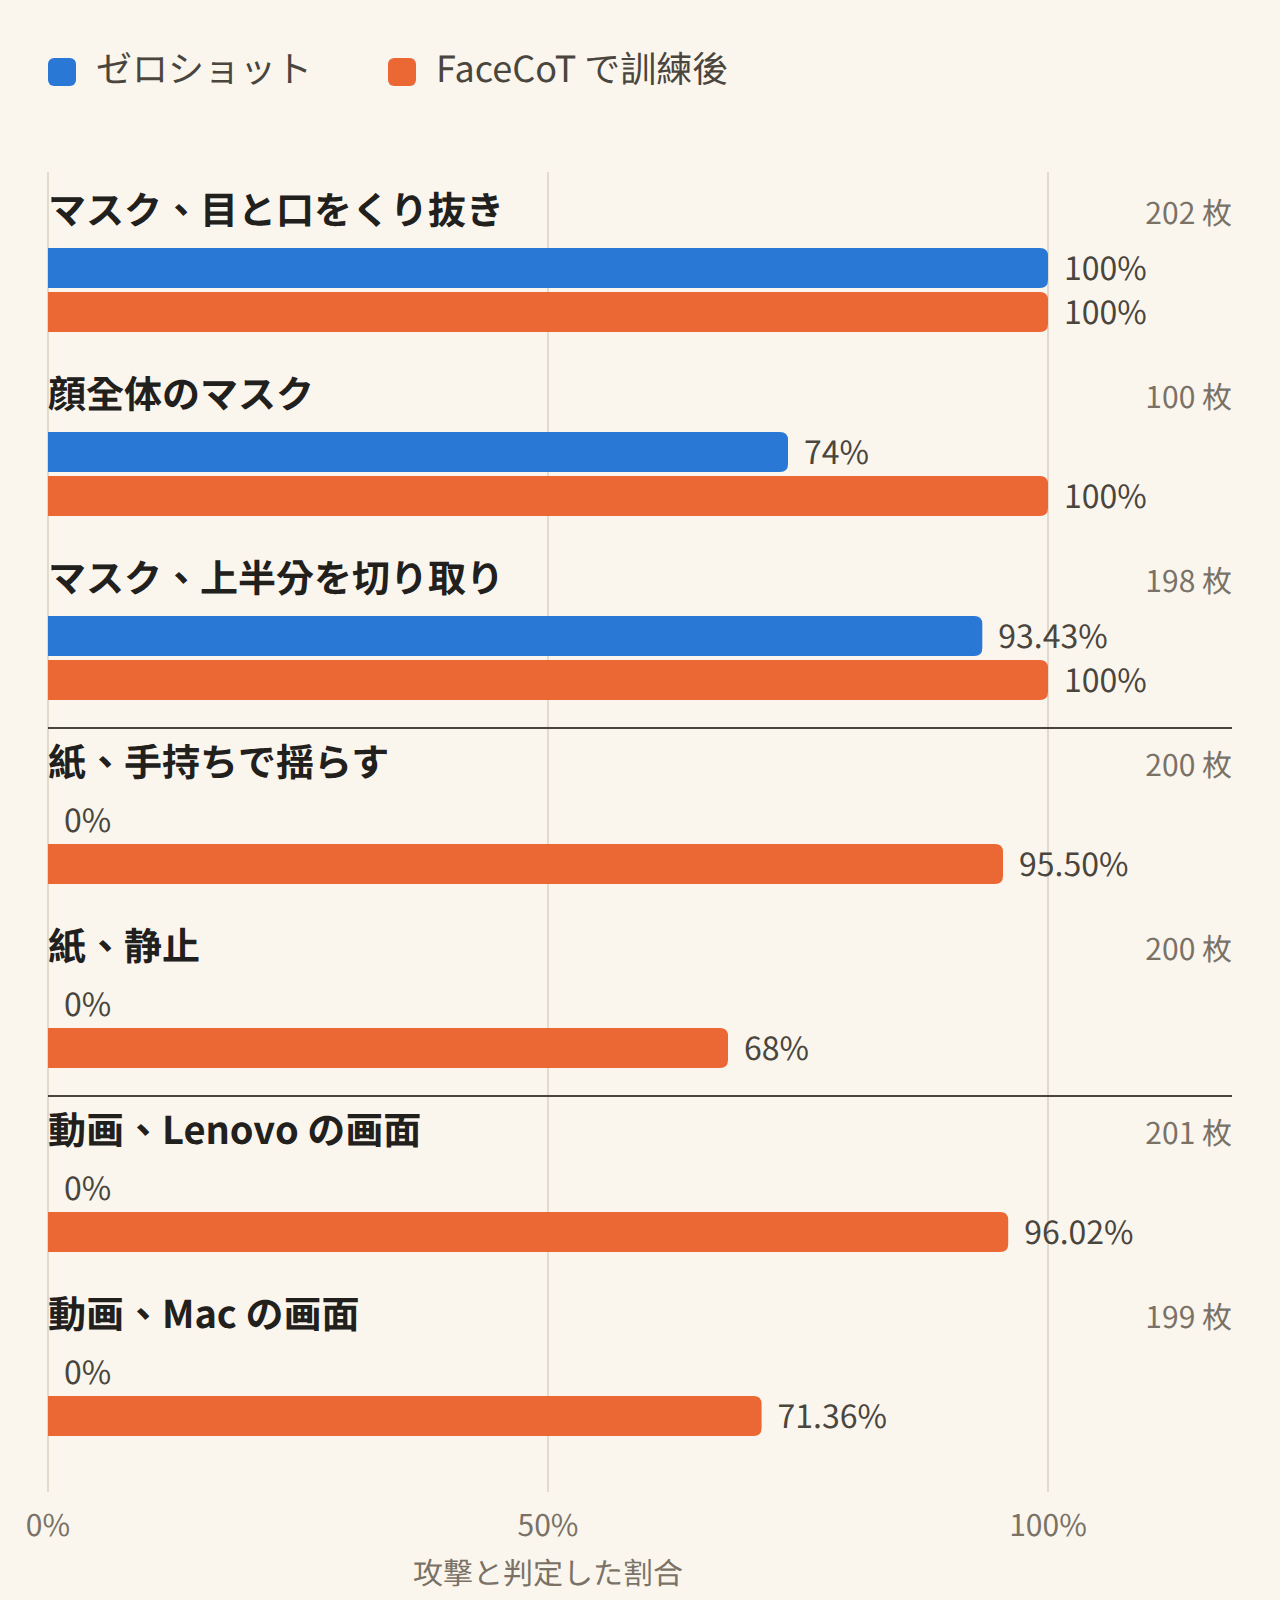
マスクはほとんど見抜けたのに、紙と画面は一枚も捕まえられなかった。汎用モデルにとって、画面の中の顔は、ただの顔に見えるのだ。
滴滴出行(DiDi)、北京郵電大学、北京師範大学のチームは、足りないのはデータだと考えた。なりすまし検知のデータセットには、画像と真偽のラベルしかない。大規模言語モデルに判断の根拠を一歩ずつ語らせるには、まず画像とテキストの問答データが要る。そこで彼らは FaceCoT を作った。108 万件の問答で、どれにも六段構成の推論が付いている。さらに、それを使うための二段階の訓練方法も設計した。
問題の定義
I-FAS はモデルにまず真偽を答えさせ、続けて一文の説明を付けさせる。説明は微調整した captioner が生成し、文の中に screen や paper といった攻撃媒体を挙げる。単なるラベルよりは少し意味が増えるが、結局は一文にすぎない。
著者らが求めたのは、判断の過程全体だ。まず画像全体を見て、次に顔を見て、目鼻や肌の細部を挙げ、それから推論し、攻撃手法を説明して、最後にようやく結論を出す。これを実現するには、一件ごとにこうした推論が書かれたデータと、推論と分類を同時に学べる訓練方法の両方が必要になる。
訓練方法については、著者らが別に理由を述べている。推論の文章と分類ラベルを混ぜて end-to-end で訓練すると、分類のほうが早く収束し、推論を学び終える前に訓練が終わってしまう。視覚エンコーダも、細部の描写から何かを学ぶ機会を得られない。
問題の解決
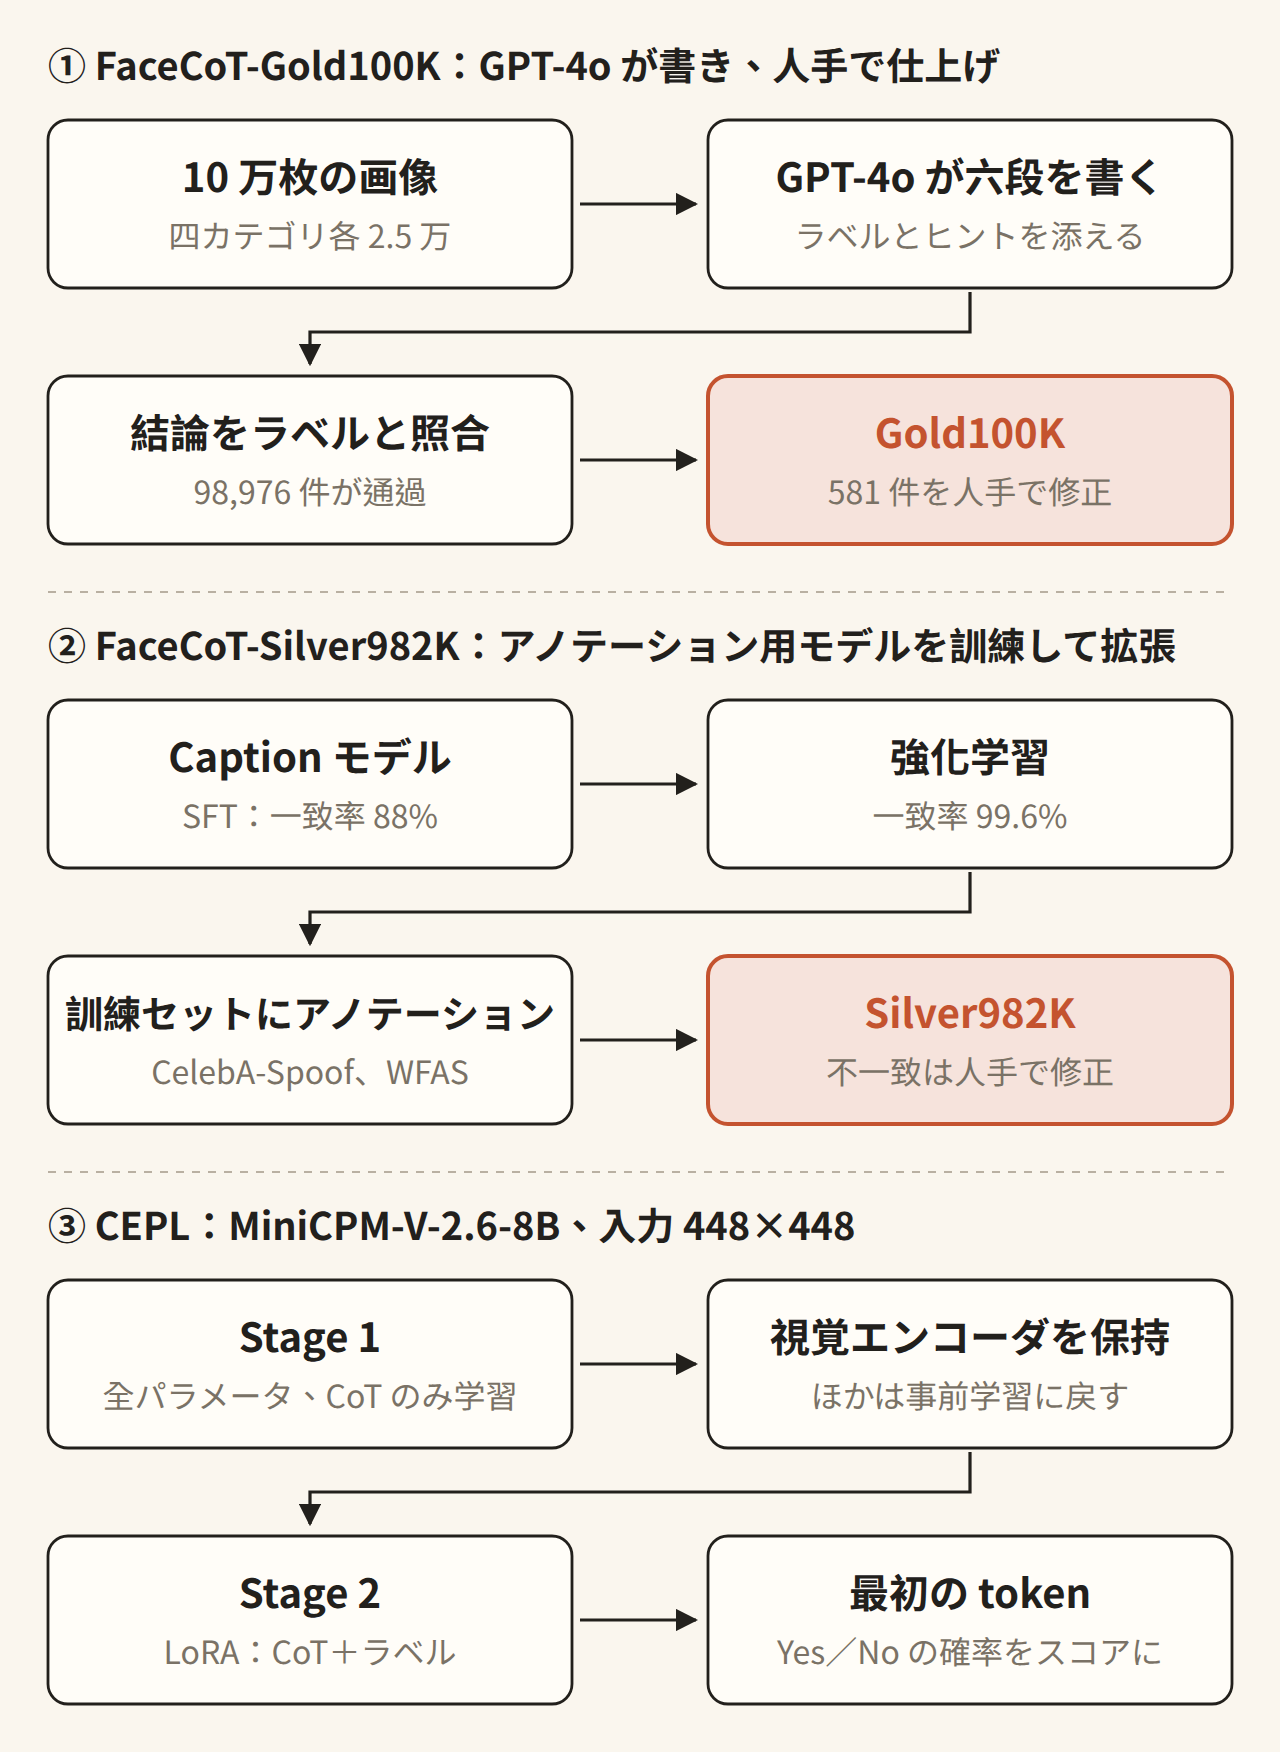
全体の流れは三段に分かれる。前の二段でデータを作り、三段目でモデルを訓練する。
データはどこから来たか
画像は二つのデータセットから来ている。CelebA-Spoof は 62.5 万枚の画像、1 万人、10 種類の攻撃。WFAS は制御されていない環境で集めた野外データで、138 万枚の画像のうち 85.3 万枚が攻撃、52.9 万枚が本物で、14 種類の攻撃を含む。
選び抜いた 10 万枚は、2.5 万枚ずつ四つのカテゴリに分かれる。
- 本物:すべて WFAS から取った。シーンが最も多様だからだ。
- 印刷:写真とポスターが各 5,000、新聞、アルバム、A4、顔の印刷、上半身の印刷が各 3,000。
- 再生:スマートフォンとタブレットが各 10,000、PC の画面が 5,000。
- マスク:3D マスク 12,768、部分マスク 10,579、ガレージキット 1,488、リアルドール 165。
三つの大きなカテゴリの下に、合わせて 14 種類の攻撃がある。各カテゴリの中では、サブカテゴリごとの枚数ができるだけ揃うようにしている。
六段構成の推論
回答はどれも六つのタグで区切られる:
<Caption>画像全体に何が写っているか</Caption>
<Facial Description>顔の様子</Facial Description>
<Facial Attributes>目、鼻、口、肌などの細部</Facial Attributes>
<Reasoning>ここまでの情報をまとめ、一歩ずつ判断する</Reasoning>
<Spoofing Description>攻撃手法と決め手になる痕跡</Spoofing Description>
<Conclusion>Yes または No</Conclusion>
質問は「あなたは顔のなりすまし検知の専門家です。答えてください:これは攻撃ですか?」なので、Yes は攻撃、No は本物を表す。
論文冒頭の例は、女性の顔が印刷された紙のマスクを手に持つ人で、目、鼻、口の位置には穴が開けてある。六段の中身を順に並べると、次のようになる。
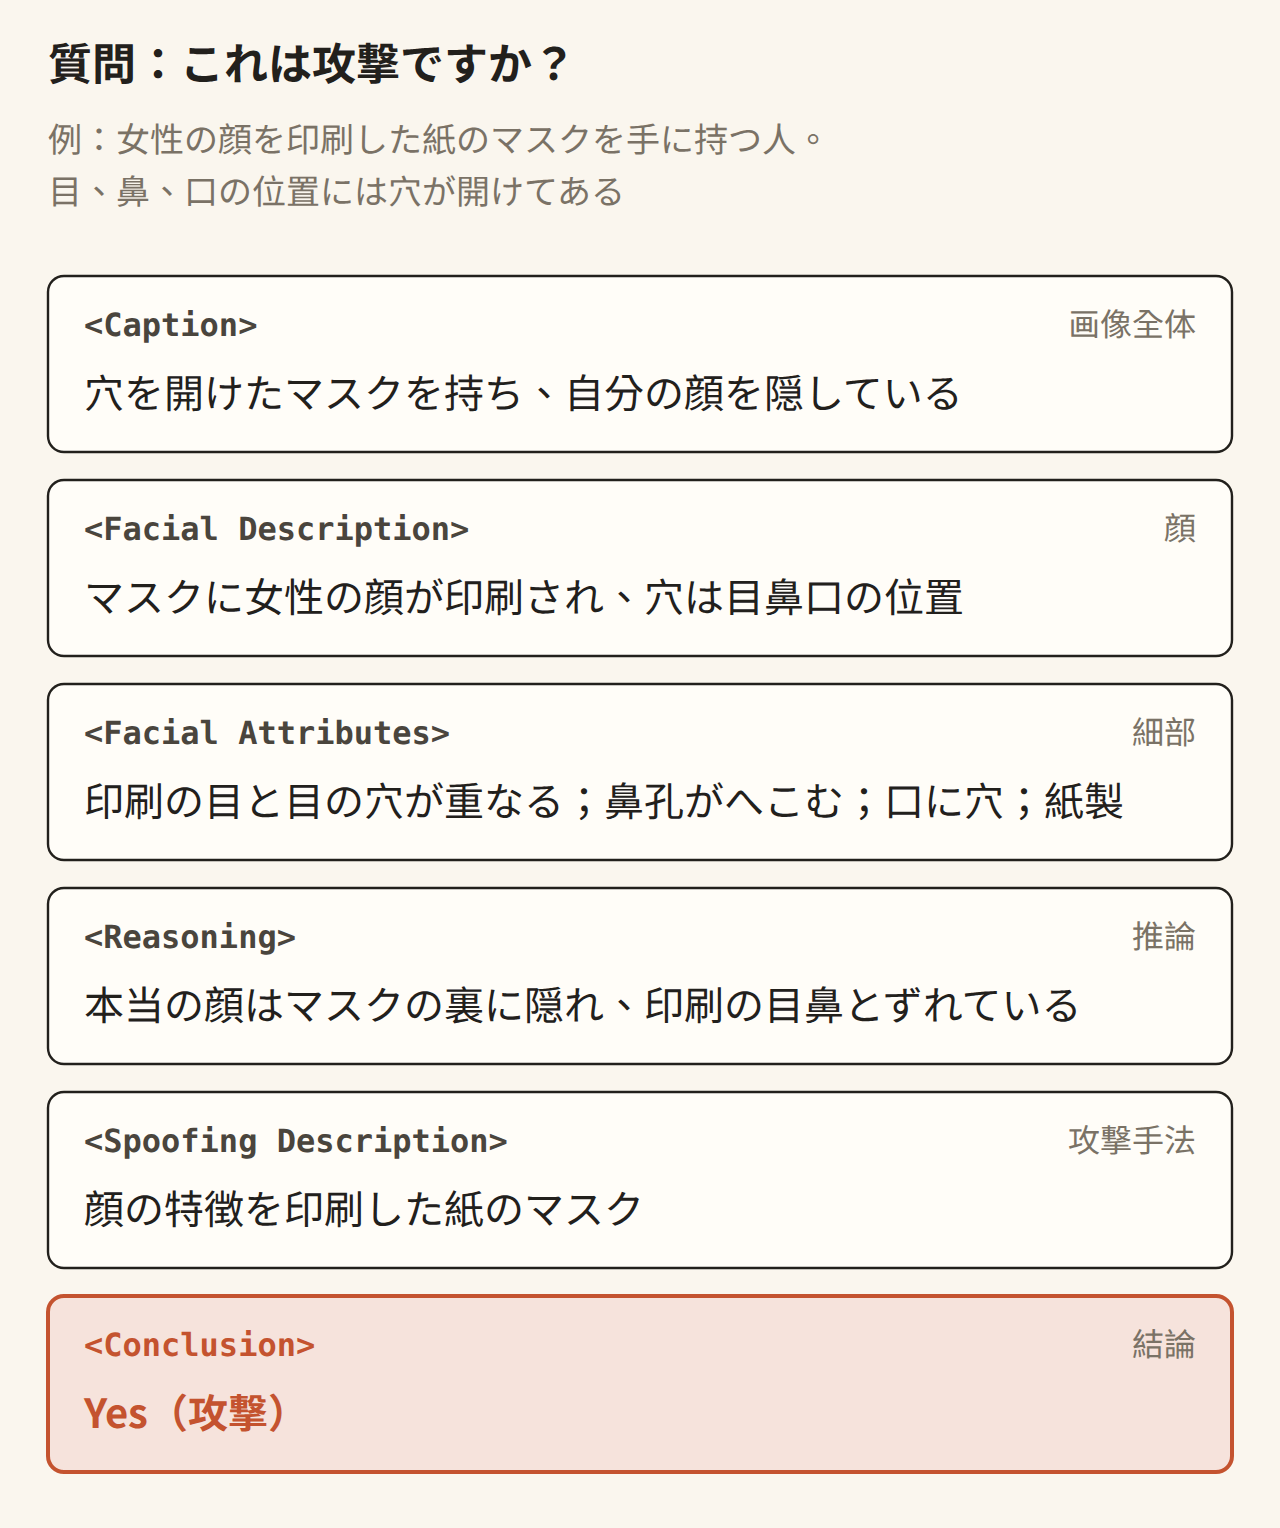
大きなものから小さなものへ、全体から部分へと進み、最後にようやく結論を出す。著者らによれば、人が真偽を見分けるときの順序をまねたものだという。
GPT-4o に答えを見ながら書かせる
Gold100K の六段の文章は GPT-4o が書いた。付録には、GPT-4o が毎回受け取る五つのものが書かれている。画像、システムプロンプト、質問、ヒント、そしてその画像のラベルだ。
システムプロンプトは GPT-4o に「審査員」の役を与え、六段の形式で答えさせる。しかも結論は模範解答と完全に一致しなければならない。つまり GPT-4o が書くのは自分の判断ではなく、答えを知ったうえでの詳しい解説だ。
なぜ答えとヒントを渡すのか。付録に例が一つある。日本の新聞を撮影した画像で、GPT-4o は新聞の紙面だと見抜いたのに、攻撃ではないと判定した。理由は、顔が鮮明で自然、加工の跡がなく、新聞にも顔の入れ替えや改ざんの兆候はない、というものだった。GPT-4o は「攻撃」をデジタルな改ざんのことだと受け取っていたのだ。
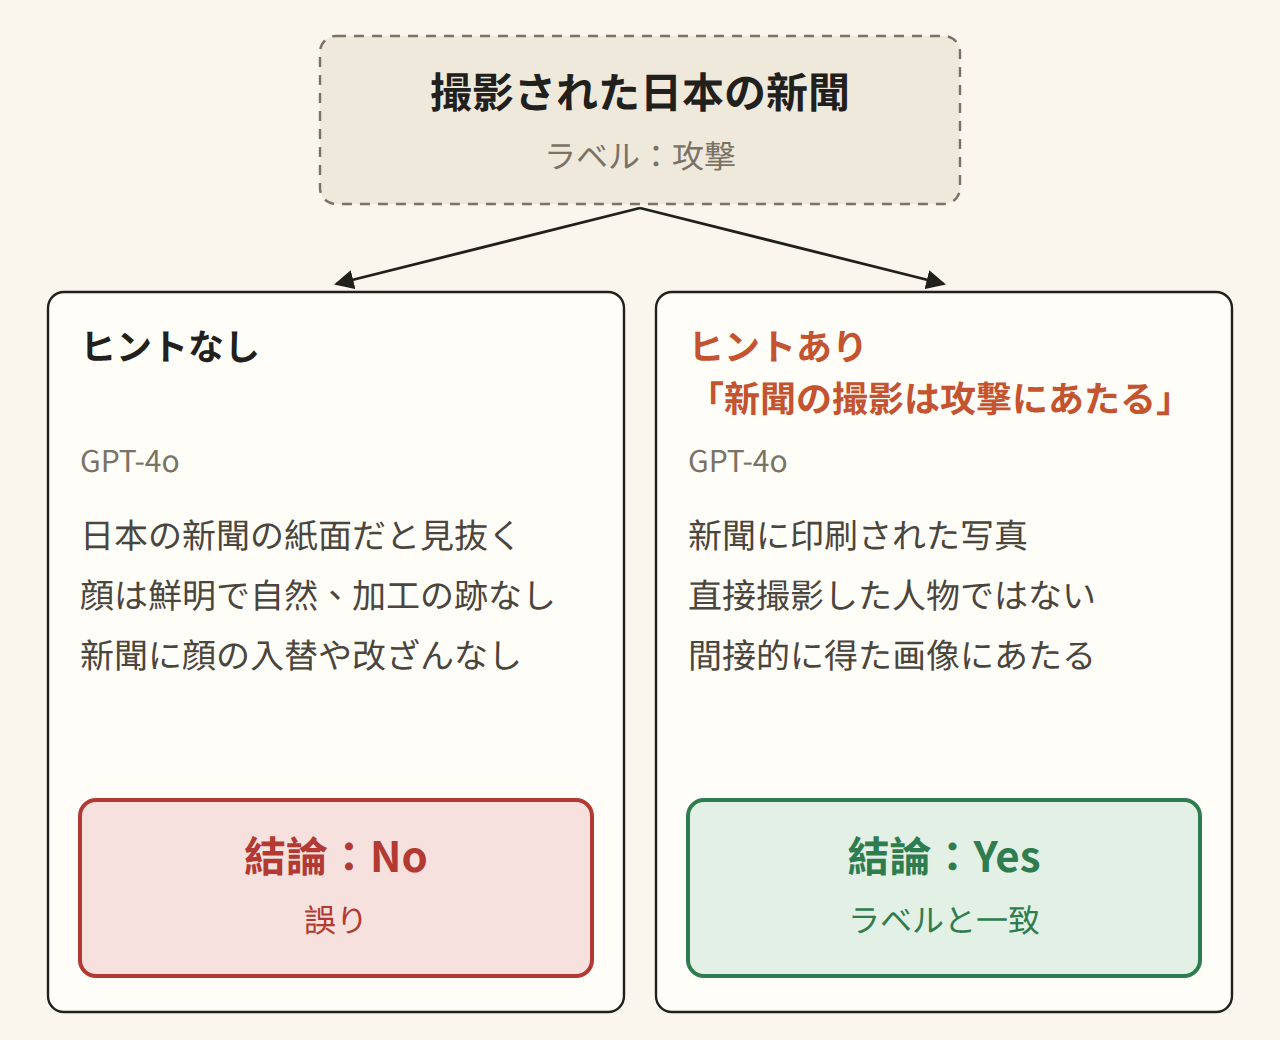
「新聞の撮影は攻撃にあたる」というヒントを加えると、GPT-4o は答えを変えた。新聞に印刷されているのは、確かに実在の人物だ。新聞を撮った画像を攻撃とみなすかどうかは、なりすまし検知というタスク独自のルールである。そこで著者らは、紙と画面による 10 種類の攻撃それぞれに、「ポスターの撮影は攻撃にあたる」「スマートフォン画面の撮影は攻撃にあたる」のようなヒントを一文ずつ書いた。マスク類はモデルが自分で見分けられるので、ヒントは付けていない。
ゼロショットのモデルが紙と画面をすべて本物とみなしたのも、おそらくこれが理由の一つだ。このルールを教わっていないのである。
書き終えたら、正規表現で <Conclusion> の中身を取り出し、ラベルと照合する。一回目で 98,976 件が一致し、残りは GPT-4o にもう一度アノテーションさせた。それでも一致しなかった 581 件は難しいサンプルとして人手に回した。人手ではまず結論を確認し、次に推論や描写のどこが誤っているかを探し、直したうえで後ろの段がつながるように書き直す。
GPT-4o の費用は一枚あたり約 0.01 ドルで、10 万枚ならおよそ 1,000 ドルだ。
98 万件に広げる
さらに 100 万枚にアノテーションを付けるとなると、GPT-4o と人手では高くつきすぎる。著者らは代わりに、六段構成の推論を書くことに特化した caption モデルを訓練した。
まず Gold100K で教師あり微調整(SFT)をする。それで未見の画像にアノテーションを付けると、結論がラベルと一致したのは 88% だけで、よくある失敗は内容の誤りと形式の崩れだった。続いて強化学習を一段加える。報酬は二つだけだ。結論がラベルと一致すれば 1 点、形式が六段のテンプレートに合っていれば 1 点。さらに KL ペナルティで引き止め、SFT 版から離れすぎないようにする。これを終えると、無作為に抽出した未アノテーションの画像 2,000 枚で、一致率は 99.6% まで上がった。
このモデルで CelebA-Spoof と WFAS の訓練セットにアノテーションを付けたものが Silver982K で、うち本物は約 36.8 万件。結論がラベルと一致しないサンプルは、こちらも人手で修正した。caption モデルの訓練は A100 8 枚でおよそ一日、アノテーション自体は約 288 GPU 時間。二つのサブセットの人手によるクリーニングには、アノテーター 6 人で三日かかった。
CEPL:まず目を鍛え、それから話すことを学ぶ
バックボーンは MiniCPM-V-2.6-8B で、視覚エンコーダ、resampler、言語モデルからなり、入力は 448×448 にリサイズする。CEPL(CoT-Enhanced Progressive Learning)は二つの段階に分かれる:
- Stage 1、視覚強化の事前学習:全パラメータを微調整し、六段の推論の文章だけを教師信号にする。狙いは、視覚エンコーダが文章中の細部の描写、たとえばマスクの縁、紙の質感、画面の反射に導かれて、そうした箇所に注意を向けられるようにすることだ。
- Stage 2、マルチタスクの同時訓練:Stage 1 の視覚エンコーダだけを残し、resampler と言語モデルはもとの事前学習の重みに戻す。言語モデルに LoRA を加え、推論の文章と二値ラベルを同時に使って訓練する。
Stage 2 では、なぜ言語モデルをリセットするのか。論文は、視覚エンコーダが学んだ細部を保ち、ほかのモジュールは事前学習の重みに戻すと述べるだけで、それ以上は説明していない。一つの解釈として、Stage 1 は文章による教師信号を借りて視覚エンコーダを訓練する手段にすぎず、その段階で言語モデルが学んだことは残す必要がない、と見ることができる。
訓練は AdamW、学習率 1e-6、最大 10 epoch、バッチサイズ 256、A100 8 枚で、各実験は三つの乱数シードで回して平均を取る。
スコアはどこから来るのか
なりすまし検知の指標である HTER と AUC には、連続値のスコアが必要だ。付録にそのやり方が明記されている。ランダム性を切って貪欲デコードを行い、モデルが生成する最初の token について Yes と No の logits を取り、softmax をかける:
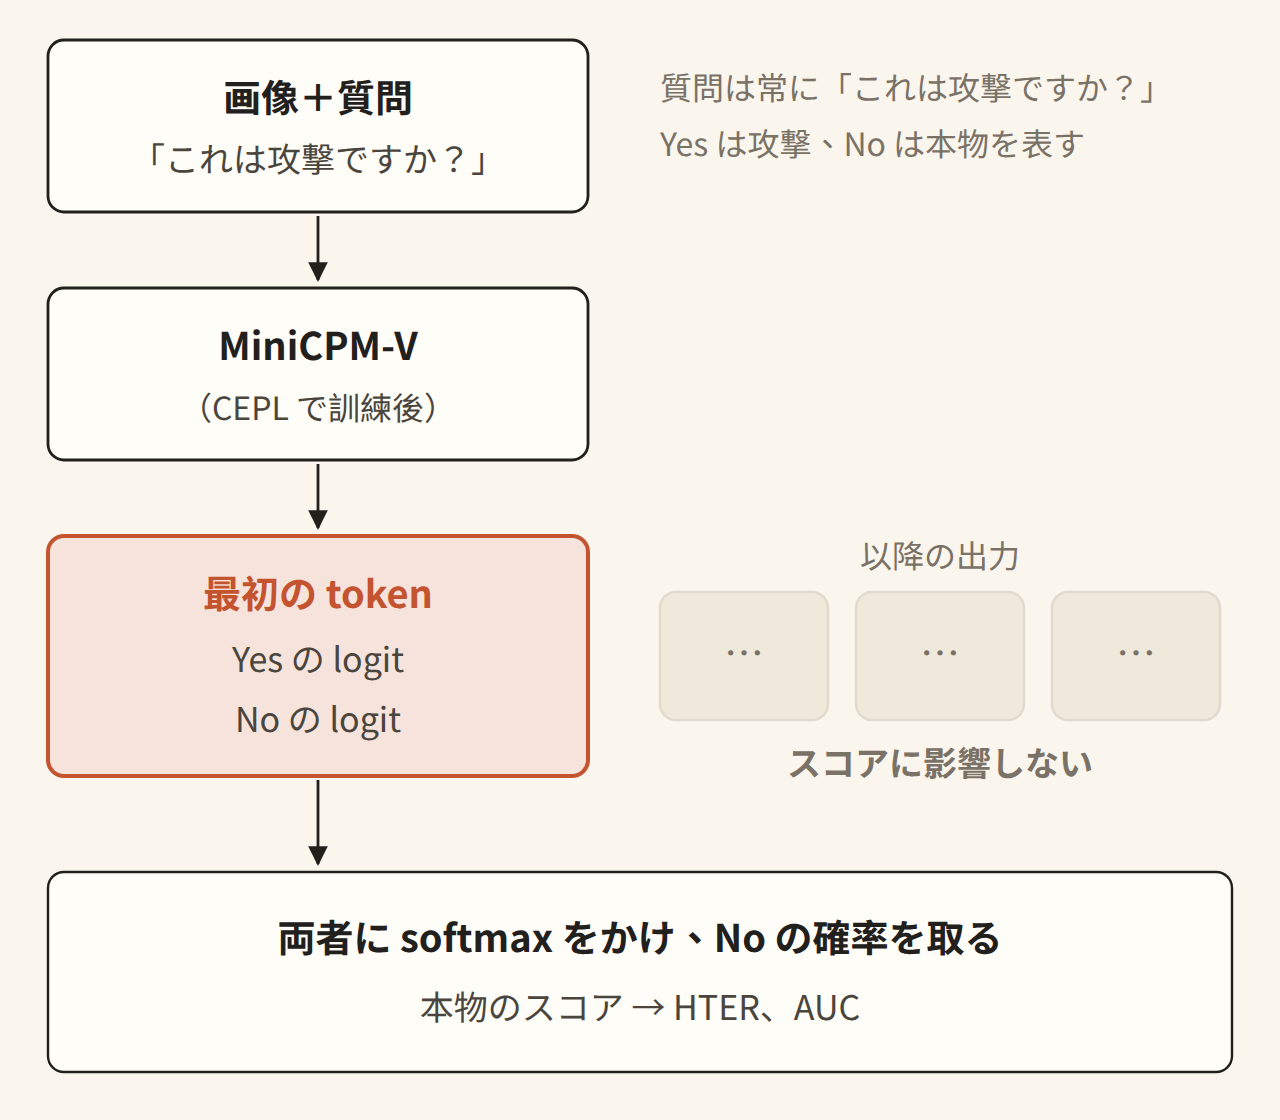
最初の token が出た時点では、推論の文章はまだ一文字も出ていない。つまり表の成績が測っているのは、モデルが直接答える力だ。六段の推論が影響するのはモデルの学び方で、スコアそのものは推論の文章が現れる前に決まっている。
討論
One-to-Eleven
プロトコルは I-FAS の Protocol 2 を踏襲し、訓練後そのまま 11 のデータセットでテストする:MSU-MFSD、CASIA-MFSD、Replay-Attack、OULU-NPU、SiW、Rose-Youtu、HKBU-MARs-V1+、WMCA、SiW-M-V2、CASIA-SURF-3DMask、HiFiMask。
比べるときは、訓練データを区別しておく必要がある。表のベースライン手法はどれも CelebA-Spoof だけで訓練しており、著者らのモデルには三つのバージョンがある。HTER と AUC はどちらも 11 データセットの平均(%)だ:
| 手法 | 訓練画像 | HTER | AUC |
|---|---|---|---|
| ViTAF | CelebA-Spoof | 23.85 | 82.82 |
| ViT-L | CelebA-Spoof | 21.08 | 85.61 |
| FLIP | CelebA-Spoof | 18.73 | 87.90 |
| I-FAS | CelebA-Spoof | 11.30 | 93.71 |
| Ours-CelebA | CelebA-Spoof | 8.56 | 96.37 |
| Ours-100K | Gold100K | 7.65 | 96.59 |
| Ours-All | 全 108 万件 | 6.30 | 97.77 |
論文の言う「HTER が 5 ポイント下がった」は、Ours-All と I-FAS の比較だ。Ours-All には WFAS の画像が加わっていて、条件が違う。条件が最も近いのは Ours-CelebA で、CelebA-Spoof の画像だけを使い、HTER は 11.30% から 8.56% に下がった。そこで使う六段の推論は caption モデルが書いたもので、その caption モデルは WFAS の画像を含む Gold100K で学習している。
データセットごとに見ると、訓練データの影響がよりはっきりする(HTER、%):
| テストデータセット | I-FAS | CelebA | All |
|---|---|---|---|
| CASIA-SURF-3DMask | 6.18 | 6.21 | 0.40 |
| HiFiMask | 28.23 | 28.68 | 15.93 |
| HKBU-MARs-V1+ | 18.64 | 6.96 | 7.34 |
| OULU-NPU | 14.86 | 9.47 | 5.86 |
| WMCA | 20.07 | 11.51 | 10.16 |
| SiW | 4.02 | 0.79 | 0.48 |
| MSU-MFSD | 5.63 | 8.33 | 5.00 |
| Replay-Attack | 9.15 | 9.87 | 12.75 |
- CASIA-SURF-3DMask と HiFiMask は、CelebA-Spoof だけでは I-FAS とほとんど変わらず、WFAS を加えて初めて大きく改善する。この二つのデータセットでの進歩は、主に WFAS に含まれるマスクのデータによるものだ。
- 同じくマスクのデータセットである HKBU-MARs-V1+ は、CelebA-Spoof だけで 18.64% から 6.96% に下がる。OULU-NPU、WMCA、SiW も、CelebA-Spoof だけの段階ではっきり改善している。
- 逆向きの例もある。MSU-MFSD は CelebA-Spoof だけだと I-FAS より悪い。Replay-Attack はデータを増やすと、かえって 9.87% から 12.75% に上がり、I-FAS の 9.15% よりも高くなる。
CoT、CEPL と解像度
アブレーション実験はどれも Gold100K で訓練している。いくつかの表に散らばった HTER を、一枚にまとめて描いた:
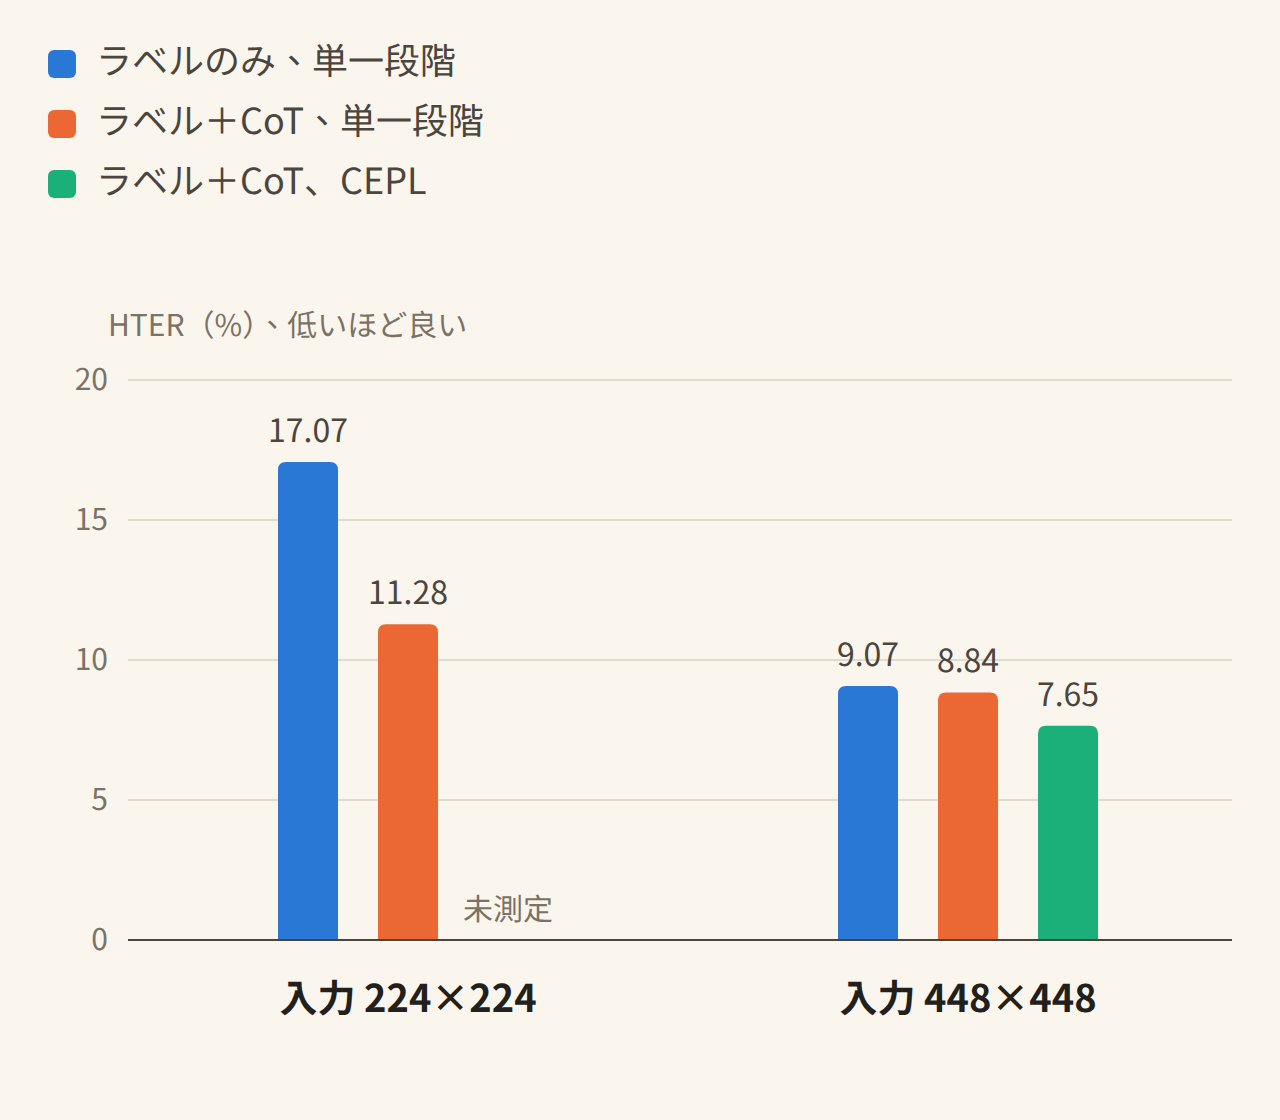
この図を順に見ていく:
- 最も効くのは解像度だ。ラベルだけで 224 から 448 に替えると、HTER は 17.07% から 9.07% に下がる。
- CoT が最も役立つのは低解像度のとき。224 で六段の推論を加えると、HTER は 6 ポイント近く下がる。448 では、同じ単一段階の訓練で 0.23 しか下がらない。著者らの解釈では、推論の文章が、低解像度ではよく見えない細部をモデルが取り戻す助けになる。裏を返せば、画像が十分に鮮明なとき、その文章が補えるものは多くない。
- 448 で差が出るのは CEPL だ。8.84% から 7.65% に下がる。
- CEPL の後にさらに強化学習を加えても、良くはならない。HTER は 7.80% だ。著者らは、教師データがすでに十分多く、強化学習による上積みはわずかだと考えている。
付録でも触れているとおり、I-FAS を含め、なりすまし検知の手法の多くは 224×224 の入力を使う。主表でこの論文は 448×448 で比べており、上のアブレーションを見る限り、この一点だけでも小さくない優位を得ている可能性がある。
データの質についても、一組の比較がある。SFT だけの caption モデルでアノテーションしたデータで訓練すると、HTER は 8.00%。強化学習を加えた版に替えると、6.87% に下がる。
バックボーン、ゼロショット、従来の試験
- バックボーンの交換:MiniCPM-V-2.6-8B のゼロショットの平均 HTER は 17.91%、訓練後は 6.30%。Qwen2.5-VL-7B はゼロショット 19.60%、訓練後 9.32%。どちらのバックボーンも恩恵を受けており、結果は MiniCPM-V のほうが良い。
- 最も難しい攻撃:Rose-Youtu で、訓練後も最も見抜けていないのは、静止した紙(68.00%)と、Mac の画面で再生した動画(71.36%)だ。
- OCIM:付録では、O、C、I、M の四つのデータセットを順にテストセットにする従来の試験方式も試しており、平均 HTER は 1.06%、I-FAS は 1.33%。四組のうち二組は、HTER で I-FAS に負けている(ICM→O は 2.81% 対 1.74%、OCI→M は 0.42% 対 0.32%)。著者ら自身も、この試験方式では AUC がすでにどれも 99% を超えていて、優劣がつけにくいと述べている。
まだ答えの出ていない問い
- HTER の閾値:論文は閾値の決め方も、最大 10 epoch のうちどのチェックポイントを使ったかも書いていない。AUC は閾値を必要としないので、影響は比較的小さい。
- 推論は忠実か:六段の推論は、もともと GPT-4o が答えを見ながら書いたもので、モデルが学ぶのはその書き方だ。しかもスコアは、推論より前の最初の token から取る。モデルが書いた理由が、実際に頼っている手がかりなのかどうか、論文は検証していない。著者らも限界の節で、FaceCoT は解釈可能性の評価に使えるが、今回はまだ行っていないと述べている。
- 推論時のコスト:8B のモデルに 448×448 の画像を入れるが、論文は推論時間を報告していない。
- 公開の範囲:データセットは契約に署名して著者に申請する必要があり、学術用途に限られる。しかも公開されるのはテキストのアノテーションだけで、画像は CelebA-Spoof と WFAS から自分で入手しなければならない。GitHub にはモデルの重みとコードを「論文の正式採択後に公開」と書かれており、今も未公開の表示のままだ。
結論
FaceCoT は、108 万件、各件に六段の推論が付いたなりすまし検知の問答データを作った。最初の 10 万件は GPT-4o が答えを見ながら書いて人手で仕上げ、残りは強化学習で調整したアノテーション用のモデルで増やした。これで MiniCPM-V を訓練すると、One-to-Eleven の平均 HTER は 6.30% まで下がり、CelebA-Spoof の画像だけでも 8.56% になる。
とはいえ、いちばん実用的なのはアブレーションの表だ。ラベルだけで入力を 224 から 448 に替えると、HTER は 17.07% から 9.07% に下がる。448 では、単一段階の訓練で六段の推論が上乗せしたのは 0.23 ポイントだけだった。手元のマルチモーダルななりすまし検知モデルがまだ 224 の顔を入力にしているなら、まず解像度を上げよう。1,000 ドルかけて GPT-4o に解説を書かせるかどうかは、それから決めればいい。
同じ CVPR の TAR-FAS は、別の道を選んだ。推論を長く書かせる代わりに、推論の途中で LBP や FFT といった古いツールを呼び出して見させる。二つの論文は同じ One-to-Eleven を使っており、CelebA-Spoof だけで訓練した場合、TAR-FAS の 7.54% はこの論文の 8.56% より少し低い。ただし、バックボーンも入力解像度も違う。
冒頭で本物扱いされた紙と画面については、汎用モデルばかりを責めるわけにもいかない。最初は GPT-4o でさえ、教えてもらうまで、新聞を撮るのも反則だとは知らなかったのだから。