原始論文
From Intuition to Investigation: A Tool-Augmented Reasoning MLLM Framework for Generalizable Face Anti-Spoofing
- 發表版本
- CVPR 2026會議
- arXiv 首次提交
- arXiv:2603.01038
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{faceantispoofingtarfas2026,
  title = {{From Intuition to Investigation: A Tool-Augmented Reasoning MLLM Framework for Generalizable Face Anti-Spoofing}},
  author = {Haoyuan Zhang and Keyao Wang and Guosheng Zhang and Haixiao Yue and Zhiwen Tan and Siran Peng and Tianshuo Zhang and Xiao Tan and Kunbin Chen and Wei He and Jingdong Wang and Ajian Liu and Xiangyu Zhu and Zhen Lei},
  year = {2026},
  eprint = {2603.01038},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2603.01038}
}
2012 年 Idiap 發表 Replay-Attack 資料集時,拿來當基準的方法是 LBP。每個像素拿周圍八個鄰居和自己比亮度,鄰居不比中心暗就記 1、比較暗就記 0,湊成一個 8 位元的碼,再把整張臉的碼統計成直方圖。紙張的纖維、螢幕的像素格,紋理都和皮膚不一樣,直方圖就會跟著不一樣。
十幾年後,人臉防偽換上了多模態大型語言模型。I-FAS 讓模型回答「這是真人嗎?」,先答 Yes 或 No,再補一句說明。只是這句說明常常長這樣:
This is a picture of a man wearing glasses.
說的都對,但和真假沒什麼關係。
中科院自動化所雷震的團隊,加上百度做 I-FAS 的原班人馬,這次把 LBP 找了回來。它沒有被放回網路裡當特徵,而是做成一個工具,讓大型語言模型自己決定什麼時候叫它出來看。
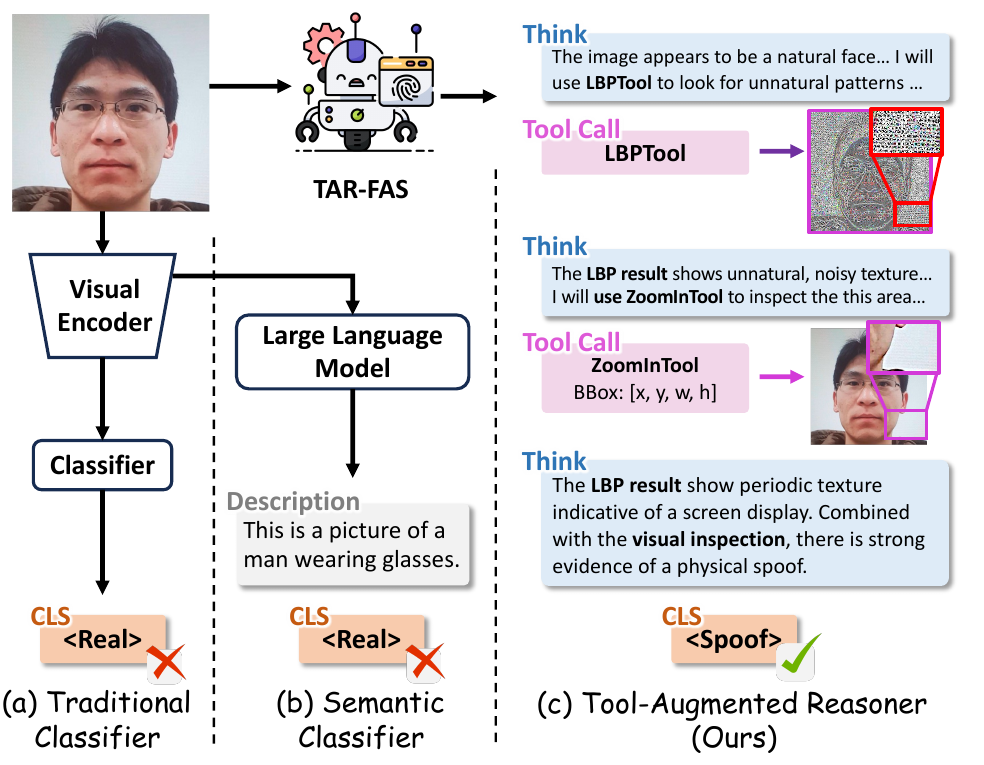
圖中間那一欄就是 I-FAS 的輸出格式。右邊是這篇的做法,模型先看一眼,覺得像真人,接著叫 LBP 工具出來,在輸出圖上看到一塊不自然的紋理,再把那一塊放大,最後改判成攻擊。
定義問題
I-FAS 把防偽改寫成看圖問答,跨資料集的成績比 CLIP 系列的方法好上一大截。作者認為它的天花板在那句描述上。他們引用先前的研究指出,多模態大型語言模型對低階的視覺特徵本來就有些盲點,訓練目標又只要求它寫一句短短的說明,模型學到的多半是「戴了面具」「拿著螢幕」這種看得見的語意線索。翻拍螢幕留下的摩爾紋、印表機的網點、面具材質的細微反光,很難寫進一句話裡,也就沒被學到。
FaceCoT 的附錄有一張表,把這件事看得更清楚。通用模型零樣本判斷 Rose-Youtu 的攻擊影像,戴面具的大多認得出來,紙本和螢幕重播卻一張都沒抓到。
那麼,要怎麼讓大型語言模型去看那些像素層級的痕跡?
傳統防偽一直在處理這件事,LBP、HOG、FFT 都是當年常用的手段。另一邊,近來的多模態模型已經能在推理途中呼叫外部工具,例如 DeepEyes 讓模型自己決定要放大圖上的哪一塊。作者把兩邊接起來,讓模型在推理時呼叫這些老牌的影像運算子。
解決問題
工具箱
作者準備了六個工具,分成四類:
- ZoomIn:給一個框,把那一塊裁出來放大。
- 紋理:LBP,看皮膚的紋理是否自然,紙張和面具材質常在這裡露出破綻。
- 頻率:FFT 和小波轉換,看頻率分布有沒有異常,螢幕和印刷品常帶有週期性的訊號。
- 結構:HOG 和 Laplacian 邊緣偵測,看邊界和梯度,面具的邊緣、螢幕的框線會在這裡浮出來。
每個工具的輸出都是一張圖,會再餵回模型。所以模型「看工具結果」,其實是在看一張 LBP 編碼圖、一張頻譜圖或一張邊緣圖。
FFT 圖為什麼看得出螢幕?下面這張示意圖把兩張 64×64 的影像換到頻譜上。上排是一張平滑的亮度起伏,代替直接拍的臉;下排在同一張臉上疊了一組每 8 個像素重複一次的直條紋,模擬隔著螢幕拍照時出現的週期紋路。
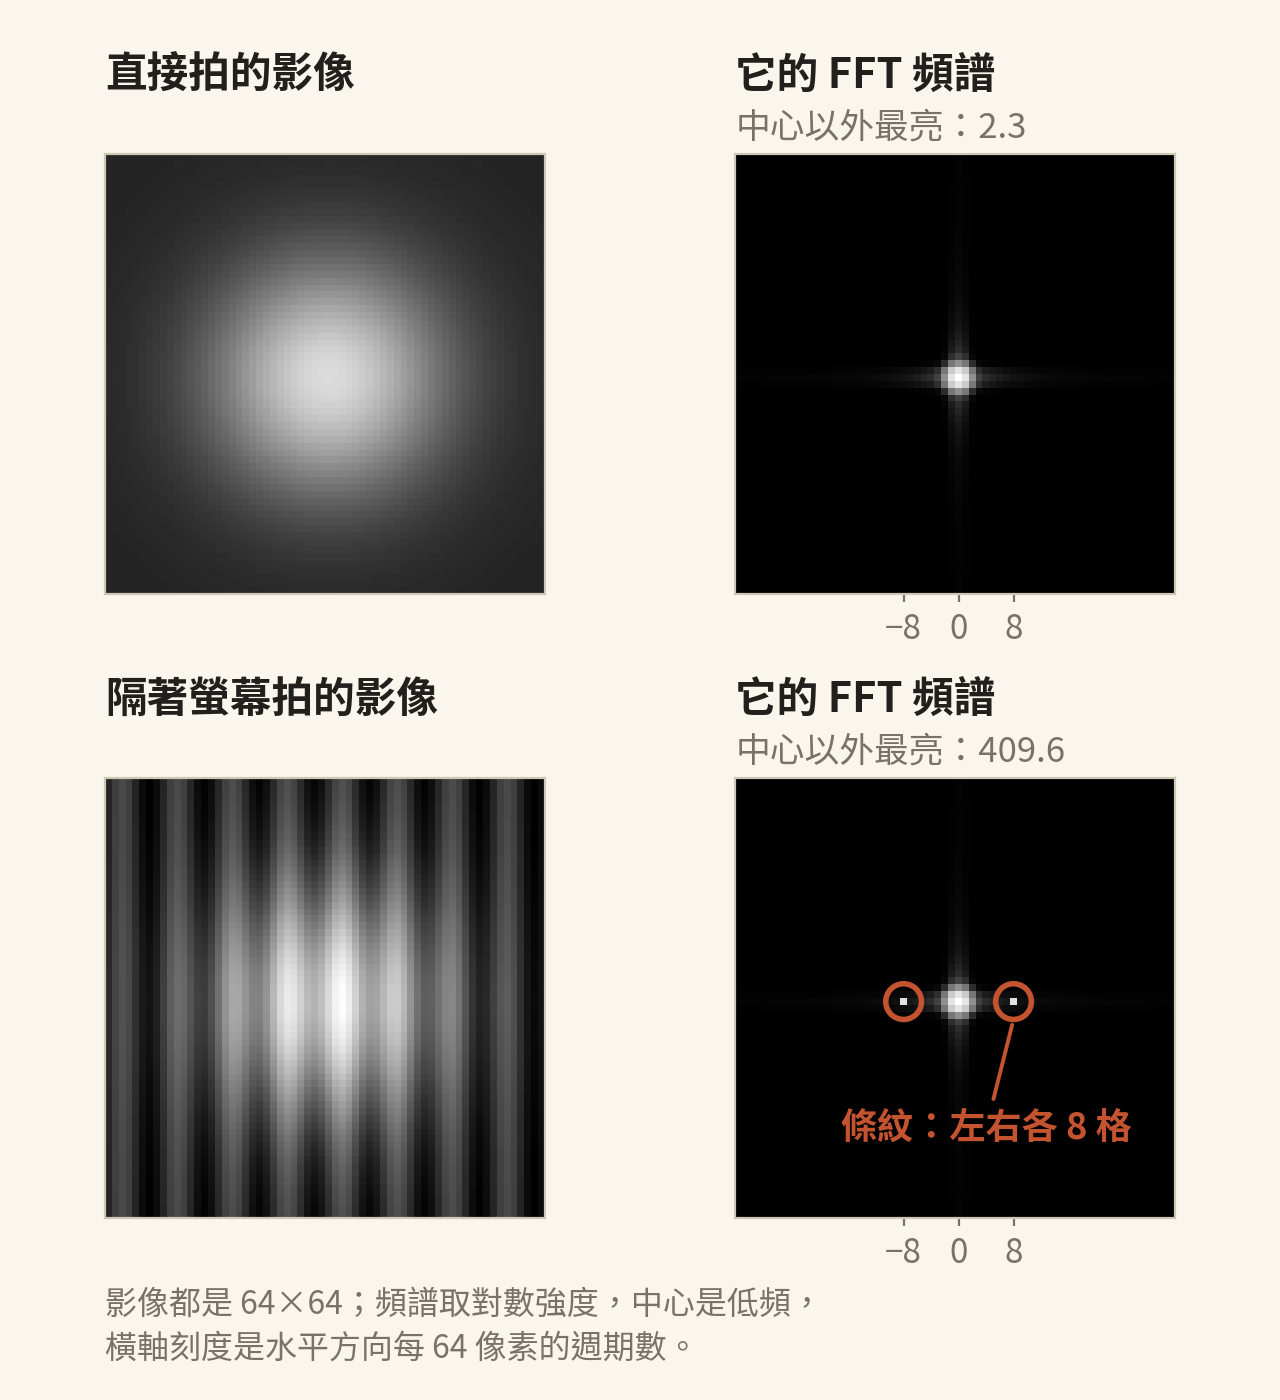
右上的頻譜只有中心一團,那是平滑亮度起伏的低頻能量,離中心越遠越暗。右下多了兩個小亮點,剛好落在橫軸 −8 和 +8。64 個像素寬、每 8 個像素一個週期,剛好是 8 個週期,所以亮點離中心 8 格,左右對稱各一個,強度是直接拍時中心以外最亮處的一百多倍。
條紋在左下的影像裡和臉的亮度混在一起,不太好分;換到頻譜上,它被集中成兩個點,一眼就看得出來。真實的摩爾紋方向和週期都比較亂,頻譜上的亮點也會散開,但道理一樣。TAR-FAS 的 FFT 工具回傳的就是這種頻譜圖,模型要學的是在圖上找離開中心的亮點。
論文沒有交代各個工具的實作參數,這張圖只用來說明 FFT 工具回傳的東西長什麼樣子。
ToolFAS-16K:先請知道答案的老師示範
模型一開始不會用工具,得先有示範。作者從 CelebA-Spoof 挑了 16,172 張影像,將近一半是真人,其餘涵蓋 10 種攻擊,再請 Gemini-2.5 Pro 一輪一輪地寫出使用工具的推理過程。
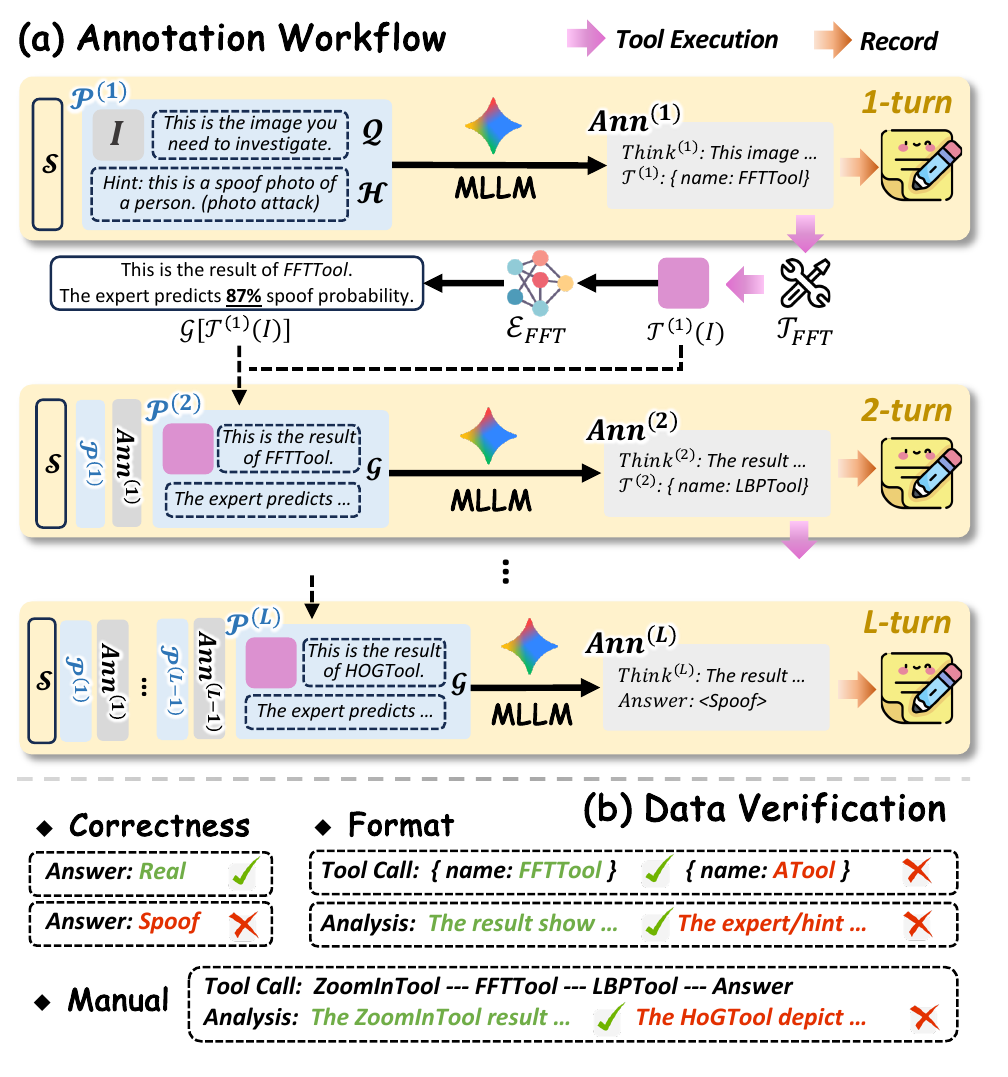
從圖的第一輪看起。Gemini 收到的除了影像和一句「這是你要調查的影像」,還有一個提示 ,直接寫出這張圖是真人還是哪一種攻擊。系統提示也講明了,最終的分類必須和提示一致,而且推理時不能提到提示。
Gemini 要求呼叫某個工具後,工具結果除了送回給它看,還會先交給一個「專家模型」。每個工具(ZoomIn 除外)各有一個專家,是只有三層卷積的小 CNN,輸入只有工具的輸出圖,看不到原始影像,輸出這張圖有攻擊痕跡的機率。作者用 CelebA-Spoof 的 4,000 個身分訓練、1,000 個身分測試,這些小模型在門檻 0.5 下大約有八到九成的準確率。下一輪的提示裡就會多一句「這是 FFTTool 的結果,專家預測有 87% 的機率帶有攻擊痕跡」。
一份標註最多 6 輪,Gemini 給出答案就結束。之後有三道檢查。答案要和標籤一致;工具呼叫要符合格式,分析裡不能出現提示或專家機率;最後由人工確認工具分析和結論在邏輯上接得起來。沒過的重標一次,再不過就丟掉。
所以這份資料是一位事先知道答案、旁邊還有助手報機率的老師,寫給學生看的解題示範。提示和專家機率在檢查時都被擋掉了,學生看不到。學生從這裡學到的是「怎麼叫工具、怎麼寫推理」;它自己看工具結果做判斷的能力,要靠下一階段的強化學習來練。
三段訓練
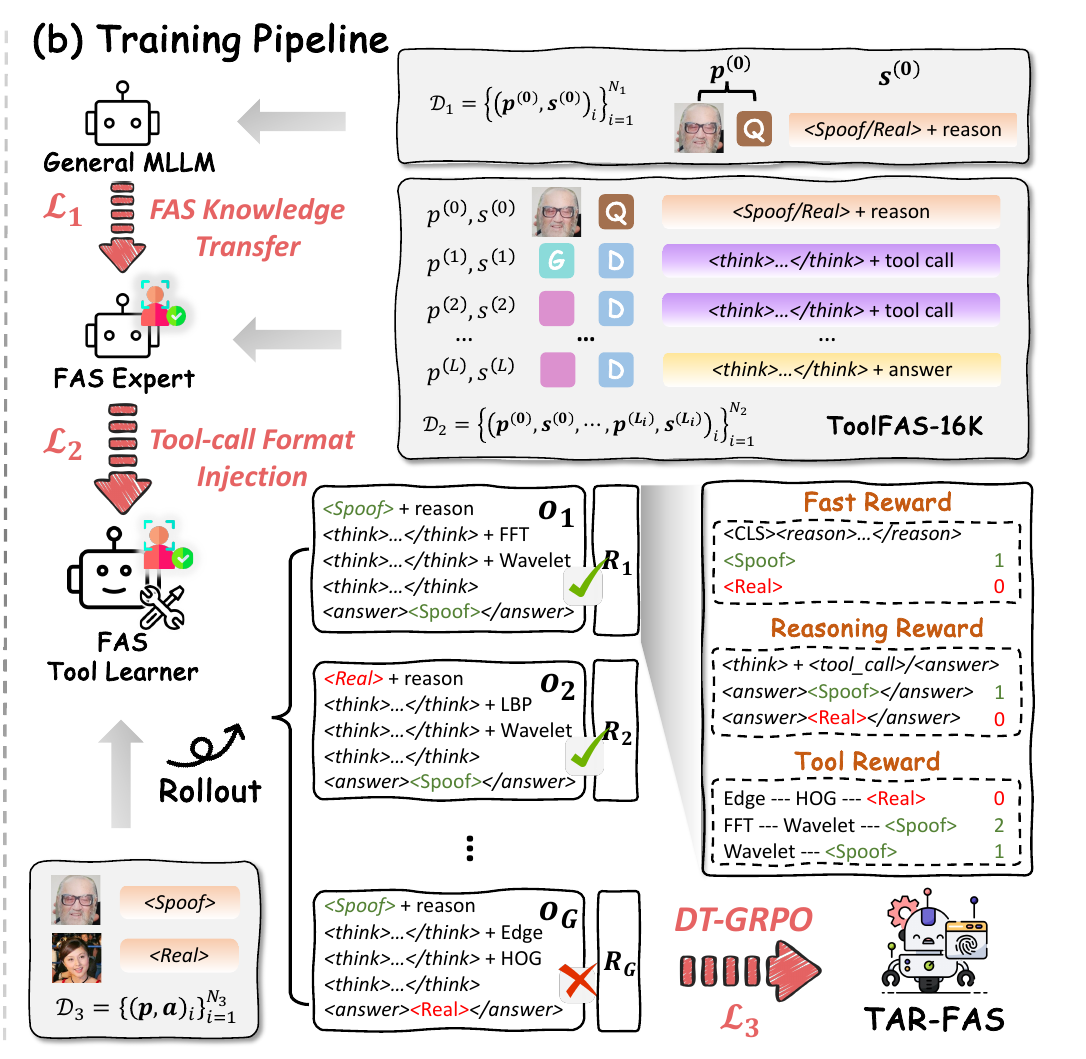
骨幹是 InternVL3-8B。圖上由上往下有三個階段:
-
FAS 知識轉移(KT):用 I-FAS 格式的資料做監督式微調。問題固定是「Is this photo of a real person?」,答案是
<Real>或<Spoof>加一句理由。這一步讓通用模型先懂防偽在問什麼。 -
工具呼叫格式注入(FI):在 ToolFAS-16K 上微調。每筆資料的第一輪和上一階段一模一樣,是快速回答;之後才是一輪輪的思考與工具呼叫。損失函數是
第一輪佔九成的權重。多輪資料很長,如果每個 token 一樣重,快速回答的那一小段很容易被稀釋,模型學會用工具,卻忘了怎麼直接分類。
-
DT-GRPO:只用 CelebA-Spoof 的影像和真假標籤做強化學習,不再需要推理示範。
前兩階段用 LoRA(rank 16),最多 4,000 步;第三階段放開全部參數,學習率 1e-6,每個問題抽 8 個回答,最多 300 步,KL 懲罰設為 0。
DT-GRPO 的獎勵
GRPO 的做法是對同一個問題抽一組回答,每個回答算一個分數 ,再減掉組內平均、除以組內標準差,得到優勢值 。比平均好的回答被加強,比平均差的被壓低。
這篇的分數由三項加權:
- :第一輪快答。格式錯扣 1 分,否則答對 1 分、答錯 0 分。
- :最後的答案。推理格式錯或工具呼叫無效扣 1 分,否則答對 1 分、答錯 0 分。
- :每用到一種不同的工具加 0.2,同一種工具叫兩次只算一次;最後答錯,這項整個歸零。
我們拿一張攻擊影像、五個回答算一次:
import numpy as np

beta_fast, beta_rsn, beta_tool, gamma = 0.1, 0.5, 0.4, 0.2

def reward(fast_ok, tools, final_ok, fmt_ok=True):
    r_fast = 1.0 if fast_ok else 0.0
    if not fmt_ok:                       # 推理格式錯或工具呼叫無效
        return beta_fast * r_fast + beta_rsn * -1.0
    r_rsn = 1.0 if final_ok else 0.0
    r_tool = gamma * len(set(tools)) if final_ok else 0.0   # 同一種工具只算一次,答錯歸零
    return beta_fast * r_fast + beta_rsn * r_rsn + beta_tool * r_tool

# 同一張攻擊影像(標籤 Spoof)抽出的五個回答
rollouts = [
    ("快答 Real,查 FFT、Wavelet 後改判 Spoof", reward(False, ["FFT", "Wavelet"], True)),
    ("快答 Spoof,不查工具直接定案", reward(True, [], True)),
    ("快答 Real,查 Edge、HOG 後仍判 Real", reward(False, ["Edge", "HOG"], False)),
    ("快答 Spoof,FFT 查兩次再加 LBP", reward(True, ["FFT", "FFT", "LBP"], True)),
    ("快答 Spoof,工具呼叫格式寫錯", reward(True, [], False, fmt_ok=False)),
]
r = np.array([ri for _, ri in rollouts])
adv = (r - r.mean()) / r.std()           # GRPO:組內標準化
for (name, ri), ai in zip(rollouts, adv):
    print(f"R={ri:+.2f}  A={ai:+.2f}  {name}")
R=+0.66  A=+0.75  快答 Real,查 FFT、Wavelet 後改判 Spoof
R=+0.60  A=+0.61  快答 Spoof,不查工具直接定案
R=+0.00  A=-0.72  快答 Real,查 Edge、HOG 後仍判 Real
R=+0.76  A=+0.97  快答 Spoof,FFT 查兩次再加 LBP
R=-0.40  A=-1.61  快答 Spoof,工具呼叫格式寫錯
把五個回答放在一起比:
- 答對才是大頭。最後答對值 0.5,工具獎勵最多只到 (最多三次工具呼叫,三種都不同)。不查工具直接答對的回答,優勢值還是正的。
- 工具是加分題。同樣答對,多看一種工具的回答就多 0.08。第一個回答快答錯了,靠工具翻盤,分數仍然比直接答對的高。
- FFT 叫兩次不會多拿分,所以模型被推向「換一種工具看看」,名稱裡的 Diverse-Tool 就是這個意思。
- 格式錯的回答分數是負的,優勢值也最低。
- 獎勵裡沒有任何一項鼓勵少叫工具。只要答對,三次呼叫用滿、三種都不同,分數最高。推論成本唯一的上限,是最多三次工具呼叫的規定。
推論時
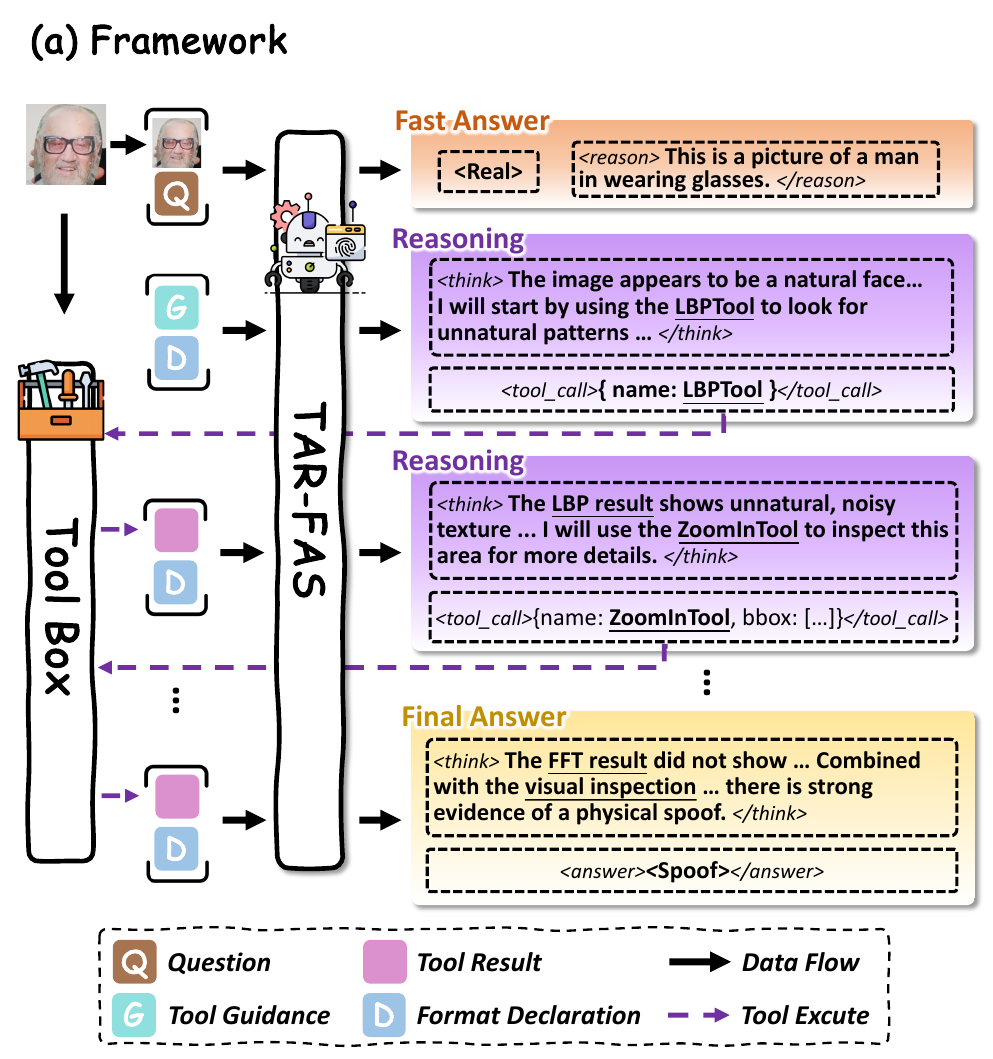
推論分兩段。第一輪問「Is this photo of a real person?(不要用工具)」,模型照 I-FAS 的格式快速回答。第二輪送進一句提示:
Wait, you should re-examine the image and give the final answer (use tools if needed).
模型開始寫 <think>,需要時輸出 <tool_call>,外部程式執行工具,把結果圖送回去,如此反覆,最多三次工具呼叫,最後寫出 <answer>。計算 HTER 和 AUC 時,分數取自最後答案裡那個分類 token 的 logits。
推論流程裡沒有專家模型,也沒有攻擊類型的提示,模型只能自己讀工具的輸出圖。
討論
One-to-Eleven
主實驗沿用 I-FAS 的 Protocol 2,只用 CelebA-Spoof 訓練,直接拿去測 11 個資料集,每組跑三個隨機種子取平均。輸入是對齊裁切後的 224×224 人臉,InternVL 會再放大到 448×448 處理。
平均起來,TAR-FAS 的 HTER 是 7.54%,AUC 是 96.67%;I-FAS 是 11.30% 與 93.71%,FLIP 是 18.73% 與 87.90%。
逐個資料集的 HTER(%)如下:
| 測試資料集 | I-FAS | TAR-FAS |
|---|---|---|
| CASIA-MFSD | 1.11 | 0.00 |
| CASIA-SURF-3DMask | 6.18 | 2.09 |
| HKBU-MARs-V1+ | 18.64 | 3.48 |
| HiFiMask | 28.23 | 17.97 |
| MSU-MFSD | 5.63 | 5.71 |
| OULU-NPU | 14.86 | 14.45 |
| Replay-Attack | 9.15 | 5.75 |
| Rose-Youtu | 5.52 | 3.61 |
| SiW | 4.02 | 8.35 |
| SiW-M-V2 | 10.89 | 11.72 |
| WMCA | 20.07 | 9.78 |
| 平均 | 11.30 | 7.54 |
進步最多的是有面具攻擊的資料集。HKBU-MARs-V1+ 從 18.64% 降到 3.48%,WMCA 從 20.07% 降到 9.78%,HiFiMask 和 CASIA-SURF-3DMask 也都降了不少。作者特別提到,HKBU-MARs-V1+ 和 CASIA-SURF-3DMask 裡有來源資料沒有的攻擊方式與材質。
有意思的是,論文開頭拿來示範的例子是螢幕的週期紋理,頻率工具也是衝著紙本和螢幕準備的,但以紙本和螢幕攻擊為主的資料集,表現有進有退。Replay-Attack 和 Rose-Youtu 進步了,MSU-MFSD 和 OULU-NPU 幾乎沒動,SiW 從 4.02% 退到 8.35%。攻擊種類最雜的 SiW-M-V2 也小幅變差。
工具和訓練階段
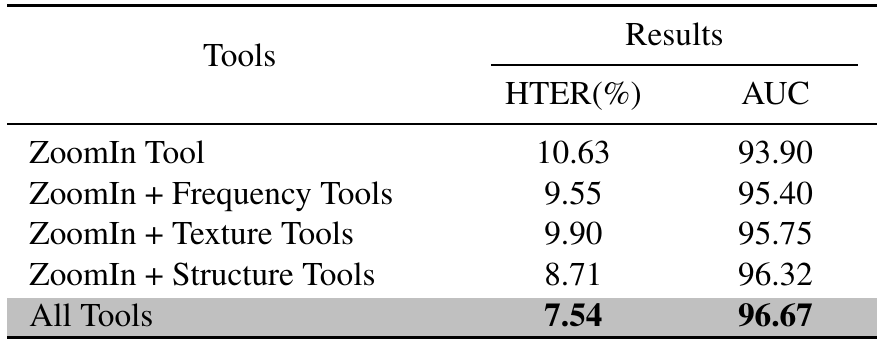
只給 ZoomIn 時 HTER 是 10.63%,已經比 I-FAS 低一點。三類工具裡,單獨加上結構工具的幫助最大,降到 8.71%;全部給齊是 7.54%。
這張表能說明工具有用,但也提醒我們,HTER 從 11.30% 降到 7.54% 這一段並非全部來自工具。只有放大鏡的版本已經吃掉其中一部分,那部分來自新的骨幹和整套訓練流程。
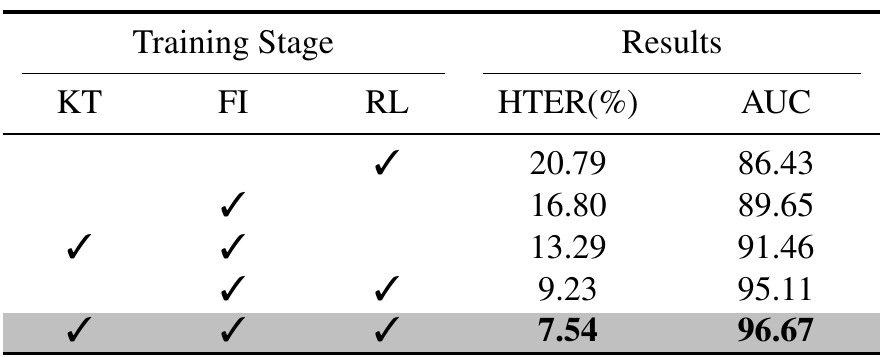
這張表比較有故事。
- 跳過示範、直接做強化學習,HTER 是 20.79%。附錄的訓練曲線裡,這種做法訓練時的推理準確率一直在七成多上下震盪,完整流程則在九成五附近。模型連工具怎麼叫都不會,獎勵很難把它帶到正確的方向。
- 只模仿 Gemini 的示範(FI),HTER 是 16.80%,比 I-FAS 還差。照著老師的解題過程抄,抄不出泛化能力。
- 示範之後接強化學習,從 16.80% 降到 9.23%,這是整張表最大的一步。
- 前面再加上知識轉移,最後到 7.54%。
還有幾組對照
- 快答和推理答:同一個模型,第一輪快答的 HTER 是 10.54%,查完工具後的最後答案是 7.54%。快答已經比 I-FAS 好一些,用工具查過一輪,再降 3 個百分點。
- 只准放大:DeepEyes 的 ST-GRPO 只允許 ZoomIn,獎勵只看格式、答對與否和有沒有用工具。換成它,HTER 是 9.98%,比 DT-GRPO 的 7.54% 高。
- 工具次數上限:附錄的曲線裡,上限從 1 次放寬到 3 次,HTER 從大約 9.2% 一路降到 7.54%;放寬到 4 次反而回升到 8% 出頭。作者認為是回答變長、抽樣的變異變大。
- 骨幹與解析度:換成 Qwen2.5-VL-7B,直接吃 224×224 的 HTER 是 9.45%,放大到 448×448 是 8.60%,InternVL3-8B 是 7.54%。解析度和骨幹各貢獻一點,不過三個數字都比 I-FAS 低。
舊考法
附錄另外跑了 OCIM(O、C、I、M 四個資料集輪流當測試集)。平均 HTER 是 1.30%,I-FAS 是 1.33%,幾乎打平。四組裡各有輸贏,OCM→I 從 3.22% 降到 0.43%,OCI→M 卻從 0.32% 升到 2.86%。
這組考法的數字已經擠在 1% 附近,很難再分出高下。訓練步數只設了上限(SFT 最多 4,000 步、RL 最多 300 步),論文沒有提到在目標資料集上挑 checkpoint;HTER 用的門檻怎麼決定,則沒有交代。
推理寫得像樣,但未必是這樣推的
最後看論文挑的四個例子。
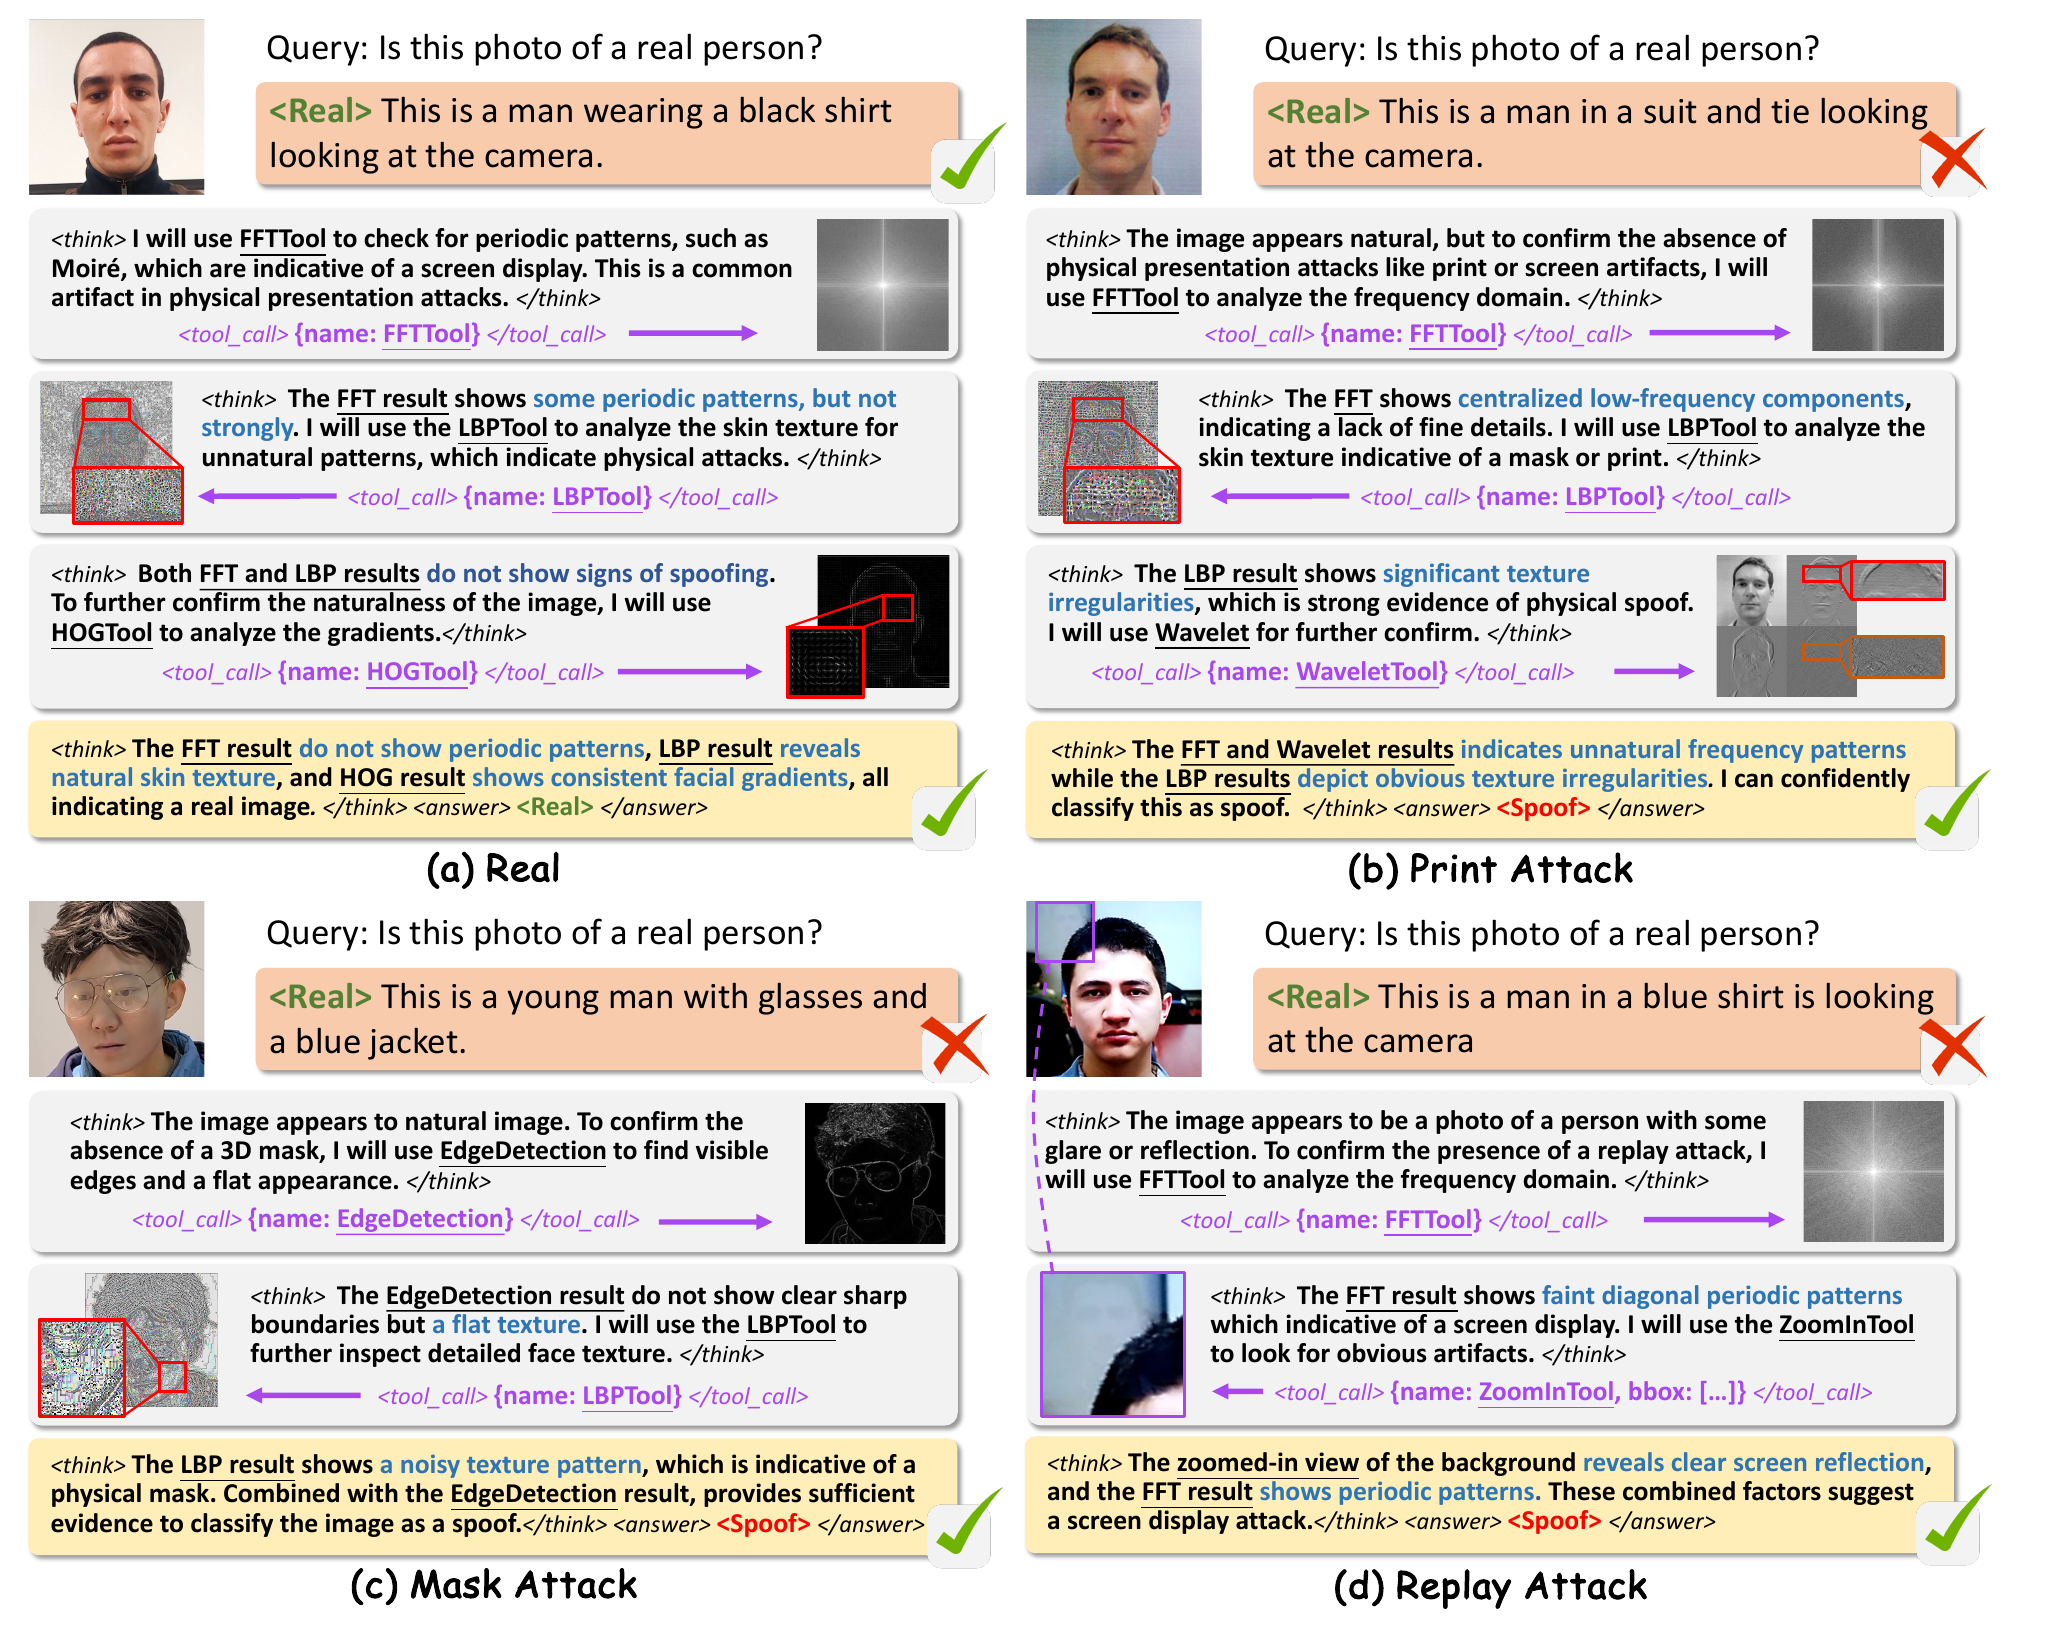
四個例子的快答全都是 Real,其中三個是攻擊,靠工具翻盤。作者觀察到,模型遇到紙本和螢幕偏好頻率工具,遇到面具偏好結構工具,紋理工具則各種攻擊都會用到。
再仔細讀 (a) 那個真人例子。查完 FFT 後,模型寫的是「FFT 結果顯示一些週期紋路,但不明顯」;到了最後一段總結,變成「FFT 結果沒有顯示週期紋路」。前面的保留到了結論就不見了,整段推理被整理成一個乾淨的故事。
這不影響這一題的答案,但提醒我們,寫出來的推理和模型實際依賴的線索,未必是同一回事。論文沒有檢驗工具結果是否真的左右了判斷,例如把工具輸出換成無關的圖,看答案會不會變。
另外有兩件事論文沒有給,部署時一定會問到。一是推論時間。8B 的模型先快答一次,再最多來回三輪,每輪都要重新讀一張工具圖。一般的手機活體模型只要跑一次 CNN,差距可想而知,但論文沒有量。二是程式碼,目前還沒有公開。
結論
TAR-FAS 讓多模態大型語言模型在推理途中呼叫 LBP、FFT、HOG 這些老牌運算子,在只用 CelebA-Spoof 訓練、測 11 個資料集的設定下,把平均 HTER 從 I-FAS 的 11.30% 降到 7.54%,面具類資料集進步最多。
這篇最值得帶走的是消融表裡的那一步。只模仿 Gemini 的示範,成績比 I-FAS 還差;同一個模型接上只看真假標籤的 GRPO,HTER 從 16.80% 降到 9.23%。示範教的是怎麼用工具,用得好不好,是強化學習練出來的。
附錄裡還有一個小發現。那些只有三層卷積、只看 LBP 或 FFT 輸出圖的專家小模型,在 CelebA-Spoof 上就有八到九成的準確率。它們在論文裡只負責在標註時給 Gemini 遞紙條,推論時並沒有上場。
至於要不要把 8B 模型搬進刷臉門禁,等程式碼放出來、量過延遲再說吧。