Article original
The Road Less Scheduled
- Publication
- NeurIPS 2024Conférence
- Premier dépôt sur arXiv
- arXiv:2405.15682
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizersschedulefree2024,
  title = {{The Road Less Scheduled}},
  author = {Aaron Defazio and Xingyu Alice Yang and Harsh Mehta and Konstantin Mishchenko and Ahmed Khaled and Ashok Cutkosky},
  year = {2024},
  eprint = {2405.15682},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2405.15682}
}
Le 1er août 2024, MLCommons publie les résultats de la première compétition AlgoPerf d'algorithmes d'entraînement.
Si vous n'avez jamais entendu parler d'AlgoPerf, c'est une compétition qui porte sur les optimiseurs et sur la procédure d'entraînement elle-même. Modèles, données et matériel (8 V100) sont fixés, et il s'agit d'amener le plus vite possible 8 tâches au score de validation visé ; ces tâches vont de la traduction automatique à la classification d'images, en passant par la reconstruction IRM, la reconnaissance vocale, les graphes moléculaires et la prédiction du taux de clics. La compétition comporte deux catégories. Dans la catégorie à réglage externe, on peut fournir un espace de recherche d'hyperparamètres, dans lequel les organisateurs tirent 5 configurations à essayer ; dans la catégorie auto-réglée, aucune recherche d'hyperparamètres n'est permise en dehors de l'entraînement, et la méthode doit se débrouiller seule avec toutes les tâches en un seul entraînement. La solution la plus courante consiste à utiliser une configuration unique pour tout ; en compensation, le temps d'entraînement maximal est multiplié par 3.
Dans la catégorie auto-réglée, une seule soumission bat la référence des organisateurs ; il s'agit de Schedule Free AdamW, soumis par des chercheurs de Meta et de Samsung, avec un score de 0.8542, contre 0.8194 pour la référence, NAdamW avec échauffement linéaire et décroissance cosinus ; les quatre autres soumissions sont toutes sous 0.4. Ce qui distingue le plus cette méthode, c'est qu'elle se passe entièrement de planification du taux d'apprentissage et n'a pas besoin de connaître à l'avance le nombre d'étapes d'entraînement.
L'article correspondant s'intitule « The Road Less Scheduled » ; le titre reprend le « less traveled » du poème « The Road Not Taken » de Frost, et la conclusion cite effectivement le poème. Le premier auteur est Aaron Defazio, de Meta FAIR, dont les travaux précédents sur D-Adaptation s'attaquaient déjà à la question du réglage du taux d'apprentissage. Le code est publié sur PyPI dès avril sous forme de paquet schedulefree, alors que l'article n'arrive sur arXiv qu'à la fin mai.
Définir le problème
Une planification a besoin d'une ligne d'arrivée
Les planifications du taux d'apprentissage les plus courantes aujourd'hui sont la décroissance cosinus et la décroissance linéaire ; toutes deux exigent de connaître le nombre total d'étapes pour pouvoir tracer la courbe. Se tromper sur coûte cher. Selon les mesures de l'annexe de Chinchilla, un cycle cosinus plus long de plus de 25 % que le nombre réel d'étapes dégrade nettement le modèle ; et si l'on veut prolonger un entraînement en cours de route, il faut tout replanifier.
La moyenne, excellente en théorie, médiocre en pratique
L'autre voie consiste à renoncer à la planification et à moyenner les paramètres. La moyenne de Polyak–Ruppert est l'approche la plus classique ; SGD avance normalement avec un pas fixe, et l'on maintient à côté la moyenne de tous les points parcourus :
Avec , est exactement la moyenne à poids égaux de . Selon la théorie classique de la convergence, pour un problème convexe et lipschitzien, c'est qu'il faut rendre, et non le dernier . En pratique, cette moyenne est bien moins bonne que le dernier itéré de SGD, ce que les auteurs présentent comme un consensus officieux du domaine de l'optimisation.
Des travaux théoriques récents montrent en outre qu'une planification à décroissance linéaire suffit à elle seule pour que le dernier itéré atteigne la vitesse optimale dans le pire cas. Planification et moyenne jouent donc en théorie à peu près le même rôle, mais la planification exige de connaître . Existe-t-il, se demandent alors les auteurs, une méthode de moyenne qui égale en pratique les planifications sans renoncer aux garanties théoriques ?
Résoudre le problème
Trois suites
Les mises à jour de Schedule-Free SGD sont les équations (3) à (5) :
On part de . Les trois suites se répartissent les rôles :
- est la suite de base ; c'est là que l'optimiseur sous-jacent fait ses pas, ici un SGD ordinaire.
- est la suite d'évaluation, la moyenne à poids égaux de , et aussi le modèle rendu au final.
- est le point où l'on calcule le gradient, interpolé entre et .
Par rapport à la moyenne de Polyak–Ruppert, seule la première ligne s'ajoute ; le gradient n'est plus calculé en , mais en , entre et .
Deux extrêmes
détermine de quel côté penche . Avec , ; le gradient est calculé en , et l'on retrouve la moyenne de Polyak–Ruppert. Avec , ; le gradient est calculé au point moyen, ce qu'on appelle primal averaging, qui offre lui aussi la garantie optimale dans le pire cas, mais converge, de l'avis général, trop lentement pour être utile.
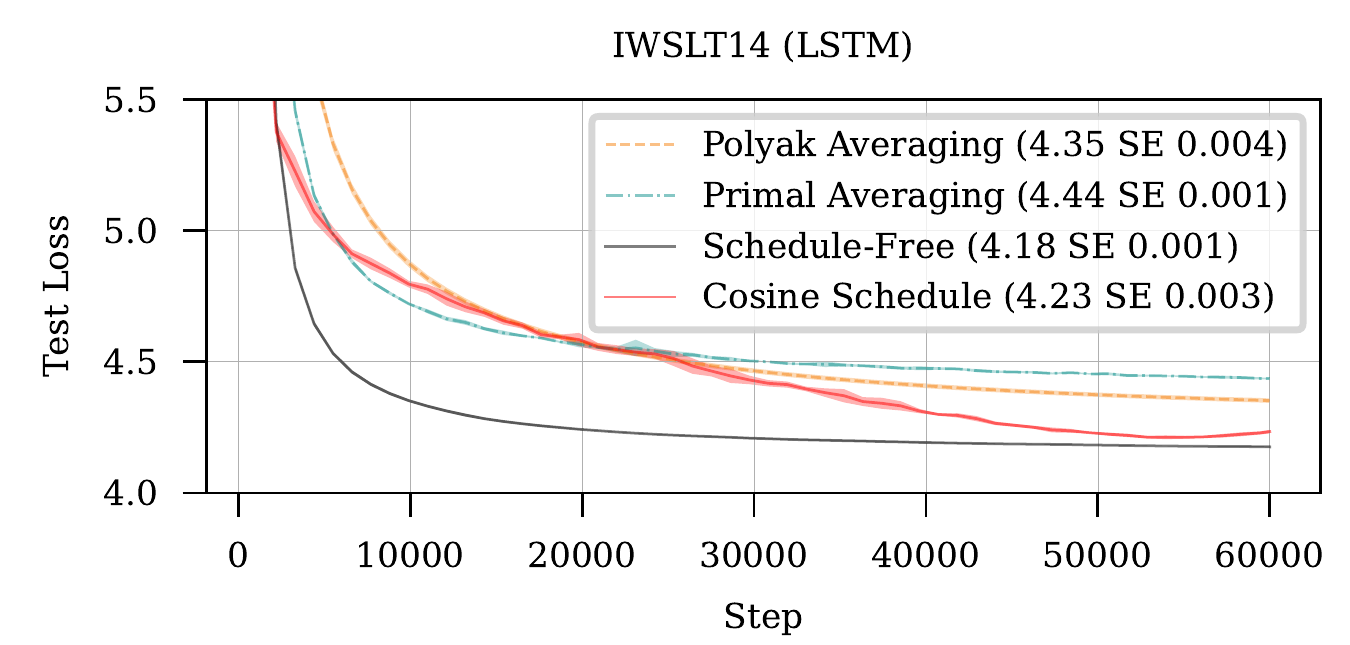
Cette figure porte sur un LSTM de traduction allemand-anglais sur IWSLT14. Les deux extrêmes perdent face à une planification cosinus bien réglée ; la moyenne de Polyak finit à 4.35, le primal averaging à 4.44, le cosinus à 4.23. Schedule-Free se place entre les deux, avec , finit à 4.18, et descend plus vite que tous les autres dès les 10 000 premières étapes.
Selon les auteurs, se déplace plus vite que , si bien que l'interpolation conserve la convergence rapide de la moyenne de Polyak ; et comme est tiré vers , le point où l'on calcule le gradient ne s'éloigne pas trop du modèle rendu, ce qui renforce la stabilité.
Une autre forme de momentum
Le rôle de ressemble beaucoup à celui d'un momentum, et l'article le compare d'ailleurs au momentum classique par moyenne mobile exponentielle (EMA). Quand le gradient de l'étape entre dans , son effet immédiat est , soit pour , exactement comme avec un momentum EMA. La différence porte sur les 90 % restants. Le momentum EMA en ajoute l'essentiel au cours des quelque 10 étapes suivantes ; Schedule-Free, lui, les incorpore très lentement, par l'intermédiaire de la moyenne .
En théorie, ce momentum n'a pas d'effet secondaire. Le Theorem 1 établit que si est convexe, que la perte de chaque échantillon est -lipschitzienne et que les échantillons sont indépendants et identiquement distribués, alors, avec ( étant la distance du point de départ à la solution optimale), on a pour tout dans :
C'est la vitesse optimale pour les problèmes convexes non lisses, constante comprise. Par comparaison, dans le même cadre, un momentum EMA dégrade au contraire la garantie dans le pire cas.
, ce n'est pas une planification décroissante ?
Arrivé ici, vous vous dites peut-être que le de la mise à jour de , c'est tout simplement un taux d'apprentissage décroissant, non ?
En un sens, oui. Avec la Figure 4, les auteurs montrent quelle part de chaque gradient finit par entrer dans et dans :
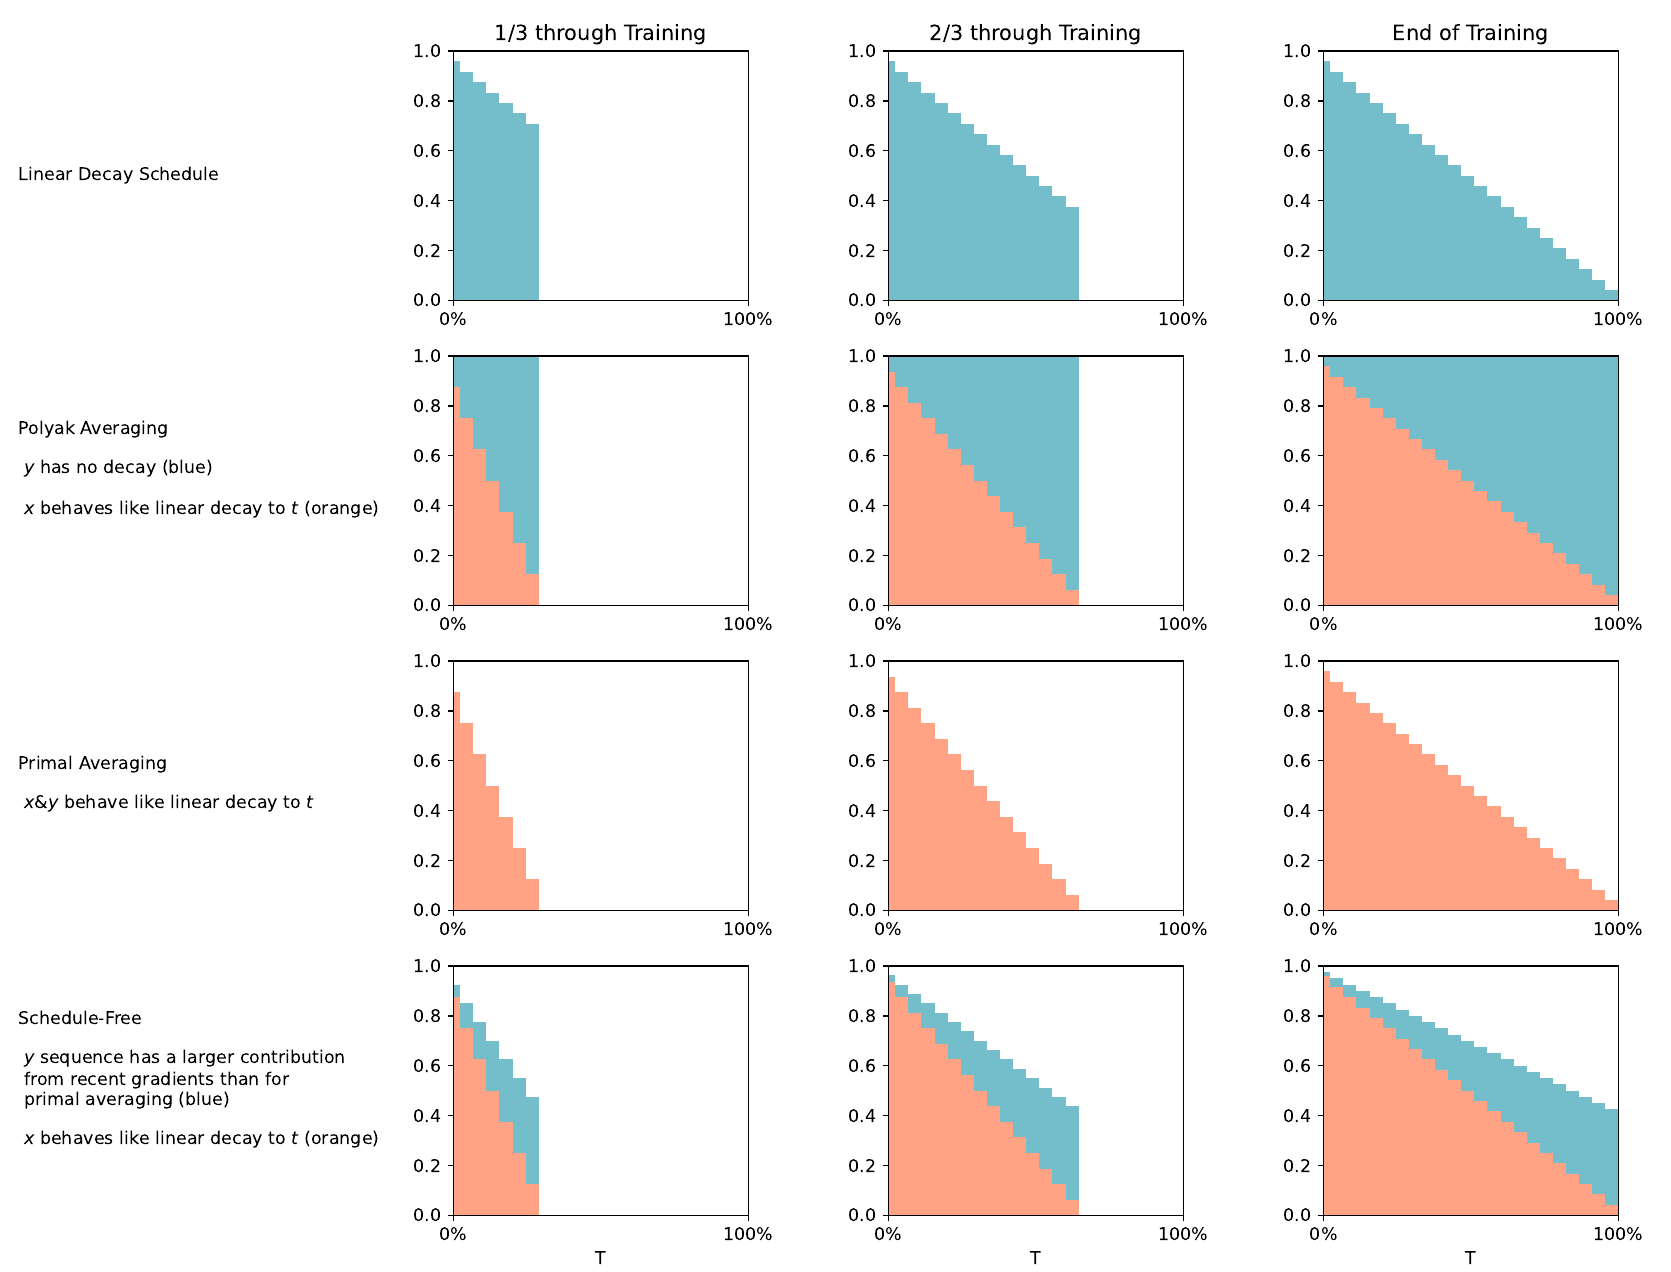
Commençons par la première ligne. Avec une planification à décroissance linéaire, à 1/3, à 2/3 comme à la fin, chaque gradient est ajouté aux paramètres selon le taux d'apprentissage du moment ; les pas étant de plus en plus petits, on obtient une rampe. Mais l'extrémité de cette rampe est fixée en .
Passons à la partie orange des trois lignes suivantes, c'est-à-dire . Pour les trois méthodes de moyenne, ressemble à chaque instant à une décroissance linéaire qui se termine à l'instant courant . C'est pour cela que la moyenne peut remplacer une planification. Elle contient en fait une planification implicite, dont l'extrémité avance avec , sans qu'il faille connaître à l'avance.
La partie bleue est , et c'est là que les trois méthodes diffèrent. Pour la moyenne de Polyak, est ; chaque gradient compte entièrement, et en fin d'entraînement, les gradients récents pèsent bien plus que sous une planification. Pour le primal averaging, est ; les gradients récents sont fortement écrasés, et la convergence est lente au début. Schedule-Free se situe entre les deux et renforce un peu le poids des gradients récents.
L'annexe B traduit cela en algèbre. Notons un pas de l'optimiseur de base et ; avec une moyenne à poids égaux et fixe, le déplacement effectif de à chaque étape est :
C'est un terme de momentum, plus fois le pas de base. Si l'on fait varier dans le temps et qu'on le prend exactement égal à , le coefficient du terme de momentum s'annule entièrement, et il ne reste qu'une planification à décroissance linéaire. Schedule-Free choisit un fixe, et n'a donc pas besoin de .
Jusqu'où va la théorie
Le Theorem 1 est en fait un cas particulier du Theorem 2, plus général. Celui-ci admet n'importe quel algorithme d'apprentissage en ligne pour produire , des poids de moyenne et des coefficients d'interpolation quelconques, et convertit leur regret en garantie de convergence pour l'optimisation stochastique ; c'est une forme d'online-to-batch conversion. Avec , on retrouve la moyenne de Polyak classique ; avec , le primal averaging (dont des travaux antérieurs de Defazio ont montré l'équivalence avec le momentum heavy-ball) ; avec , la garantie sur le dernier itéré d'une planification à décroissance linéaire. L'annexe C le resserre ensuite en égalité, pour en déduire une vitesse accélérée sur les problèmes lisses.
Il faut aussi préciser les conditions. Toutes ces garanties portent sur des problèmes convexes ; le pas du Theorem 1 cache encore , et le remplacer par , valable à tout instant, donne de très mauvais résultats en pratique. Dans les faits, on utilise un pas fixe bien plus grand, . Le Theorem 3 montre que, sous une condition vérifiable pendant l'entraînement, un pas aussi grand atteint lui aussi la vitesse optimale ; les auteurs l'ont vérifiée sur tous les problèmes de la section 4.1, où elle est toujours satisfaite, mais ils reconnaissent qu'on ne comprend pas encore entièrement quand un grand pas est utilisable sur les problèmes stochastiques.
Un autre indice vient des fonctions quadratiques. Les auteurs génèrent aléatoirement 10 problèmes quadratiques en dimension 20 et balaient et . Avec un petit pas, n'a presque aucun effet ; avec un grand pas, est la clé de la convergence.
Schedule-Free AdamW
En remplaçant l'optimiseur de base par AdamW, on obtient l'Algorithm 1 :
- , l'interpolation remplace le momentum.
- Calculer le gradient en .
- .
- , qui intègre l'échauffement et la correction du biais au taux d'apprentissage.
- .
- .
- .
Plusieurs points diffèrent d'AdamW.
- Pas de moment d'ordre un. sert à l'interpolation ; il suffit donc de stocker , et , soit autant de mémoire qu'AdamW ; la version SGD consomme elle aussi autant que SGD avec momentum.
- L'échauffement reste nécessaire. Dans la section 4.4, les auteurs écrivent sans détour que la méthode a encore besoin d'un échauffement du taux d'apprentissage.
- Les poids de la moyenne suivent le taux d'apprentissage. Avec échauffement, les auteurs utilisent comme poids de moyenne ; les étapes à petit taux d'apprentissage pendant l'échauffement pèsent ainsi moins dans la moyenne, ce qui, d'après eux, améliore fortement les résultats. Une fois l'échauffement terminé, décroît de nouveau au rythme de .
- La décroissance des poids s'applique en . On peut aussi l'appliquer en , mais sur des problèmes comme ImageNet et NanoGPT, l'appliquer en donne de nettement meilleurs résultats.
Détails d'implémentation
Pendant l'entraînement, le gradient se calcule en ; à l'évaluation, il faut ; les paramètres du modèle doivent donc basculer de l'un à l'autre. L'implémentation PyTorch officielle ne stocke qu'une copie supplémentaire, ; le tampon des paramètres eux-mêmes contient pendant l'entraînement et pendant l'évaluation. De , on tire ; c'est exactement l'interpolation que fait optimizer.eval(), et optimizer.train() revient ensuite à .
Il en découle quelques règles d'utilisation. Là où l'on appelle model.train(), il faut aussi appeler optimizer.train(), et là où l'on appelle model.eval(), optimizer.eval() ; avant d'enregistrer un checkpoint, il faut aussi passer en mode eval, sinon c'est qui est sauvegardé, et non . Si votre code prend en charge les step closures de PyTorch, vous pouvez utiliser la version à closure et vous épargner ces bascules.
BatchNorm est le cas le plus pénible. La running mean et la variance de BN s'accumulent pendant l'entraînement, donc en ; une fois passé à , les statistiques ne correspondent plus. Le correctif donné par le README officiel consiste à faire passer quelques dizaines de lots d'entraînement avec avant l'évaluation, pour réaccumuler les statistiques :
model.train()
optimizer.eval()
with torch.no_grad():
    for batch in itertools.islice(train_loader, 50):
        model(batch)
model.eval()
Les couches de normalisation qui ne reposent pas sur des statistiques de lot, comme LayerNorm, n'ont pas ce problème. Le README rappelle aussi que si le framework garde en cache une copie fp16 des paramètres (certains GradScaler le font), il faut la mettre à jour à la main pour que l'évaluation utilise bien .
Discussion
Configuration expérimentale
Les auteurs présentent leur étude comme l'une des plus vastes évaluations d'optimiseurs à ce jour, avec 28 problèmes au total, dont 12 régressions logistiques, 9 tâches d'apprentissage profond et 7 tâches d'AlgoPerf. Parmi les tâches d'apprentissage profond, CIFAR-10, CIFAR-100, SVHN et ImageNet utilisent Schedule-Free SGD, tandis qu'IWSLT14, DLRM, fastMRI, l'affinage de MAE et NanoGPT utilisent Schedule-Free AdamW.
Pour la comparaison, les deux camps balaient une grille de taux d'apprentissage et de décroissance des poids, et Schedule-Free choisit en plus son entre 0.9 et 0.98 ; pour les tâches où l'on utilise habituellement une planification à paliers, celle-ci entre aussi dans la comparaison.
Un seul entraînement pour toute la frontière
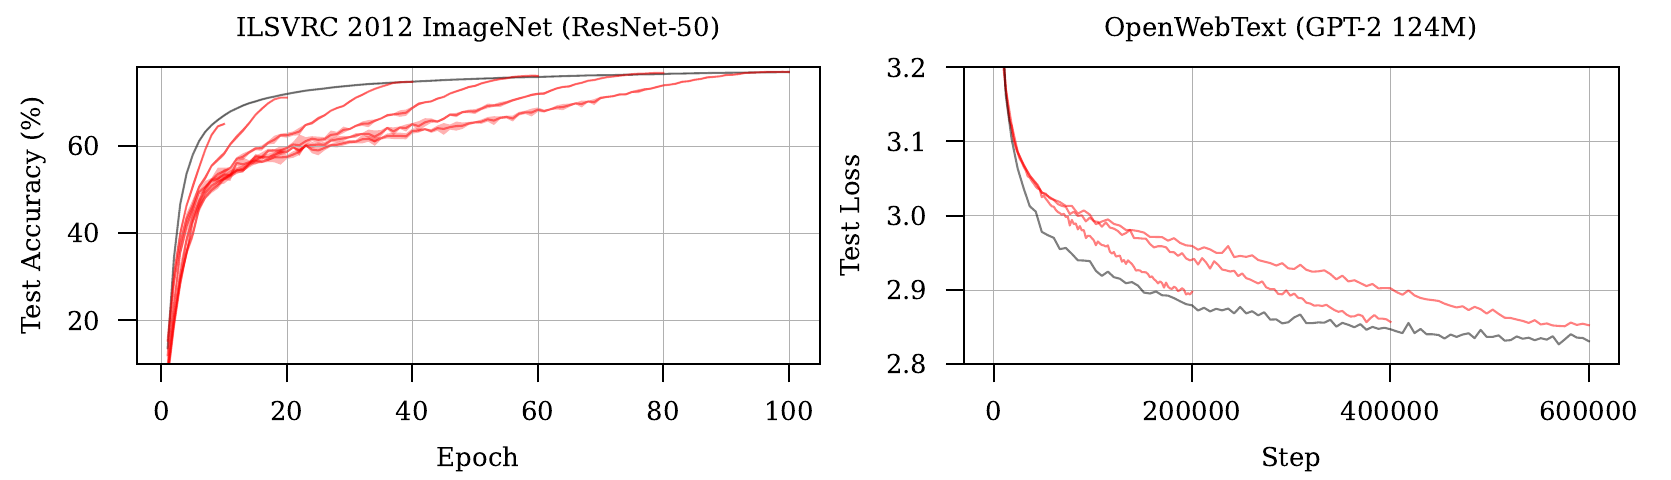
Les courbes rouges sont des planifications cosinus de longueurs différentes, chacune n'étant à son meilleur qu'à sa propre extrémité ; en reliant ces extrémités, on obtient la frontière « durée d'entraînement contre performance ». La courbe noire, issue d'un seul entraînement, colle pourtant à cette frontière à chaque instant, et côté GPT-2, elle reste même sous les courbes rouges la plupart du temps. Autrement dit, où que l'on arrête l'entraînement, c'est à peu près comme si l'on avait réglé à l'avance une planification cosinus pour cette durée-là.
Neuf tâches d'apprentissage profond
| Tâche | Métrique | Schedule-Free | Meilleure planification |
|---|---|---|---|
| CIFAR-10 | Précision | 96.03 | 95.73 |
| CIFAR-100 | Précision | 78.71 | 77.41 |
| SVHN | Précision | 98.40 | 98.27 |
| ImageNet | Précision | 76.90 | 76.90 |
| IWSLT14 | Perte ↓ | 4.18 | 4.23 |
| fastMRI | SSIM | 0.9112 | 0.9110 |
| Criteo | Précision | 0.7915 | 0.7906 |
| Affinage MAE | Précision | 83.54 | 83.52 |
| GPT-2 124M | Perte ↓ | 2.831 | 2.853 |
D'après les légendes des Figures 2 et 5 de l'article. La colonne « Meilleure planification » correspond à la planification cosinus ou à décroissance linéaire réglée par les auteurs ; ImageNet utilise ResNet-50, et GPT-2 124M correspond à la configuration NanoGPT sur OpenWebText.
Schedule-Free bat la planification réglée sur sept tâches (avec un écart minime pour fastMRI et Criteo), et fait jeu égal sur ImageNet et sur l'affinage de MAE. Le plus grand écart concerne CIFAR-100, avec 1.3 point de plus ; sur ImageNet, les deux obtiennent 76.90 %, contre 76.49 % pour la planification à paliers.
Derrière ces chiffres, quelques réglages méritent qu'on s'y arrête.
- Des taux d'apprentissage bien plus grands. Sur CIFAR-10, Schedule-Free utilise un taux d'apprentissage de 10, contre 0.2 pour le cosinus ; sur ImageNet, 1.5 contre 0.05 ; sur NanoGPT, 0.005 contre 0.0005. Selon les auteurs, pouvoir utiliser un taux plus grand sans diverger explique peut-être en partie la convergence plus rapide.
- NanoGPT demande un traitement particulier. Avec , la perte remonte rapidement en cours d'entraînement ; il faut passer à 0.98 pour stabiliser. L'écrêtage du gradient doit aussi être désactivé, un point que les auteurs jugent crucial.
- Le gradient ne s'effondre pas. Sur CIFAR-10, avec SGD et une planification cosinus, la perte d'entraînement approche 0 en fin de parcours, et la norme du gradient s'effondre elle aussi vers 0, après quoi le modèle n'apprend presque plus ; Schedule-Free ne présente pas ce phénomène. Les auteurs y voient une raison possible de ses très bons résultats sur CIFAR et SVHN.
L'annexe ajoute les résultats de la moyenne de Polyak et du primal averaging sur les mêmes tâches ; tous deux sont nettement en retrait. Sur ImageNet, ils obtiennent respectivement 72.84 % et 69.78 %, et sur NanoGPT, la perte de la moyenne de Polyak diverge carrément.
AlgoPerf
Les résultats AlgoPerf de l'article sont une comparaison menée par les auteurs eux-mêmes selon les règles de la compétition, face à la référence NAdamW, sur 10 graines aléatoires. La tâche ResNet-50 est exclue, car ni AdamW ni NAdamW n'atteignent la cible. Sur les 7 tâches restantes, Schedule-Free AdamW est plus rapide sur WMT, ViT, fastMRI et OGBG, fait jeu égal sur Conformer et Criteo, et est un peu plus lent sur DeepSpeech. Les auteurs attribuent les résultats de ces deux tâches à BatchNorm ; Conformer et DeepSpeech utilisent BN, et le cadre logiciel de la compétition se prête mal au recalcul des statistiques BN en .
L'annexe donne aussi la configuration unique utilisée dans la catégorie auto-réglée : taux d'apprentissage 0.0025, , , décroissance des poids d'environ 0.081, échauffement de 2 %, et poids de moyenne multipliés en plus par .
Les résultats officiels figurent dans l'annonce de MLCommons et dans l'analyse publiée ensuite par les organisateurs à ICLR 2025. Dans la catégorie auto-réglée, Schedule Free AdamW est la seule soumission à battre la référence, avec un temps d'entraînement moyen environ 8 % plus court, et il est le plus rapide sur 4 des 8 tâches de base ; comparé à la référence de la catégorie à réglage externe, il est, sans aucun réglage, environ 10 % plus rapide sur les 7 tâches où les deux ont réussi l'entraînement. La même équipe a aussi engagé une version à 5 configurations dans la catégorie à réglage externe, où elle se classe deuxième (0.7077), derrière les 0.7784 de Distributed Shampoo ; sur les 7 tâches réussies par les deux, Shampoo est environ 24 % plus rapide que Schedule-Free AdamW auto-réglé.
Il y a aussi eu un petit incident. Le prix de la catégorie auto-réglée n'a finalement pas été décerné. Selon l'annonce de MLCommons, les conditions d'attribution n'étaient pas remplies, plusieurs soumissions ayant des affiliations communes avec les présidents du groupe de travail.
Sensibilité au momentum
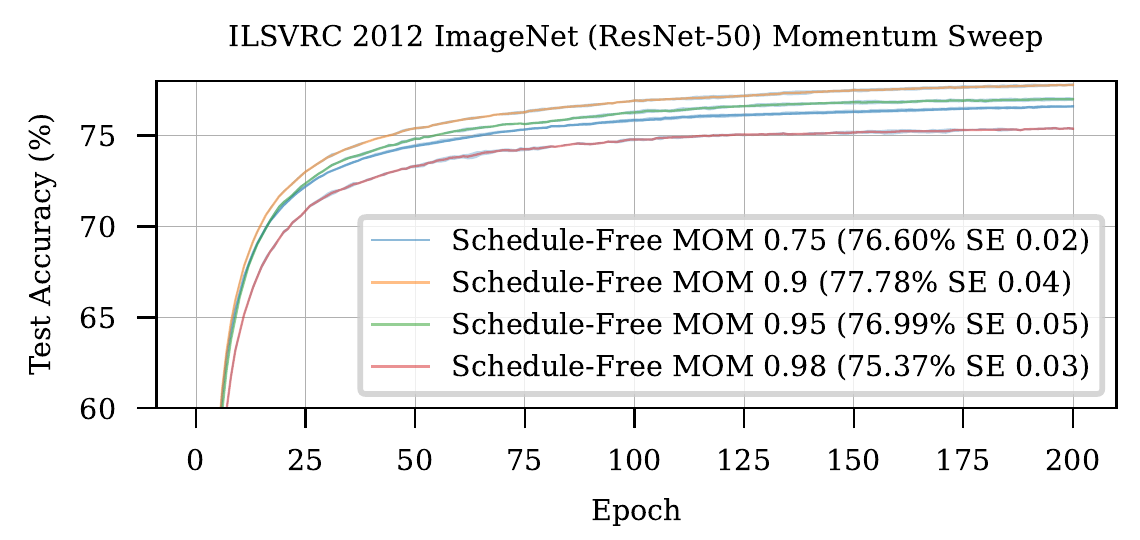
Si le optimal changeait avec la durée d'entraînement, « pas besoin de connaître » ne ferait que déplacer le problème de la planification vers le momentum. Les auteurs entraînent sur ImageNet pendant 200 époques, plus longtemps que d'habitude, en balayant quatre valeurs de momentum. Quel que soit le moment où l'on s'arrête pour regarder, le meilleur reste . La sensibilité au taux d'apprentissage est elle aussi comparable à celle d'une planification cosinus ; ce n'est que pour des entraînements très courts (25 époques au plus) qu'un taux un peu plus grand fait mieux.
Les autres éléments sont toutefois moins optimistes. NanoGPT exige déjà de porter à 0.98 ; le README officiel indique aussi que pour des entraînements particulièrement longs, il peut falloir monter à 0.95 ou 0.98. Hägele et al. (NeurIPS 2024) comparent, sur un modèle de langage de 210 millions de paramètres, Schedule-Free AdamW à « un taux d'apprentissage constant suivi d'un refroidissement linéaire final » (proche de WSD). Avec , il est nettement moins bon, et la perte remonte même en fin d'entraînement ; avec , il se comporte très bien, mais dans les deux configurations, la planification avec refroidissement l'égale ou le dépasse. Ils n'ont pas non plus réglé davantage les hyperparamètres de l'un ou de l'autre.
Limites
Dans leur conclusion, les auteurs indiquent clairement que la principale limite pratique est de devoir refaire le balayage du taux d'apprentissage et de la décroissance des poids, car les valeurs optimales diffèrent de celles utilisées avec une planification. Les autres points de vigilance ont pour la plupart déjà été évoqués.
- L'échauffement reste nécessaire. La plupart des expériences de l'article le fixent à 5 % de la durée totale d'entraînement, et la configuration AlgoPerf à 2 % ; à strictement parler, la durée d'entraînement intervient donc encore.
- BN demande de recalculer les statistiques en ; il faut basculer de mode entre entraînement et évaluation, et de même avant d'enregistrer un checkpoint.
- La théorie ne couvre que les problèmes convexes, et il n'existe pas encore de théorie complète sur les conditions d'utilisation d'un grand pas.
- est plus sensible pour les longs entraînements de modèles de langage.
Conclusion
Schedule-Free remplace la planification du taux d'apprentissage par trois suites. L'optimiseur de base fait ses pas en , est la moyenne de , et le gradient est calculé en , entre les deux. La moyenne contient implicitement une planification à décroissance linéaire dont l'extrémité se déplace en permanence, si bien qu'il n'est pas nécessaire de connaître à l'avance ; sur les problèmes convexes, tout conserve la vitesse optimale dans le pire cas. Sur 9 tâches d'apprentissage profond, il en gagne 7 et fait jeu égal sur 2, et il remporte la première place de la catégorie auto-réglée d'AlgoPerf 2024.
Si vous voulez l'essayer, après avoir changé d'optimiseur, pensez à ajouter les optimizer.train() et optimizer.eval() correspondants à côté de model.train() et model.eval(), et à passer en mode eval avant d'enregistrer un checkpoint ; pour un modèle avec BN, recalculez les statistiques en avant l'évaluation. Commencez avec un taux d'apprentissage 1 à 10 fois (AdamW) ou 10 à 50 fois (SGD) plus grand que celui de la version avec planification, prenez d'abord à 0.9, montez vers 0.95 ou 0.98 pour les entraînements très longs, et gardez l'échauffement.
Le nom a beau être Schedule-Free, la ligne 8 de l'Algorithm 1 contient toujours .