Article original
Large Batch Optimization for Deep Learning: Training BERT in 76 minutes
- Publication
- ICLR 2020Conférence
- Premier dépôt sur arXiv
- arXiv:1904.00962
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizerslamb2019,
  title = {{Large Batch Optimization for Deep Learning: Training BERT in 76 minutes}},
  author = {Yang You and Jing Li and Sashank Reddi and Jonathan Hseu and Sanjiv Kumar and Srinadh Bhojanapalli and Xiaodan Song and James Demmel and Kurt Keutzer and Cho-Jui Hsieh},
  year = {2019},
  eprint = {1904.00962},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1904.00962}
}
Soumis à ICLR 2018, LARS a été refusé. La décision des relecteurs est très précise ; elle relève que la méthode n'est validée que sur une seule tâche, ImageNet, qu'elle ajoute des hyperparamètres, et que la mise à l'échelle couche par couche du taux d'apprentissage n'a aucun fondement théorique.
Un an plus tard, Yang You, premier auteur de LARS, devenu chercheur étudiant chez Google Brain, revient avec un article qui répond à chacune de ces objections. La nouvelle tâche est BERT, le nouvel optimiseur s'appelle LAMB, et deux théorèmes de convergence complètent le tout. Le titre ne fait pas dans la modestie et affiche directement « 76 minutes ».
Définir le problème
Le préentraînement de BERT-Large se fait en deux phases, d'abord 900 000 étapes avec des séquences de longueur 128, puis les 100 000 dernières étapes avec des séquences de longueur 512, le batch étant de 512 dans les deux cas. Sur 16 TPUv3, cela prend environ 3 jours (81.4 heures selon la mesure de l'article).
Pour réduire ce temps, le plus direct est d'ajouter des machines et d'agrandir le batch, mais les deux voies toutes tracées sont des impasses. La première est LARS, qui ramène l'entraînement de ResNet-50 sur ImageNet à quelques minutes, mais ne fonctionne pas sur BERT :
| Batch | 512 | 4K | 8K | 16K | 32K |
|---|---|---|---|---|---|
| LARS | 90.72 | 90.54 | 90.55 | 89.59 | diverge |
| LAMB | 91.75 | 91.14 | 91.26 | 91.35 | 91.48 |
D'après la Table 2 de l'article ; F1 sur le jeu de développement de SQuAD v1.1, sélection de colonnes ; le F1 du BERT-Large officiel est de 90.395.
La seconde est AdamW, déjà utilisé par BERT. Les auteurs essaient trois réglages, les valeurs par défaut de BERT, les hyperparamètres de LAMB repris tels quels, et un réglage refait par leurs soins. À 16K, le F1 n'atteint que 88.1, en deçà de l'objectif de 90.4 ; dans le tableau de réglage de l'annexe, toutes les configurations à échauffement plus court divergent. Avec un batch mixte de 64K pour la première phase et de 32K pour la seconde, « même après un long réglage, impossible d'obtenir un résultat raisonnable ».
Peut-on garder l'avantage de l'adaptation élément par élément d'Adam, y ajouter le rapport de confiance couche par couche de LARS, et faire tenir BERT jusqu'à 32K ? C'est la question à laquelle répond cet article.
Résoudre le problème
Une transformation en deux étapes
Les auteurs commencent par abstraire LARS en une stratégie générale, applicable à n'importe quel optimiseur de base. Si la mise à jour de chaque couche par l'algorithme de base (SGD ou Adam) est , on la modifie ainsi :
- Normaliser d'abord la mise à jour de chaque couche à une longueur unité : .
- Multiplier le taux d'apprentissage, couche par couche, par , où est une fonction de la norme des poids.
Avec SGD comme base, la mise à jour de la couche devient
La première étape ne garde que la direction et jette la taille du gradient. La mise à jour devient biaisée, mais selon les auteurs, avec un très grand batch, la direction du gradient est globalement fiable et le biais reste faible ; l'avantage est qu'un gradient soudain énorme ou minuscule ne se répercute plus directement sur la mise à jour. La seconde étape aligne l'ordre de grandeur de la mise à jour sur celui des poids. En pratique, les auteurs utilisent
c'est-à-dire qu'ils bornent la norme des poids entre une limite basse et une limite haute, pour éviter qu'une couche fraîchement initialisée, de norme très petite ou très grande, reçoive un rapport aberrant. L'article ne précise pas les valeurs réellement données à et .
Si , le taux d'apprentissage global est multiplié par , exactement le trust ratio de LARS. Les auteurs interprètent en outre ce rapport comme une estimation grossière de l'inverse de la constante de Lipschitz du gradient de la couche ; les couches à forte courbure font automatiquement de petits pas.
LAMB
En prenant Adam comme base, on obtient LAMB (Layer-wise Adaptive Moments optimizer for Batch training). À chaque étape, on calcule d'abord, comme dans Adam, les moments d'ordre un et deux, avec correction du biais :
On ajoute ensuite la décroissance des poids découplée, puis on applique à toute la couche la mise à l'échelle par le trust ratio :
Il y a ici deux niveaux d'adaptation. ajuste le pas élément par élément à l'intérieur de la couche, et le trust ratio égalise, d'une couche à l'autre, le rapport entre la mise à jour et les poids. Placer la décroissance des poids à l'intérieur de la norme est un choix délibéré des auteurs ; le terme de décroissance et la mise à jour d'Adam déterminent ensemble la distance parcourue par la couche. Les valeurs par défaut sont , , et , avec pour taux d'apprentissage la décroissance linéaire d'origine de BERT, . Les auteurs notent aussi qu'avec , LAMB dégénère en signSGD, avec un taux d'apprentissage multiplié par la racine carrée de la dimension de la couche.
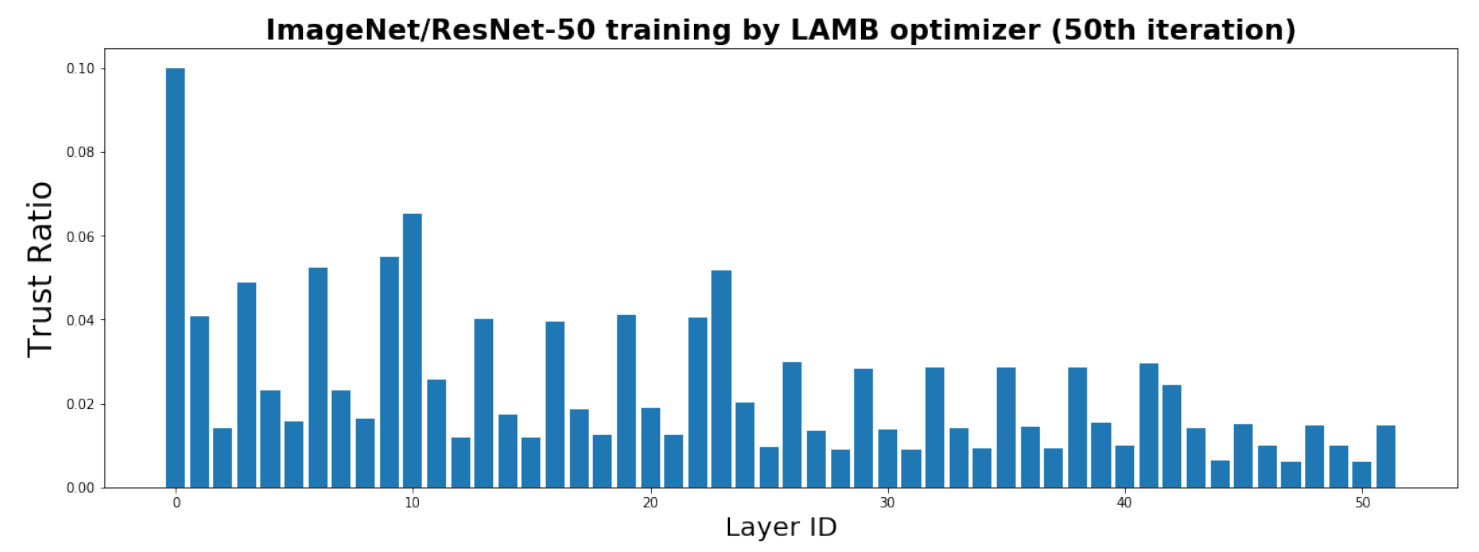
Cette figure d'annexe relève le trust ratio de chaque couche de ResNet-50 à la 50e itération d'entraînement. En abscisse, le numéro de la couche ; en ordonnée, le rapport. La première couche est la plus haute, vers 0.10 ; les couches les plus basses, en fin de réseau, ne sont qu'autour de 0.006, soit un écart de plus d'un facteur dix, et les couches d'un même bloc résiduel alternent entre haut et bas. Les auteurs y voient le trust ratio en train d'accélérer « les couches qui apprennent lentement ».
Analyse de convergence
C'est la partie qu'on avait reproché à LARS de ne pas fournir. Dans un cadre d'optimisation stochastique non convexe avec régularisation , les auteurs supposent la perte -smooth par rapport à la couche , et définissent (la couche la plus raide) et (la moyenne sur les couches).
Le point de comparaison est SGD. Avec une taille de batch égale au nombre total d'étapes et un taux d'apprentissage bien choisi, la borne de SGD dépend de . L'intuition est la même que pour le tableau des rapports par couche de LARS ; avec un seul taux d'apprentissage pour tout le réseau, on doit s'aligner sur la couche la plus raide.
Les bornes de LARS (Theorem 2) et de LAMB (Theorem 3) font intervenir à la place, sous plusieurs conditions :
- , c'est-à-dire un batch du même ordre que le nombre total d'étapes ;
- l'analyse ne traite que le cas et décroissance des poids ;
- admet des bornes positives ;
- la borne de LAMB en exige en plus et le même nombre de paramètres dans chaque couche ; pour , les auteurs n'obtiennent qu'une borne moins bonne, tout en disant croire qu'en pratique, le cas devrait se comporter mieux que le cas , et laissent la question à de futurs travaux.
Les critères de convergence diffèrent aussi ; SGD mesure le carré de la norme du gradient, LARS le carré de la somme des normes du gradient par couche. Les auteurs expliquent en annexe que la borne de LARS ne bat celle de SGD que si le gradient est « plus dense » que la courbure et le bruit ; sinon, c'est la borne supérieure de SGD qui est meilleure. Autrement dit, ces deux théorèmes montrent que la mise à l'échelle par couche est avantageuse sous certaines conditions, et les et utilisés dans les expériences sortent du champ des théorèmes.
Discussion
De 3 jours à 76 minutes
Les expériences BERT reprennent les données officielles (2.5 milliards de mots de Wikipedia et 800 millions de mots de BooksCorpus) et la procédure d'affinage sur SQuAD v1.1, dont les réglages restent inchangés. LAMB ne règle qu'un taux d'apprentissage, et ne le règle même pas à nouveau quand le batch grandit ; il le met à l'échelle selon la règle de la racine carrée, pour un batch de 512, multiplié par à chaque doublement, jusqu'à à 32K ; la proportion d'échauffement passe de 1/320 à 1/5 du nombre total d'étapes. Le nombre d'époques étant fixe, plus le batch est grand, moins il y a d'étapes.
| Batch | Étapes | TPUv3 | Durée | F1 |
|---|---|---|---|---|
| 512 (officiel) | 1000k | 16 | 81.4 h | 90.395 |
| 512 | 1000k | 16 | 82.8 h | 91.752 |
| 4K | 125k | 128 | 693.6 m | 91.137 |
| 16K | 31 250 | 512 | 200.0 m | 91.345 |
| 32K | 15 625 | 1024 | 101.2 m | 91.475 |
| 64K/32K | 8 599 | 1024 | 76.19 m | 90.584 |
D'après la Table 1 de l'article, sélection de lignes.
32K est le maximum que peut contenir un Pod TPUv3 complet (1 024 puces) avec des séquences de longueur 512. Sur les 15 625 étapes, 14 063 se font en longueur 128 et 1 562 en longueur 512, en 100 minutes environ ; 64 fois plus de ressources donnent une accélération de 49.1 fois.
Pour aller plus vite encore, les auteurs utilisent un batch différent dans chaque phase. Dans la première, les séquences sont courtes et le batch peut monter jusqu'à 131 072, mais au-delà de 65 536, on ne gagne plus rien en vitesse ; la première phase utilise donc 65 536, et la seconde revient à 32 768. Passer d'un grand batch à un plus petit met l'entraînement sens dessus dessous ; les auteurs y remédient en refaisant, au début de la seconde phase, un échauffement du taux d'apprentissage depuis 0, avant la décroissance habituelle. Au total, 8 599 étapes et 76 minutes.
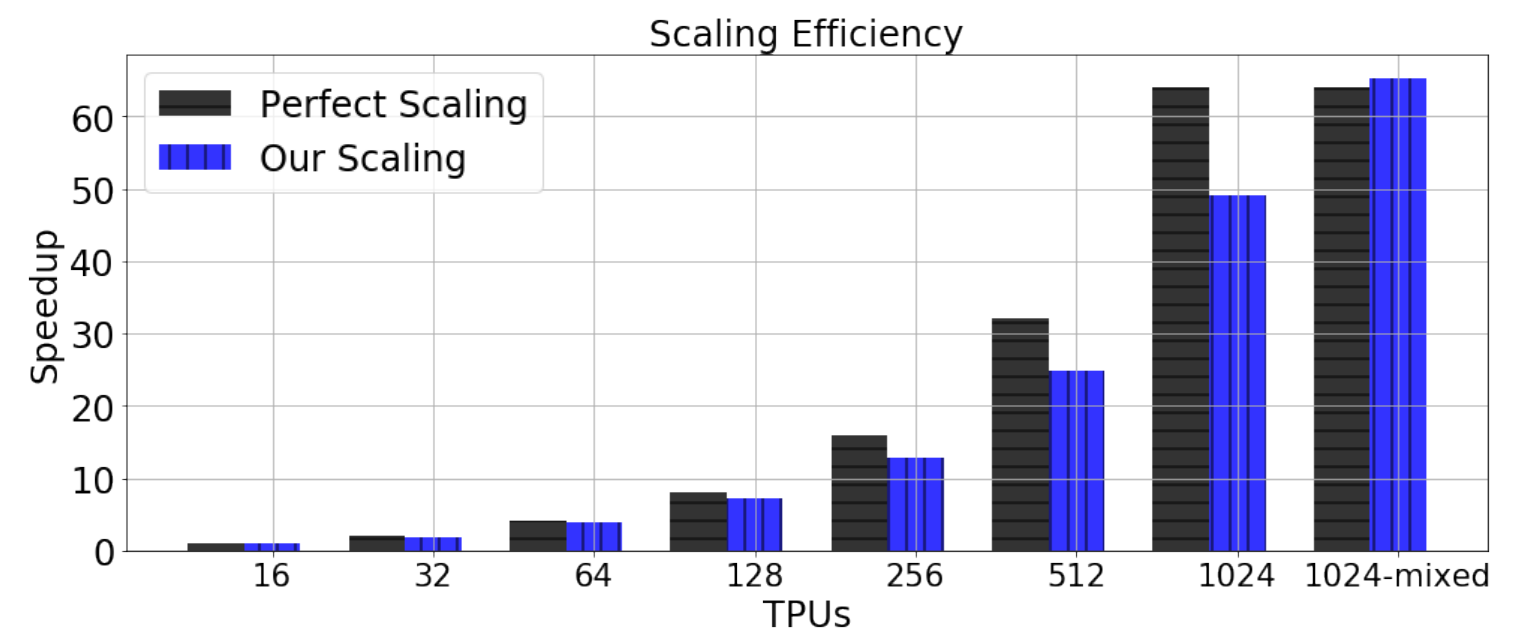
Les barres noires représentent l'accélération linéaire idéale, les bleues les mesures. Avec 1 024 puces et un batch de 32K, on n'obtient qu'un facteur 49 ; les auteurs attribuent l'écart au volume de communication de la synchronisation des gradients, BERT ayant 300 millions de paramètres contre 25 millions seulement pour ResNet-50. Le batch mixte, tout à droite, atteint un facteur 65.2 ; dépasser la valeur idéale n'a rien d'étonnant, puisqu'il fait presque moitié moins d'étapes qu'avec un batch fixe de 32K.
Le chiffre de 76 minutes doit se lire avec le F1. Les 90.584 du batch mixte dépassent les 90.395 du BERT officiel, mais c'est le score le plus bas de toutes les configurations de LAMB, les autres se situant entre 91.1 et 91.9.
ImageNet
Côté ResNet-50, les auteurs veulent montrer qu'une méthode adaptative comme LAMB peut elle aussi atteindre le niveau de SGD avec momentum. Avec un batch de 16K et 90 époques, AdaGrad, Adam et AdamW, même soigneusement réglés, n'obtiennent que 55.38 %, 66.04 % et 67.27 % ; avec l'échauffement et la décroissance par paliers de Goyal et al., ils n'atteignent que 72.01 %, 73.48 % et 73.07 %. Le SGD avec momentum rapporté par Goyal et al. obtient 75.20 %, LAMB 76.66 %. De 512 à 32K, sans aucun nouveau réglage, le top-1 de LAMB reste entre 76.42 % et 77.11 %, le minimum étant à 32K ; face à LARS, à 32K, on a 76.4 % contre 76.3 %.
Reality Check
Deux ans plus tard, Nado et ses collègues de Google refont les expériences BERT dans « A Large Batch Optimizer Reality Check », dont le sous-titre donne directement la conclusion, à savoir que les optimiseurs génériques traditionnels suffisent pour toutes les tailles de batch.
Ils reprennent la même configuration en deux phases et le même nombre d'étapes, en remplaçant seulement LAMB par Adam, soigneusement réglé à nouveau :
| Batch | Étapes | LAMB | Adam |
|---|---|---|---|
| 32K | 15 625 | 91.48 | 91.58 |
| 64K/32K | 8 599 | 90.58 | 91.04 |
| 64K | 7 818 | – | 90.46 |
D'après la Table 3 de Nado et al. ; F1 sur le jeu de développement de SQuAD v1.1 ; les valeurs de LAMB sont reprises de l'article LAMB.
À 32K, la perte de préentraînement d'Adam est aussi plus basse, 1.277 contre 1.342. Avec 64K du début à la fin, Adam atteint 90.46 en 7 818 étapes, soit plus de sept cents étapes de moins que le batch mixte de LAMB.
Qu'est-ce qui distingue les conditions des deux camps ? Nado et al. pointent deux détails d'implémentation qui ont pu désavantager l'Adam de l'article LAMB. D'abord, l'Adam du code open source de BERT n'a pas de correction du biais, alors que celle-ci a en elle-même un effet d'échauffement. Ensuite, la planification du taux d'apprentissage de BERT présente une falaise au début de la décroissance, celle-ci étant appliquée par erreur dès l'échauffement ; ce code se retrouve dans plus de 3 000 copies du programme d'entraînement de BERT sur GitHub. L'effort de réglage n'est pas non plus le même. Pour chacune des deux phases de préentraînement, Nado et al. recherchent séparément le taux d'apprentissage, , , l'exposant de la courbe d'échauffement et la décroissance des poids, avec environ 30 essais par phase, et 130 pour la seconde phase à 64K, étant fixé à . En sens inverse, ils n'ont pas relancé LAMB, et comparent des nombres d'étapes, pas des temps réels mesurés ; leur argument est qu'Adam est plus simple à calculer, et qu'à nombre d'étapes égal, il ne sera pas plus lent sur un système optimisé.
Sur ResNet-50 (batch de 32 768, 6 000 étapes), ils appliquent aussi LAMB tel quel à tous les paramètres, et n'obtiennent que 27.3 % ; en confiant les paramètres de BatchNorm et les biais à Adam, on remonte à 76.3 %. La normalisation couche par couche peut donc réellement nuire à certains paramètres, et l'article LAMB ne dit pas comment ceux-ci sont traités. Ils écrivent dans leur discussion que les règles de mise à jour de LARS et de LAMB n'ont pas plus de lien avec les « grands batchs » que celles du momentum ou d'Adam ; les hypothèses sur lesquelles reposent les bornes de convergence (pas de momentum, ) sont très éloignées de la pratique, et l'on peut démontrer des bornes similaires pour Adam.
Un autre éclairage vient de MoCo v3. En 2021, Chen, Xie et He essaient aussi LAMB pour entraîner ViT de façon auto-supervisée ; avec ViT-B/16 et un batch de 4096, LAMB atteint 72.5 % avec un taux d'apprentissage de , un peu mieux qu'AdamW ; à et , la précision chute de 1.6 et de 6.0 points. Les auteurs le jugent trop sensible au taux d'apprentissage pour s'en servir commodément dans des ablations.
Conclusion
Pour passer de 81 heures à 76 minutes, LAMB transpose à Adam le rapport de confiance couche par couche de LARS, et y ajoute 1 024 TPUv3, un batch mixte et un nouvel échauffement en seconde phase ; il apporte aussi les théorèmes de convergence qui manquaient à LARS. Les vérifications ultérieures montrent que, pour peu que l'implémentation d'Adam soit sans défaut et chaque phase sérieusement réglée, Adam ne fait pas moins bien que LAMB à batch et nombre d'étapes égaux ; et les conditions de validité des théorèmes sont très éloignées de l'entraînement réel.
Avant de passer à LAMB, vérifiez quelle version votre bibliothèque implémente, s'il y a ou non correction du biais, et normalisation préalable du gradient, et si LayerNorm et les biais sont exclus du trust ratio. Ensuite, au même nombre d'étapes, réglez sérieusement un Adam avec correction du biais comme point de comparaison.
Le record des 76 minutes a finalement été égalé, en moins d'étapes, par Adam, celui-là même que LAMB voulait remplacer.