Article original
Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:1706.02677
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{optimizerslargeminibatchsgd2017,
  title = {{Accurate, Large Minibatch SGD: Training ImageNet in 1 Hour}},
  author = {Priya Goyal and Piotr Dollár and Ross Girshick and Pieter Noordhuis and Lukasz Wesolowski and Aapo Kyrola and Andrew Tulloch and Yangqing Jia and Kaiming He},
  year = {2017},
  eprint = {1706.02677},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1706.02677}
}
Entraîner un ResNet-50 sur 8 Tesla P100, avec une taille de lot (batch size) de 256, demande 29 heures pour parcourir les 90 époques d'ImageNet.
En juin 2017, une équipe de Facebook transpose le même modèle sur 256 GPU, porte la taille de lot à 8 192, et termine l'entraînement en une heure, avec une erreur top-1 de validation à seulement 0.14 point de pourcentage de celle d'origine. Parmi les auteurs figurent Ross Girshick, Piotr Dollár et Kaiming He, ainsi que Yangqing Jia, l'auteur de Caffe.
Avec 32 fois plus de GPU pour un temps 29 fois plus court, on dirait un résultat obtenu à coups de matériel. Ce rapport technique consacre pourtant l'essentiel de ses pages à ce qui ne relève pas du matériel, notamment la façon d'ajuster le taux d'apprentissage quand le lot devient 32 fois plus grand, la raison pour laquelle l'entraînement déraille au tout début, la manière de calculer BatchNorm, et quelques détails d'implémentation qui, mal écrits, laissent l'entraînement tourner, mais dégradent le résultat.
Définir le problème
Dans le SGD distribué synchrone, workers (ici, GPU) calculent chacun le gradient sur exemples ; les gradients sont additionnés, et tous mettent à jour les paramètres avec le même résultat. Chaque pas voit donc exemples.
Pour que chaque carte ait du travail, ne peut pas être trop petit ; plus il y a de GPU, plus le lot total est grand. Pour les mêmes 90 époques, un lot 32 fois plus grand signifie 32 fois moins de mises à jour.
Les grands lots avaient alors mauvaise réputation. En 2014, Krizhevsky avait fait croître le taux d'apprentissage linéairement avec le lot, mais en passant de 128 à 1 024, l'erreur augmentait d'un point de pourcentage. Keskar et al. (2017) soutenaient que les grands lots convergent vers des minima aigus, et généralisent moins bien. D'autres avaient entraîné avec des lots de 5 120 sans perte de précision, mais sans donner de règle d'ajustement qui dispense de chercher les hyperparamètres.
L'article cherche à savoir si, en faisant grossir le lot à partir de 256, on peut conserver la précision des petits lots avec une seule règle simple, sans régler à nouveau aucun hyperparamètre ; et sinon, où cela casse.
Résoudre le problème
La règle de mise à l'échelle linéaire
La règle des auteurs tient en une phrase, lot multiplié par , taux d'apprentissage multiplié par . Les autres hyperparamètres, comme la décroissance des poids, restent tous inchangés.
Pourquoi multiplier par ? Prenons . Un pas de SGD avec un petit lot s'écrit :
Avec deux petits lots et , on fait deux pas de suite ; le gradient du second pas est calculé en :
Si l'on fusionne les deux petits lots en un grand lot de taille , et qu'on ne fait qu'un seul pas, avec un taux d'apprentissage :
Les deux équations ne diffèrent qu'en deux points, l'endroit où est calculé le gradient du second petit lot ( ou ), et le coefficient devant. Si le gradient change peu après un pas des paramètres, c'est-à-dire , l'égalité des deux équations exige , soit . Généralisé à petits lots, cela donne les équations (3) et (4) de l'article, et .
Les auteurs reconnaissent eux-mêmes que c'est une hypothèse forte, et signalent au moins deux cas où elle ne tient manifestement pas. Le premier est le début de l'entraînement, quand le réseau change vite et que les gradients de pas voisins diffèrent beaucoup. Le second est que le lot ne peut pas grandir indéfiniment ; les résultats restent stables sur une large plage, mais au-delà d'un certain point, la précision se dégrade rapidement, et sur ImageNet, ce point se situe vers 8k.
Le premier cas est confié à l'échauffement.
L'échauffement
L'article ResNet utilisait déjà un échauffement constant, avec un petit taux d'apprentissage fixe pendant les premières époques. Les auteurs l'essaient avec un lot de 8k, avec pendant les 5 premières époques puis un saut direct à , et constatent que cela ne suffit pas ; au moment où l'on quitte le faible taux d'apprentissage, l'erreur d'entraînement monte brutalement.
Ils passent donc à un échauffement progressif (gradual warmup), qui part de , ajoute une quantité fixe à chaque pas, et atteint exactement au bout de 5 époques, avant de reprendre la planification d'origine.
Faisons le calcul pour un lot de 8k. Le jeu d'entraînement d'ImageNet compte environ 1.28 million d'images ; une époque fait environ 156 pas, et 5 époques environ 780. Pour faire monter le taux d'apprentissage de 0.1 à 3.2, il faut ajouter environ 0.004 à chaque pas. Les auteurs notent aussi que les résultats sont peu sensibles à la durée de l'échauffement.
Le lot de BatchNorm
BatchNorm calcule la moyenne et la variance sur un lot ; la perte de chaque exemple ne dépend donc plus seulement de lui, mais aussi des autres exemples du même lot. Les auteurs l'écrivent clairement dans l'équation (5). Avec BN, on peut voir le jeu d'entraînement comme « l'ensemble de tous les sous-ensembles de taille », chaque sous-ensemble formant un exemple indépendant.
La taille de lot de BN fait donc partie de la définition de la fonction de perte. Si change, le caractère aléatoire des statistiques de BN change aussi, et l'objectif optimisé change avec lui. Les auteurs fixent donc par worker, et n'augmentent que quand ils ajoutent des GPU ; les statistiques de BN sont aussi calculées séparément dans chaque worker, sans synchronisation entre workers. Cela économise des communications, et surtout, les expériences à différentes tailles de lot optimisent ainsi le même objectif. Le texte original précise que, si l'on veut changer , il faut le régler comme un hyperparamètre de BN, et non comme un paramètre de l'entraînement distribué.
Quatre pièges d'implémentation
La section 3 liste quatre détails qui, « mal écrits, n'empêchent pas d'entraîner, mais donnent une erreur plus élevée que prévu » ; chacun est résumé dans une Remark.
Décroissance des poids. La décroissance des poids est en fait le gradient du terme L2 de la perte. Si l'on écrit la perte de chaque exemple , la mise à jour SGD devient l'équation (8) :
En pratique, la rétropropagation ne calcule que le terme d'entropie croisée, et est ajouté à part. Multiplier la perte d'entropie croisée par n'agrandit donc que le second terme, sans toucher au terme de décroissance des poids, et l'effet diffère de celui d'un taux d'apprentissage multiplié par . C'est la Remark 1 ; mettre à l'échelle la perte d'entropie croisée et mettre à l'échelle le taux d'apprentissage sont deux choses différentes.
Correction du momentum. Le SGD avec momentum a deux écritures courantes. L'écriture de référence est l'équation (9), où le tampon de momentum n'accumule que les gradients, et où le taux d'apprentissage n'est appliqué qu'au moment de mettre à jour les paramètres :
L'autre écriture est l'équation (10), qui absorbe le taux d'apprentissage dans le tampon, avec :
À taux d'apprentissage fixe, les deux sont parfaitement équivalentes. Dès que le taux change, elles diffèrent. contient un historique multiplié par l'ancien taux ; pour rester cohérent avec l'équation (9), il faut d'abord le multiplier par lors de la mise à jour, rapport que les auteurs appellent correction du momentum. Ils constatent que, quand le taux d'apprentissage augmente fortement (), l'absence de correction rend le terme d'historique trop petit et l'entraînement instable ; quand le taux baisse, cette correction est moins critique. C'est la Remark 2 ; avec l'écriture de l'équation (10), tout changement de taux d'apprentissage exige une correction du momentum.
Agrégation des gradients. Le bon gradient d'un grand lot est la somme des gradients des exemples, divisée par . La couche de perte de chaque worker fait généralement déjà la moyenne sur ses exemples, et allreduce fait une somme, pas une moyenne ; il manque donc un facteur . Les auteurs conseillent de placer directement ce dans la perte, ce qui ne met à l'échelle que le gradient de la perte par rapport à son entrée, et évite de remettre à l'échelle tout le vecteur gradient. C'est la Remark 3 ; la perte de chaque worker doit être divisée par le lot total , et non par son propre . Le texte original rappelle aussi qu'il est faux de compenser « en ne multipliant pas le taux d'apprentissage par et en ne divisant la perte que par » ; la décroissance des poids serait alors mal calculée, pour la raison donnée dans la Remark 1.
Mélange des données. La théorie de SGD suppose un tirage aléatoire à chaque fois ; en pratique, on mélange le jeu d'entraînement à chaque époque. Pour une comparaison équitable avec une référence qui utilise ce mélange, on ne génère qu'une seule permutation aléatoire par époque, que l'on découpe en parts réparties entre les workers. C'est la Remark 4. Si chaque worker mélange de son côté, sans coordination, le comportement peut changer nettement, et fausser les conclusions des expériences.
La communication
Pour dépasser les 8 cartes d'un seul serveur, les gradients doivent être agrégés à travers le réseau. Les gradients des différentes couches n'ont pas de dépendance entre eux ; dès que le gradient d'une couche est calculé, on lance son allreduce tout en continuant à calculer la couche suivante, ce qui cache la communication derrière la rétropropagation.
L'allreduce se fait en trois étapes ; on additionne d'abord les tampons des 8 cartes à l'intérieur du serveur, puis on fait la somme entre serveurs, et enfin on diffuse le résultat à chaque carte. Pour la partie entre serveurs, les auteurs implémentent deux algorithmes, recursive halving/doubling et ring ; sur 32 serveurs (256 cartes), le premier est 3 fois plus rapide que le second. Tout cela se trouve dans Gloo, la bibliothèque open source de Facebook, utilisée avec Caffe2.
Le matériel est le serveur Big Basin de Facebook, avec 8 P100 par serveur reliées par NVLink, et un Ethernet ordinaire à 50 Gbit entre serveurs. Les auteurs ont estimé la bande passante. ResNet-50 compte environ 25 millions de paramètres, soit 100 MB ; la rétropropagation sur une P100 prend environ 120 millisecondes ; le trafic réseau d'un allreduce vaut environ 2 fois la taille des données ; le pic demande donc 200 MB / 0.125 s = 1 600 MB/s, soit environ 12.8 Gbit/s, et environ 15 Gbit/s avec les surcoûts ; 50 Gbit suffisent.
Discussion
Dispositif expérimental
La référence principale est l'erreur top-1 de validation sur ImageNet-1k. Le modèle est le ResNet-50 de fb.resnet.torch (stride 2 placé sur la convolution 3×3), avec un momentum de Nesterov de 0.9 et une décroissance des poids de 0.0001, non appliquée aux et de BN. Toutes les tailles de lot sont entraînées 90 époques, avec un taux d'apprentissage de référence , divisé par 10 aux époques 30, 60 et 80 ; pour et , on retrouve le 0.1 d'origine.
Un autre détail concerne l'initialisation, où le du dernier BN de chaque bloc résiduel est initialisé à 0, pour qu'au départ le signal ne passe que par le raccourci. Les auteurs constatent que cela aide tous les modèles, et surtout les grands lots.
L'aléa est aussi pris en compte. Pour chaque modèle, on prend la médiane de l'erreur sur les 5 dernières époques, puis on rapporte la moyenne et l'écart-type de 5 entraînements indépendants. L'erreur de référence (lot de 256) est de 23.60 % ± 0.12. Au-delà de 12k, à cause des limites matérielles, les lots sont simulés sur un seul serveur par accumulation de gradients ; les auteurs indiquent avoir vérifié que les résultats sont équivalents à ceux d'un vrai entraînement distribué.
Trois échauffements
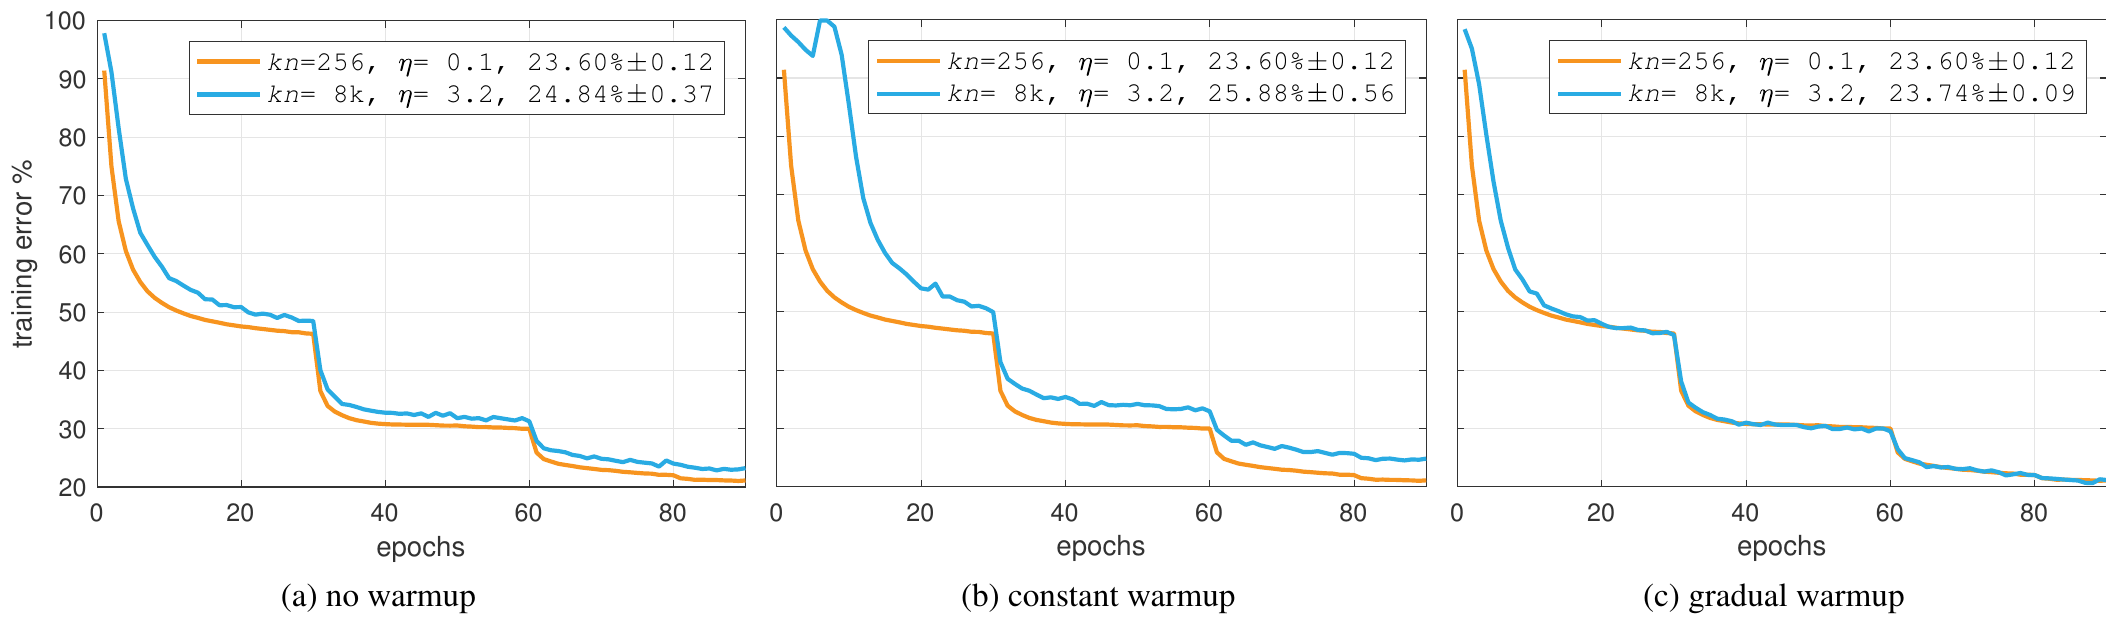
Dans les trois graphiques, la courbe orange est la référence avec un lot de 256, la bleue un lot de 8k avec un taux d'apprentissage de 3.2. Les pourcentages de la légende sont des erreurs de validation.
- Sans échauffement (a) : la courbe bleue est au-dessus de l'orange du début à la fin. L'erreur d'entraînement finale est plus haute d'environ 2.1 points de pourcentage, et l'erreur de validation d'environ 1.2 point (24.84 %). Les auteurs en déduisent que la hausse de l'erreur de validation vient surtout de l'erreur d'entraînement, et non du surapprentissage.
- Échauffement constant (b) : le faible taux des 5 premières époques fait bien baisser l'erreur, mais dès le passage à 3.2, l'erreur monte brutalement, et n'est ensuite jamais entièrement rattrapée ; l'erreur de validation est même la pire des trois (25.88 %).
- Échauffement progressif (c) : au début, la courbe bleue est plus haute à cause du faible taux, puis rejoint l'orange après environ 20 époques ; l'erreur de validation est de 23.74 %, à 0.14 point seulement de la référence, alors que l'écart-type lui-même est d'environ 0.1.
Que même les courbes d'entraînement coïncident, l'article y insiste à plusieurs reprises. Les auteurs en tirent que la difficulté des grands lots tient surtout à l'optimisation, et que tant que l'erreur d'entraînement suit, on ne voit, dans cette plage, aucun signe de dégradation de la généralisation.
8k, le plafond
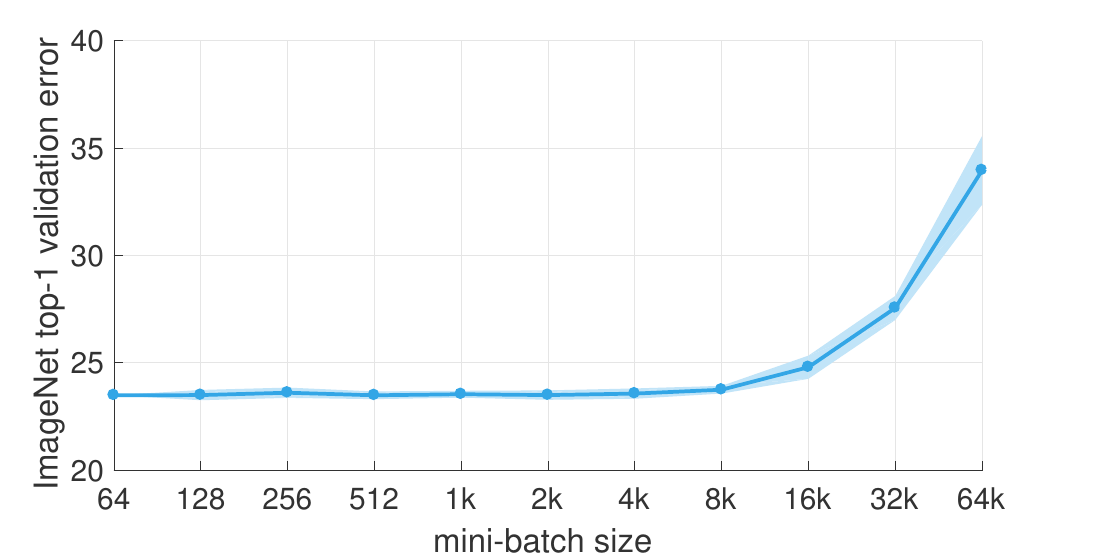
Tous les lots utilisent la règle de mise à l'échelle linéaire, et ceux de plus de 256 y ajoutent 5 époques d'échauffement progressif. De 64 à 8k, l'erreur forme presque une droite horizontale ; au-delà de 8k, elle commence à monter, 24.79 % à 16k, 27.55 % à 32k, 33.96 % à 64k. Plus loin encore, l'entraînement avec la règle linéaire diverge purement et simplement.
Les courbes d'entraînement montrent aussi la différence.
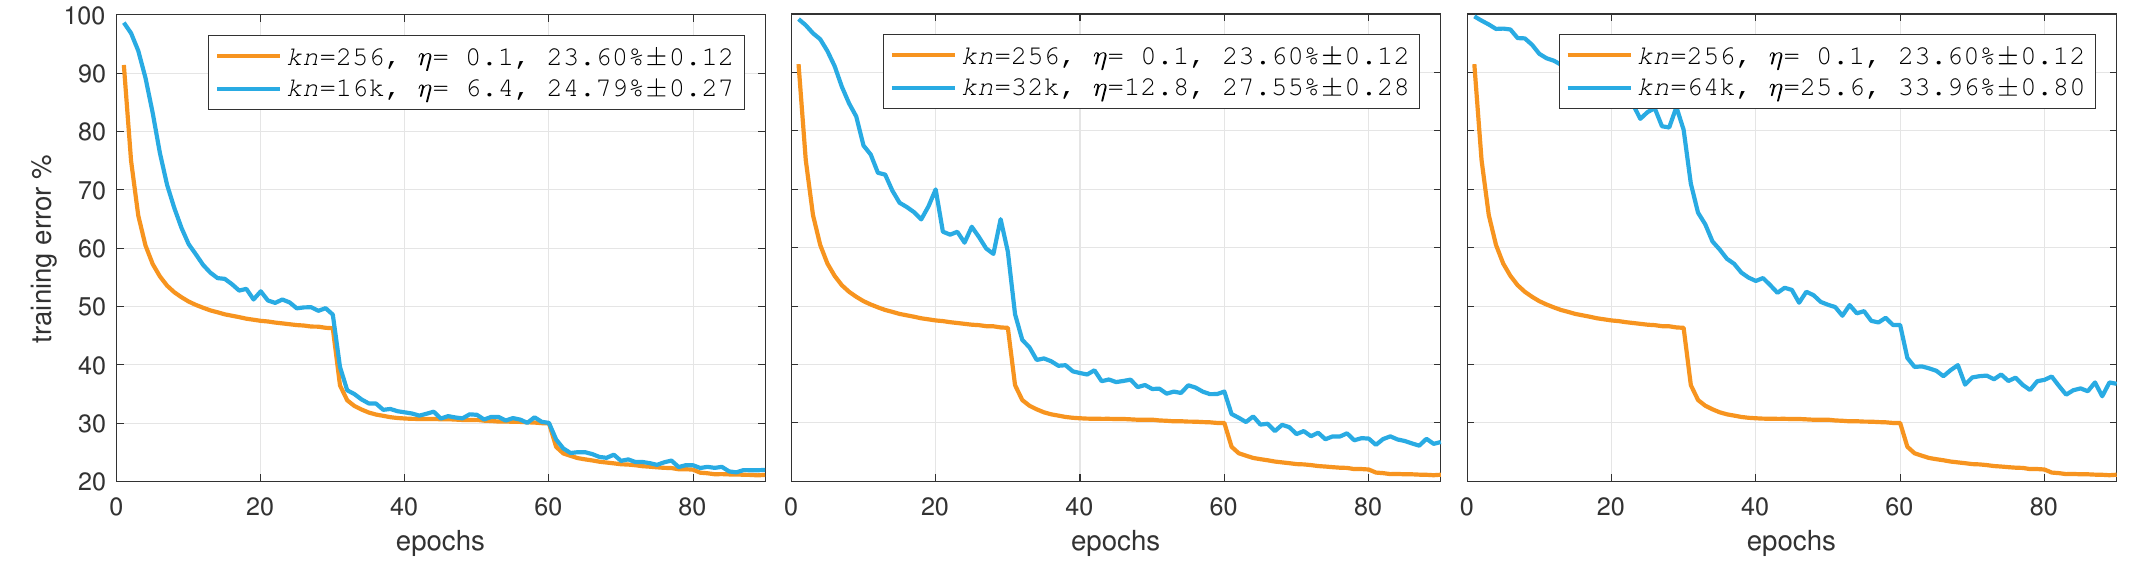
Jusqu'à 8k, en dehors de la phase d'échauffement, les courbes d'entraînement se superposent toutes à la référence. À partir de 16k, un écart net subsiste entre les deux courbes pendant tout l'entraînement. Les auteurs conseillent donc, pour comparer un nouveau réglage, de se servir de la courbe d'entraînement comme indicateur précoce ; si les courbes ne coïncident pas, l'erreur de validation finale ne coïncidera probablement pas non plus.
Pour ResNet-101, la situation est semblable. L'erreur avec un lot de 8k est de 22.36 %, 0.28 point au-dessus des 22.08 % du lot de 256 ; les auteurs estiment que 8k est déjà à la limite pour ResNet-101. L'entraînement sur 256 P100 prend 92.5 minutes.
Le plafond monte-t-il quand les données augmentent ? Les auteurs passent à ImageNet-5k, qui ajoute 4 000 classes tirées d'ImageNet-22k, soit 6.8 millions d'images au total, environ 5 fois plus qu'au départ ; l'évaluation reste une classification à 1 000 classes sur le jeu de validation d'ImageNet-1k. La courbe d'erreur a presque exactement la même forme que sur ImageNet-1k ; le lot de 8k n'est que 0.26 point au-dessus du lot de 256 (de 25.83 % à 26.09 %), et le point de bascule ne se décale pas vers les plus grands lots. Avec 5 fois plus de données, le lot utilisable n'a pas grandi pour autant.
Autres règles de mise à l'échelle
La règle linéaire est-elle justement la meilleure ? Les auteurs essaient plusieurs taux d'apprentissage, avec des lots de 256 et de 8k :
| Lot | Taux d'apprentissage η | Erreur top-1 |
|---|---|---|
| 256 | 0.05 | 23.92 |
| 256 | 0.10 | 23.60 |
| 256 | 0.20 | 23.68 |
| 8k | 0.05 · 32 | 24.27 |
| 8k | 0.10 · 32 | 23.74 |
| 8k | 0.20 · 32 | 24.05 |
| 8k | 0.10 | 41.67 |
| 8k | 0.10 · √32 | 26.22 |
D'après la Table 2a de l'article ; ResNet-50, moyenne de 5 entraînements (%).
Le meilleur taux est 0.1 pour le lot de 256, et 0.1 × 32 = 3.2 pour le lot de 8k, exactement la valeur donnée par la règle linéaire. Si le taux d'apprentissage ne suit pas le lot (0.10), l'erreur grimpe à 41.67 %. Krizhevsky avait dérivé une règle en racine carrée à partir de l'écart-type de l'estimation du gradient ; avec et le même échauffement progressif, l'erreur reste de 26.22 %.
Le lot de 8k est aussi plus sensible au taux d'apprentissage que celui de 256. Quand le multiplicateur passe de 0.1 à 0.05 ou 0.2, le lot de 256 ne varie que de 0.1 à 0.3 point, celui de 8k de 0.3 à 0.5 point. Les auteurs conseillent, en pratique, de ne pas choisir un lot proche du point de rupture.
Le γ = 0 des blocs résiduels
Initialiser à 0 le du dernier BN de chaque bloc résiduel fait passer l'erreur de 23.84 % à 23.60 % avec un lot de 256, et de 24.11 % à 23.74 % avec un lot de 8k ; les grands lots en profitent davantage, ce qui montre aussi, selon les auteurs, qu'ils sont plus exposés aux difficultés d'optimisation. Cette astuce a ensuite rejoint torchvision, dont le constructeur de ResNet a un paramètre zero_init_residual ; le commentaire du code cite cet article, et indique une amélioration de 0.2 à 0.3 point de pourcentage.
Transfert vers la détection et la segmentation
La précision sur ImageNet n'est généralement pas une fin en soi ; ce qui compte, c'est que les caractéristiques préentraînées servent à d'autres tâches. Les auteurs utilisent les ResNet-50 préentraînés avec des lots de 256 à 16k pour initialiser Mask R-CNN, et font de la détection d'objets et de la segmentation d'instances sur COCO. Pour chaque taille de lot, ils préentraînent 5 modèles, soit 35 Mask R-CNN au total, avec tous les autres hyperparamètres identiques à ceux de l'article Mask R-CNN.
| Lot de préentraînement | Erreur top-1 | box AP | mask AP |
|---|---|---|---|
| 256 | 23.60 | 35.9 | 33.9 |
| 1k | 23.53 | 35.9 | 33.9 |
| 4k | 23.56 | 35.8 | 33.8 |
| 8k | 23.74 | 35.8 | 33.9 |
| 16k | 24.79 | 35.1 | 33.2 |
D'après la Table 3a de l'article, dont seules certaines lignes sont reprises ; COCO minival, moyenne de 5 exécutions (%).
Tant que l'erreur sur ImageNet se maintient (jusqu'à 8k), les AP de détection et de segmentation sont presque identiques ; à 16k, l'erreur sur ImageNet monte, et l'AP sur COCO baisse avec elle de 0.7 à 0.8 point de pourcentage.
La règle linéaire elle-même s'applique aussi à Mask R-CNN. La notion de lot y est différente de celle de la classification ; le backbone traite 2 images par carte, et sur chaque image, on prend 512 RoI pour calculer trois pertes, classification, régression des boîtes et masque. Les auteurs entraînent sur 1, 2, 4 et 8 cartes, avec un taux d'apprentissage proportionnel au nombre de cartes (de 0.0025 à 0.02) ; le box AP est entre 35.6 et 35.7, le mask AP entre 33.5 et 33.7, presque sans différence. Le texte original note aussi que la configuration par défaut de Mask R-CNN sur 8 cartes appliquait déjà discrètement cette règle.
Quelle vitesse ?
En passant d'un lot de 256 à 11k (44 fois plus), le temps par pas n'augmente que de 12 % ; par époque, on passe de plus de 16 minutes à environ 30 secondes, avec alors 352 cartes (44 serveurs). Par rapport à l'extrapolation idéale de la référence à 8 cartes, l'efficacité du passage de 8 à 256 cartes est d'environ 90 %, et ce avec un Ethernet ordinaire.
La suite
Le plafond de 8k a vite été contesté. Deux mois plus tard, dans le résumé de l'article LARS, You et al. écrivent sans détour que l'approche de la mise à l'échelle linéaire avec échauffement n'est pas assez générale, et que l'entraînement peut diverger ; ils ajustent plutôt le taux d'apprentissage couche par couche, et poussent le lot de ResNet-50 jusqu'à 32k.
Shallue et al. (JMLR 2019) mesurent systématiquement, sur 35 charges de travail, la relation entre taille de lot et nombre de pas d'entraînement ; ils constatent que la plage de mise à l'échelle parfaite, « lot doublé, pas divisés par deux », varie énormément d'une tâche à l'autre, et que le meilleur taux d'apprentissage ne suit pas forcément une règle linéaire ou en racine carrée ; ils ne trouvent en revanche aucune preuve que les grands lots nuisent à la généralisation. Au regard de ces résultats, la règle linéaire convient plutôt comme règle empirique à l'intérieur de la plage de mise à l'échelle parfaite ; au-delà, il faut régler à nouveau.
L'échauffement, lui, est resté, et s'est répandu bien au-delà des grands lots. Les Transformers entraînés avec Adam en ont presque toujours besoin ; plus tard, Pre-LN et RAdam en ont chacun proposé une explication.
Conclusion
Cet article pousse le lot de ResNet-50 de 256 à 8k grâce à trois choses, un taux d'apprentissage qui croît linéairement avec le lot, un échauffement progressif sur les 5 premières époques, et un BN calculé sur chaque carte avec 32 exemples fixes. L'erreur avec un lot de 8k, 23.74 %, est à environ un écart-type des 23.60 % du lot de 256 ; les courbes d'entraînement coïncident, et le transfert vers la détection et la segmentation ne se dégrade pas. Au-delà de 8k, la même méthode commence à échouer.
Quand on passe réellement d'une carte à huit, c'est plutôt la section 3 de l'article qui sert le plus. Une fois le taux d'apprentissage multiplié par le nombre de cartes et l'échauffement ajouté, il faut encore vérifier si la perte est divisée par le lot total ou par le lot d'une seule carte, si c'est bien le taux d'apprentissage qui est mis à l'échelle, et pas seulement la perte (ce qui fausserait la décroissance des poids), et si le tampon de momentum du framework intègre le taux d'apprentissage. Avec une erreur à ces endroits, le modèle converge quand même, simplement avec une erreur un peu plus élevée, ce qui est très difficile à remarquer.
Cinq mois plus tard, l'article de Preferred Networks s'intitule « Extremely Large Minibatch SGD: Training ResNet-50 on ImageNet in 15 Minutes », avec 1 024 P100 et un lot de 32k. (Le titre est presque recopié, Accurate devenu Extremely, et 1 Hour devenu 15 Minutes.)