Article original
SportsMOT: A Large Multi-Object Tracking Dataset in Multiple Sports Scenes
- Publication
- ICCV 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2304.05170
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingsportsmot2023,
  title = {{SportsMOT: A Large Multi-Object Tracking Dataset in Multiple Sports Scenes}},
  author = {Yutao Cui and Chenkai Zeng and Xiaoyu Zhao and Yichun Yang and Gangshan Wu and Limin Wang},
  year = {2023},
  eprint = {2304.05170},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2304.05170}
}
Sur les images télévisées d'un match, le traqueur n'a pas à suivre tout le monde. Spectateurs, arbitres, entraîneurs au bord du terrain, on peut tous les ignorer ; seuls comptent les joueurs sur le terrain. Une fois ceux-ci suivis, on peut calculer la distance parcourue par chacun et sa vitesse moyenne, puis passer à l'analyse tactique.
Les jeux de données de suivi de l'époque avaient pour la plupart été construits pour la vidéosurveillance ou la conduite autonome, avec des piétons et des véhicules dans la rue, et presque toutes les personnes à l'image à suivre. DanceTrack était bien passé à la scène, mais ses danseurs sont presque impossibles à distinguer les uns des autres, ce qui ne correspond pas non plus à la situation d'un terrain de sport.
Yutao Cui, Chenkai Zeng, Xiaoyu Zhao, Yichun Yang et leurs collègues, de l'équipe de Limin Wang à l'Université de Nanjing, ont donc construit SportsMOT, un jeu de données de suivi dédié aux scènes sportives, et proposé MixSort, un cadre qui renforce l'association par l'apparence des traqueurs existants.
Définir le problème
Pour les auteurs, les trois composants des traqueurs dominants, détection, association par le mouvement et association par l'apparence, ont tous été biaisés par la distribution de jeux de données comme MOT17, MOT20 et DanceTrack, et fonctionnent mal une fois transposés sur un terrain de sport.
Détection. Les jeux de données de piétons demandent de détecter presque toutes les personnes à l'image ; sur un terrain de sport, seuls les joueurs comptent, d'où le besoin d'un détecteur entraîné spécialement.
Mouvement. Les piétons de MOT17 et MOT20 marchent lentement et en ligne droite ; prédire leur position avec un filtre de Kalman puis calculer l'IoU suffit largement. Les danseurs de DanceTrack changent souvent de direction et de position relative, mais sans aller vite. Les sportifs, eux, vont vite et changent sans cesse d'allure : sprints, arrêts brusques, virages serrés, avec d'une image à l'autre de grands déplacements, très difficiles à prédire.
Apparence. Les piétons de MOT17 et MOT20 ont des silhouettes et des tenues différentes, faciles à distinguer ; les danseurs de DanceTrack sont habillés presque exactement pareil. Les sportifs se situent entre les deux. Les joueurs d'une même équipe portent le même maillot, et deviennent flous quand ils bougent vite ou que la caméra bouge vite ; mais les maillots portent des numéros, et chacun a une posture un peu différente. Les auteurs appellent cela « similaires mais distinguables ».
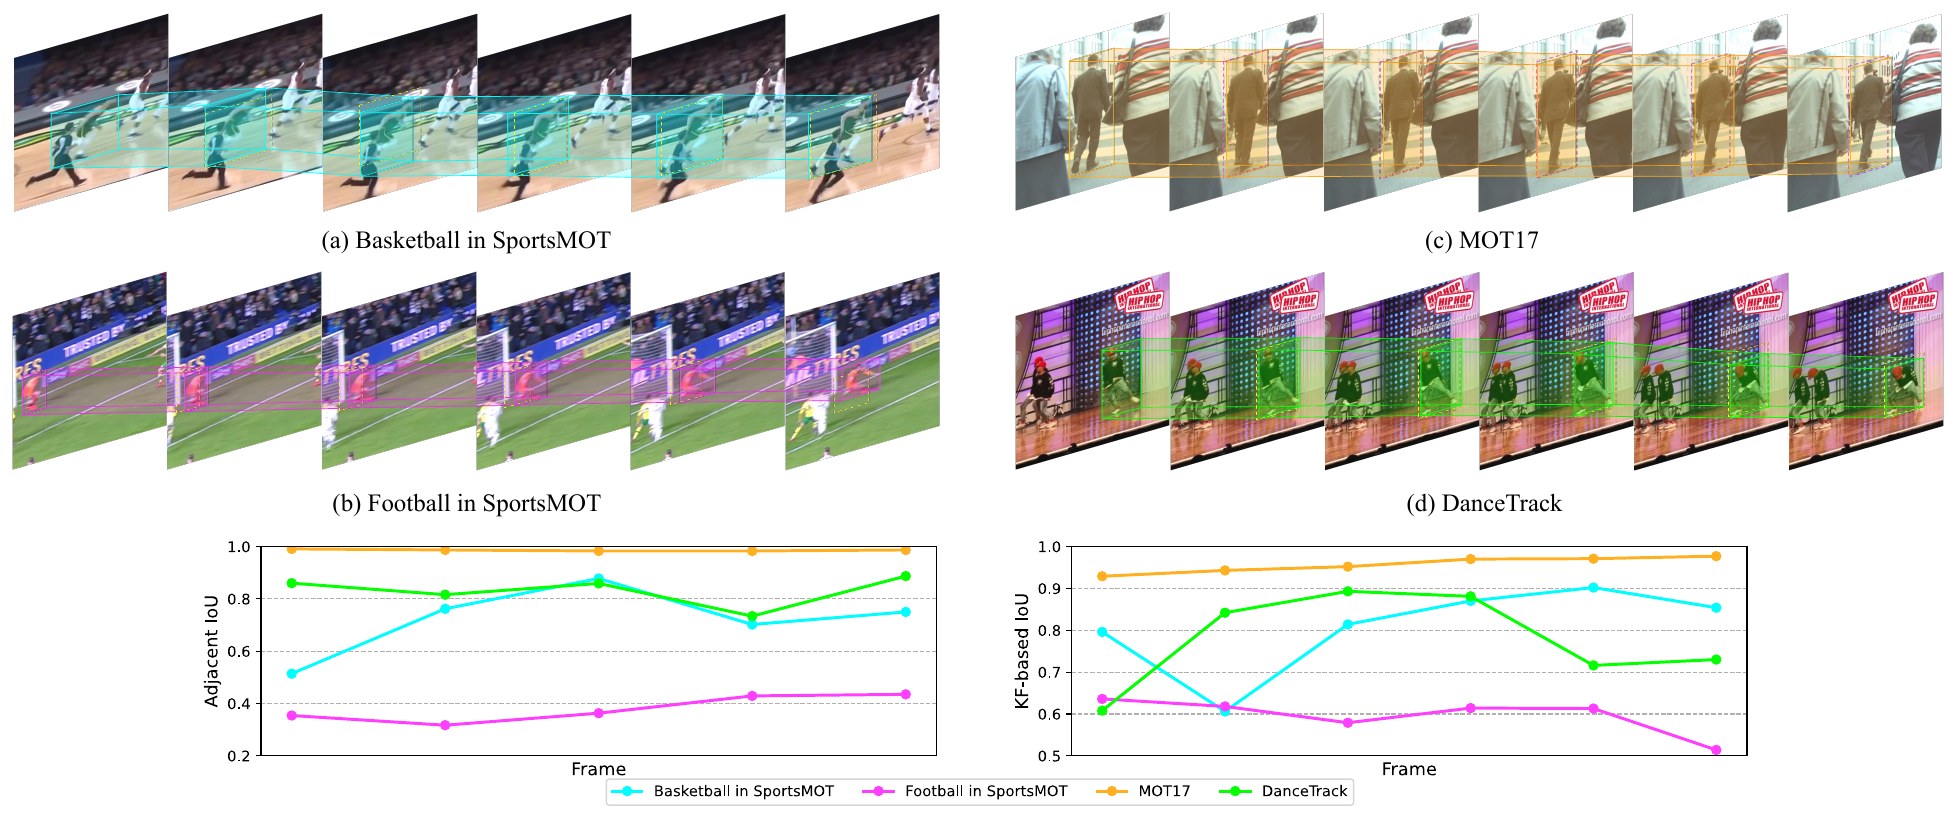
La moitié haute montre les quatre séquences. Dans celle du football, on voit la boîte d'un même joueur faire de grands bonds d'une image à l'autre. En bas, les deux courbes le chiffrent, avec pour le football un IoU entre images consécutives de seulement 0.3 à 0.45, et de 0.5 à 0.65 après prédiction par filtre de Kalman, alors que pour les piétons de MOT17, il est presque toujours proche de 1.
Résoudre le problème
D'où viennent les données
Les auteurs choisissent trois sports connus du monde entier, le basket-ball, le volley-ball et le football ; les vidéos proviennent d'un autre jeu de données d'actions sportives, MultiSports, dont les sources comprennent des matchs professionnels de la NCAA, de la Premier League et des Jeux olympiques. Chaque sport a ses formations et ses schémas de déplacement typiques.
La sélection obéit à quelques conditions :
- Seuls les plans de retransmission en plongée sont retenus, pour éviter certaines images extrêmes.
- Toutes les vidéos sont en 720p, à 25 images par seconde.
- Chaque vidéo a été vérifiée à la main ; aucun extrait ne contient de changement brusque de point de vue.
Les règles d'annotation sont, elles aussi, taillées sur mesure pour les scènes sportives :
- La boîte englobe les membres et le torse du joueur ; le ballon, même au contact du corps, n'en fait pas partie.
- Quand un joueur est occulté, tant qu'une partie de son corps reste visible, il faut inférer sa boîte complète.
- Si plus de la moitié du torse est hors champ, le joueur n'est pas annoté.
- Chaque joueur n'a qu'un seul ID sur toute la vidéo.
L'annotation se fait avec un outil maison. Quand un annotateur commence à annoter un nouveau joueur, l'outil lui attribue automatiquement un nouvel ID et propage la boîte à l'image suivante avec le traqueur mono-objet KCF ; l'annotateur la corrige ensuite. Une fois tout annoté, une passe de relecture corrige les boîtes et les ID non conformes ; enfin, les boîtes de moins de 5 pixels de large ou de haut sont supprimées.
Taille
| Jeu de données | Vidéos | Images | Durée (s) | Boîtes | Traj. |
|---|---|---|---|---|---|
| MOT17 | 14 | 11 235 | 463 | 292 733 | 1 342 |
| MOT20 | 8 | 13 410 | 535 | 1 652 040 | 3 456 |
| DanceTrack | 100 | 105 855 | 5 292 | — | 990 |
| SportsMOT | 240 | 150 379 | 6 015 | 1 629 490 | 3 401 |
D'après la Table 1 de l'article.
SportsMOT compte 13.4 fois plus d'images que MOT17, et à peu près autant de boîtes que MOT20, mais réparties sur 240 vidéos. L'entraînement, la validation et le test en comptent respectivement 45, 45 et 150 ; l'ensemble de test en représente la majeure partie.
Les trois sports diffèrent aussi beaucoup :
| Sport | Images | Traj. | Long. traj. | Long. interr. | Boîtes par image |
|---|---|---|---|---|---|
| Basket-ball | 845.4 | 10 | 767.9 | 68.7 | 9.1 |
| Volley-ball | 360.4 | 12 | 335.9 | 38.2 | 11.2 |
| Football | 673.9 | 20.5 | 422.1 | 116.1 | 12.8 |
D'après la Table 2 de l'article ; toutes les valeurs sont des moyennes par vidéo, et les longueurs (de trajectoire et d'interruption) sont en images.
Le basket-ball compte en moyenne 10 trajectoires par vidéo, soit exactement les 10 joueurs sur le terrain, presque toujours présents à l'image du début à la fin. Le terrain de football est grand, et la caméra ne filme qu'une partie des joueurs ; on compte en moyenne 20.5 trajectoires par vidéo, et les interruptions sont aussi les plus longues, les joueurs sortant souvent du champ avant d'y revenir.
Deux propriétés, chacune mesurée
Les auteurs quantifient ces deux propriétés avec trois figures.
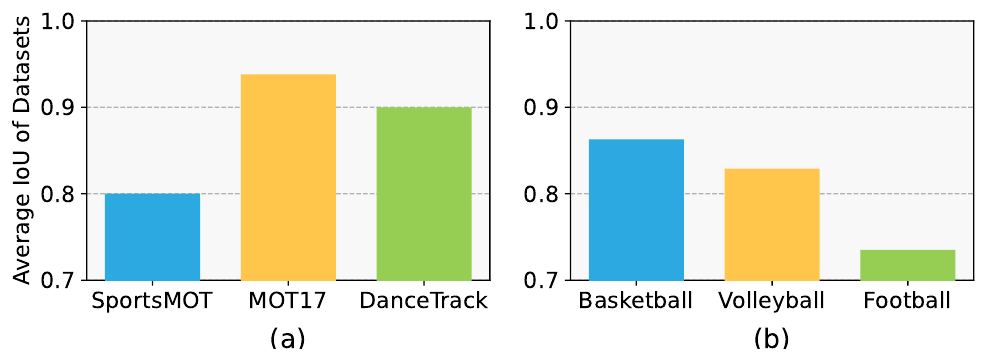
La première mesure la vitesse. Moins les boîtes d'une même personne se recouvrent d'une image à la suivante, plus elle se déplace vite. SportsMOT est le plus bas des trois jeux de données, à environ 0.80 ; et parmi les trois sports, c'est le football qui est le plus bas, à environ 0.74.
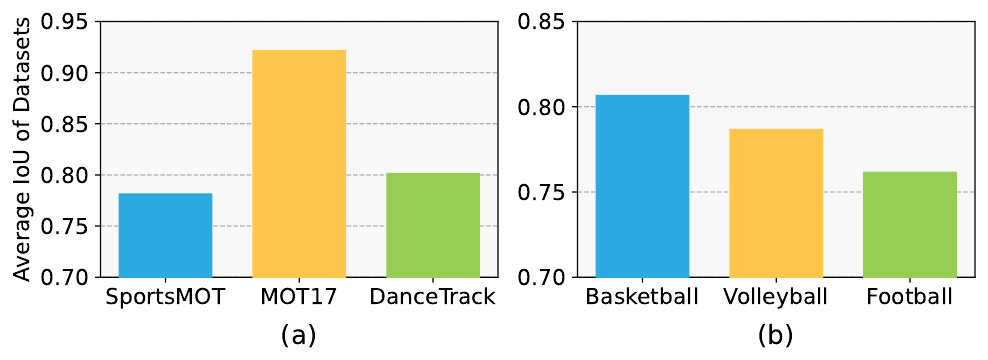
La deuxième mesure la prévisibilité du mouvement. Les auteurs font prédire l'image suivante par un filtre de Kalman à partir des boîtes de vérité terrain des images précédentes, puis calculent l'IoU avec la vraie image suivante. Si le mouvement était à vitesse constante, la prédiction devrait être très juste, et l'IoU proche de 1. SportsMOT est là encore le plus bas, à environ 0.78, proche de DanceTrack ; MOT17 atteint 0.92. Les auteurs l'attribuent aux changements de vitesse. Face aux accélérations et aux arrêts brusques, l'hypothèse de vitesse constante ne suit pas.
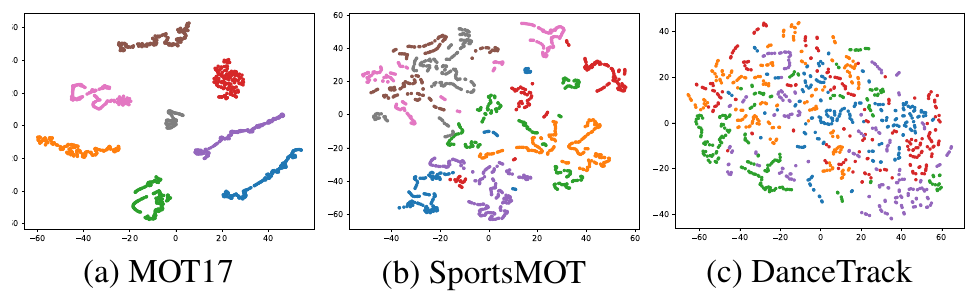
La troisième porte sur l'apparence. Une fois les caractéristiques re-ID projetées dans le plan par t-SNE, chaque personne de MOT17 forme son propre groupe, tout le monde est mélangé dans DanceTrack, et SportsMOT se situe entre les deux. Voilà ce que veut dire « similaires mais distinguables ».
Côté métriques, les auteurs recommandent de s'appuyer principalement sur HOTA, AssA et IDF1, et de ne pas classer les méthodes selon MOTA, qui privilégie la détection.
MixSort : un traqueur mono-objet pour comparer les apparences
Puisque les sportifs sont « distinguables », l'apparence devrait servir. Mais les caractéristiques re-ID habituelles condensent chaque boîte séparément en un vecteur, puis comparent des distances. L'idée des auteurs est d'emprunter la démarche des traqueurs mono-objet, qui prennent directement le gabarit (template) de la trajectoire pour aller chercher la personne dans la nouvelle image.
Ils reprennent MixFormer, un traqueur mono-objet proposé plus tôt par la même équipe, et le transforment en un module d'association par l'apparence qui se greffe sur des traqueurs de type « détecter puis associer » comme ByteTrack ou OC-SORT ; le tout s'appelle MixSort.
Pour chaque trajectoire, la procédure est la suivante :
- Prédire sa position dans l'image courante avec le filtre de Kalman, et découper autour de cette position une zone de recherche de 224 × 224.
- Envoyer la zone de recherche et le gabarit de la trajectoire (96 × 96) ensemble dans MixFormer, qui produit une carte de chaleur indiquant, pour chaque position de la zone de recherche, à quel point elle ressemble au centre du gabarit.
- Pour une boîte de détection dont le centre tombe dans la zone de recherche, la valeur de la carte de chaleur en son centre sert de similarité d'apparence ; si le centre tombe hors de la zone, la similarité vaut 0.
On obtient ainsi une matrice de similarité d'apparence , combinée à la matrice d'IoU par une somme pondérée :
L'appariement final se fait avec l'algorithme hongrois.
Pour l'adapter au suivi multi-objets, les auteurs apportent quelques modifications. MixFormer prédisait à l'origine les coins supérieur gauche et inférieur droit de la cible avec une tête de coins ; ici, une tête de carte de chaleur prédit le centre de la cible, et le module d'attention mixte passe de 12 à 4 couches pour gagner en vitesse. Chaque trajectoire ne garde qu'un gabarit ; quand elle est appariée à une nouvelle détection, le gabarit n'est mis à jour que si la part de cette détection non cachée par d'autres détections est assez grande, pour éviter qu'une image occultée ne pollue le gabarit.
À l'entraînement, la trajectoire de chaque joueur est convertie au format des données de suivi mono-objet ; la vérité terrain de la carte de chaleur du centre est générée par une gaussienne, et l'entraînement utilise la focal loss. MixFormer part de poids déjà entraînés sur des données de suivi mono-objet, puis est affiné pendant 300 epochs sur SportsMOT. Le détecteur reprend le YOLOX de ByteTrack, entraîné d'abord sur CrowdHuman, puis sur SportsMOT.
Discussion
La difficulté est dans l'association
Les auteurs réentraînent et testent plusieurs traqueurs courants sur SportsMOT :
| Méthode | HOTA | AssA | DetA | IDF1 |
|---|---|---|---|---|
| FairMOT | 49.3 | 34.7 | 70.2 | 53.5 |
| GTR | 54.5 | 45.9 | 64.8 | 55.8 |
| QDTrack | 60.4 | 47.2 | 77.5 | 62.3 |
| CenterTrack | 62.7 | 48.0 | 82.1 | 60.0 |
| TransTrack | 68.9 | 57.5 | 82.7 | 71.5 |
| ByteTrack | 64.1 | 52.3 | 78.5 | 71.4 |
| OC-SORT | 73.7 | 61.5 | 88.5 | 74.0 |
| MixSort-Byte | 65.7 | 54.8 | 78.8 | 74.1 |
| MixSort-OC | 74.1 | 62.0 | 88.5 | 74.4 |
D'après la Table 3 de l'article, ensemble de test. Les cinq premières méthodes n'utilisent que l'ensemble d'entraînement ; ByteTrack, OC-SORT et les deux MixSort utilisent l'entraînement et la validation.
Le DetA de la détection se situe pour l'essentiel entre 77 et 88, alors que l'AssA de l'association tombe entre 35 et 62. Les auteurs en concluent que le principal défi de SportsMOT est l'association, pas la détection. Les joueurs sont nets à l'image et la scène n'est pas bondée ; il suffit au détecteur d'apprendre à ne pas encadrer les spectateurs et les arbitres pour bien faire.
MixSort aide les deux traqueurs de base. Ajouté à ByteTrack, il apporte 1.6 point de HOTA et 2.7 points d'IDF1 ; ajouté à OC-SORT, seulement 0.4. Le HOTA des différentes méthodes s'étale de 49 à 74, un écart considérable ; pour les auteurs, c'est le signe que SportsMOT départage mieux les algorithmes.
Le filtre de Kalman, un boulet au pied
Le résultat le plus surprenant de l'article est l'ablation de MixSort-Byte :
| IoU | Préd. Kalman | MixSort | HOTA | AssA | IDF1 |
|---|---|---|---|---|---|
| ✓ | 71.5 | 58.1 | 71.2 | ||
| ✓ | 64.2 | 48.7 | 63.9 | ||
| ✓ | ✓ | 64.1 | 52.3 | 71.4 | |
| ✓ | ✓ | 73.8 | 61.6 | 74.4 | |
| ✓ | ✓ | ✓ | 65.7 | 54.8 | 74.1 |
D'après la Table 6 de l'article, ensemble de test de SportsMOT. Dans les lignes sans prédiction de Kalman, l'IoU est calculé directement entre la dernière position de la trajectoire et la boîte de détection.
Les première et troisième lignes ne diffèrent que par la prédiction préalable de la position avec un filtre de Kalman. Sans prédiction, en calculant l'IoU directement avec la boîte de l'image précédente, le HOTA est de 71.5 ; avec la prédiction du filtre de Kalman, il tombe au contraire à 64.1.
Un filtre de Kalman qui suppose un mouvement à vitesse constante se trompe tellement sur les sportifs qu'il vaut mieux ne rien prédire du tout. La meilleure combinaison du tableau est l'IoU plus MixSort, sans filtre de Kalman, avec un HOTA de 73.8, 8 points au-dessus du MixSort-Byte (65.7) que les auteurs rapportent dans leur tableau principal.
Avec la seule apparence de MixSort, sans regarder du tout la position, le HOTA n'est que de 64.2, et les changements d'identité grimpent à 25 947 (contre 4 329 avec l'IoU seul). L'apparence permet de distinguer les joueurs, mais elle ne suffit pas à elle seule.
Quand l'apparence sert-elle ?
Sur OC-SORT plus MixSort, les auteurs font varier le poids de fusion et observent la réaction de chacun des trois sports. correspond au mouvement seul, à l'apparence seule :
| Sport | Mouvement seul | Meilleure fusion | Apparence seule |
|---|---|---|---|
| Basket-ball | 65.9 | 66.2 (α = 0.8) | 26.9 |
| Volley-ball | 76.0 | 76.9 (α = 0.5) | 40.9 |
| Football | 71.9 | 73.2 (α = 0.4) | 65.7 |
D'après la Table 4 de l'article, ensemble de test de SportsMOT, HOTA.
Pour les trois sports, c'est la fusion qui l'emporte, et le mouvement seul fait toujours mieux que l'apparence seule. Le gain apporté par l'apparence est le plus fort pour le football (+1.3), puis pour le volley-ball (+0.9), et le plus faible pour le basket-ball (+0.3). Si l'on se reporte aux figures précédentes, le football a l'IoU entre images consécutives le plus bas et les mouvements les plus rapides. Les auteurs en concluent que plus une scène est rapide, plus elle a besoin d'indices d'apparence ; le optimal baisse en conséquence, et le football ne donne au mouvement qu'un poids de 0.4.
Le basket-ball est le plus difficile des trois. Son meilleur HOTA n'est que de 66.2, et tombe à 26.9 avec l'apparence seule. Les auteurs supposent que, sur un petit terrain où les contacts physiques sont nombreux, occultations et flou sont plus marqués.
Face à DanceTrack et SoccerNet
Sur l'ensemble de validation de DanceTrack, MixSort-Byte obtient un HOTA de 46.7, contre 47.1 pour le ByteTrack d'origine ; ajouter l'apparence dégrade même légèrement le résultat. Les danseurs sont trop difficiles à distinguer, et le module d'apparence n'y peut rien. Sur SportsMOT, les joueurs se ressemblent mais restent distinguables, et il faut se servir à la fois des indices de mouvement et d'apparence.
SoccerNet, un autre jeu de données de suivi sportif, ne filme que du football, et demande de suivre tous les éléments du terrain, joueurs, gardiens, arbitres et ballon. MixSort-Byte y obtient un HOTA de 62.9, avec un DetA de seulement 71.5, inférieur aux 78.8 de SportsMOT, car les objets à détecter sont plus hétéroclites ; mais son AssA, 55.5, est au contraire légèrement supérieur aux 54.8 de SportsMOT. Les auteurs en déduisent que l'association est plus difficile sur SportsMOT.
Enfin, les auteurs comparent MixSort à un modèle re-ID classique. Ajouter à ByteTrack le modèle re-ID de DeepSORT, affiné sur SportsMOT, fait passer le HOTA de 64.1 à 64.8 ; avec MixSort, il atteint 65.7. Les indices d'apparence sont bel et bien utiles, et comparer les apparences avec un traqueur mono-objet fait encore un peu mieux.
Conclusion
Avec 240 vidéos de retransmissions de matchs professionnels, SportsMOT propose une situation de suivi différente de celle des piétons comme de celle des danseurs ; les joueurs courent vite, changent de vitesse, et ont une apparence similaire mais distinguable. Les auteurs quantifient ces deux propriétés par l'IoU entre images consécutives, l'IoU après prédiction de Kalman et la distribution des caractéristiques re-ID, et montrent que la difficulté tient surtout à l'association.
MixSort prouve que les indices d'apparence servent vraiment sur un terrain de sport, mais ce qu'il faut surtout retenir de l'article, c'est ce tableau d'ablation. Sur des sportifs, le filtre de Kalman à vitesse constante, loin d'aider, fait perdre 7.4 points de HOTA.
Deux mois plus tard, Deep-EIoU, qui s'attaque lui aussi aux scènes sportives, supprime purement et simplement le filtre de Kalman et atteint un HOTA de 77.2 sur SportsMOT. Une revue de 2025 sur le suivi multi-objets range d'ailleurs SportsMOT aux côtés de MOT17, MOT20 et DanceTrack parmi les quatre jeux de données de référence.
Sur le terrain, tous les joueurs portent le même maillot ; heureusement, il y a un numéro dans le dos.