Article original
MOT20: A benchmark for multi object tracking in crowded scenes
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2003.09003
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingmot202020,
  title = {{MOT20: A benchmark for multi object tracking in crowded scenes}},
  author = {Patrick Dendorfer and Hamid Rezatofighi and Anton Milan and Javen Shi and Daniel Cremers and Ian Reid and Stefan Roth and Konrad Schindler and Laura Leal-Taixé},
  year = {2020},
  eprint = {2003.09003},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2003.09003}
}
Si vous avez lu les tableaux principaux de ByteTrack, d'OC-SORT ou de StrongSORT, vous avez forcément vu la colonne MOT20. Elle suit généralement de près celle de MOT17, avec des chiffres globalement plus bas, et des vitesses bien plus lentes.
L'article MOT20 ne fait que 7 pages, dont l'essentiel décrit les règles d'annotation et la méthode d'évaluation, presque identiques à celles de MOT16, quatre ans plus tôt. Ce qui est vraiment nouveau, ce sont 8 vidéos extrêmement bondées.
Les auteurs forment l'équipe qui maintient MOTChallenge, venue de l'Université technique de Munich, de l'Université d'Adélaïde, de l'ETH Zurich et de l'Université technique de Darmstadt. D'après les statistiques de l'article, MOTChallenge compte depuis son lancement en 2014 plus de 1 000 utilisateurs, et ses 5 défis totalisent 44 vidéos et 2.7 millions de boîtes. Les vidéos de MOT20 ont d'abord servi en 2019 à un défi organisé dans le cadre d'un atelier ; cet article en est la description complète, publiée après coup.
Définir le problème
De MOT15 à MOT17, le suivi multi-objets a gagné des données propres et une évaluation cohérente. Mais d'expérience, les auteurs constatent que la plupart des méthodes risquent d'être sur-ajustées à un jeu de données particulier ; placées dans une situation complètement différente, elles ne s'en sortent pas sans une profonde révision de leurs paramètres, voire un changement de modèle.
La foule est l'une de ces situations encore mal testées. Dès qu'il y a beaucoup de monde, les boîtes rapetissent et s'occultent mutuellement, le détecteur commence à rater des gens, et le traqueur doit distinguer qui est qui dans une masse de boîtes qui se ressemblent toutes. Les auteurs veulent un ensemble de vidéos capable de « pousser les méthodes dans leurs retranchements ».
Résoudre le problème
8 vidéos, 3 scènes
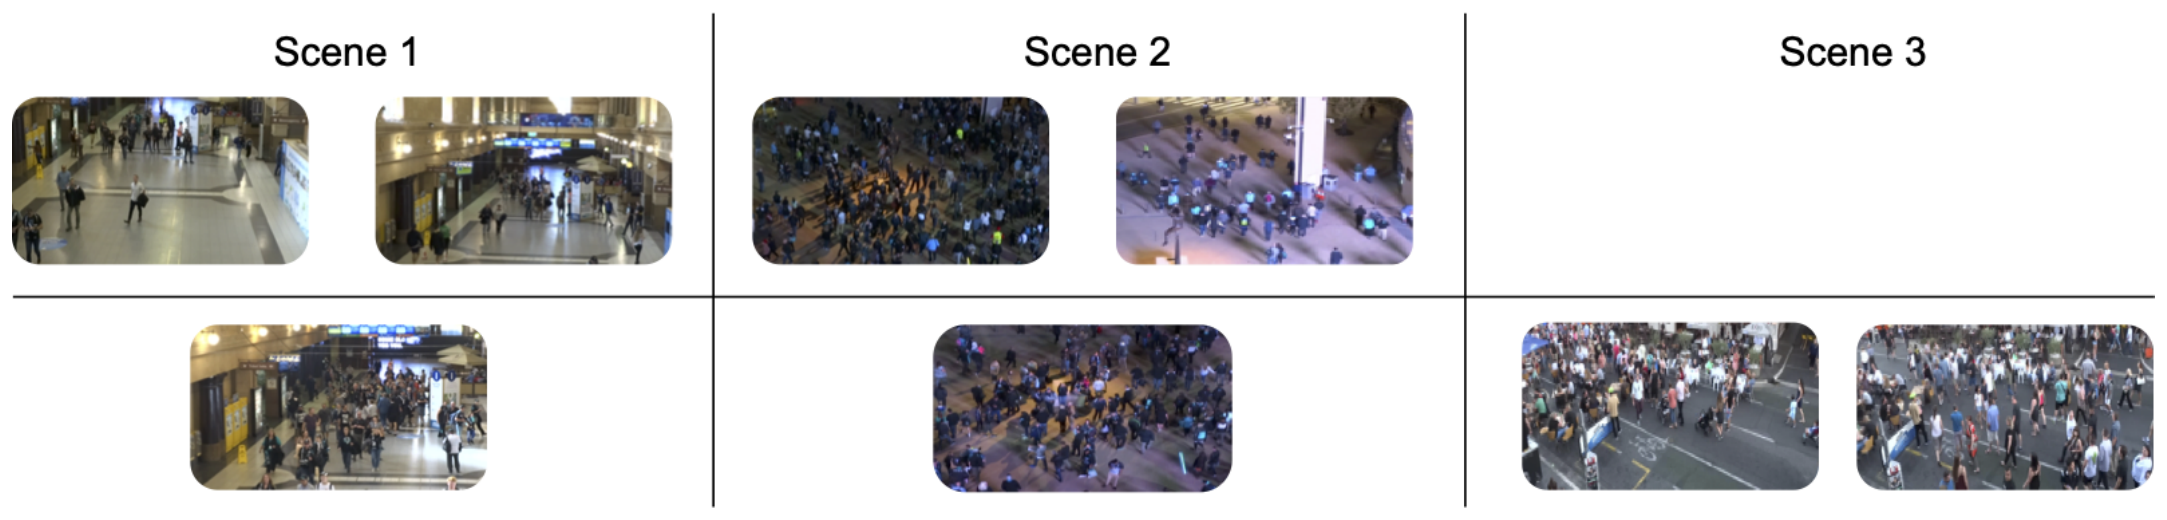
Les 8 vidéos sont filmées dans 3 scènes, 4 pour l'entraînement et 4 pour le test, toutes en plongée depuis un point élevé. Les scènes 1 et 2 apparaissent à l'entraînement comme au test ; la scène 3 n'apparaît qu'au test. Les auteurs gardent délibérément une scène inédite, pour tester si les méthodes se généralisent à un nouvel environnement. Les annotations de test ne sont pas publiques, pour éviter que les méthodes soient réglées au point de coller à des vidéos précises.
Voici les statistiques de chaque vidéo :
| Vidéo | Scène | Résolution | Images | Traj. | Boîtes | Par image |
|---|---|---|---|---|---|---|
| 01 | Intérieur | 1920×1080 | 429 | 74 | 19 870 | 46.3 |
| 02 | Intérieur | 1920×1080 | 2 782 | 270 | 154 742 | 55.6 |
| 03 | Ext., nuit | 1173×880 | 2 405 | 702 | 313 658 | 130.4 |
| 05 | Ext., nuit | 1654×1080 | 3 315 | 1 169 | 646 344 | 195.0 |
| 04 | Ext., nuit | 1545×1080 | 2 080 | 669 | 274 084 | 131.8 |
| 06 | Ext., jour | 1920×734 | 1 008 | 271 | 132 757 | 131.7 |
| 07 | Intérieur | 1920×1080 | 585 | 111 | 33 101 | 56.6 |
| 08 | Ext., jour | 1920×734 | 806 | 191 | 77 484 | 96.1 |
D'après la Table 1 de l'article ; les vidéos de test sont en gras. Toutes les vidéos sont à 25 images par seconde.
Plusieurs points de ce tableau méritent qu'on s'y attarde.
D'abord, les vidéos sont courtes. Les vidéos d'entraînement totalisent moins de 6 minutes, celles de test moins de 3, mais l'ensemble d'entraînement compte 1.13 million de boîtes de piétons, et celui de test en compte encore 520 000.
Ensuite, le jeu de données est dominé par une poignée de vidéos. MOT20-05 compte à elle seule 646 000 boîtes, soit 57 % de tout l'ensemble d'entraînement ; dans l'ensemble de test, MOT20-04 en représente 53 %. MOTChallenge calcule un seul MOTA sur toutes les vidéos de test mises bout à bout ; les performances sur MOT20-04, cette place de nuit, déterminent donc à peu près le score de test. La note sur MOT16 relevait déjà la même situation avec MOT16-03.
Enfin, la scène inédite 3 (MOT20-06 et 08) a une résolution de 1920×734, avec des proportions différentes de toutes les autres vidéos.
Combien de personnes par image en moyenne ?
L'article et les travaux qui l'ont cité donnent plusieurs chiffres pour dire « à quel point c'est bondé ». Le corps de l'article dit que la densité peut atteindre 246 personnes par image ; l'article ByteTrack écrit 170 personnes en moyenne par image de test ; la moyenne de l'ensemble de test, d'après le tableau ci-dessus, est de 115.5 personnes par image.
Ces chiffres diffèrent selon ce que l'on compte. MOT20 n'annote pas seulement les piétons, mais aussi les classes suivantes :
| Classe | Nombre |
|---|---|
| Piéton | 1 652 040 |
| Personne immobile | 335 891 |
| Occultant au sol | 87 786 |
| Véhicule non motorisé | 22 365 |
| Foule | 4 303 |
| Total | 2 102 385 |
D'après la Table 2 de l'article.
En additionnant les annotations de toutes les classes de l'ensemble de test, on obtient 765 465 entrées ; divisées par 4 479 images, cela fait environ 170.9 entrées par image, d'où le chiffre de 170 souvent cité. Seuls les piétons servent réellement à l'évaluation, soit 115.5 personnes par image.
Quant à 246, le corps de l'article le qualifie une fois de densité moyenne, sans expliquer comment il est calculé ; dans le tableau, la moyenne par vidéo la plus élevée est celle de MOT20-05, 195 personnes, si bien que 246 est plus probablement un maximum sur une seule image. Quel que soit le chiffre retenu, MOT20 est bien plus bondé que MOT17.
Règles d'annotation
L'annotation reprend les règles de MOT16, qui répartissent le contenu de l'image en trois groupes :
- Les piétons en mouvement. Toutes les personnes reconnaissables comme piétons et en train de se déplacer. Se pencher brièvement pour ramasser quelque chose ou s'accroupir pour parler à un enfant ne fait pas sortir de cette catégorie. C'est ce groupe que le traqueur doit suivre.
- Les silhouettes humaines de classe ambiguë. Les personnes assises, allongées, ou immobiles sur place pendant toute la vidéo, ainsi que les représentations artificielles de personnes (comme sur une affiche). À l'évaluation, les suivre ne rapporte aucun point, et ne pas les suivre n'en fait perdre aucun.
- Les véhicules et les occultants. Ils ne participent pas à l'évaluation ; ils sont fournis aux utilisateurs pour l'entraînement, ou servent à calculer le degré d'occultation des piétons. Voitures et vélos à l'arrêt ne sont annotés que s'ils cachent un piéton.
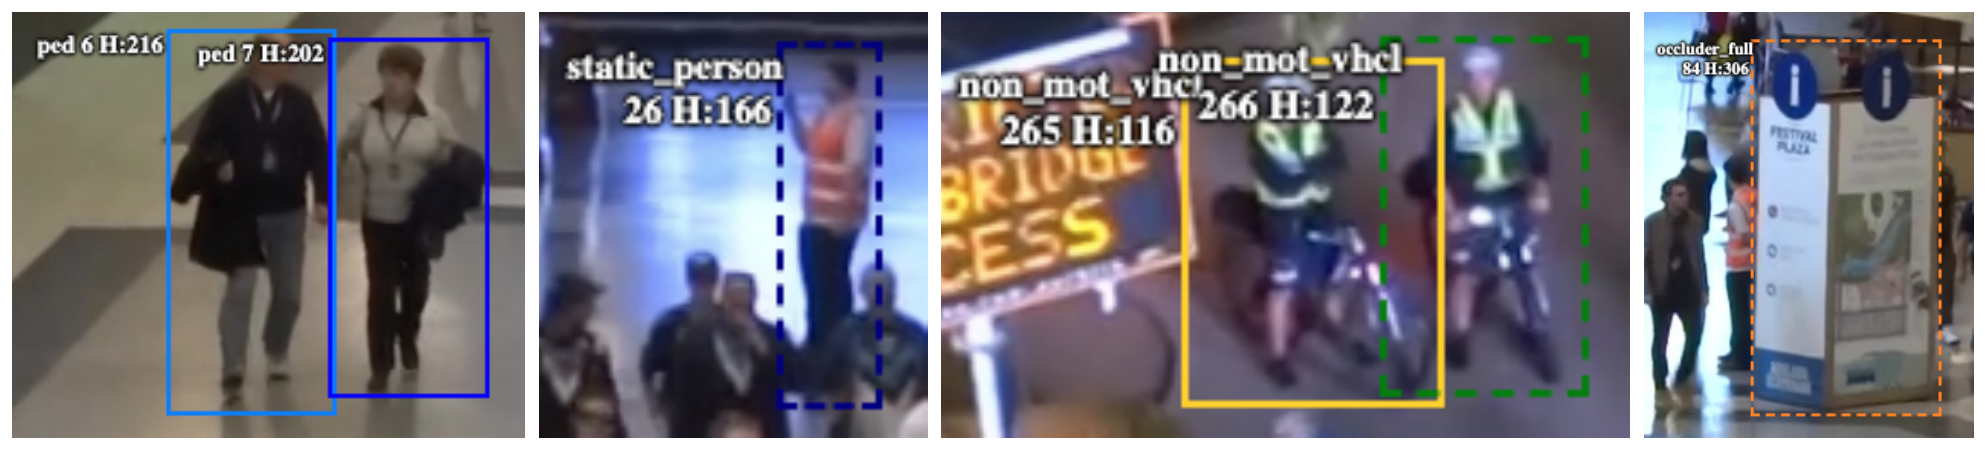
Ce groupe « ni puni ni récompensé » compte particulièrement dans MOT20. Les personnes immobiles totalisent 336 000 entrées, soit un cinquième des boîtes de piétons. Dans la vidéo de test MOT20-08, on compte 52 998 personnes immobiles pour 77 484 piétons ; autrement dit, environ 4 personnes sur 10 à l'écran sont hors du champ de l'évaluation.
Le détecteur, lui, se moque bien de savoir si quelqu'un marche. Un traqueur qui s'appuie sur les détections risque fort de suivre parfaitement ces personnes immobiles ; si elles comptaient comme faux positifs, le traqueur serait pénalisé à tort. À l'inverse, un traqueur fondé sur des indices de mouvement qui ne suit pas une personne assise ne devrait pas non plus être pénalisé pour détection manquée.
Par ailleurs, la définition des cibles à suivre est très concrète. Ce sont des piétons debout, qu'on pourrait rejoindre à pied en suivant la ligne de visée, sans obstacle physique entre les deux. Les reflets, les personnes derrière une vitre, à vélo ou assises dans un véhicule ne comptent pas.
Détections publiques
Comme MOT17, MOT20 fournit un jeu de détections publiques, pour que tout le monde compare les algorithmes de suivi sur les mêmes entrées. Cette fois, c'est un Faster R-CNN avec un backbone (réseau de base) ResNet-101, entraîné sur les vidéos d'entraînement de MOT20. Le défi MOT20 n'acceptait au départ que des résultats obtenus avec les détections publiques ; ce n'est qu'à l'ouverture des soumissions permanentes que les détecteurs maison ont aussi été acceptés.
Les performances de ce détecteur sur les vidéos de test montrent justement pourquoi les auteurs ont gardé une scène inédite :
| Vidéo | Scène | AP | Rappel | Précision | FP/image |
|---|---|---|---|---|---|
| 04 | Place, nuit (connue) | 0.63 | 69.7 | 98.0 | 1.55 |
| 07 | Intérieur (connue) | 0.78 | 83.6 | 92.5 | 1.89 |
| 06 | Rue, jour (inédite) | 0.43 | 57.9 | 74.4 | 12.64 |
| 08 | Rue, jour (inédite) | 0.38 | 55.2 | 61.6 | 13.93 |
D'après la Table 6 de l'article, vidéos de test.
Sur les scènes déjà vues, la précision dépasse 90 % et on compte moins de 2 faux positifs par image. Sur la rue de jour inédite, la précision tombe à 60 ou 70 %, les faux positifs par image explosent pour atteindre 12 à 14, et l'AP n'est plus que d'environ 0.4.
Ces détections publiques reviennent à refiler directement au traqueur l'échec de généralisation. Sur MOT20-06 et 08, un traqueur qui utilise les détections publiques doit gérer d'emblée une masse de fausses boîtes.
Les statistiques de détection montrent aussi à quel point les boîtes sont petites. Dans les quatre vidéos de test, la boîte de détection la plus basse ne mesure que 21 à 37 pixels de haut ; la vidéo d'entraînement MOT20-03 en contient même de 16 pixels.
Format de fichier et évaluation
Les fichiers de MOT20 sont de simples CSV, un objet par ligne, avec 9 champs dans l'ordre suivant : numéro d'image, ID, x et y du coin supérieur gauche de la boîte, largeur, hauteur, score de confiance, classe, visibilité. Dans les fichiers de détection, l'ID vaut −1 ; dans les fichiers de vérité terrain, la colonne du score de confiance sert d'indicateur, et 0 marque une entrée exclue de l'évaluation. Les coordonnées commencent à 1.
L'évaluation reprend elle aussi MOT16 : un appariement exige un IoU d'au moins 0.5, et les métriques sont celles de CLEAR MOT plus les métriques de qualité de trajectoire de Wu et Nevatia (MT, ML, FM). Les auteurs précisent que la définition du changement d'identité est ici plus stricte que dans le CLEAR MOT d'origine. Dès que la trajectoire appariée à une cible réelle diffère de son appariement précédent, on compte un changement. Toutes les vidéos de test sont évaluées ensemble, mises bout à bout, au lieu d'une moyenne par vidéo.
Pour les scènes de foule, MOT20 ajoute aussi une règle absente de MOT17. Une boîte de résultat qui recouvre à plus de 75 % une boîte de ces classes, personne immobile, reflet, personne sur un véhicule ou distracteur, est retirée des résultats ; l'article place cette règle dans la procédure d'évaluation du défi de détection.
MOTA reste la métrique principale, et les auteurs ajoutent comme d'habitude que la question de savoir si ce nombre peut servir, seul, d'unique mesure de performance est « hautement discutable ». Pour voir si une méthode a été réglée au point de ne convenir qu'à quelques vidéos, le classement affiche aussi l'écart type du MOTA d'une vidéo à l'autre.
L'article lui-même ne contient aucun résultat de traqueur, seulement les performances du détecteur ci-dessus. Pour savoir comment les traqueurs se comportent sur MOT20, il faut aller voir les articles et les classements ultérieurs.
Discussion
En rassemblant les passages où MOT20 apparaît dans les notes du site, on voit que ces vidéos mettent à l'épreuve, en gros, quatre choses.
La foule ralentit les méthodes qui ont besoin de caractéristiques d'apparence. Sur MOT20, FairMOT tombe à 13.2 FPS, et StrongSORT à 1.5 FPS. Avec plus d'une centaine de personnes par image, il faut extraire une caractéristique d'apparence pour chacune, et la comparer à chaque trajectoire.
La foule rend plus visible l'accumulation d'erreur du modèle de mouvement. L'écart qu'OC-SORT creuse avec ByteTrack est plus grand sur MOT20 que sur MOT17. Les occultations sont nombreuses et durent chaque fois plusieurs images ; le filtre de Kalman n'a aucune observation pour se corriger, et l'erreur s'accumule tout du long.
Caméras fixes. Les vidéos de MOT20 sont toutes tournées avec des caméras fixes ; la compensation du mouvement de caméra n'y sert donc à rien. Les ablations de Deep OC-SORT montrent d'ailleurs qu'avec la compensation du mouvement de caméra, MOT17 progresse nettement, mais pas MOT20.
Bondé et difficile à reconnaître, ce n'est pas la même chose. Les auteurs de DanceTrack soulignent que, malgré le nombre de personnes, les piétons de MOT20 se déplacent de façon très régulière, et leurs positions relatives comme leurs zones d'occultation ne changent presque pas ; une telle foule ne gêne pas la comparaison d'apparence. DanceTrack prend donc le problème par l'autre bout, avec peu de monde, mais des gens qui se ressemblent tous et bougent dans tous les sens.
Conclusion
MOT20 garde les règles existantes de MOTChallenge et y place 8 vidéos extrêmement bondées, avec en moyenne plus d'une centaine de piétons par image, des boîtes dont les plus petites font tout juste une quinzaine de pixels, et une rue de jour réservée au test. L'article est court, sans méthode ni résultats de suivi, mais il a fait de « la foule » une colonne que tout article de suivi ultérieur se doit de présenter.
En lisant ses chiffres, gardez deux choses en tête : le score de test se décide en grande partie sur MOT20-04, une seule vidéo, celle de la place de nuit ; et les « 170 personnes par image » qu'on entend souvent incluent des classes exclues de l'évaluation, alors que les piétons réellement évalués sont 115.5 par image.