原始論文
SportsMOT: A Large Multi-Object Tracking Dataset in Multiple Sports Scenes
- 發表版本
- ICCV 2023會議
- arXiv 首次提交
- arXiv:2304.05170
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingsportsmot2023,
  title = {{SportsMOT: A Large Multi-Object Tracking Dataset in Multiple Sports Scenes}},
  author = {Yutao Cui and Chenkai Zeng and Xiaoyu Zhao and Yichun Yang and Gangshan Wu and Limin Wang},
  year = {2023},
  eprint = {2304.05170},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2304.05170}
}
一場球賽的轉播畫面,追蹤器要追的不是所有人。觀眾、裁判、場邊的教練都不用管,只要場上的球員。追到之後,才能算每個人跑了多遠、平均速度多快,進一步做戰術分析。
當時的追蹤資料集,大多是為了監視或自駕車而建的:街上的行人、車輛,幾乎畫面裡每個人都要追。DanceTrack 雖然換成了舞台,但舞者之間幾乎無法分辨,和運動場上的情況也不一樣。
南京大學王利民團隊的 Yutao Cui、Chenkai Zeng、Xiaoyu Zhao、Yichun Yang 等人,於是做了一個專門給運動場景的追蹤資料集 SportsMOT,並提出一個在現有追蹤器上加強外觀關聯的框架 MixSort。
定義問題
作者認為,主流追蹤器的三個元件,偵測、運動關聯和外觀關聯,都被 MOT17、MOT20 和 DanceTrack 這幾個資料集的分布帶偏了,搬到運動場上就不太好用。
偵測。 行人資料集要偵測畫面裡幾乎所有的人,運動場上卻只要球員,所以需要專門訓練的偵測器。
運動。 MOT17 和 MOT20 的行人走得慢、走得直,用卡爾曼濾波預測位置、再算 IoU 就很夠用。DanceTrack 的舞者會頻繁改變方向和相對位置,但速度並不快。運動員則是又快又會變速:衝刺、急停、急轉,相鄰兩幀之間的位移很大,而且很難預測。
外觀。 MOT17、MOT20 的行人體型和穿著都不同,很好分辨;DanceTrack 的舞者穿得幾乎一模一樣。運動員介於兩者之間:同一隊的球員穿一樣的球衣,快速移動或鏡頭快速移動時還會模糊;但球衣上有號碼,每個人的姿勢也不太一樣。作者把這叫作「相似但可分辨」。
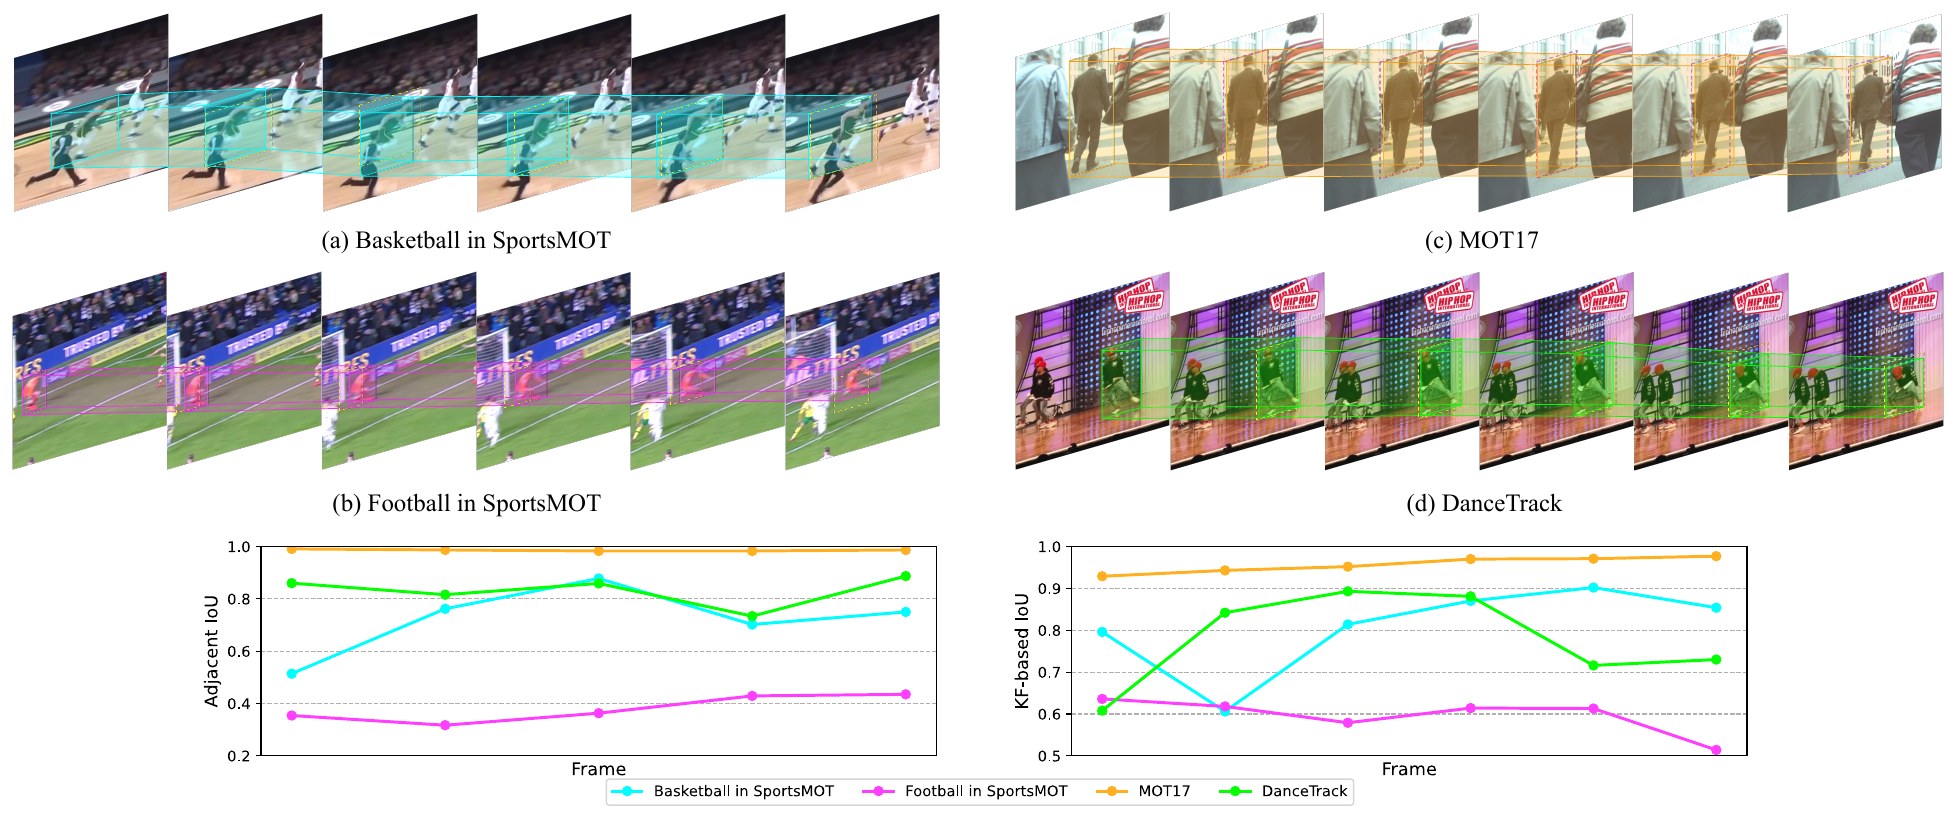
上半部是四組取樣序列。可以看到足球那一組,同一個球員在連續幾幀之間,框的位置跳得很遠。下面兩張折線圖把這件事量化:足球的相鄰幀 IoU 只有 0.3 到 0.45,用卡爾曼濾波預測後也只有 0.5 到 0.65;MOT17 的行人則幾乎都接近 1。
解決問題
資料怎麼來
作者挑了三種全世界都熟悉的運動:籃球、排球和足球,影片取自另一個運動動作資料集 MultiSports,來源包括 NCAA、英超和奧運的職業比賽。三種運動各有典型的陣型和跑動模式。
篩選時有幾個條件:
- 只用轉播的俯拍鏡頭,避開一些極端的畫面。
- 影片都是 720p、每秒 25 幀。
- 每段影片都人工檢查過,片段內沒有突然的視角切換。
標註規則也針對運動場景訂得很具體:
- 框住球員的四肢和軀幹,碰到身體的球不算在內。
- 球員被遮住時,只要還有一部分身體看得見,就要推測出完整的框。
- 軀幹有一半以上在畫面外,就不標。
- 每個球員在整段影片裡只能有一個 ID。
標註用的是自製工具。標註員開始標一個新球員時,工具自動給一個新 ID,並用單目標追蹤器 KCF 把框傳到下一幀,標註員再修正。全部標完再審查一輪,修正不合規定的框和 ID;最後刪掉寬或高小於 5 像素的框。
規模
| 資料集 | 影片 | 幀數 | 總長(秒) | 框 | 軌跡 |
|---|---|---|---|---|---|
| MOT17 | 14 | 11,235 | 463 | 292,733 | 1,342 |
| MOT20 | 8 | 13,410 | 535 | 1,652,040 | 3,456 |
| DanceTrack | 100 | 105,855 | 5,292 | — | 990 |
| SportsMOT | 240 | 150,379 | 6,015 | 1,629,490 | 3,401 |
整理自原論文 Table 1。
SportsMOT 的幀數是 MOT17 的 13.4 倍,框的數量和 MOT20 差不多,但分散在 240 段影片裡。訓練、驗證、測試分別是 45、45、150 段,測試集占了大部分。
三種運動的差別也很大:
| 運動 | 平均幀數 | 平均軌跡數 | 平均軌跡長度 | 平均中斷長度 | 每幀框數 |
|---|---|---|---|---|---|
| 籃球 | 845.4 | 10 | 767.9 | 68.7 | 9.1 |
| 排球 | 360.4 | 12 | 335.9 | 38.2 | 11.2 |
| 足球 | 673.9 | 20.5 | 422.1 | 116.1 | 12.8 |
整理自原論文 Table 2,皆為每段影片的平均;長度單位是幀。
籃球每段影片平均 10 條軌跡,剛好是場上的 10 個球員,而且幾乎從頭到尾都在畫面裡。足球場大,鏡頭只拍得到一部分球員,平均每段有 20.5 條軌跡,中斷的時間也最長,球員常常跑出畫面又回來。
兩個特性,各量一次
作者用三張圖量化前面說的兩個特性。
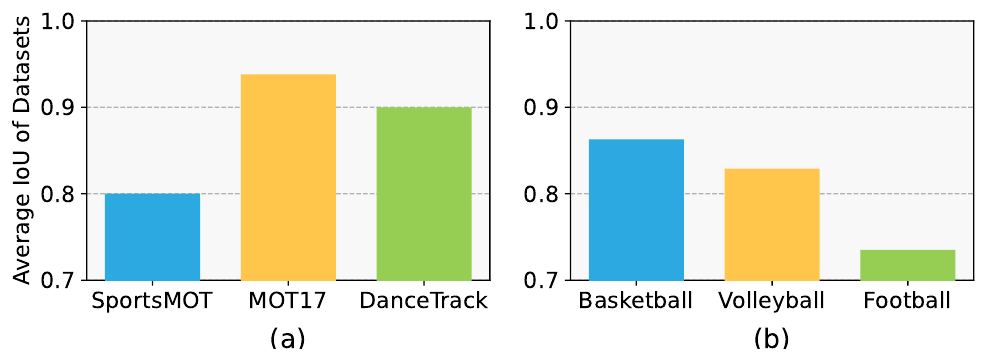
第一張量的是速度。同一個人在相鄰兩幀的框重疊得越少,代表移動得越快。SportsMOT 在三個資料集中最低,約 0.80;三種運動裡又以足球最低,約 0.74。
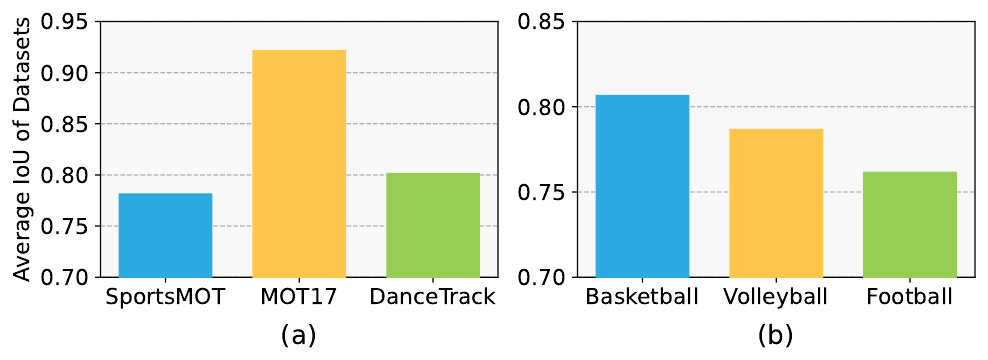
第二張量的是運動好不好預測。作者用前幾幀的真值框讓卡爾曼濾波預測下一幀,再和真正的下一幀算 IoU。如果運動是等速的,預測應該很準,IoU 會接近 1。SportsMOT 一樣最低,約 0.78,和 DanceTrack 差不多;MOT17 有 0.92。作者把這歸因於變速:急加速、急停,等速假設跟不上。
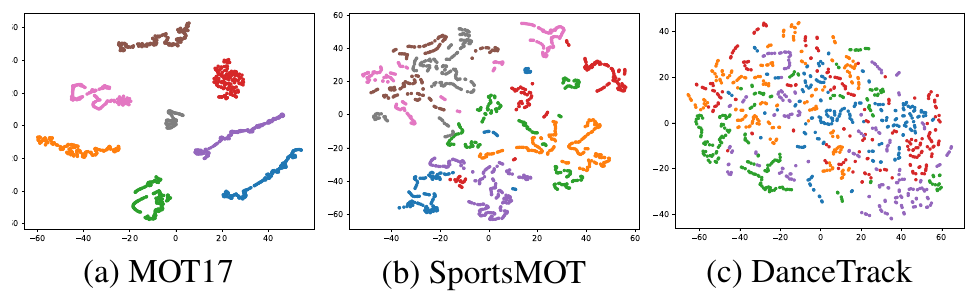
第三張看外觀。把 re-ID 特徵用 t-SNE 投影到平面,MOT17 的每個人自成一群,DanceTrack 的所有人混在一起,SportsMOT 介於兩者之間。這就是「相似但可分辨」。
評估指標方面,作者建議以 HOTA、AssA、IDF1 為主,不以偏重偵測的 MOTA 排名。
MixSort:把單目標追蹤器拿來比外觀
既然運動員「可分辨」,外觀就應該派得上用場。但一般的 re-ID 特徵,是把每個框各自抽成一個向量再比距離。作者的想法是換用單目標追蹤器的作法,直接拿軌跡的模板,到新的一幀裡找人。
他們用的是同一個團隊先前提出的單目標追蹤器 MixFormer,改成一個外觀關聯模組,可以接在 ByteTrack、OC-SORT 這類先偵測再關聯的追蹤器上,稱為 MixSort。
對每一條軌跡,流程是:
- 用卡爾曼濾波預測它在這一幀的位置,以這個位置為中心,裁出一塊 224 × 224 的搜尋區。
- 把搜尋區和這條軌跡的模板(96 × 96)一起送進 MixFormer,輸出一張熱圖,表示搜尋區裡每個位置像不像模板的中心。
- 中心落在搜尋區裡的偵測框,以熱圖在它中心的值當作外觀相似度;落在搜尋區外的,相似度是 0。
這樣得到一個外觀相似度矩陣 ,再和 IoU 矩陣加權合併:
最後用匈牙利演算法配對。
為了配合多目標追蹤,作者做了幾個修改。原本 MixFormer 用角點頭預測目標的左上、右下角,這裡改成熱圖頭,預測目標中心;混合注意力模組從 12 層減到 4 層,加快速度。每條軌跡只留一個模板,配上新偵測時,只有當新偵測沒被其他偵測擋住的面積夠大,才更新模板,避免被遮住的畫面污染模板。
訓練時,把每個球員的軌跡轉成單目標追蹤的資料格式,用高斯分布產生中心熱圖的真值,以 focal loss 訓練。MixFormer 從單目標追蹤資料訓練好的權重開始,在 SportsMOT 上微調 300 個 epoch。偵測器則沿用 ByteTrack 的 YOLOX,先在 CrowdHuman 上訓練,再在 SportsMOT 上訓練。
討論
難在關聯
作者在 SportsMOT 上重新訓練、測試了幾個主流的追蹤器:
| 方法 | HOTA | AssA | DetA | IDF1 |
|---|---|---|---|---|
| FairMOT | 49.3 | 34.7 | 70.2 | 53.5 |
| GTR | 54.5 | 45.9 | 64.8 | 55.8 |
| QDTrack | 60.4 | 47.2 | 77.5 | 62.3 |
| CenterTrack | 62.7 | 48.0 | 82.1 | 60.0 |
| TransTrack | 68.9 | 57.5 | 82.7 | 71.5 |
| ByteTrack | 64.1 | 52.3 | 78.5 | 71.4 |
| OC-SORT | 73.7 | 61.5 | 88.5 | 74.0 |
| MixSort-Byte | 65.7 | 54.8 | 78.8 | 74.1 |
| MixSort-OC | 74.1 | 62.0 | 88.5 | 74.4 |
整理自原論文 Table 3,測試集。前五個方法只用訓練集;ByteTrack、OC-SORT 和兩個 MixSort 用訓練集加驗證集。
偵測的 DetA 大多在 77 到 88 之間,關聯的 AssA 卻落在 35 到 62。作者據此認為,SportsMOT 的主要挑戰在關聯,不在偵測。球員在畫面裡清楚、又不擁擠,偵測器只要學會不去框觀眾和裁判,就能做得很好。
MixSort 對兩個基礎追蹤器都有幫助。ByteTrack 加上之後 HOTA 多 1.6、IDF1 多 2.7;OC-SORT 加上之後只多 0.4。各方法之間的 HOTA 從 49 到 74,差距很大,作者認為這代表 SportsMOT 比較能拉開不同演算法。
卡爾曼濾波反而扯後腿
這篇最讓人意外的結果,是 MixSort-Byte 的消融:
| IoU | 卡爾曼預測 | MixSort | HOTA | AssA | IDF1 |
|---|---|---|---|---|---|
| ✓ | 71.5 | 58.1 | 71.2 | ||
| ✓ | 64.2 | 48.7 | 63.9 | ||
| ✓ | ✓ | 64.1 | 52.3 | 71.4 | |
| ✓ | ✓ | 73.8 | 61.6 | 74.4 | |
| ✓ | ✓ | ✓ | 65.7 | 54.8 | 74.1 |
整理自原論文 Table 6,SportsMOT 測試集。沒有卡爾曼預測的列,直接拿軌跡上一次的位置和偵測框算 IoU。
第一列和第三列只差在要不要先用卡爾曼濾波預測位置。不預測、直接拿上一幀的框算 IoU,HOTA 是 71.5;用卡爾曼濾波預測之後,反而掉到 64.1。
假設等速運動的卡爾曼濾波,在運動員身上預測錯得太多,還不如不預測。表上最好的組合,是 IoU 加 MixSort、不用卡爾曼濾波,HOTA 73.8,比作者在主表上報告的 MixSort-Byte(65.7)高了 8 分。
只用 MixSort 的外觀、完全不看位置,HOTA 只有 64.2,ID 切換高達 25,947 次(只用 IoU 是 4,329 次)。外觀可以分辨,但單靠外觀還不夠。
外觀什麼時候有用
作者在 OC-SORT 加 MixSort 上調整融合權重 ,看三種運動各自的反應。 是只用運動, 是只用外觀:
| 運動 | 只用運動 | 最好的融合 | 只用外觀 |
|---|---|---|---|
| 籃球 | 65.9 | 66.2(α = 0.8) | 26.9 |
| 排球 | 76.0 | 76.9(α = 0.5) | 40.9 |
| 足球 | 71.9 | 73.2(α = 0.4) | 65.7 |
整理自原論文 Table 4,SportsMOT 測試集,HOTA。
三種運動都是融合最好,而且只用運動都比只用外觀好。外觀帶來的提升,足球最多(+1.3)、排球次之(+0.9)、籃球最少(+0.3)。對照前面的圖,足球的相鄰幀 IoU 最低、動作最快。作者的結論是,動作越快的場景,越需要外觀線索;最佳的 也隨之下降,足球只給運動 0.4 的權重。
籃球是三者中最難的。它的最佳 HOTA 只有 66.2,只用外觀時更只有 26.9。作者推測,籃球場小、身體接觸多,遮擋和模糊都比較嚴重。
和 DanceTrack、SoccerNet 比
在 DanceTrack 的驗證集上,MixSort-Byte 的 HOTA 是 46.7,原本的 ByteTrack 是 47.1,加了外觀反而稍微變差。舞者的外觀太難分辨,外觀模組幫不上忙。SportsMOT 的球員外觀相似但分得開,運動和外觀兩種線索都得用上。
另一個運動追蹤資料集 SoccerNet 只拍足球,而且要追場上所有元素,包括球員、守門員、裁判和球。MixSort-Byte 在 SoccerNet 上的 HOTA 是 62.9,DetA 只有 71.5,比 SportsMOT 的 78.8 低,因為要偵測的東西更雜;但 AssA 是 55.5,反而略高於 SportsMOT 的 54.8。作者據此認為,SportsMOT 的關聯更有挑戰。
最後,作者也把 MixSort 和一般的 re-ID 模型比較。在 ByteTrack 上加入 DeepSORT 用的 re-ID 模型、並在 SportsMOT 上微調,HOTA 從 64.1 升到 64.8;換成 MixSort 則到 65.7。外觀線索確實有用,用單目標追蹤器比外觀又更好一些。
結論
SportsMOT 用 240 段職業比賽的轉播影片,提出了一種和行人、舞者都不同的追蹤情境:球員跑得快、會變速,外觀相似但可以分辨。作者用相鄰幀 IoU、卡爾曼預測後的 IoU 和 re-ID 特徵的分布,把這兩個特性量化出來,並說明這裡的困難主要在關聯。
MixSort 證明外觀線索在運動場上確實有用,但這篇論文更值得記住的,是那張消融表。等速假設的卡爾曼濾波在運動員身上不但沒幫忙,還讓 HOTA 掉了 7.4 分。
兩個月後,同樣處理運動場景的 Deep-EIoU 乾脆把卡爾曼濾波整個拿掉,在 SportsMOT 上拿到 77.2 的 HOTA。2025 年的一篇多目標追蹤綜述,也把 SportsMOT 和 MOT17、MOT20、DanceTrack 並列為四個標準資料集。
場上的球員都穿著一樣的球衣,好在背後還有號碼。