Article original
Samba: Synchronized Set-of-Sequences Modeling for Multiple Object Tracking
- Publication
- ICLR 2025Conférence
- Premier dépôt sur arXiv
- arXiv:2410.01806
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingsamba2024,
  title = {{Samba: Synchronized Set-of-Sequences Modeling for Multiple Object Tracking}},
  author = {Mattia Segu and Luigi Piccinelli and Siyuan Li and Yung-Hsu Yang and Bernt Schiele and Luc Van Gool},
  year = {2024},
  eprint = {2410.01806},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2410.01806}
}
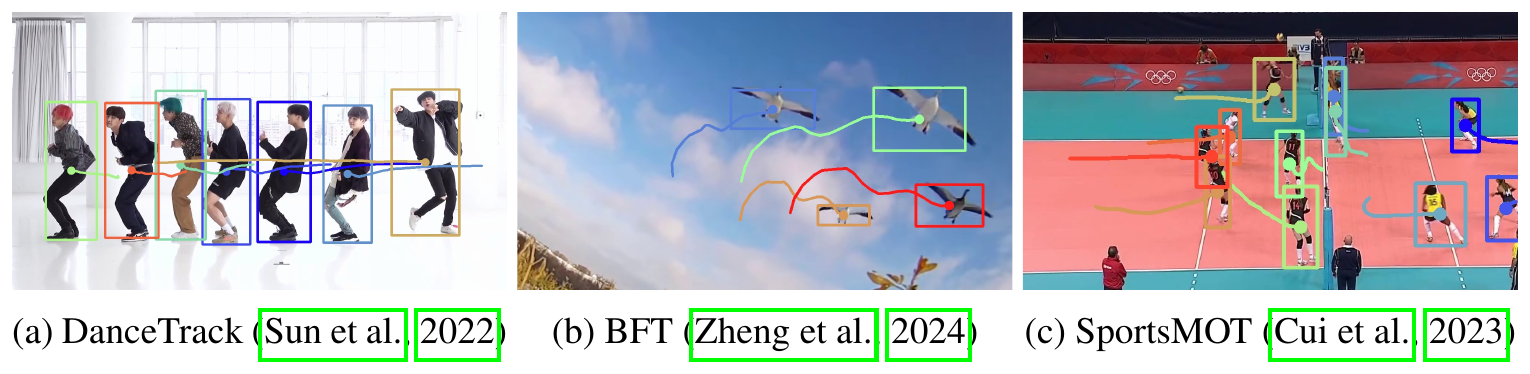
Regardez une danse de groupe, et vous verrez que les danseurs dansent rarement chacun de leur côté. Quand la formation glisse vers la gauche, tout le monde part à gauche ; quand quelqu'un s'accroupit, ses voisins sautent peut-être au même moment. Un vol d'oiseaux qui vire, des joueurs qui se replacent, c'est la même chose.
Pour le suivi, c'est un indice très utile. Quand une personne de la troupe est cachée, on ne sait pas où elle se trouve à cet instant, mais en regardant comment bougent les autres, on peut le deviner à peu près.
Pourtant, la plupart des traqueurs traitent chaque trajectoire séparément. Le filtre de Kalman, c'est un par trajectoire ; dans les traqueurs à requêtes comme MOTR, chaque requête ne transmet elle aussi que sa propre information de l'image précédente. Mattia Segu, Luc Van Gool et leurs collègues de l'ETH Zurich veulent un modèle capable de regarder à la fois « l'historique à long terme de chaque trajectoire » et « les relations entre trajectoires », et l'appellent Samba ; c'est à la fois l'abréviation de Synchronized Mamba et le nom de la samba, une danse qui exige que tout le monde bouge à l'unisson.
Définir le problème
Les auteurs se concentrent sur la voie du « suivi par requêtes », celle de TrackFormer et de MOTR. Ces méthodes utilisent à chaque image un ensemble de requêtes de piste pour retrouver dans l'image les personnes suivies à l'image précédente, puis transmettent les requêtes à l'image suivante.
Cette voie a trois problèmes :
- Elle ne regarde que l'image précédente. Les requêtes passent d'une image à la suivante, et l'historique plus ancien est mal exploité. MeMOTR a ajouté une mémoire à long terme, mais avec une moyenne mobile exponentielle, qui gomme les détails.
- Chacun suit de son côté. Chaque requête est transmise indépendamment, et la coordination entre danseurs ou entre oiseaux n'est pas du tout exploitée.
- En cas d'occultation, on ne peut que geler. Quand un objet est caché et que la confiance de la détection est très basse, MeMOTR et MOTRv2 gèlent la requête dans le dernier état observé, en attendant que l'objet réapparaisse. Plus l'occultation dure, plus l'état gelé s'éloigne de la position réelle.
Résoudre le problème
Architecture générale
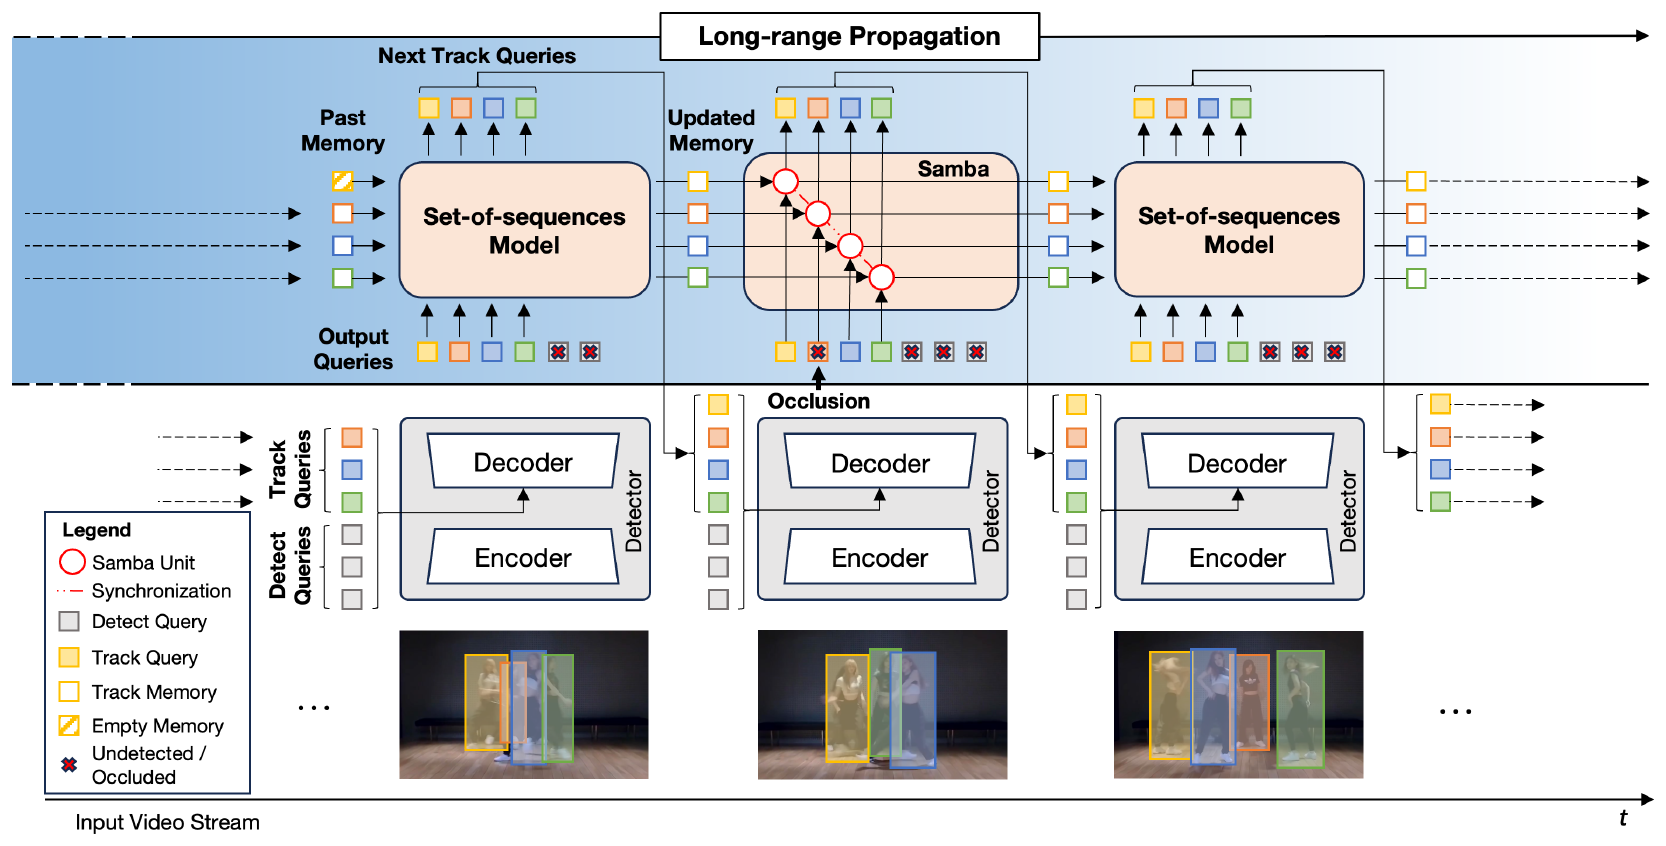
Le détecteur de SambaMOTR est un Deformable-DETR standard, comme celui de MOTR. Ce qui change, c'est « la façon de transmettre les requêtes d'une image à la suivante ».
MOTR utilise un petit module qui convertit directement la sortie de l'image courante en requêtes de l'image suivante. SambaMOTR le remplace par Samba ; chaque trajectoire est une séquence, et Samba utilise un modèle à espace d'états pour compresser toutes les sorties de cette trajectoire, depuis sa naissance, en un état caché, à partir duquel il prédit la requête de l'image suivante.
Avant d'entrer dans Samba, la sortie du décodeur reçoit en plus un encodage positionnel des coordonnées de la boîte, pour que le modèle voie à la fois l'apparence et la position. Samba ne produit pas une nouvelle requête complète, mais un résidu, ajouté à la requête d'origine.
Un modèle à espace d'états synchronisé
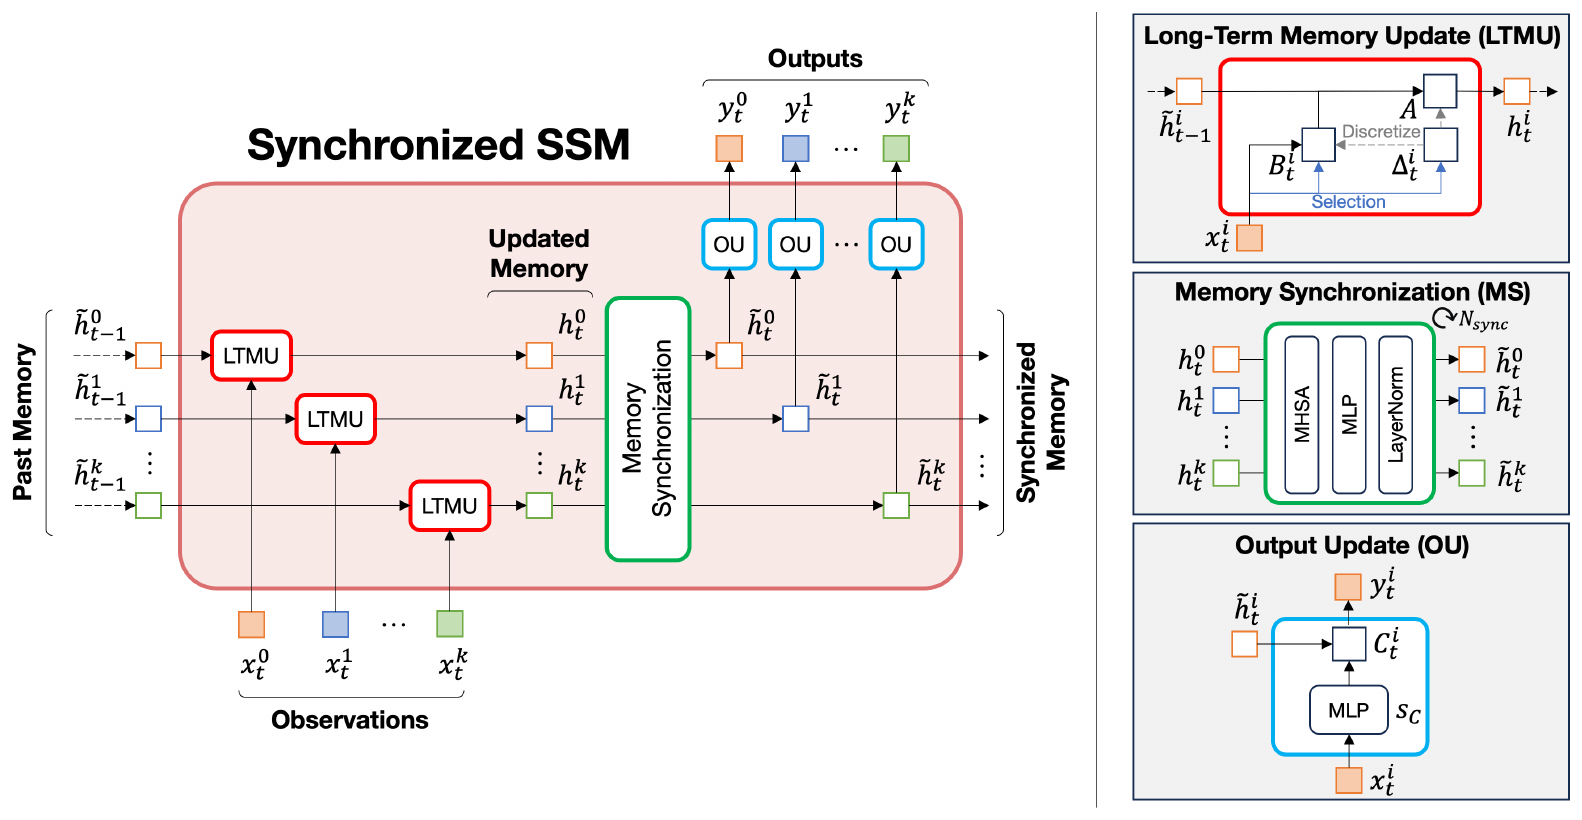
Le cœur de Samba, c'est la « synchronisation ». Dans un Mamba ordinaire, l'état caché de chaque séquence n'est mis à jour qu'à partir de sa propre entrée. Samba ajoute une synchronisation à chaque pas :
La première ligne est la mise à jour d'origine de Mamba ; chaque trajectoire met à jour sa mémoire avec sa propre observation de l'image courante. La deuxième ligne est la synchronisation ; les mémoires mises à jour de toutes les trajectoires sont rassemblées et passent par quelques couches d'auto-attention, qui leur permettent d'échanger de l'information. La troisième ligne produit la sortie à partir de la mémoire synchronisée.
L'auto-attention accepte un nombre quelconque de trajectoires et ne dépend pas de leur ordre, deux propriétés dont on a justement besoin. En contrepartie, son coût de calcul est proportionnel au carré du nombre de trajectoires ; il reste toutefois linéaire en temps, et l'on peut suivre une trajectoire aussi longtemps qu'on veut.
MaskObs : refuser les observations douteuses
Quand un objet est caché, le décodeur produit quand même une requête, mais elle est le plus souvent peu fiable et peut avoir saisi la personne qui le cache. Si l'on s'en sert malgré tout pour mettre à jour la mémoire, l'erreur s'accumule.
MaskObs exclut de la mise à jour de la mémoire les observations dont la confiance de détection est inférieure à 0.5.
À la différence du gel, la mémoire et la requête continuent d'avancer à chaque image. Simplement, la mise à jour repose alors entièrement sur l'historique propre de la trajectoire et sur l'information reçue, lors de la synchronisation, des autres trajectoires encore visibles.
Ramenons cette formule à une dimension et fixons et à 0.6 et 0.4 pour voir où est la différence. La mémoire d'un danseur A vaut 1.0. Dans l'image courante, A disparaît derrière B ; la sortie du décodeur ressemble en fait davantage à B, avec une valeur de et une confiance de seulement 0.3. À l'image suivante, A réapparaît ; l'observation vaut 1.0, avec une confiance de 0.9.
| Approche | Image occultée | Retour de A |
|---|---|---|
| Tout accepter | ||
| MaskObs |
Exemple de calcul établi pour cette note ; dans le modèle réel, et varient avec l'entrée, et la mémoire est un vecteur de grande dimension.
Si l'on accepte tout, l'information de B se mêle à la mémoire de A, et il faut encore plusieurs images après le retour de A pour s'en remettre. Avec le masque, A garde l'essentiel de sa mémoire.
S'entraîner sur des extraits longs
La famille MOTR s'entraîne sur 5 images à la fois, avec un gradient calculé sur les 5. Avec seulement 5 images, la mémoire à long terme ne s'apprend pas ; allonger directement les extraits fait grimper l'empreinte mémoire.
Les auteurs prennent des extraits de 10 images ; les 5 premières ne font qu'une passe avant, sans gradient, et la rétropropagation ne porte que sur les 5 dernières. L'empreinte mémoire reste à peu près la même, et le modèle apprend pourtant à exploiter un historique plus long.
Discussion
L'apport de chaque élément
| Configuration | HOTA | AssA | IDF1 |
|---|---|---|---|
| MOTR | 54.2 | 40.2 | 51.5 |
| MeMOTR | 63.4 | 52.3 | 65.5 |
| Modèle à espace d'états | 63.5 | 53.8 | 67.0 |
| + MaskObs | 64.8 | 54.3 | 68.1 |
| + synchronisation | 65.9 | 55.6 | 68.7 |
| + extraits longs | 67.2 | 57.5 | 70.5 |
D'après la Table 4 de l'article, ensemble de test de DanceTrack.
Remplacer le module de transmission par un simple Mamba suffit déjà à égaler MeMOTR, avec 1.5 point d'AssA en plus. Chaque élément ajouté ensuite fait gagner plus d'un point de HOTA, pour un total de 3.8 points au-dessus de MeMOTR.
L'annexe contient quelques ablations plus fines :
- Où placer la synchronisation. Synchroniser avant d'intégrer l'observation de l'image courante donne un HOTA de 66.1, à peu près comme les 66.0 sans synchronisation ; synchroniser après la mise à jour donne 67.2. Selon les auteurs, en synchronisant après la mise à jour, une trajectoire occultée peut combler ce qui lui manque avec l'information des autres trajectoires dans l'image courante.
- Les six vidéos les plus difficiles. Sur les six vidéos de DanceTrack où le modèle sans synchronisation fait le moins bien, la synchronisation fait passer le HOTA moyen de 40.9 à 44.5 et l'AssA de 25.1 à 28.3. Plus la scène est confuse, plus la synchronisation est utile.
- Gel ou MaskObs. En revenant au gel pendant l'occultation à la manière de MeMOTR, le HOTA tombe de 67.2 à 65.9.
- Prédire un résidu ou une requête complète. Prédire directement la requête complète de l'image suivante ne donne que 64.2 de HOTA ; prédire un résidu, 67.2.
Trois jeux de données
| Benchmark | Meilleur rival | HOTA rival | HOTA SambaMOTR | Écart AssA |
|---|---|---|---|---|
| DanceTrack | MeMOTR | 63.4 | 67.2 | +5.2 |
| BFT | OC-SORT | 66.8 | 69.6 | +4.9 |
| SportsMOT | TransTrack | 68.9 | 69.8 | +1.9 |
DanceTrack d'après la Table 1 de l'article, BFT d'après la Table 2, SportsMOT d'après la Table 3 ; aucune donnée d'entraînement supplémentaire.
SambaMOTR est premier sur les trois jeux de données, avec pour détecteur un simple Deformable-DETR sur ResNet-50, et non le YOLOX-X que les méthodes « détecter puis associer » utilisent souvent. Sur DanceTrack, C-BIoU, avec YOLOX-X, a un DetA de 81.3, supérieur aux 78.8 de SambaMOTR, mais un AssA de seulement 45.4, plus de 12 points sous celui de SambaMOTR.
BFT, avec ses vols d'oiseaux, montre bien ce que vaut la synchronisation. Les oiseaux se ressemblent presque tous, et l'apparence ne permet pas de savoir qui est qui, mais ils virent en groupe. L'AssA de SambaMOTR atteint 73.6, 12.5 points de plus que TrackFormer, jusque-là le meilleur traqueur à requêtes.
MOT17 et autres limites
L'annexe donne aussi les résultats sur MOT17. SambaMOTR y obtient un HOTA de 58.8, comme MeMOTR, bien en dessous des 63.1 de ByteTrack. Selon les auteurs, les piétons de MOT17 avancent surtout en ligne droite, et l'ensemble d'entraînement ne compte que 7 vidéos ; les méthodes de bout en bout n'y ont aucun avantage.
Les auteurs relèvent eux-mêmes deux limites. D'abord, une trajectoire inactive au-delà d'un certain nombre d'images est abandonnée ; or les footballeurs sortent souvent du champ pendant plusieurs secondes et reviennent avec un nouvel identifiant, ce qui demanderait d'ajouter une ré-identification à long terme. Ensuite, la synchronisation repose sur l'auto-attention, dont le coût croît avec le carré du nombre de trajectoires ; dès qu'il y a beaucoup de monde, ça ralentit. L'inférence tourne à 16 FPS sur une seule RTX 4090.
Conclusion
SambaMOTR apporte deux choses aux traqueurs à requêtes. D'abord une mémoire à long terme ; chaque trajectoire utilise un modèle à espace d'états qui compresse tout son historique en un état caché, avec un coût linéaire en temps. Ensuite la synchronisation ; à chaque pas, les mémoires de toutes les trajectoires échangent de l'information, et une trajectoire occultée peut s'appuyer sur les mouvements des autres.
MaskObs fait passer le traitement de l'occultation du « gel » à « refuser les observations douteuses, mais continuer d'avancer ». Avec l'entraînement sur extraits longs en plus, ces trois éléments dépassent les méthodes précédentes sur les danses de groupe, les vols d'oiseaux et les matchs.
Ses auteurs recoupent largement ceux de MASA. MASA apprend l'association d'apparence sans la moindre vidéo ; SambaMOTR apprend, dans les vidéos, les relations temporelles et collectives. Les deux articles prennent l'association par les deux bouts.