Article original
MambaMOT: State-Space Model as Motion Predictor for Multi-Object Tracking
- Publication
- ICASSP 2025Conférence
- Premier dépôt sur arXiv
- arXiv:2403.10826
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingmambamot2024,
  title = {{MambaMOT: State-Space Model as Motion Predictor for Multi-Object Tracking}},
  author = {Hsiang-Wei Huang and Cheng-Yen Yang and Wenhao Chai and Zhongyu Jiang and Jenq-Neng Hwang},
  year = {2024},
  eprint = {2403.10826},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.10826}
}
Fin 2023, Mamba entre en scène comme « modèle à espace d'états sélectif » ; il tient tête aux Transformers sur les longues séquences, avec un coût de calcul qui ne croît que linéairement avec la longueur de la séquence. Dans les mois qui suivent, on essaie de l'importer dans tous les domaines.
En suivi multi-objets, l'endroit le plus naturel pour un modèle de séquence, c'est la prédiction du mouvement. Connaissant les boîtes d'une trajectoire sur les dernières images, prédire la boîte de l'image suivante est par nature un problème de séquence, confié depuis SORT au filtre de Kalman.
Hsiang-Wei Huang, Jenq-Neng Hwang et leurs collègues de l'Université de Washington remplacent justement le filtre de Kalman par Mamba. L'article ne fait que quatre pages et l'idée est très directe, mais il se prête bien à une comparaison avec DiffMOT, paru moins de deux semaines plus tôt ; même problème, l'un avec un modèle de diffusion, l'autre avec un modèle à espace d'états.
Définir le problème
Le filtre de Kalman suppose que l'objet avance en ligne droite à vitesse constante sur de courtes durées. Les piétons respectent à peu près cette hypothèse ; les danseurs et les joueurs, non.
OC-SORT avait analysé deux faiblesses du filtre de Kalman dans ce genre de scène. La première est sa sensibilité au bruit d'état ; pour peu que l'estimation de la vitesse soit un peu biaisée, il suffit que l'objet ne soit pas détecté pendant quelques images pour que la position prédite parte très loin. La seconde est l'amplification de l'erreur avec le temps ; sans nouvelle observation, le filtre de Kalman ne peut que continuer sur l'ancienne vitesse.
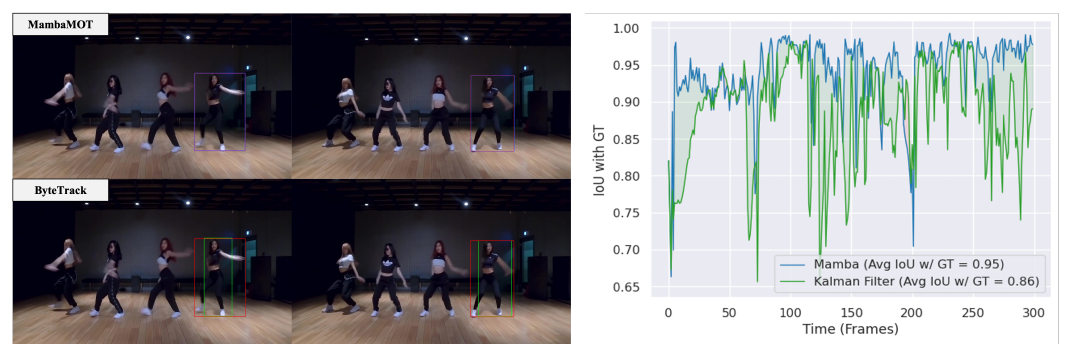
La courbe de droite est très parlante. La plupart du temps, le filtre de Kalman prédit correctement lui aussi, mais chaque fois que le danseur change brusquement de mouvement, la ligne verte plonge, et passe plusieurs fois sous 0.75. Pour une association par IoU, ces décrochages soudains sont précisément les moments où la trajectoire se brise.
Plutôt que de supposer le mouvement linéaire, les auteurs veulent laisser le modèle apprendre à partir des données comment bougent d'ordinaire un danseur ou un joueur.
Résoudre le problème
Prédire la boîte suivante avec Mamba
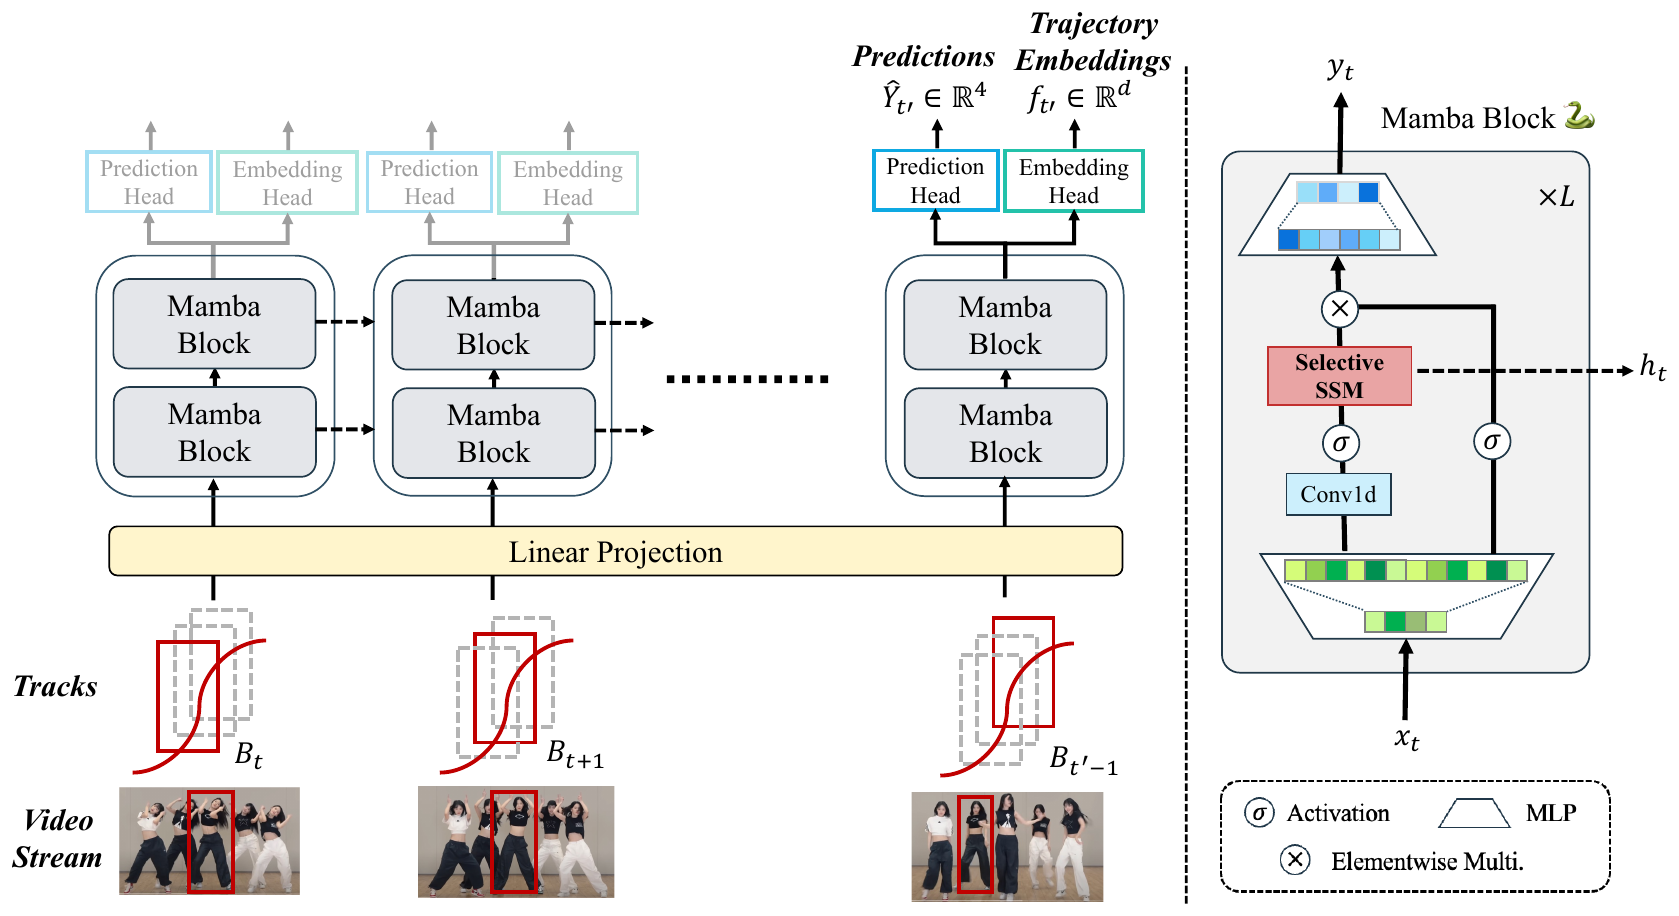
Le modèle de mouvement de MambaMOT est très petit. En entrée, les boîtes d'une trajectoire sur ses dernières images, quatre nombres par boîte ; une projection linéaire les porte à 64 dimensions, elles traversent deux blocs Mamba, et un dernier MLP produit la boîte de l'image suivante. La perte d'entraînement est la somme de la GIoU et de l'erreur quadratique moyenne entre boîte prédite et boîte de vérité terrain.
L'association reprend telle quelle celle de ByteTrack ; les boîtes à score élevé sont d'abord appariées aux boîtes prédites par l'IoU, puis les trajectoires restantes sont appariées une seconde fois aux boîtes à faible score. MambaMOT et ByteTrack ne diffèrent donc que par un seul composant, le modèle de mouvement.
Que veut dire « sélectif » ?
Le cœur de Mamba est une récurrence :
L'état caché résume toutes les entrées passées ; à chaque nouvelle entrée, on décide quelle part de l'ancien résumé garder et quelle part de la nouvelle entrée absorber.
Dans un modèle à espace d'états classique, et sont fixes ; la part gardée et la part absorbée sont les mêmes à chaque pas. Mamba les fait varier avec l'entrée, d'où le nom de « sélectif ». L'article écrit ces deux grandeurs et , dont la somme vaut exactement 1.
Ramenée à une dimension, cette formule montre bien à quoi elle sert pour la prédiction du mouvement. En posant , la récurrence devient :
C'est une moyenne mobile exponentielle, à ceci près que le coefficient de lissage est déterminé par l'entrée.
L'exemple d'un demi-tour
Réduisons l'entrée à la vitesse horizontale d'une personne qui danse, image par image. Sur les premières images, elle va toujours vers la droite, à 10 pixels par image, et la mémoire contient . À l'image courante, elle fait brusquement demi-tour, et sa vitesse passe à .
| Approche | Coeff. | Nouvelle mémoire | Direction prédite |
|---|---|---|---|
| Fixe | 0.2 | Encore à droite | |
| Sélective | 0.8 | Vers la gauche |
Exemple de calcul établi pour cette note ; dans le modèle réel, l'état caché est un vecteur de grande dimension, et la sortie passe encore par un MLP.
Un modèle à coefficient fixe traite toutes les entrées de la même façon ; il faut plusieurs images pour que l'information nouvelle l'emporte sur l'ancienne tendance. Un modèle sélectif peut apprendre que, face à ce genre d'entrée, l'ancienne tendance n'est plus fiable et qu'il faut accorder un grand poids à la nouvelle observation.
Le filtre de Kalman s'ajuste lui aussi en fonction des observations, mais l'ampleur de l'ajustement dépend de paramètres de bruit fixés à l'avance, et le modèle sous-jacent reste toujours celui de la vitesse constante. Mamba, lui, apprend sa manière de s'ajuster à partir des données.
MambaMOT+ : apprendre au passage une caractéristique de trajectoire
Puisque l'état caché de Mamba retient le schéma de mouvement de toute la trajectoire, les auteurs veulent aller plus loin et s'en servir. MambaMOT+ ajoute une tête de plongement à la sortie des blocs Mamba, qui produit le vecteur de caractéristiques de la trajectoire.
Cette caractéristique s'entraîne avec une perte de plongement cosinus ; deux segments découpés dans la même trajectoire doivent avoir des caractéristiques semblables, et la similarité de deux segments de trajectoires différentes doit être poussée sous 0.
Une fois le suivi terminé, les caractéristiques de toutes les tracklets sont comparées deux à deux, et un regroupement hiérarchique raccorde celles dont les schémas de mouvement se ressemblent. Pour éviter les raccords absurdes, on ne relie pas deux tracklets séparées de plus de 50 images dans le temps ou de plus de 50 pixels dans l'espace.
Les auteurs soulignent que la fusion de tracklets classique demande d'entraîner à part un réseau siamois, exécuté une fois pour chaque paire de tracklets, soit un coût en ; MambaMOT+ n'a besoin que d'une passe avant par tracklet, soit . Cela dit, le regroupement compare toujours les similarités cosinus deux à deux, et cette étape reste en ; un produit scalaire entre vecteurs coûte simplement bien moins cher que l'exécution d'un réseau.
Notons aussi que cette fusion n'a lieu qu'une fois toute la vidéo suivie ; MambaMOT+ n'est donc plus une méthode en ligne.
Les données d'entraînement
Les données d'entraînement du modèle de mouvement sont les trajectoires des ensembles d'entraînement de MOT17, DanceTrack et SportsMOT. À chaque fois, on découpe au hasard un segment de longueur comprise entre 2 et , complété s'il fait moins de , et la cible est la boîte de vérité terrain de l'image suivante. L'entraînement dure 500 epochs sur une seule RTX 4080.
Discussion
DanceTrack et SportsMOT
| Méthode | HOTA | AssA | IDF1 |
|---|---|---|---|
| ByteTrack | 47.3 | 31.4 | 52.5 |
| OC-SORT | 54.6 | 40.2 | 54.6 |
| MambaMOT | 55.5 | 38.3 | 53.9 |
| MambaMOT+ | 56.1 | 39.0 | 54.9 |
D'après la Table I de l'article, ensemble de test de DanceTrack.
Face à ByteTrack, qui utilise les mêmes détections, MambaMOT gagne 8.2 points de HOTA ; c'est le principal argument de l'article.
Mais à y regarder de près, une bonne partie de ces 8.2 points vient du côté de la détection ; le DetA de ByteTrack est de 71.6, celui de MambaMOT de 80.8, tandis que l'AssA passe de 31.4 à 38.3. Le modèle de mouvement agit surtout sur l'association ; avec les mêmes détections, un écart de plus de 9 points de DetA laisse penser que, dans le tableau, les configurations des deux méthodes diffèrent par autre chose que le seul modèle de mouvement. Le DetA d'OC-SORT, 80.4, est proche de celui de MambaMOT ; c'est une référence plus équitable.
Face à OC-SORT, l'histoire est un peu différente. OC-SORT est une méthode qui retouche le filtre de Kalman ; MambaMOT ne le dépasse que de 0.9 point de HOTA, et fait même moins bien en AssA et en IDF1. Il faut la fusion de trajectoires de MambaMOT+ pour l'emporter de 0.3 en IDF1.
Sur SportsMOT, la situation est similaire. Avec le même détecteur YOLOX, MambaMOT obtient un HOTA de 70.4, OC-SORT 70.2, et MambaMOT+ monte à 71.3. Face aux 62.0 de ByteTrack, MambaMOT a 8.4 points d'avance.
Ce qui manque
L'article est très court, et plusieurs points restent sans réponse :
- Pas d'ablation. Combien d'images en entrée, combien de blocs Mamba, que se passe-t-il sans la perte GIoU ; rien de tout cela n'est testé. On ne sait pas non plus si un LSTM ou un Transformer ferait aussi bien.
- Pas de résultats sur des jeux de données de piétons. Les données d'entraînement contiennent les trajectoires de MOT17, mais les tests ne portent que sur DanceTrack et SportsMOT.
- Pas d'expérience d'un jeu de données à l'autre. Le modèle de mouvement est entraîné sur les trajectoires d'entraînement des trois jeux de données réunis, puis évalué sur les ensembles de test de deux d'entre eux. Son comportement face à des types de mouvement jamais vus n'est pas testé.
- Des comparaisons incomplètes. Le plus fort adversaire du tableau est OC-SORT. DiffMOT, de la même époque, obtient 62.3 de HOTA sur DanceTrack, et Deep OC-SORT 61.3 ; ni l'un ni l'autre ne figure dans le tableau. Ces méthodes utilisent en plus des caractéristiques d'apparence et ne sont pas directement comparables, mais l'article ne permet guère au lecteur de situer Mamba lui-même.
Les ablations de DiffMOT donnent toutefois un repère indirect. Dans le cadre de DiffMOT, parmi les modèles de mouvement appris, le LSTM obtient 51.2 de HOTA, le Transformer 54.6 et le modèle de diffusion 55.7, contre 46.8 pour le filtre de Kalman. Les modèles de mouvement appris font bel et bien mieux que le filtre de Kalman ; quant au choix du modèle de séquence, les écarts sont bien plus faibles.
Vitesse
MambaMOT tourne à 28.8 FPS sur un seul GPU. Les auteurs le comparent aux méthodes de bout en bout comme MOTR, qui restent en général sous les 10 FPS. Le modèle de mouvement, avec ses deux blocs Mamba de 64 dimensions, est en lui-même très léger.
Conclusion
MambaMOT remplace le filtre de Kalman par un petit Mamba, pour voir si le suivi s'en trouve amélioré. Sur les danseurs et les joueurs, c'est le cas ; face à ByteTrack, le HOTA gagne d'un coup plus de 8 points.
L'intérêt d'un modèle à espace d'états sélectif est de pouvoir décider, selon l'entrée, s'il faut croire l'ancienne tendance ou la nouvelle observation, et c'est exactement ce dont les mouvements irréguliers ont besoin. Mais face aux méthodes qui améliorent le filtre de Kalman, comme OC-SORT, il ne lui reste qu'une infime avance ; quant à savoir s'il convient mieux à cette tâche que d'autres modèles de séquence, l'article ne le dit pas.