Article original
Beyond the Image Plane: World-Grounded Queries for Multi-Object Tracking
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2609.00924
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingplanet2026,
  title = {{Beyond the Image Plane: World-Grounded Queries for Multi-Object Tracking}},
  author = {Orcun Cetintas and Guillem Brasó and Tim Meinhardt and Laura Leal-Taixé},
  year = {2026},
  eprint = {2609.00924},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2609.00924}
}
La caméra transforme le monde en relief en une image plate. Deux personnes placées l'une derrière l'autre se superposent dans l'image ; une personne qui marche vers l'objectif n'y est qu'une boîte qui grossit un peu. La profondeur, l'ordre devant-derrière et la vraie direction du mouvement sont écrasés par la projection.
Le traqueur, lui aussi, ne voit que ce plan. Qu'il compare l'apparence, le recouvrement des boîtes ou qu'il prédise leur déplacement, tout se passe dans le plan image, et il hérite du même coup de toutes ces ambiguïtés.
Depuis un ou deux ans, des modèles de fondation géométriques comme VGGT ou Depth Anything 3 savent estimer directement, à partir d'une vidéo ordinaire, la structure 3D de toute la scène et les paramètres de la caméra. Les auteurs de SUSHI et de NOOUGAT (Orcun Cetintas, Guillem Brasó, Tim Meinhardt et Laura Leal-Taixé) veulent voir si l'injection de ces informations 3D estimées dans un traqueur l'aide à y voir plus clair.
Définir le problème
Utiliser l'information 3D pour le suivi n'a rien de nouveau. Certaines méthodes estiment la visibilité des piétons pour raisonner sur les occultations, d'autres convertissent les trajectoires en coordonnées du monde, d'autres encore utilisent des modèles 3D du corps humain. Certaines ajoutent aussi des contraintes de profondeur au filtre de Kalman, ou prédisent les trajectoires en vue de dessus.
Les auteurs relèvent que, dans ces approches, l'information 3D est soit liée à une catégorie précise, par exemple réservée aux piétons, soit ajoutée seulement au stade de l'association, comme règle ou coût supplémentaire, une fois la représentation de l'objet déjà formée. La représentation interne des objets dans le traqueur reste purement 2D.
L'autre problème est le temps. Les traqueurs à requêtes de bout en bout ne voient en général que 2 à 10 images à l'entraînement, et à l'inférence, leur regard en arrière est lui aussi limité ; MOTIP, sur lequel s'appuie PLANET, peut voir les 30 images passées, soit une ou deux secondes dans une vidéo ordinaire. Une personne cachée plus longtemps sort de sa mémoire.
PLANET veut faire entrer l'information 3D dès la formation des requêtes, et la rendre utilisable sur une plage de temps plus longue.
Résoudre le problème
D'abord, passer le jeu de données en 3D
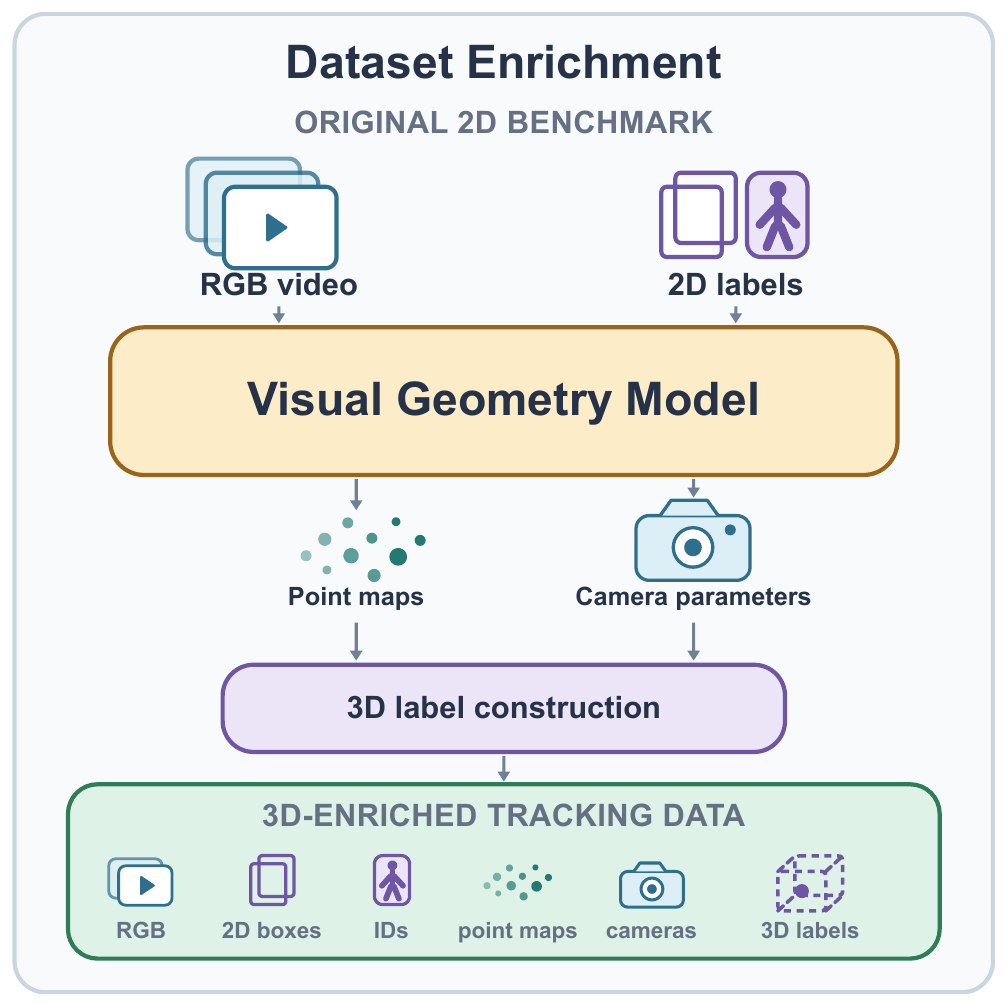
DanceTrack, SportsMOT et BFT ne contiennent que des boîtes 2D. La première étape consiste à les passer en 3D.
Les auteurs traitent chaque vidéo entière avec la version longues séquences de Depth Anything 3 ; profondeur et paramètres de caméra sont estimés sur des fenêtres temporelles qui se chevauchent, et une fermeture de boucle limite la dérive accumulée sur la durée. Après rétroprojection de la profondeur et des paramètres de caméra estimés, chaque pixel de chaque image correspond à un point dans les coordonnées du monde ; c'est ce qu'on appelle une carte de points.
La carte de points couvre toute la scène, sans dire quels points appartiennent à quelle personne. Pour chaque boîte 2D annotée, les auteurs prennent la position moyenne des points contenus dans la boîte comme centre 3D de l'objet :
- Une boîte qui n'est pas du tout occultée est utilisée telle quelle.
- Une boîte occultée mêle premier plan et arrière-plan ; les auteurs combinent la profondeur des images voisines, celle de l'image courante et la position de la boîte dans l'image pour déterminer prudemment quelle partie correspond à l'objet.
- On vérifie la cohérence le long de la trajectoire. Les cas encore incertains sont marqués invalides et ne servent pas à l'entraînement.
Ces centres 3D ne donnent que la position, sans la taille ni l'orientation de l'objet ; ce sont des « pseudo-étiquettes » estimées.
Des requêtes qui voient la 3D dès leur formation
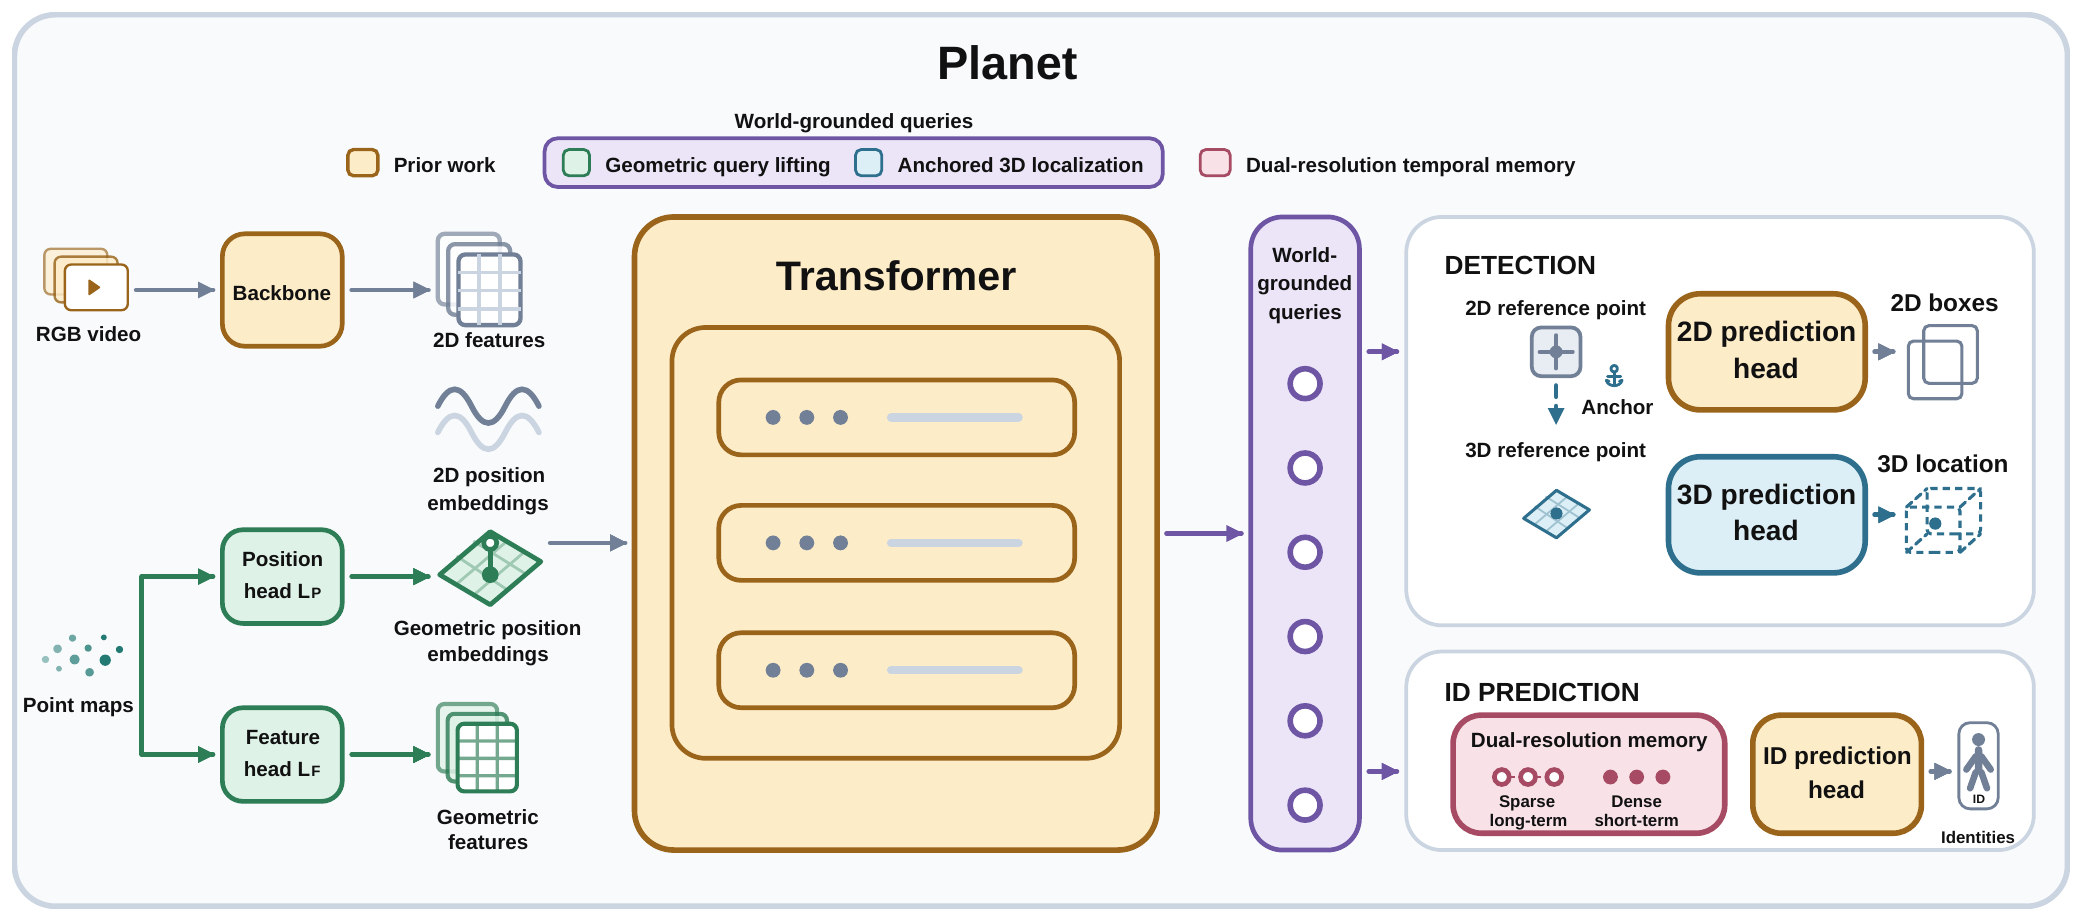
PLANET s'appuie sur MOTIP. La particularité de MOTIP est que la détection et la prédiction d'identité partagent le même ensemble de requêtes ; chaque requête doit à la fois produire une boîte et prédire à quel identifiant cette boîte appartient. Il suffit donc que les requêtes contiennent de l'information 3D pour que la détection et l'association en profitent toutes les deux.
Les auteurs font entrer la 3D dans les requêtes de deux façons.
Relèvement géométrique des requêtes. La carte de points passe par deux petits réseaux apprenables. L'un produit des caractéristiques géométriques, ajoutées directement aux caractéristiques d'image du backbone ; l'autre produit un plongement de position géométrique, concaténé à l'encodage positionnel 2D d'origine avant fusion. Quand le Transformer met à jour les requêtes, les caractéristiques et les positions qu'il voit portent la structure 3D de la scène.
Localisation 3D ancrée. Dans Deformable DETR, chaque requête a un point de référence 2D qui guide la prédiction de la boîte. Les auteurs relèvent ce point de référence 2D, via la carte de points, en un point de référence 3D correspondant ; une petite tête de prédiction 3D prédit ensuite, à partir de la requête, un résidu qui corrige ce point pour obtenir le centre 3D de l'objet. Cette prédiction, supervisée par les pseudo-étiquettes 3D construites plus haut, est une tâche auxiliaire.
Le but de la tâche auxiliaire est de forcer chaque requête à retenir la position de son objet dans l'espace 3D. Deux personnes qui se superposent dans l'image, l'une devant, l'autre derrière, doivent avoir des requêtes porteuses de positions 3D différentes.
Pourquoi « ancrer » sur le point de référence 2D plutôt que d'apprendre un point de référence 3D indépendant ? Parce que le backbone et le détecteur ont déjà acquis de très bonnes capacités de localisation sur de grandes quantités de données 2D. En partant du point de référence 2D, la localisation 3D n'a qu'une correction à apprendre, sans repartir de zéro.
Une mémoire à double résolution : voir plus loin avec les mêmes places
L'information 3D peut aider à reconnaître une personne qui a été cachée, à condition que le traqueur se souvienne encore d'elle. La troisième idée de PLANET est d'allonger la durée sur laquelle il peut regarder en arrière, sans augmenter la capacité de la mémoire.
Il s'agit de couper la mémoire en deux. Une moitié est réservée aux dernières images consécutives et conserve les détails à court terme ; l'autre moitié est réservée à l'historique plus ancien, avec une image prélevée seulement toutes les quelques images. À l'entraînement, l'intervalle d'échantillonnage varie aussi au hasard, pour habituer le modèle à un passé aux intervalles irréguliers.
L'article ne donne ni la capacité ni l'intervalle exacts, et dit seulement que la portée passe des 30 images de MOTIP à environ 200 images. Des chiffres supposés en donnent une idée :
| Approche | Places | Images récentes | Échantillons anciens | Portée |
|---|---|---|---|---|
| Tout en continu | 30 | 30 | — | 30 images |
| Double résolution | 30 | 15 | 15, une image sur 12 | 15 + 15 × 12 = 195 images |
Exemple de calcul établi pour cette note ; la capacité de 30 reprend les 30 images de MOTIP, et l'intervalle d'échantillonnage de 12 est une valeur supposée.
La mémoire stocke les requêtes en sortie finale du détecteur, qui portent déjà l'information 3D ; cette mémoire allongée conserve donc aussi les indices 3D. Ce changement n'ajoute aucun temps d'entraînement.
Discussion
L'apport de chaque élément
| Configuration | HOTA | AssA | DetA | IDF1 |
|---|---|---|---|---|
| Référence MOTIP | 63.0 | 53.2 | 75.0 | 66.6 |
| + relèvement géométrique | 64.0 | 54.3 | 75.9 | 67.6 |
| + localisation 3D ancrée | 64.4 | 54.9 | 76.1 | 67.8 |
| + mémoire double résolution | 65.6 | 56.9 | 76.1 | 70.3 |
D'après la Table 1 de l'article ; moyenne de 5 entraînements par configuration.
Le relèvement géométrique des requêtes fait progresser à la fois la détection et l'association, avec environ 1 point de plus en DetA comme en AssA. La localisation 3D ancrée aide surtout l'association, avec 0.6 point d'AssA contre seulement 0.2 de DetA. La mémoire à double résolution agit entièrement sur l'association ; le DetA ne bouge pas, l'AssA gagne 2 points et l'IDF1 2.5.
Les auteurs examinent aussi l'interaction entre mémoire et 3D. Avec la même mémoire à double résolution, un modèle purement 2D gagne 1.5 point d'IDF1, un modèle avec la 3D en gagne 2.5. Les indices 3D sont plus stables, et plus on s'en souvient longtemps, plus ils servent.
Comment faire entrer la 3D
| Approche | HOTA | AssA | IDF1 |
|---|---|---|---|
| Référence MOTIP | 63.0 | 53.2 | 66.6 |
| Fusion directe des caract. de Depth Anything 3 | 63.1 | 53.1 | 66.6 |
| Requêtes ancrées dans le monde | 64.4 | 54.9 | 67.8 |
D'après la Table 4 de l'article.
L'approche la plus intuitive consiste à brancher directement les caractéristiques du modèle de fondation 3D sur le traqueur. Le résultat n'aide presque pas ; le HOTA ne gagne que 0.1, et l'AssA et l'IDF1 ne progressent pas. Ces caractéristiques ont été entraînées pour estimer la géométrie, et le traqueur ne sait pas quoi en faire.
Une autre comparaison porte sur la localisation 3D. Avec la même supervision 3D, si la tête de prédiction 3D utilise un point de référence 3D appris indépendamment, le HOTA tombe même de 64.0 à 63.8 ; ancré sur le point de référence 2D, il monte à 64.4.
L'information 3D est utile en soi, mais le traqueur ne peut s'en servir que si elle a une place précise lors de la formation des requêtes et une tâche précise dans l'objectif d'entraînement.
Trois jeux de données
| Benchmark | MOTIP | PLANET | AssA : MOTIP → PLANET |
|---|---|---|---|
| DanceTrack | 69.6 | 72.1 | 60.4 → 63.9 |
| SportsMOT | 72.6 | 73.7 | 63.2 → 63.2 |
| BFT | 70.5 | 72.6 | 71.8 → 73.9 |
HOTA ; DanceTrack d'après la Table 5 de l'article, SportsMOT d'après la Table 6, BFT d'après la Table 7, tous sur les ensembles de test.
PLANET est premier sur les trois jeux de données, en n'utilisant pour chacun que ses propres données d'entraînement, sans données supplémentaires comme CrowdHuman. Certaines méthodes des tableaux de comparaison en utilisent.
C'est sur DanceTrack qu'il progresse le plus ; côté association, l'AssA gagne 3.5 points, et l'IDF1 passe de 74.7 à 78.0. Des danseurs habillés pareil qui ne cessent de se croiser, c'est exactement la scène la plus confuse dans le plan image. Sur SportsMOT, l'AssA reste à 63.2, comme MOTIP, et tout le progrès vient de la détection ; le DetA passe de 83.5 à 86.0, et le MOTA de 92.4 à 95.2.
NOOUGAT, des mêmes auteurs un an plus tôt, obtient dans sa version hors ligne un HOTA de 68.4 sur DanceTrack, et ne figure pas dans les tableaux de comparaison de cet article. Les deux suivent des voies différentes ; NOOUGAT utilise un détecteur existant et se concentre sur l'apprentissage de l'association, alors que PLANET est de bout en bout, et que détection et association profitent ensemble de la 3D.
Ce qui reste à préciser
L'article vient de paraître sur arXiv et n'a pas encore de lieu de publication ; le code et les jeux de données passés en 3D ne seront publiés, selon les auteurs, qu'après acceptation de l'article.
L'article n'a pas de section sur les limites, et le lecteur voudra sans doute savoir certaines choses. À l'inférence, PLANET a besoin de la carte de points de chaque image, et donc d'une exécution préalable de Depth Anything 3. L'article annonce 12 images par seconde en FP32 et 20 en FP16, comparable à MOTIP, sans préciser si le temps de cette étape est inclus. La qualité des pseudo-étiquettes 3D dépend aussi du modèle géométrique ; l'article explique comment filtrer les étiquettes incertaines, mais n'évalue pas leur précision. Enfin, l'article ne dit pas clairement sur quel découpage de quel jeu de données portent les ablations.
Conclusion
Puisqu'on sait désormais estimer la structure 3D d'une scène à partir d'une vidéo ordinaire, PLANET essaie de la faire entrer dans le traqueur.
La méthode repose sur trois points. D'abord, passer les jeux de données 2D existants en 3D, pour obtenir des cartes de points et le centre 3D de chaque boîte. Ensuite, faire entrer l'information 3D dès la formation des requêtes, et forcer celles-ci, par une tâche auxiliaire ancrée sur le point de référence 2D, à retenir la position 3D de leur objet. Enfin, une mémoire à double résolution allonge, à capacité égale, la durée de regard en arrière jusqu'à environ 200 images.
La comparaison la plus intéressante des ablations montre que brancher directement les caractéristiques d'un modèle de fondation 3D ne sert presque à rien. L'information 3D ne donne sa mesure que placée là où le traqueur s'en sert vraiment.