Article original
Multiple Object Tracking as ID Prediction
- Publication
- CVPR 2025Conférence
- Premier dépôt sur arXiv
- arXiv:2403.16848
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingmotip2024,
  title = {{Multiple Object Tracking as ID Prediction}},
  author = {Ruopeng Gao and Ji Qi and Limin Wang},
  year = {2024},
  eprint = {2403.16848},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.16848}
}
À ce stade, nous avons vu deux grandes familles de traqueurs.
La première détecte puis associe. La détection est confiée à un détecteur spécialisé, et l'association repose sur des règles conçues à la main : un filtre de Kalman prédit la position, l'IoU ou une distance d'apparence donne le coût, l'algorithme hongrois fait l'appariement, et on ajoute une pile de seuils. Ces règles marchent très bien sur des piétons, mais chaque nouvelle situation exige que quelqu'un analyse, modifie et règle à nouveau les paramètres. De SORT à Deep OC-SORT, puis C-BIoU et UCMCTrack, c'est la voie suivie.
La seconde est la lignée MOTR, de bout en bout, où une requête de piste se transmet d'une image à l'autre, et détection et suivi se font ensemble dans le décodeur. L'association ne dépend plus de règles écrites à la main, mais les deux sortes de requêtes, entassées dans le même décodeur, se gênent mutuellement, et c'est souvent la détection qui en pâtit. MOTRv2 a fini par rendre la détection à YOLOX.
Ruopeng Gao et Limin Wang, de l'Université de Nankin, et Ji Qi, de China Mobile (Suzhou) Software Technology, se demandent s'il est possible de garder la répartition des rôles « détecter puis associer » tout en confiant entièrement l'association à un modèle appris.
Leur réponse s'appelle MOTIP. C'est l'article qui suit MeMOTR chez Ruopeng Gao, et la méthode est d'une simplicité surprenante.
Définir le problème
L'association ressemble beaucoup à un problème de classification. Dans les données d'entraînement, chaque trajectoire a un ID ; étant donné une boîte de détection, décider à quelle trajectoire elle appartient, n'est-ce pas prédire son ID ?
Le problème, c'est l'inférence. Les vidéos de test ne montrent que des personnes jamais vues, avec des ID nouveaux, et un modèle ne peut pas ranger quelqu'un dans une classe qui n'est jamais apparue pendant l'entraînement.
C'est pourquoi une méthode comme FairMOT, qui apprend ses caractéristiques d'apparence avec une perte de classification, doit changer de procédé à l'inférence : on extrait les caractéristiques, on calcule une similarité cosinus, puis des règles écrites à la main font l'appariement. Entraînement et inférence font en réalité deux choses différentes.
Pour les auteurs, le point de blocage est que l'ID d'un suivi et l'étiquette d'une classification ordinaire sont de nature différente.
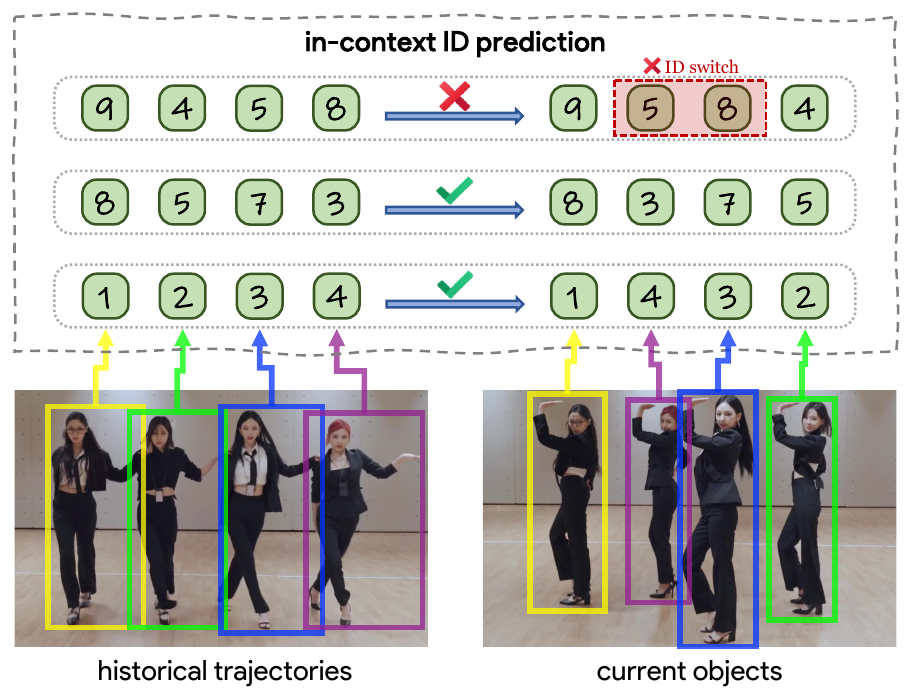
Dans une classification ordinaire, « chat » veut dire chat ; l'étiquette a un sens. L'ID d'un suivi n'en a aucun. Les quatre personnes numérotées 1, 2, 3, 4 dans le fichier de vérité terrain pourraient tout aussi bien s'appeler 8, 5, 7, 3, pourvu que chacune garde le même numéro du début à la fin. L'ID n'est qu'un dossard, qui dit « ces boîtes sont la même personne » ; le numéro inscrit dessus n'a aucune importance.
Résoudre le problème
Prédire l'ID en contexte
Puisque le numéro lui-même n'a pas d'importance, laissons le modèle regarder « les dossards portés par les trajectoires historiques » et prédire lequel revient à chaque nouvelle détection.
Concrètement, chaque trajectoire passée reçoit au hasard un numéro , avec . Quand une nouvelle image arrive, si une détection appartient à la -ième trajectoire, la bonne réponse est .
Comme le numéro est un indice fourni avec chaque trajectoire, les auteurs parlent de prédiction d'ID en contexte (in-context ID prediction). Ainsi, quel que soit le nombre de nouveaux visages au test, il s'agit toujours de prédire un numéro entre 1 et , dans la plage vue à l'entraînement. On peut distribuer les numéros comme on veut ; la prédiction est juste dès qu'elle concorde avec l'historique, et c'est exactement ce que disent les trois rangées de la Figure 1.
Trois pièces
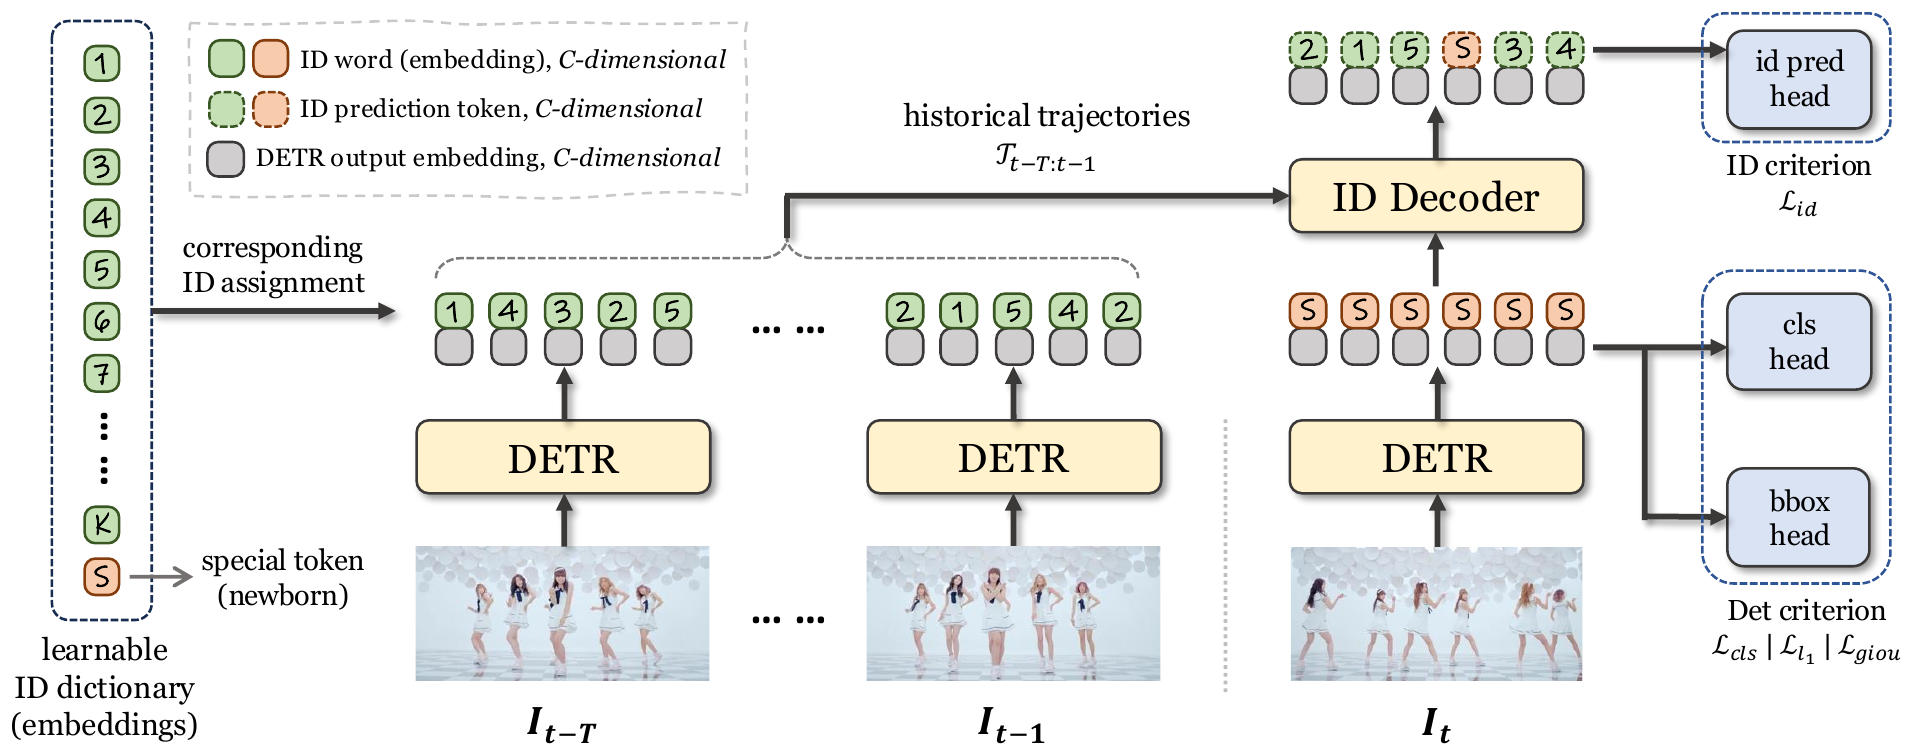
L'architecture ne compte que trois pièces.
Le détecteur DETR. Un Deformable DETR avec un ResNet-50 comme backbone (réseau de base). L'intérêt est que les embeddings de sortie du décodeur peuvent servir directement de caractéristiques d'objet, sans recadrer les boîtes ni faire de RoI pooling. Chaque objet reçoit une caractéristique de 256 dimensions.
Le dictionnaire d'ID. Un ensemble de embeddings appris de 256 dimensions :
Les premiers représentent les numéros ordinaires, le dernier, , représente « nouvel objet ». Les auteurs n'ont pas utilisé d'encodage one-hot, parce qu'il se prête mal à l'entraînement et que le plafond des numéros serait alors lié à la dimension des vecteurs. Par défaut ; il suffit que ce soit au moins le nombre maximal d'objets dans une image.
Le décodeur d'ID. Un décodeur Transformer standard, alternant auto-attention et attention croisée, suivi d'une tête de classification linéaire qui produit les probabilités des classes.
Comment un objet devient un token
Suivons une trajectoire du début à la fin.
Une trajectoire déjà suivie a reçu le numéro . Chacune de ses boîtes des dernières images a une caractéristique DETR . On concatène directement la caractéristique et l'embedding du numéro :
Chaque token fait 512 dimensions ; la première moitié dit « à quoi il ressemble », la seconde « quel numéro il porte ». Tous les tokens de cette trajectoire sur les dernières images forment son historique. vaut 29 images sur DanceTrack et 59 sur SportsMOT.
Les détections de l'image courante, dont on ignore encore l'identité, reçoivent toutes le symbole de nouvel objet :
On envoie ensuite le tout dans le décodeur d'ID, avec les détections courantes comme requêtes et tous les tokens historiques comme clés et valeurs. L'attention croisée y permet à chaque détection de chercher dans l'historique « quel numéro porte la série de tokens qui lui ressemble le plus » ; l'auto-attention permet aux détections d'une même image d'échanger des informations, pour éviter que deux personnes très semblables se disputent le même numéro. Pour finir, la tête de classification donne la probabilité que chaque détection appartienne à chaque numéro.
Si la détection appartient à la -ième trajectoire, la réponse est ; s'il s'agit d'une personne qui vient d'apparaître, la réponse est la classe « nouvel objet ». L'association devient ainsi un problème de classification à classes, qu'on peut entraîner directement par entropie croisée, en l'ajoutant aux pertes de détection de DETR :
Les quatre poids valent respectivement 2, 5, 2 et 1.
Inférence : distribuer et récupérer les dossards
À l'inférence, le déroulement est direct :
- Les numéros de 1 à sont distribués dans l'ordre aux trajectoires, sans doublon. Quand une trajectoire se termine, son numéro est récupéré pour une nouvelle trajectoire. Si longue que soit la vidéo et si nombreuses que soient les personnes, il suffit donc qu'il n'y ait jamais plus de trajectoires suivies en même temps.
- Les sorties de DETR sont d'abord filtrées avec un seuil de confiance de 0.3.
- Les détections restantes passent dans le décodeur d'ID, et chacune choisit le numéro de plus forte probabilité, à condition que cette probabilité dépasse 0.2.
- Si deux détections d'une même image choisissent le même numéro, seule celle de plus forte confiance le garde.
- Une détection restée sans numéro et dont la confiance dépasse 0.6 est traitée comme un nouvel objet et reçoit un nouveau dossard.
Par défaut, il n'y a pas d'algorithme hongrois. Les auteurs estiment qu'une stratégie d'attribution plus élaborée pourrait sans doute gagner un peu, mais ce qu'ils veulent vérifier, c'est la capacité du modèle lui-même.
Ils ont aussi mesuré que, dans la plupart des cas, moins de 40 % des numéros sont utilisés. Face à une scène extrêmement dense, il suffit d'augmenter , tout comme DETR prévoit par défaut 300 requêtes.
À l'entraînement, fabriquer des erreurs exprès
À l'entraînement, les trajectoires historiques sont construites à partir de la vérité terrain, et chacune est parfaitement propre. À l'inférence, il en va autrement. Des personnes sont occultées, le modèle distribue de mauvais numéros, et ces erreurs s'inscrivent ensuite dans l'historique.
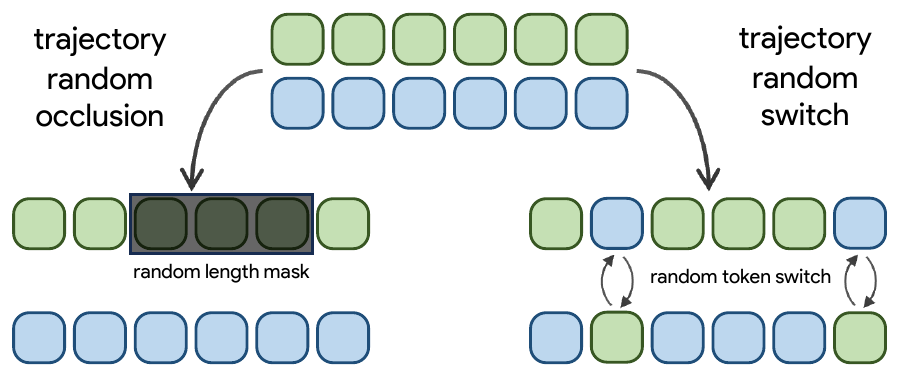
Pour habituer le modèle à un historique imparfait, les auteurs ajoutent deux augmentations de trajectoire :
- Occultation aléatoire : avec une probabilité , on retire une portion de tokens au milieu d'une trajectoire, pour simuler une personne cachée.
- Échange aléatoire : avec une probabilité , on intervertit les numéros de deux trajectoires dans une même image, pour simuler un modèle qui confond deux personnes semblables.
Les deux probabilités sont fixées à 0.5.
Par ailleurs, comme détection et association sont deux modules séparés, l'entraînement se parallélise. On prend à chaque fois un extrait de images ; le DETR de chaque image peut faire sa passe avant en même temps, et le décodeur d'ID utilise un masque d'attention pour ne pas voir le futur ; seul le DETR de 4 de ces images doit faire la rétropropagation. Avec 8 RTX 4090, l'entraînement sur DanceTrack prend moins d'une journée.
Discussion
Les auteurs veillent à comparer à conditions égales, et les résultats principaux utilisent tous Deformable DETR avec ResNet-50, sans jeu de données de détection supplémentaire. Selon eux, entraîner sur de fausses vidéos obtenues en faisant glisser des images fixes comme celles de CrowdHuman ne convient pas aux méthodes de bout en bout, surtout à celles qui doivent modéliser de longues durées.
DanceTrack
| Méthode | HOTA | DetA | AssA | IDF1 |
|---|---|---|---|---|
| OC-SORT | 55.1 | 80.3 | 38.3 | 54.6 |
| C-BIoU | 60.6 | 81.3 | 45.4 | 61.6 |
| DiffMOT | 62.3 | 82.5 | 47.2 | 63.0 |
| MeMOTR | 63.4 | 77.0 | 52.3 | 65.5 |
| CO-MOT | 65.3 | 80.1 | 53.5 | 66.5 |
| MOTIP | 69.6 | 80.4 | 60.4 | 74.7 |
| MOTRv2 (données suppl.) | 69.9 | 83.0 | 59.0 | 71.7 |
| MOTIP (données suppl.) | 72.0 | 81.8 | 63.5 | 76.8 |
D'après la Table 1 de l'article, ensemble de test de DanceTrack.
Sans données supplémentaires, MOTIP obtient 69.6, soit 4.3 points de plus que CO-MOT, qui utilise lui aussi Deformable DETR, 6.9 de plus en AssA, et plus de 8 points de plus en IDF1. La version avec données supplémentaires monte à 72.0 et dépasse MOTRv2.
Les 63.4 de MeMOTR dans ce tableau correspondent à sa version passée au Deformable DETR standard ; le tableau principal de l'article MeMOTR, avec DAB-Deformable-DETR, annonce 68.5. Même face à 68.5, MOTIP garde une avance nette, mais les deux ne reposent pas sur le même cadre de détection.
SportsMOT et les oiseaux
Sur SportsMOT, avec le seul ensemble d'entraînement, MOTIP obtient un HOTA de 72.6 et un AssA de 63.2, au-dessus d'OC-SORT dans les mêmes conditions (68.1) et de la version Deformable DETR de MeMOTR (68.8), et même au-dessus de DiffMOT, qui utilise des données supplémentaires (72.1).
Cela dit, le meilleur résultat sur SportsMOT revient à l'approche de Deep-EIoU : un détecteur YOLOX entraîné sur les ensembles d'entraînement et de validation, plus un modèle ReID, pour un HOTA de 77.2. Les données d'entraînement et les détecteurs diffèrent, on ne peut donc pas comparer directement, mais cela rappelle que, dans les scènes de sport, un détecteur puissant associé à des règles simples reste très compétitif.
Les auteurs testent aussi un jeu de données de suivi d'oiseaux, BFT, qui compte 22 espèces et 106 vidéos. Les oiseaux volent dans un espace en trois dimensions, avec des mouvements plus irréguliers que ceux des gens au sol, et n'ont pas de vêtements pour se distinguer. MOTIP obtient un HOTA de 70.5, OC-SORT 66.8, ByteTrack 62.5.
Auto-attention et algorithme hongrois
Les ablations sont menées sur l'ensemble de validation de DanceTrack :
| Auto-att. | Hongrois | Augm. | HOTA | AssA |
|---|---|---|---|---|
| 57.7 | 43.9 | |||
| ✓ | 59.7 | 47.2 | ||
| ✓ | 59.5 | 47.2 | ||
| ✓ | ✓ | 59.9 | 47.9 | |
| ✓ | ✓ | 62.2 | 51.5 | |
| ✓ | ✓ | ✓ | 62.2 | 51.8 |
D'après la Table 4 de l'article, ensemble de validation de DanceTrack ; Augm. = augmentation de trajectoire.
- Sans auto-attention, l'algorithme hongrois sert. On passe de 57.7 à 59.7. Sans auto-attention, chaque détection choisit son numéro seule, sans savoir ce qu'ont choisi les autres ; il faut une attribution globale pour éviter les conflits.
- Avec l'auto-attention, l'algorithme hongrois ne sert presque plus à rien. Il n'apporte que 0.4 point, et une fois l'augmentation de trajectoire ajoutée, le score est exactement le même. Selon les auteurs, l'auto-attention fait que les détections d'une même image échangent leurs informations d'identité dès le décodage ; le modèle a appris de lui-même à faire l'attribution globale.
- L'augmentation de trajectoire apporte 2.7 points. De 59.5 à 62.2, c'est le plus grand pas du tableau.
Il faut aussi doser l'augmentation. Avec la seule occultation aléatoire, 0.5 est le meilleur réglage (60.7), et en masquant à 1.0 on retombe à 58.6 ; en ajoutant l'échange aléatoire à une occultation de 0.5, 0.5 est encore le meilleur réglage (62.2), et à 0.8 on chute à 59.8.
Face à la ReID
MOTIP suit lui aussi les objets à partir de leurs caractéristiques, et ressemble beaucoup à une méthode ReID. Les auteurs le comparent à deux façons courantes d'entraîner une ReID, la classification à la FairMOT et l'apprentissage contrastif, qui utilisent toutes deux la similarité cosinus à l'inférence.
Avec DETR gelé et seule la partie association entraînée, la variante façon FairMOT n'obtient qu'un HOTA de 29.4, l'apprentissage contrastif 41.0, et la prédiction d'ID de MOTIP 55.4. Quand tous les paramètres sont entraînés ensemble, les méthodes ReID, même avec l'algorithme hongrois et un module de renforcement des trajectoires de même structure que le décodeur d'ID, plafonnent à 54.5 ; MOTIP atteint 59.5.
Mêmes caractéristiques, mais une autre façon d'entraîner, « prédire un numéro en regardant le contexte », et l'écart atteint 5 points ou plus. Selon les auteurs, les méthodes ReID intègrent l'historique avec des règles écrites à la main et calculent les similarités une à une, ce qui bride la souplesse du modèle ; MOTIP laisse le modèle décider lui-même comment lire les trajectoires historiques.
Limites
Sur MOT17, MOTIP obtient un HOTA de 59.3, à peu près comme CO-MOT (60.1) et MOTRv3 (60.2) parmi les méthodes de bout en bout, mais nettement derrière les méthodes heuristiques comme ByteTrack (63.1). L'explication des auteurs est que MOT17 ne compte que 7 vidéos d'entraînement, trop peu pour une méthode qui doit apprendre des données, alors que les méthodes heuristiques sont peaufinées depuis près de dix ans pour le mouvement linéaire des piétons.
Côté vitesse, sur une RTX A5000, MOTIP tourne à 12.7 images par seconde en FP32, à peu près comme les 13.1 de MOTR ; en FP16, il atteint 22.8 images.
Les auteurs précisent aussi que la conception est volontairement simple, pour vérifier que l'idée de « traiter le suivi comme une prédiction d'ID » tient la route ; il reste beaucoup de place pour ajouter d'autres indices, comme le mouvement ou la profondeur.
Conclusion
MOTIP réécrit l'association du suivi multi-objets en un problème de prédiction d'ID en contexte. Des numéros sont distribués au hasard aux trajectoires historiques, et le modèle n'a qu'à regarder ces numéros pour prédire lequel revient à chaque nouvelle détection. Le modèle entier se résume à DETR, un dictionnaire d'ID et un décodeur Transformer standard ; pas de filtre de Kalman, pas de matrice de coût, pas même d'algorithme hongrois. Il dépasse pourtant les méthodes précédentes sur DanceTrack, sur SportsMOT et sur le suivi d'oiseaux.
Le résultat le plus intéressant des ablations, c'est la mise hors jeu de l'algorithme hongrois. Ce composant, présent depuis SORT, est remplacé dans MOTIP par une couche d'auto-attention.
Avec le recul, c'est ainsi que les métriques d'évaluation voyaient déjà les ID. CLEAR MOT établit les correspondances image par image, IDF1 apparie un à un identités réelles et identités calculées sur toute la vidéo ; ni l'une ni l'autre ne se soucie de savoir si le traqueur a donné le numéro 3 ou le 87, seulement si une même personne a toujours gardé le même dossard. MOTIP apprend simplement au modèle à comprendre les ID de la même façon.