Article original
MeMOTR: Long-Term Memory-Augmented Transformer for Multi-Object Tracking
- Publication
- ICCV 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2307.15700
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingmemotr2023,
  title = {{MeMOTR: Long-Term Memory-Augmented Transformer for Multi-Object Tracking}},
  author = {Ruopeng Gao and Limin Wang},
  year = {2023},
  eprint = {2307.15700},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2307.15700}
}
MOTR représente chaque trajectoire par une requête de piste ; à chaque image, cette requête passe par le décodeur, est mise à jour, puis transmise à l'image suivante. L'identité de l'objet se maintient grâce à cette chaîne de transmissions.
Le problème, c'est que la requête de chaque image ne voit que l'image précédente. Qu'un danseur soit caché quelques images, qu'il pivote ou qu'il croise quelqu'un habillé pareil, et la sortie de cette image peut devenir peu fiable ; or la requête de l'image suivante est tirée de cette sortie peu fiable.
Ruopeng Gao et Limin Wang (également auteur correspondant de SportsMOT), de l'Université de Nanjing, veulent que les requêtes de piste se souviennent un peu plus du passé. Ils dotent chaque trajectoire d'une mémoire à long terme, mise à jour très lentement, qui stabilise la requête de piste. C'est MeMOTR.
Définir le problème
Les auteurs relèvent deux problèmes des traqueurs à requêtes comme MOTR.
Seules deux images consécutives sont exploitées. Qu'elles fusionnent des requêtes ou des caractéristiques, la plupart des méthodes n'exploitent explicitement que l'information de deux images consécutives. La requête de piste a beau être mise à jour sans cesse, elle n'a pas de représentation stable à long terme. Quand la requête d'une même personne change trop d'une image à l'autre, les erreurs d'association arrivent vite. Le MeMOT antérieur stockait les caractéristiques passées dans une grande banque de mémoire, mais à un coût de stockage élevé.
Requêtes de détection et requêtes de piste ne sont pas au même niveau. Les requêtes d'objet apprenables de DETR jouent plutôt le rôle de boîtes d'ancrage apprenables, sans grande sémantique propre. Les requêtes de piste, elles, viennent de la sortie de l'image précédente, et savent déjà quelle catégorie elles représentent et où elles se trouvent. Envoyer ces deux types de requêtes ensemble, dès le départ, dans le même décodeur crée un écart sémantique entre elles.
Résoudre le problème
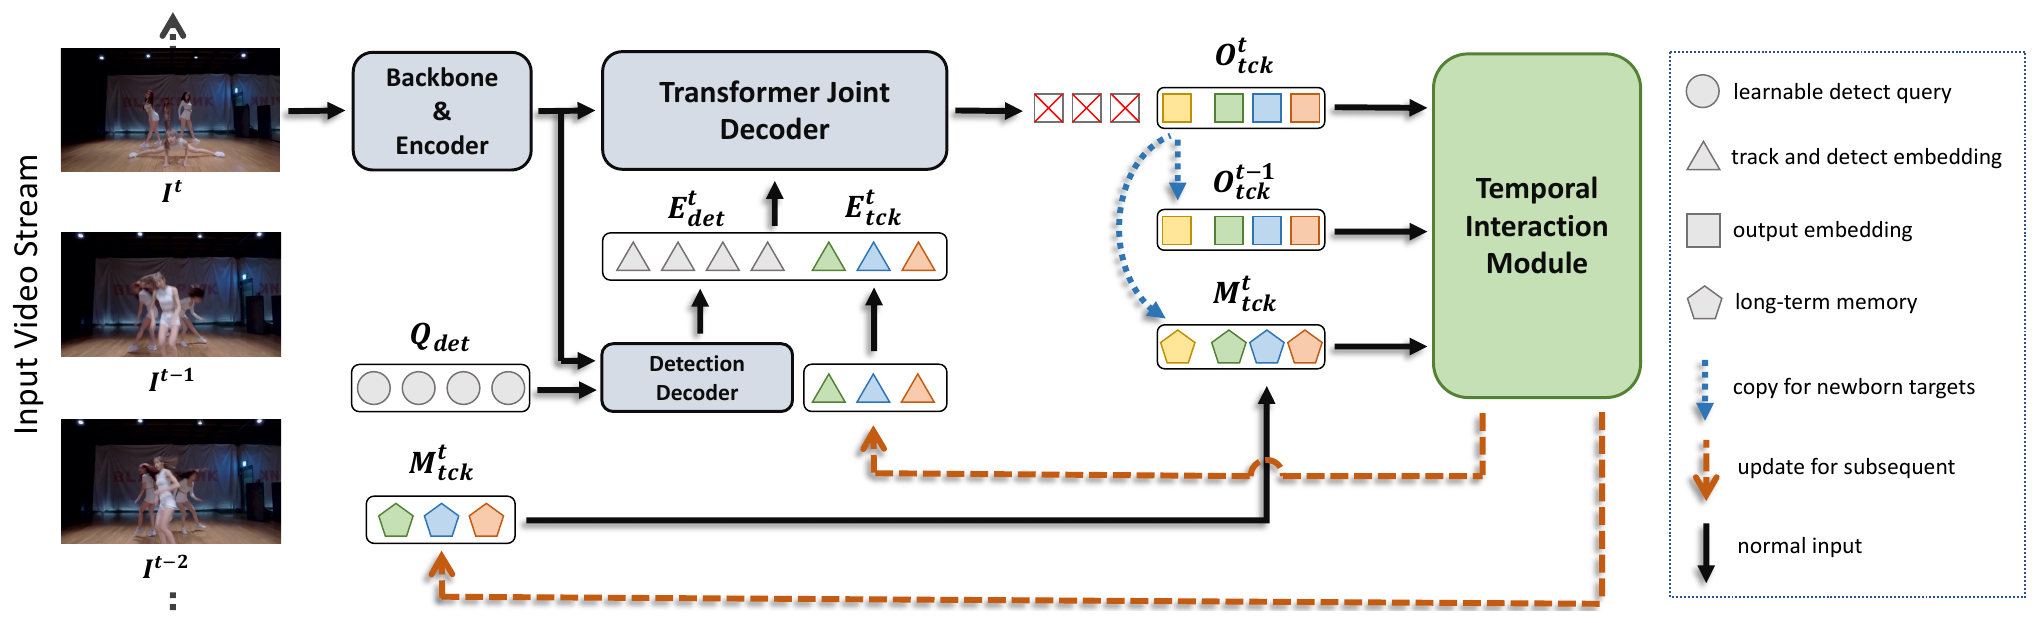
L'architecture d'ensemble ressemble beaucoup à celle de MOTR ; un backbone (réseau de base) ResNet-50 et un encodeur Transformer extraient les caractéristiques de l'image, et le décodeur traite à la fois la détection et le suivi. Les différences sont au nombre de trois : un décodeur scindé en deux, une mémoire à long terme en plus pour chaque trajectoire, et un module d'interaction temporelle qui produit les embeddings de piste de l'image suivante. Le cadre de détection est DAB-Deformable-DETR ; les auteurs fournissent aussi une version avec le Deformable-DETR standard, pour une comparaison équitable avec MOTR.
Donner d'abord un peu de sens aux requêtes de détection
Le décodeur d'origine compte 6 couches. MeMOTR en extrait la première pour en faire un décodeur de détection, qui ne traite que les requêtes de détection. En traversant cette couche, les requêtes de détection trouvent à peu près la position et la catégorie des objets, et deviennent des embeddings de détection porteurs de sémantique.
Les embeddings de détection sont ensuite concaténés aux embeddings de piste , puis envoyés dans le décodeur conjoint formé des 5 couches restantes. Les deux types de requêtes savent alors déjà « ce qu'elles cherchent », et partent sur un pied plus égal.
Mémoire à long terme
Chaque nouvelle trajectoire initialise une mémoire à long terme avec sa sortie du moment. Ensuite, à chaque image, elle est mise à jour ainsi :
est la sortie du décodeur pour cette trajectoire à l'image . C'est une moyenne mobile exponentielle (EMA), avec .
0.01, c'est très petit. L'hypothèse des auteurs est qu'un objet ne se déforme et ne se déplace que légèrement sur quelques images consécutives ; ses caractéristiques sémantiques devraient donc évoluer très lentement, et la mémoire se mettre à jour en douceur.
Calculons combien de temps dure ce souvenir. La sortie d'une image entre dans la mémoire avec un poids , puis ce poids est multiplié par 0.99 à chaque image. ; au bout d'environ 69 images, l'influence de cette image est donc réduite de moitié. Les vidéos de DanceTrack étant à 20 images par seconde, cela fait environ 3 secondes et demie. Globalement, cette mémoire correspond à peu près à la moyenne des 100 dernières images, soit 5 secondes.
Qu'un danseur se retourne ou reste caché deux ou trois secondes, et le bruit de ces quelques images ne fait presque pas dévier cette mémoire.
Module d'interaction temporelle
Comment la mémoire à long terme sert-elle au suivi de l'image suivante ? Grâce au module d'interaction temporelle.
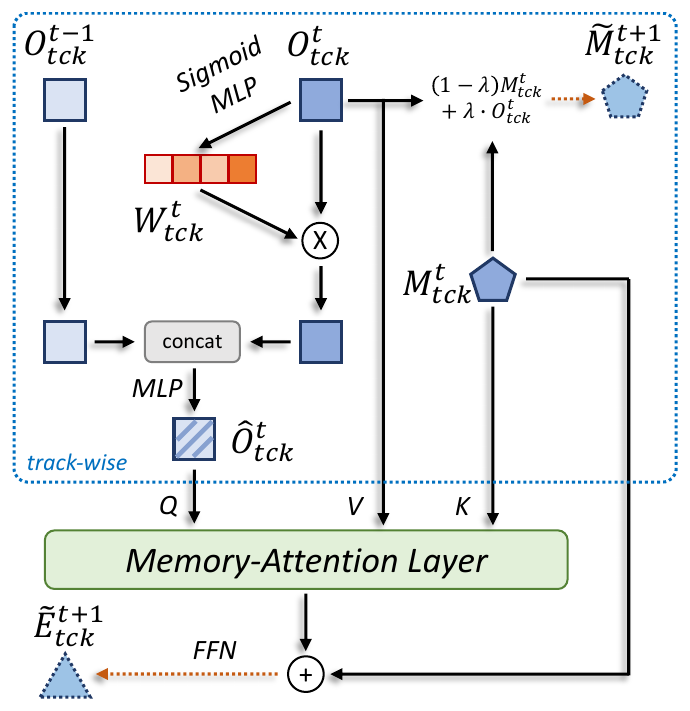
Il procède en deux étapes.
Première étape, fusionner deux images consécutives. La sortie de l'image courante peut être peu fiable à cause d'une occultation ou d'un flou ; un petit réseau lui attribue donc d'abord des poids par canal :
Ces poids multiplient la sortie de l'image courante, qui est ensuite concaténée à la sortie de l'image précédente ; un MLP à deux couches donne alors le résultat fusionné . La sortie de l'image précédente n'est pas pondérée ; si elle a été conservée, c'est que son score de confiance a franchi le seuil, ce qui la rend relativement fiable.
Deuxième étape, comparer les trajectoires entre elles. Une même image contient plusieurs personnes qui se ressemblent beaucoup, et les auteurs veulent que la représentation de chaque trajectoire se distingue mieux de celle des autres. Une attention multi-têtes, appelée couche d'attention à mémoire, fait donc interagir toutes les trajectoires ; la requête (Q) est le résultat fusionné , la clé (K) la mémoire à long terme , et la valeur (V) la sortie de l'image courante .
La sortie de l'attention, ajoutée à la mémoire à long terme puis passée dans un réseau feed-forward, donne l'embedding de piste de l'image suivante, . Comme on y a ajouté une mémoire à long terme qui évolue lentement, l'embedding de piste a lui aussi peu de chances de changer brusquement d'une image à la suivante.
Quand mettre à jour
À l'inférence, trois seuils interviennent, tous fixés à 0.5 :
- Une détection dont la confiance dépasse devient une nouvelle trajectoire.
- Un objet déjà suivi dont la confiance passe sous n'est pas supprimé directement, mais marqué comme temporairement perdu ; il n'est supprimé qu'après images consécutives sans être retrouvé. vaut 30 images sur DanceTrack, 15 sur MOT17.
- Ce n'est que si la confiance dépasse que les sorties du module d'interaction temporelle, et , mettent à jour l'embedding de piste et la mémoire à long terme ; sinon, on garde les anciens et .
Pendant les quelques images où une personne est cachée et où sa confiance chute, sa mémoire est gelée, pour qu'aucune sortie peu fiable ne s'y inscrive.
L'entraînement reprend l'approche de MOTR, qui fournit un extrait vidéo à la fois, en allongeant progressivement les extraits. Sur DanceTrack, l'entraînement dure 18 epochs ; les extraits commencent à 2 images et passent à 3, 4 puis 5 images aux epochs 6, 10 et 14.
Discussion
DanceTrack
Les auteurs évaluent surtout sur DanceTrack, dont les problèmes d'association sont les plus difficiles.
| Méthode | HOTA | DetA | AssA | IDF1 |
|---|---|---|---|---|
| ByteTrack | 47.7 | 71.0 | 32.1 | 53.9 |
| MOTR | 54.2 | 73.5 | 40.2 | 51.5 |
| OC-SORT | 55.1 | 80.3 | 38.3 | 54.6 |
| C-BIoU | 60.6 | 81.3 | 45.4 | 61.6 |
| MeMOTR (Deformable-DETR) | 63.4 | 77.0 | 52.3 | 65.5 |
| MeMOTR | 68.5 | 80.5 | 58.4 | 71.2 |
| MOTRv2 (données en plus) | 69.9 | 83.0 | 59.0 | 71.7 |
D'après la Table 1 de l'article, ensemble de test de DanceTrack.
MeMOTR dépasse C-BIoU, la meilleure méthode antérieure sans données supplémentaires, de 7.9 points de HOTA et de 13.0 points d'AssA. Même avec le Deformable-DETR standard, comme MOTR, il obtient un HOTA de 63.4, plus de 9 points au-dessus de MOTR.
MOTRv2, qui utilise des données supplémentaires et emprunte en plus les détections de YOLOX, reste légèrement devant. Mais en AssA, MeMOTR n'est qu'à 0.6 point derrière ; l'écart tient surtout à la détection.
De MOTR à MeMOTR, pas à pas
En annexe, les auteurs dressent un tableau des modifications successives, cumulées à partir de MOTR :
| Étape | HOTA val. | HOTA test |
|---|---|---|
| MOTR | 51.7 | 54.2 |
| + mémoire à long terme et interaction temporelle | 56.5 | 62.5 |
| + décodeur de détection (1 + 5 couches) | 61.0 | 63.4 |
| Passage à DAB-Deformable-DETR (décodeur non scindé) | 62.1 | 65.9 |
| + décodeur de détection (1 + 5 couches) | 63.9 | 68.5 |
| + boîtes candidates YOLOX | 66.8 | 70.0 |
D'après la Table 8 de l'article, DanceTrack. Hormis MOTR sur la première ligne, toutes les configurations retirent deux astuces d'entraînement de MOTR (suppression aléatoire de requêtes de piste, insertion de requêtes de faux positifs).
Le plus grand pas est le premier. L'ajout de la seule mémoire à long terme et du module d'interaction temporelle fait bondir le HOTA de test de 54.2 à 62.5, soit 8.3 points de plus. Le passage à DAB-Deformable-DETR aide aussi beaucoup ; pour les auteurs, un a priori de position fondé sur des boîtes d'ancrage convient bien à des boîtes de trajectoire qui se déplacent en douceur dans le temps. La dernière ligne ajoute, à la manière de MOTRv2, des boîtes candidates YOLOX, et porte le HOTA à 70.0 ; mais la méthode n'est alors plus entièrement de bout en bout.
Ablations pièce par pièce
Les ablations se font toutes sur l'ensemble de validation de DanceTrack, dont les données d'entraînement représentent environ 10 fois celles de MOT17, ce qui limite le surapprentissage.
- Une seule couche pour le décodeur de détection, c'est le mieux. Sans scission, 62.1 ; avec 1 couche séparée, 63.9, et l'AssA passe de 52.2 à 55.0 ; avec 2 couches, on redescend au contraire à 63.2, car le décodeur conjoint perd une couche, et l'embedding de piste est corrigé une fois de moins.
- La fusion de deux images consécutives demande les deux ingrédients à la fois. Les poids par canal seuls, ou la sortie de l'image précédente seule, n'ajoutent que 0.1 à 0.4 point de HOTA ; ce n'est qu'ensemble qu'ils atteignent 63.9, 1.6 point au-dessus de la version sans aucun des deux. Selon les auteurs, atténuer les canaux peu fiables sans que l'image précédente vienne compléter l'information revient simplement à jeter de l'information.
- La couche d'attention à mémoire a besoin de la mémoire à long terme. Sans mémoire à long terme, ajouter la couche d'attention à mémoire dégrade même les résultats ; l'AssA tombe de 52.1 à 50.7. Avec la mémoire à long terme, la couche d'attention fait passer l'AssA de 52.9 à 55.0. Pour les auteurs, des embeddings de piste sans mémoire sont instables par nature, et les comparer entre eux ne fait qu'amplifier le bruit.
- est le meilleur choix. Avec 0.005, 0.02 et 0.04, le HOTA vaut respectivement 62.6, 63.2 et 63.5. Les auteurs rappellent que devra peut-être être ajusté selon le jeu de données ; des scènes où les objets se déforment beaucoup demanderont sans doute une mise à jour un peu plus rapide.
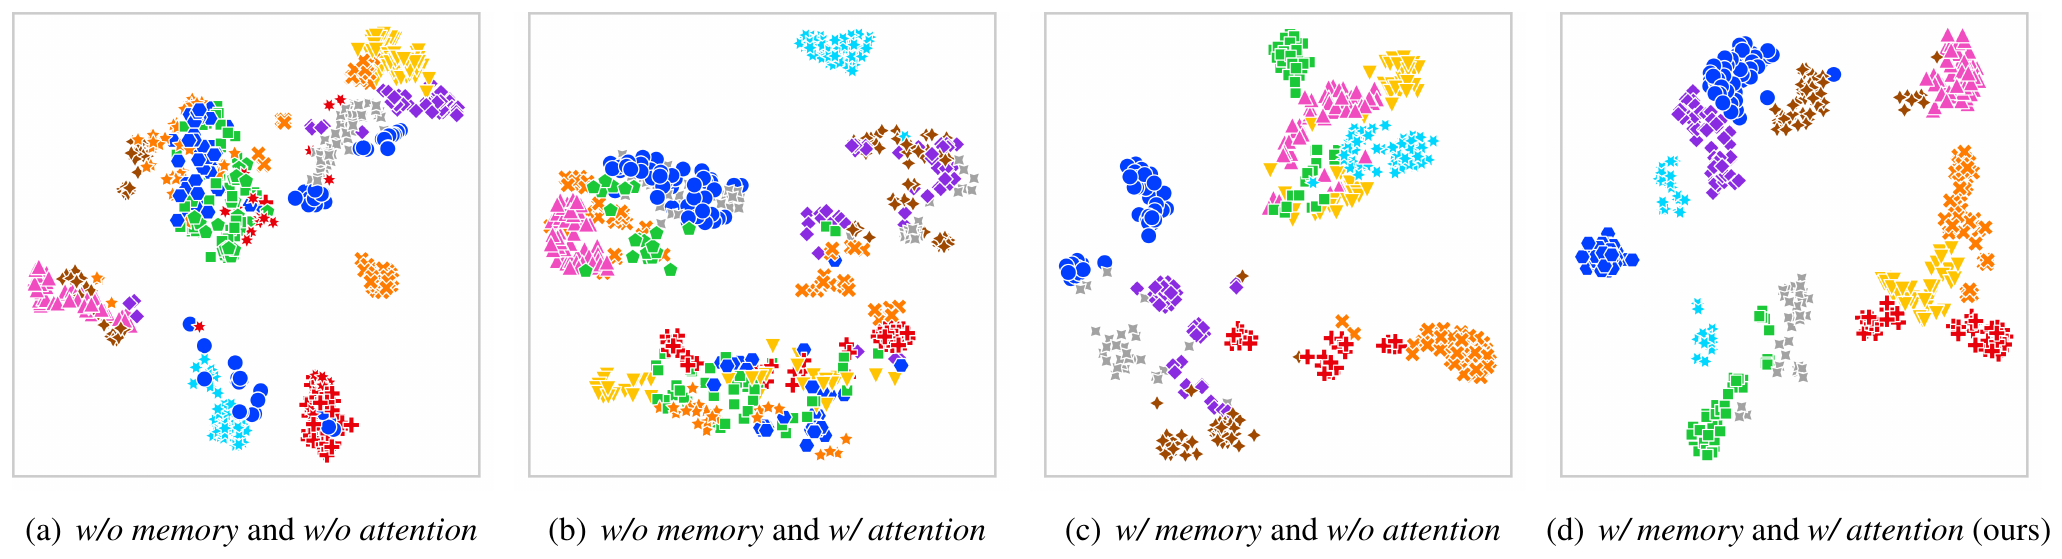
Cette figure illustre le point 3. En (b), avec l'attention seule, les points des différentes trajectoires sont encore plus mêlés qu'en (a) ; en (d), avec mémoire et attention, les embeddings de chaque trajectoire sur les 50 images se regroupent en un amas, et les amas sont les plus éloignés les uns des autres.
Les passages les plus difficiles
Les auteurs isolent les 8 vidéos de l'ensemble de validation de DanceTrack où l'AssA de MOTR est le plus bas, et les comparent séparément. Sur ces 8 vidéos, l'AssA moyen de MOTR n'est que de 23.6 ; MeMOTR le porte à 35.5.
Le progrès est net, mais encore loin des 58.4 de MeMOTR dans l'ensemble. Les auteurs le reconnaissent, le problème de l'association est loin d'être résolu.
MOT17 et autres jeux de données
Sur MOT17, MeMOTR obtient un HOTA de 58.8, le meilleur parmi les méthodes à base de Transformer, et son AssA de 58.4 comme son IDF1 de 71.5 font mieux que le MeMOT antérieur ; mais son DetA n'est que de 59.6, bien en dessous des 64.5 de ByteTrack avec YOLOX, et son HOTA reste derrière les 63.1 de ByteTrack.
Les auteurs avancent deux raisons. D'abord, les piétons de MOT17 sont petits et serrés ; les détecteurs de type DETR peinent déjà dans ce cas, et dans l'auto-attention, les requêtes de détection sont en plus étouffées par les requêtes de piste. Ensuite, l'ensemble d'entraînement de MOT17 ne compte qu'environ 5 000 images ; même avec des pseudo-vidéos fabriquées à partir de CrowdHuman, le modèle atteint un HOTA d'environ 90 sur l'ensemble d'entraînement, mais seulement 58.8 au test, un surapprentissage très marqué.
Sur l'ensemble de validation multi-classes de BDD100K, mesuré avec la métrique TETA, MeMOTR obtient 53.6, au-dessus des 50.8 de TETer et des 50.7 de MOTR.
La version v3 ajoute des résultats sur SportsMOT. Avec le seul ensemble d'entraînement de SportsMOT, MeMOTR obtient un HOTA de 70.0 et un AssA de 59.1, au-dessus d'OC-SORT (68.1), relancé avec son code officiel sur le même ensemble d'entraînement seul. Les auteurs renoncent délibérément aux données supplémentaires, au motif que l'ensemble d'entraînement de SportsMOT compte déjà plus de 25 000 images, et que fabriquer de fausses vidéos en translatant des images fixes s'écarte des vraies situations de suivi, ce qui nuit aux méthodes de bout en bout, qui apprennent directement des données.
Conclusion
MeMOTR dote chaque trajectoire d'une mémoire à long terme mise à jour très lentement, l'injecte grâce au module d'interaction temporelle dans l'embedding de piste de l'image suivante, et sépare une couche de décodeur de détection pour que requêtes de détection et requêtes de piste partent du même point. Le tableau cumulatif de l'annexe montre que le plus grand pas est la mémoire à long terme elle-même, qui fait gagner d'un coup plus de 8 points à MOTR sur l'ensemble de test de DanceTrack.
Ses faiblesses sont aussi héritées de MOTR. La détection reste son point faible ; sur les scènes bondées de MOT17, il perd face aux méthodes qui utilisent YOLOX, et il tend au surapprentissage sur les petits jeux de données. Les auteurs suggèrent d'essayer à l'avenir des données synthétiques.
L'étape suivante de cette équipe, avec MOTIP en 2024, sera de reformuler l'association d'identités comme un problème de classification.
Une mémoire qui ne change que de 1 % par image, ça semble bien lent à la détente. Mais pour reconnaître qui est qui dans une troupe de danseurs habillés pareil, c'est justement sur cette lenteur qu'on compte.