Article original
Matching Anything by Segmenting Anything
- Publication
- CVPR 2024Conférence
- Premier dépôt sur arXiv
- arXiv:2406.04221
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingmasa2024,
  title = {{Matching Anything by Segmenting Anything}},
  author = {Siyuan Li and Lei Ke and Martin Danelljan and Luigi Piccinelli and Mattia Segu and Luc Van Gool and Fisher Yu},
  year = {2024},
  eprint = {2406.04221},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2406.04221}
}
Autour de 2023, la détection et la segmentation se dotent de modèles de fondation qui « reconnaissent tout ». SAM sait découper tout ce que contient une image ; Detic et Grounding-DINO savent détecter, à partir d'un texte, plus d'un millier de catégories.
Le suivi, lui, n'a pas bougé. Les méthodes qui apprennent l'association ont presque toutes besoin, pour s'entraîner, de vidéos annotées avec des identités, des données chères et au champ très étroit ; MOT17 ne contient que des piétons, BDD100K seulement huit catégories d'objets de la route. Des caractéristiques d'apparence apprises sur des piétons ne valent plus grand-chose quand il s'agit de suivre des animaux ou des personnages de dessin animé.
Siyuan Li, Lei Ke, Fisher Yu et leurs collègues de l'ETH Zurich cherchent un moyen pour que l'association, comme la détection, puisse « tout suivre ». Ils se passent entièrement de vidéos et n'utilisent qu'un tas de photos sans annotation.
Définir le problème
Pour apprendre l'association, il faut savoir que « cette chose dans cette image et cette autre chose dans cette autre image sont la même ». C'est l'annotation d'identité, la partie la plus chère des données de suivi.
Certains ont déjà essayé de s'en passer. Les méthodes comme UniTrack utilisent directement, pour l'association, des caractéristiques d'image apprises de façon auto-supervisée. Le problème, c'est que ces caractéristiques sont en général entraînées sur des données comme ImageNet, avec « un seul sujet par image », et qu'elles apprennent la similarité de l'image entière. Dans une scène de rue où une image contient des dizaines de choses, elles ont du mal à distinguer qui est qui.
Les auteurs ont deux problèmes à résoudre :
- D'où viennent les correspondances. Sans vidéo, comment savoir que deux choses sont la même ?
- Comment se brancher sur les modèles existants. La détection et la segmentation ont déjà des modèles de fondation très forts ; l'idéal serait d'y ajouter directement la capacité d'association, sans toucher à ce qu'ils savent déjà faire.
Résoudre le problème
Une photo, deux vues
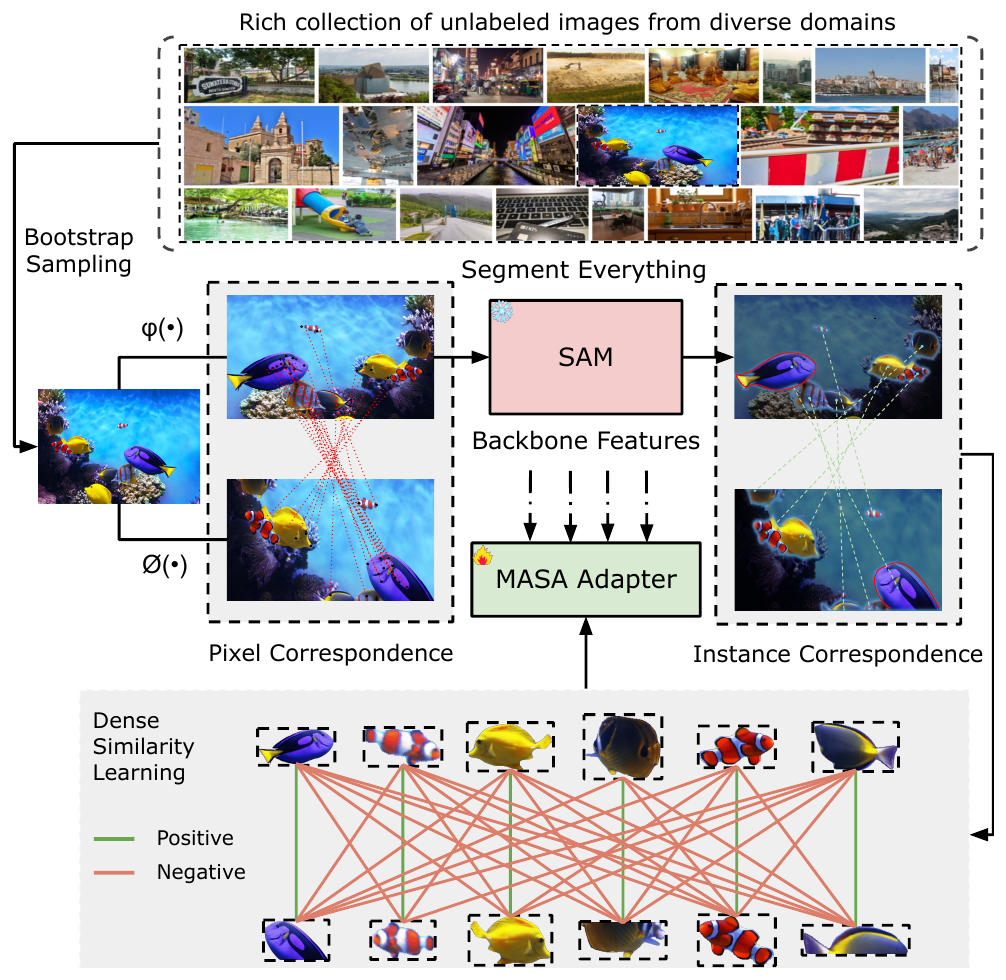
MASA prend une photo et lui applique deux augmentations fortes différentes ; d'un côté, par exemple, on agrandit, on décale et on change les couleurs, de l'autre on réduit, on retourne et on y mélange une autre image. Les deux vues n'ont plus grand-chose en commun en apparence, mais comme c'est nous qui avons fait les transformations, on sait quel pixel correspond à quel pixel.
Cela simule les changements que subit un même objet entre deux images d'une vidéo ; sa position change, sa taille change, l'éclairage change, mais l'objet reste le même.
La correspondance de pixels ne suffit pas ; ce qu'il faut, c'est une correspondance entre « objets ». SAM découpe chaque chose de la photo en un masque. Les pixels d'un même masque appartiennent au même objet, et la correspondance de pixels devient une correspondance d'objets.
Rapprocher le même poisson, éloigner les autres
Une fois les correspondances d'objets établies, l'entraînement relève de l'apprentissage contrastif classique. Les caractéristiques d'un même objet dans les deux vues forment un exemple positif, à rapprocher ; avec tous les autres objets, elles forment des exemples négatifs, à éloigner :
est la similarité cosinus, et la température vaut .
L'apport de SAM, ici, tient aux exemples négatifs. Dans une photo complexe, SAM peut découper une centaine d'objets ou plus, et chaque objet sert d'exemple négatif à tous les autres. Avec une température aussi basse, ce sont les quelques négatifs les plus ressemblants qui dominent la perte ; quelques chiffres suffisent à le voir.
| Cas | Sim. pos. | Sim. nég. | Perte |
|---|---|---|---|
| Aucun négatif proche | 0.80 | 0.30, 0.20, 0.10 | 0.001 |
| Un négatif très proche | 0.80 | 0.75, 0.20, 0.10 | 0.40 |
Exemple de calcul établi pour cette note.
Il suffit de remplacer un seul négatif par « un autre poisson qui lui ressemble beaucoup » pour que la perte soit multipliée par près de 400. Le modèle est obligé d'apprendre les détails qui permettent de distinguer des objets semblables. Or ce qu'il y a de plus difficile en suivi, c'est justement de distinguer des choses qui se ressemblent.
Un adaptateur branché derrière le modèle de fondation
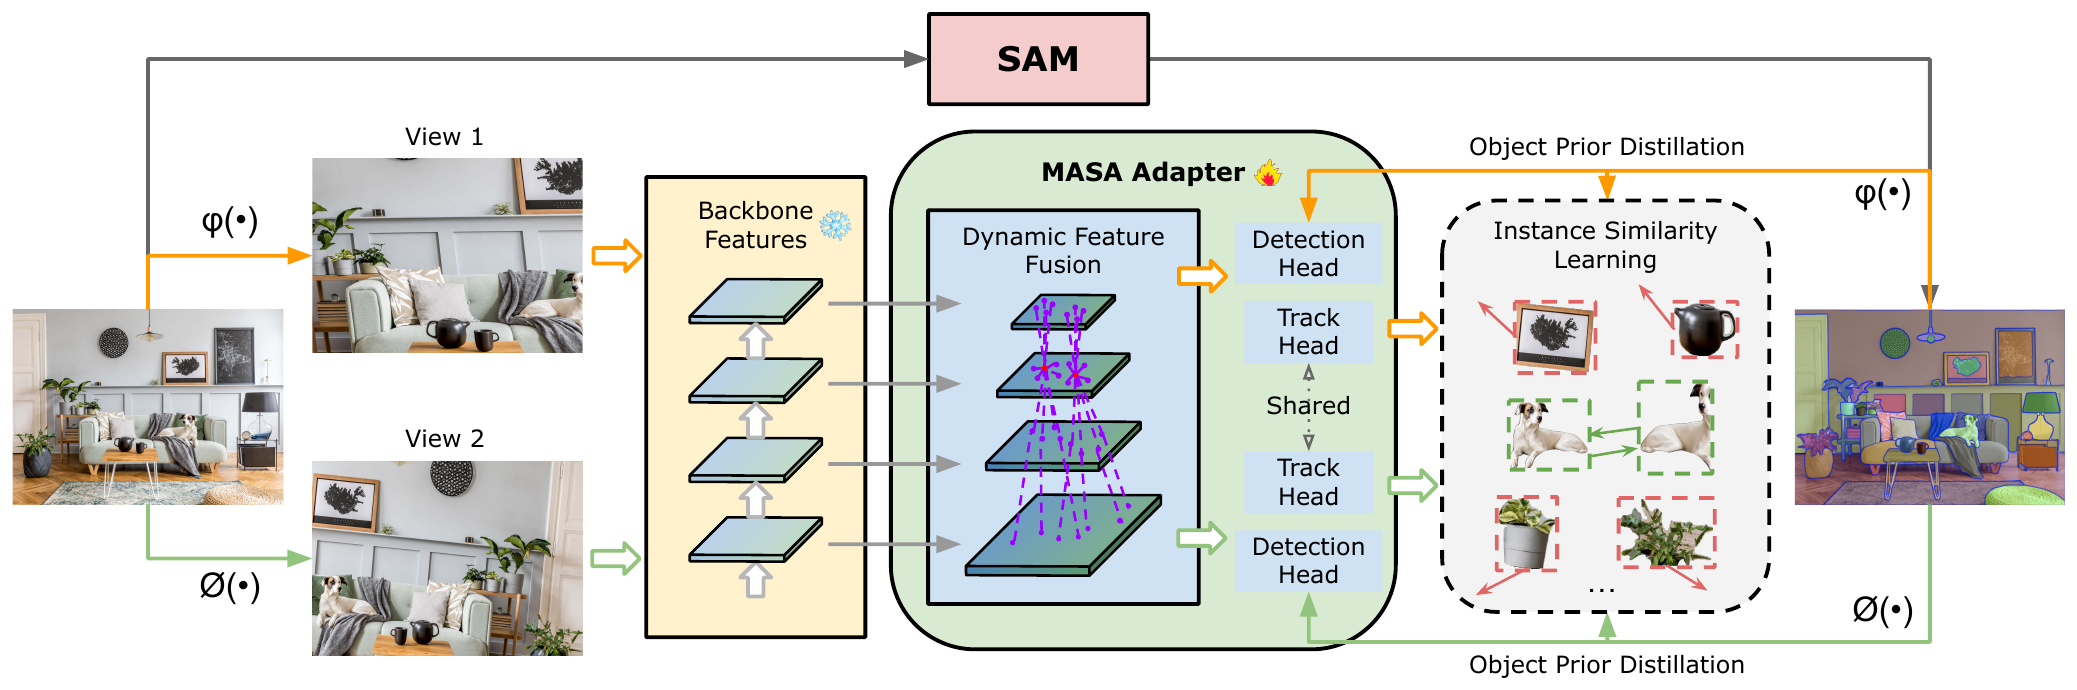
La capacité d'association apprise doit pouvoir s'ajouter à n'importe quel modèle de détection ou de segmentation. Les auteurs conçoivent un adaptateur MASA, branché derrière un backbone (réseau de base) gelé. Le backbone ne bouge pas, si bien que ses capacités de détection et de segmentation d'origine restent intactes.
L'adaptateur fait trois choses :
- Construire une pyramide de caractéristiques. Le Swin Transformer a déjà des caractéristiques multi-échelles et se branche directement sur un FPN ; le ViT de SAM n'a qu'une seule échelle, et l'on fabrique donc quatre échelles par convolution transposée et pooling.
- Fusion dynamique des caractéristiques. Des convolutions déformables agrègent l'information d'une position à l'autre et d'une échelle à l'autre. L'argument des auteurs est que, pour distinguer des objets différents, la caractéristique de chaque position gagne à savoir à quoi ressemble le reste de l'image.
- Tête de suivi. RoI-Align extrait les caractéristiques selon la boîte de chaque objet ; elles passent par 4 couches de convolution et 1 couche entièrement connectée, qui produisent un vecteur de plongement pour chaque objet.
L'entraînement comporte aussi une tâche auxiliaire ; une tête de détection apprend à prédire la boîte englobante des masques de SAM. Cela revient à distiller dans les caractéristiques de l'adaptateur ce que SAM sait de « ce qui compte comme un objet ».
Deux façons de s'en servir à l'inférence
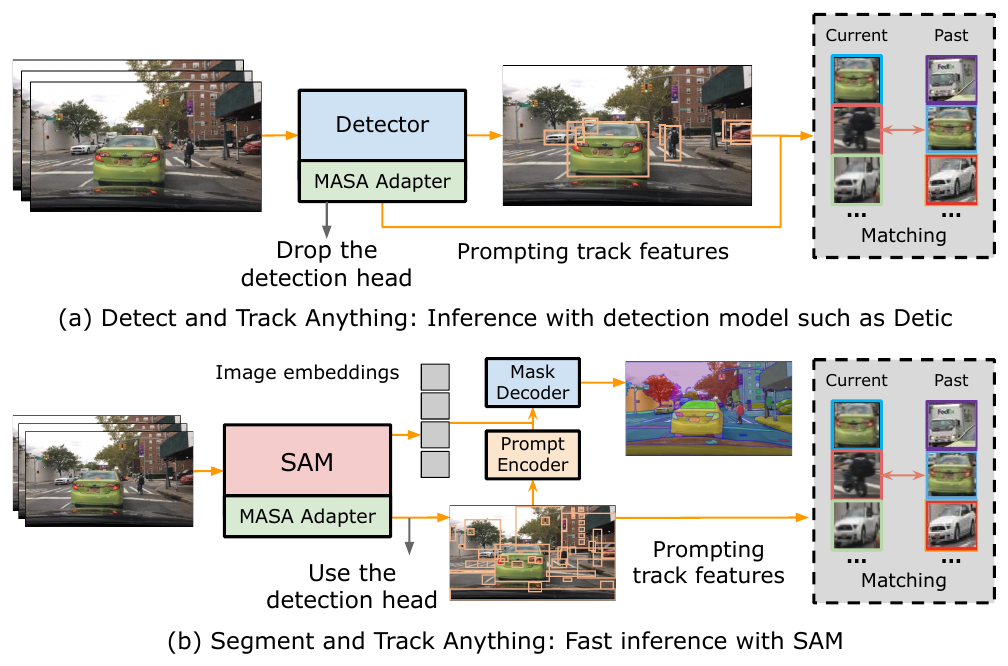
Avec un détecteur, on jette la tête de détection utilisée à l'entraînement ; quelles que soient les boîtes fournies par le détecteur, l'adaptateur produit des caractéristiques de suivi pour ces boîtes.
Avec SAM, au contraire, la tête de détection devient utile. Pour « découper tout », SAM doit normalement semer environ un millier de points sur l'image comme prompts, puis faire un post-traitement fastidieux. La tête de détection de MASA lui fournit directement des boîtes d'objets comme prompts ; les auteurs mesurent sur UVO qu'à rappel égal, c'est environ 10 fois plus rapide.
L'appariement reprend le softmax bidirectionnel de la famille QDTrack ; le score entre un objet et une trajectoire doit être élevé dans les deux sens, parmi « tous les candidats de cette trajectoire » comme parmi « toutes les trajectoires de cet objet », pour que la paire soit retenue ; il est ensuite moyenné avec la similarité cosinus.
Les données d'entraînement sont 500 000 photos tirées de SA-1B. Tous les benchmarks utilisent le même jeu de poids, jamais entraîné sur aucun des domaines testés ; c'est de l'association zero-shot.
Discussion
Face aux méthodes entraînées sur le domaine
Pour ne comparer que la capacité d'association, les auteurs utilisent sur chaque benchmark les mêmes détections que la meilleure méthode de l'époque :
| Benchmark | Rival (intra-domaine) | AssocA rival | AssocA MASA |
|---|---|---|---|
| TAO TETA | TETer | 36.7 | 37.6 |
| BDD MOTS | UNINEXT-H | 53.2 | 54.5 |
| BDD MOT | ByteTrack | 51.5 | 52.9 |
TAO d'après la Table 1 de l'article, BDD MOTS d'après la Table 4, BDD MOT d'après la Table 5, tous sur les ensembles de validation ; pour MASA, la meilleure variante de chaque tableau.
Ces rivaux ont tous utilisé des annotations vidéo complètes dans leur domaine ; MASA n'a vu aucune image de TAO ni de BDD, et son score d'association est pourtant un peu plus élevé. Les écarts sont faibles, mais vont tous dans le même sens.
Sur BDD MOT, le mMOTA est de 45.5 pour ByteTrack et d'environ 44.5 pour MASA. ByteTrack raccroche aussi les boîtes à faible score aux trajectoires, ce qui favorise les métriques orientées détection.
Si l'on ne fournit pas les mêmes détections et que MASA, branché sur Detic, détecte et suit lui-même, il obtient sur TAO un TETA de 46.3, bien au-dessus des 34.6 des autres méthodes du tableau. Cette avance vient surtout des capacités de détection de Detic lui-même ; MASA permet de s'en servir directement pour le suivi.
Des catégories jamais vues
Les benchmarks de suivi à vocabulaire ouvert n'autorisent l'entraînement qu'avec les annotations des catégories courantes, et testent les catégories rares comme « nouvelles catégories ». Avec Detic, MASA obtient sur les nouvelles catégories un TETA de 40.8 et un AssocA de 41.2, contre 32.0 et 33.2 pour OVTrack, conçu spécialement pour cette tâche.
L'apport de chaque élément
Les ablations sont entraînées sur les photos brutes de BDD et de COCO, et évaluées sur BDD MOT :
| Configuration | AssocA | mIDF1 |
|---|---|---|
| Caractéristiques SAM brutes | 32.9 | 37.3 |
| + entraînement MASA et tête de suivi | 48.5 | 51.7 |
| + fusion dynamique | 50.1 | 53.3 |
| + distillation de l'a priori | 51.9 | 54.9 |
D'après la Table 8 de l'article, ensemble de validation de BDD MOT.
Les caractéristiques d'origine de SAM sont optimisées pour la segmentation ; utilisées telles quelles pour distinguer les individus, elles ne donnent qu'un AssocA de 32.9. Dès qu'on ajoute l'entraînement de MASA, on gagne 15.6 points, le plus gros gain de tout l'article.
Les autres ablations confirment l'analyse précédente :
- Source des propositions. Si l'on remplace SAM par un Mask2Former entraîné sur COCO, l'AssocA sur TAO tombe de 34.1 à 29.8. SAM découpe plus finement et de façon plus variée, et fournit de meilleurs exemples négatifs.
- Nombre de propositions. En faisant passer le plafond d'objets par lot de 64 à 256, l'AssocA sur TAO monte de 31.5 à 35.8.
- Force des augmentations. Avec des augmentations élémentaires, comme le retournement et le recadrage, le mIDF1 sur BDD est de 48.2 ; en ajoutant transformations affines aléatoires, MixUp et jitter à grande échelle, il monte à 54.9. Il faut que les photos varient suffisamment pour simuler les changements d'une vidéo.
Face aux autres méthodes auto-supervisées, entraînées sur les mêmes photos de BDD et de COCO, MoCo v2 obtient un AssocA de 42.7 sur BDD MOT, DINO seulement 23.1, et MASA 51.9. Ces méthodes apprennent la similarité de l'image entière et sont mal à l'aise dans les scènes à plusieurs objets.
Limites
Les auteurs en citent deux en annexe. D'abord, les détections du modèle de fondation ne sont pas toujours cohérentes d'une image à l'autre ; ce qui est découpé dans une image peut disparaître dans la suivante, et le résultat du suivi clignote ; MASA ne s'occupe que de l'association et ne peut pas corriger les erreurs de détection. Ensuite, MASA n'a pas de mémoire à long terme, seulement une file qui stocke le plongement de chaque objet, et échoue facilement en cas d'occultation sévère.
Conclusion
MASA démontre que, pour apprendre l'association du suivi, on n'a pas forcément besoin de vidéos, et encore moins d'annotations d'identité. On transforme une photo deux fois, SAM aide à faire passer la correspondance de pixels au niveau des objets, et l'apprentissage contrastif dispose d'une foule d'exemples positifs et négatifs.
La conception en adaptateur permet de brancher cette capacité sur des modèles de fondation comme SAM, Detic ou Grounding-DINO, sans toucher à leur détection ni à leur segmentation. Dans des domaines qu'il n'a jamais vus, comme TAO et BDD, son score d'association zero-shot dépasse même un peu celui des méthodes entraînées dans le domaine avec des annotations complètes.
Quant à l'instabilité des détections et aux occultations trop longues, il les laisse encore au modèle de fondation en amont et à une simple file ; pour suivre plus longtemps, il faudra lui ajouter une mémoire.