Article original
DiffMOT: A Real-time Diffusion-based Multiple Object Tracker with Non-linear Prediction
- Publication
- CVPR 2024Conférence
- Premier dépôt sur arXiv
- arXiv:2403.02075
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingdiffmot2024,
  title = {{DiffMOT: A Real-time Diffusion-based Multiple Object Tracker with Non-linear Prediction}},
  author = {Weiyi Lv and Yuhang Huang and Ning Zhang and Ruei-Sung Lin and Mei Han and Dan Zeng},
  year = {2024},
  eprint = {2403.02075},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2403.02075}
}
Depuis SORT, la plupart des traqueurs utilisent un filtre de Kalman comme modèle de mouvement. Il suppose que l'objet avance en ligne droite à vitesse constante sur de courtes durées ; il est rapide à calculer, a peu de paramètres, et rend de grands services sur des données centrées sur les piétons comme MOT17.
Mais sur la scène de DanceTrack ou les terrains de SportsMOT, les gens ne marchent plus sagement. Les danseurs pivotent d'un coup, s'accroupissent, sautent ; les joueurs s'arrêtent net, changent de direction, accélèrent en sprint. Dès que l'hypothèse de mouvement rectiligne uniforme tombe, la boîte prédite ne s'aligne plus sur la boîte de détection, la trajectoire se brise et un nouvel identifiant surgit.
Weiyi Lv, Yuhang Huang, Dan Zeng et leurs collègues de l'Université de Shanghai veulent prédire ces mouvements irréguliers avec un modèle de diffusion. Les modèles de diffusion excellent à modéliser des distributions complexes ; le problème, c'est qu'il leur faut en général un bon millier de pas pour générer un résultat, alors que le suivi doit tourner en temps réel.
Définir le problème
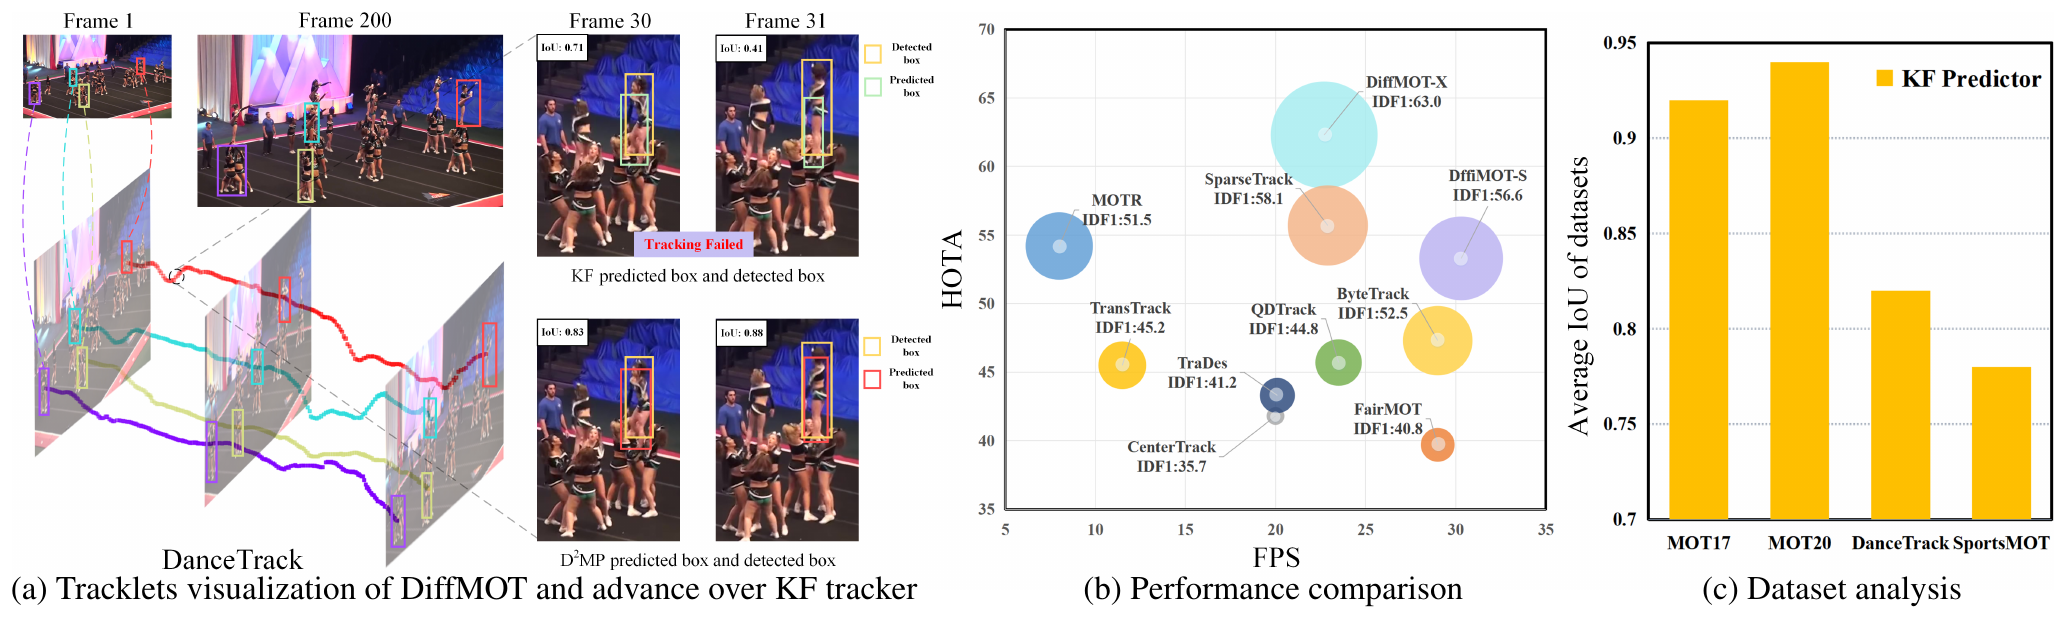
Le panneau (c), à droite, est le point de départ de l'article. Les auteurs prédisent la boîte de l'image suivante avec un filtre de Kalman, puis calculent son IoU avec la boîte de vérité terrain. Pour MOT17 et MOT20, l'IoU moyenne dépasse 0.9 ; pour DanceTrack, il n'est que d'environ 0.82, et d'environ 0.78 pour SportsMOT.
Pour le suivi, quand la boîte prédite tombe à côté, l'association doit s'accrocher à d'autres indices. Si l'on prédit plutôt avec un réseau de neurones, les réseaux simples comme les MLP ou les LSTM n'arrivent pas à modéliser des mouvements aussi complexes, et les méthodes à base de flot optique ou de Transformer, qui y parviennent mieux, sont trop lentes pour le temps réel.
DiffMOT veut prédire avec précision des mouvements non linéaires, tout en allant assez vite.
Résoudre le problème
Architecture générale
DiffMOT est un traqueur classique de type « détecter puis associer », en trois étapes :
- Détection. YOLOX trouve toutes les boîtes de l'image.
- Prédiction du mouvement. Pour chaque trajectoire existante, on prédit sa position dans l'image à partir des informations de ses 5 dernières images. Cette étape est le cœur de DiffMOT ; elle s'appelle D²MP (decoupled diffusion-based motion predictor).
- Association. On reprend l'appariement en deux temps de ByteTrack ; les boîtes de détection à score élevé sont d'abord appariées aux boîtes prédites par l'apparence et l'IoU, puis celles qui restent sont appariées une seconde fois aux boîtes à faible score, par l'IoU. Pour l'apparence, on emprunte à Deep OC-SORT son apparence dynamique et sa pondération adaptative.
À part la deuxième étape, tout est fait de composants existants. Les expériences de l'article peuvent donc se lire comme un remplacement du filtre de Kalman par un modèle de diffusion, au sein d'un même cadre.
Générer un « déplacement »
D²MP ne génère pas une boîte, mais la variation de la boîte. Le mouvement de l'image est défini par :
Une fois le mouvement prédit, on l'ajoute à la boîte de l'image précédente pour obtenir la boîte prédite de l'image courante.
Le modèle apprend la distribution des mouvements de tous les objets du jeu de données, et la prédiction est ensuite conditionnée par l'historique propre à chaque objet. Les auteurs jugent cette approche plus robuste que d'ajuster un modèle de mouvement distinct pour chaque trajectoire ; les gestes des danseurs varient à l'infini, mais la façon dont « un danseur bouge » obéit en elle-même à des régularités.
Un processus de diffusion découplé
Dans un modèle de diffusion ordinaire, le processus direct transforme les données en bruit pas à pas. D²MP reprend une approche de « diffusion découplée », qui scinde ce processus en deux volets menés simultanément :
- Les données tendent vers zéro. Les données de mouvement propres décroissent linéairement avec le temps et s'annulent à .
- Le bruit croît. Un bruit gaussien, parti de zéro, est ajouté jusqu'à devenir du bruit pur à .
La somme des deux donne le mouvement bruité :
est la vitesse de décroissance, un bruit normal centré réduit. À , c'est le mouvement propre ; à , il ne reste que .
Le processus inverse doit reconstituer le mouvement à partir du bruit. La diffusion découplée d'origine a besoin d'un réseau à deux branches, qui prédit à la fois et . Les auteurs remarquent que l'équation ci-dessus permet d'exprimer en fonction de et de ; le réseau n'a donc qu'une seule grandeur à prédire, .
Plus important encore, ce processus peut se faire en un seul pas.
Comment se fait ce pas unique
Déroulons les processus direct et inverse sur un exemple.
Supposons qu'à l'image précédente, la boîte d'un danseur soit , soit dans l'ordre le centre , le centre , la largeur et la hauteur, en pixels. Dans l'image courante, la boîte se déplace de 12 vers la droite et de 3 vers le haut, sans changer de taille ; le mouvement réel est donc .
Dans le processus direct, . À :
Le mouvement a perdu un quart de sa valeur, et un bruit d'un demi-écart type s'y est mêlé. À , il ne reste que .
Pour le processus inverse, on saute en un seul pas de à . Si l'on reporte ces valeurs dans la formule du processus inverse, la moyenne vaut exactement et la variance 0. Si le réseau déduit de l'historique , le mouvement prédit est et la boîte prédite .
Exemple de calcul établi pour cette note.
Un modèle de diffusion ordinaire doit faire de quelques centaines à un millier de pas ; dans la diffusion découplée, la décroissance est analytique et peut se parcourir en un seul pas, si bien que le temps de prédiction du mouvement devient négligeable.
D'où vient la condition
C'est un réseau appelé HMINet qui prédit . Il lit les informations des 5 dernières images de la trajectoire, huit nombres par image : les quatre valeurs de la boîte, plus le déplacement de cette image.
Ces 5 images passent, avec un class token apprenable, à travers 6 couches d'auto-attention multi-têtes ; le class token final constitue le plongement de la condition. Le mouvement bruité et le plongement de la condition entrent ensuite ensemble dans une « couche de fusion du mouvement », où le plongement de la condition passe par un MLP qui produit un facteur d'échelle et un décalage, lesquels ajustent les caractéristiques du mouvement bruité. Après quelques couches supplémentaires d'auto-attention et de fusion, un dernier MLP produit .
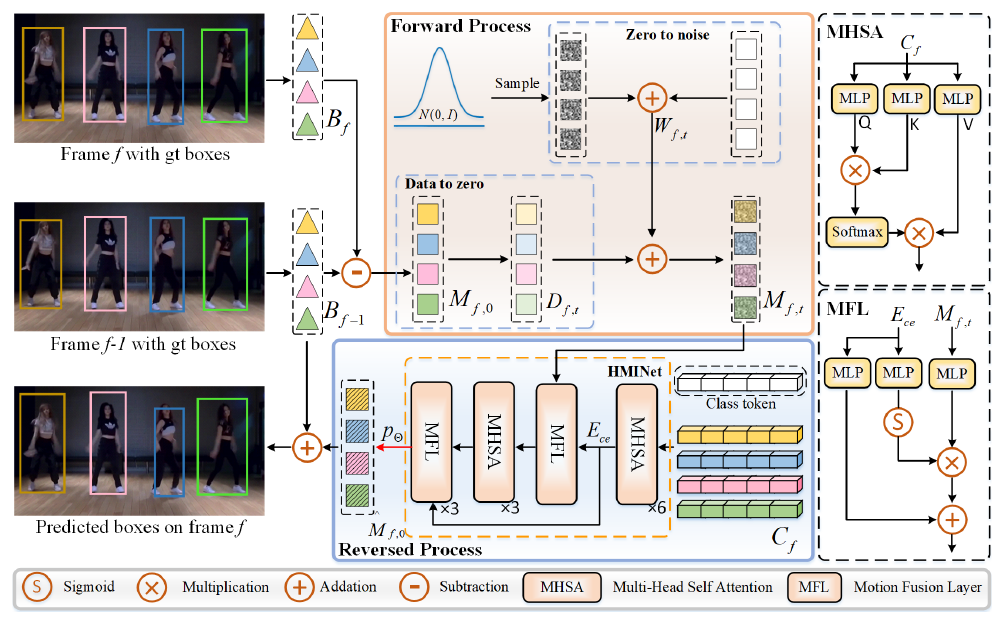
À l'entraînement, la perte est une smooth L1 entre le prédit et le vrai .
Discussion
Changer de modèle de mouvement
Toutes les ablations se font sur l'ensemble de validation de DanceTrack ; le détecteur et l'association restent les mêmes, seul le modèle de mouvement change :
| Modèle de mouvement | HOTA | IDF1 | AssA |
|---|---|---|---|
| IoU seule | 44.7 | 36.8 | 25.3 |
| Filtre de Kalman | 46.8 | 52.1 | 31.3 |
| LSTM | 51.2 | 51.6 | 34.3 |
| Transformer | 54.6 | 54.6 | 38.1 |
| D²MP | 55.7 | 55.2 | 39.5 |
D'après la Table 5 de l'article, ensemble de validation de DanceTrack.
Le filtre de Kalman ne fait que 2.1 points de HOTA de mieux que l'absence totale de prédiction ; D²MP gagne encore 8.9 points sur le filtre de Kalman. Le Transformer ne s'en sort pas mal non plus, avec 54.6 de HOTA, mais l'article ne donne pas sa vitesse dans le même cadre.
Un seul pas suffit-il ?
| Architecture | Pas | HOTA | FPS |
|---|---|---|---|
| Deux branches | 1 | 44.5 | 20.9 |
| Deux branches | 10 | 52.3 | 13.1 |
| Deux branches | 20 | 54.6 | 7.5 |
| Une branche | 1 | 55.7 | 22.7 |
D'après la Table 6 de l'article, ensemble de validation de DanceTrack ; la vitesse inclut la détection par YOLOX-X.
Ce tableau montre l'intérêt de la branche unique. La version à deux branches, qui prédit à la fois et , n'obtient que 44.5 avec un seul pas d'échantillonnage ; il lui faut 20 pas pour atteindre 54.6, et sa vitesse tombe alors à 7.5 FPS. La version à une branche, qui ne prédit que , obtient 55.7 dès le premier pas. Avec une grandeur de moins à apprendre, le réseau apprend mieux.
Quelle longueur d'historique ?
Pour une longueur d'historique allant de 1 à 10 images, le HOTA vaut successivement 51.7, 52.5, 53.0, 55.7 (5 images), 52.5 et 51.1. Trop court, l'historique ne montre pas où va l'objet ; trop long, les informations anciennes finissent par gêner la prédiction. 5 images, c'est le meilleur réglage.
Trois contenus ont aussi été essayés pour la condition : la boîte de l'image précédente seule, le déplacement de l'image précédente seul, ou les deux. Les deux ensemble donnent le meilleur HOTA, mais l'écart maximal entre les trois n'est que de 1.3.
Résultats sur les ensembles de test
| Benchmark | DiffMOT | Meilleur autre | Méthode |
|---|---|---|---|
| DanceTrack | 62.3 | 61.3 | Deep OC-SORT |
| SportsMOT | 76.2 | 74.1 | MixSort-OC |
| MOT17 | 64.5 | 65.1 | SparseTrack |
| MOT20 | 61.7 | 63.9 | Deep OC-SORT |
HOTA sur les ensembles de test. DanceTrack d'après la Table 1 de l'article ; SportsMOT d'après la Table 2 de l'article, avec un détecteur entraîné sur les ensembles d'entraînement et de validation ; MOT17 d'après la Table 3 de l'article ; MOT20 d'après la Table 9 de l'annexe de l'article.
Sur DanceTrack et SportsMOT, où dominent les mouvements non linéaires, DiffMOT est premier. Sur DanceTrack, son IDF1 de 63.0 et son AssA de 47.2 dépassent aussi ceux de Deep OC-SORT de 1.5 et 1.4 ; le progrès porte surtout sur l'association.
Sur MOT17 et MOT20, centrés sur les piétons, DiffMOT n'est plus le meilleur ; il reste un peu en dessous de Deep OC-SORT et de SparseTrack. Le mouvement des piétons est déjà presque rectiligne, le filtre de Kalman suffit, et le modèle de diffusion n'a pas grand-chose à apporter.
Côté vitesse, il tourne à 22.7 FPS avec YOLOX-X, et peut atteindre 30.3 FPS avec YOLOX-S, mais son HOTA tombe alors à 53.3.
D'un jeu de données à l'autre
En annexe, les auteurs appliquent directement à d'autres jeux de données le D²MP entraîné sur DanceTrack. Sur SportsMOT, il obtient un HOTA de 75.6, à peine 0.6 de moins que la version entraînée sur SportsMOT, et toujours au-dessus des 74.1 de MixSort-OC. Sur MOT17, en revanche, il perd 2.7 points.
D'après ces résultats, les mouvements des danseurs et ceux des joueurs se ressemblent davantage entre eux qu'ils ne ressemblent à ceux des piétons.
Quand ça échoue
L'annexe décrit deux types d'échec. Le premier est l'échange d'identifiants entre deux personnes qui se croisent ; selon les auteurs, c'est parce que le modèle n'impose aucune contrainte sur la direction de la vitesse. Le second, c'est qu'une personne disparue longtemps n'est pas retrouvée ; D²MP ne prédit que l'image suivante, et ne peut pas projeter sur plusieurs images une trajectoire interrompue depuis longtemps pour l'attendre.
Conclusion
DiffMOT ne touche qu'à une seule pièce, en remplaçant le filtre de Kalman du cadre « détecter puis associer » par un modèle de diffusion.
Ce qui le rend utilisable en suivi temps réel, c'est la diffusion découplée. La décroissance des données est analytique, et le processus inverse peut se faire en un seul pas ; le réseau n'a qu'à prédire la vitesse de décroissance , ce qui s'apprend mieux que de prédire à la fois et le bruit. On obtient un prédicteur capable de modéliser les mouvements irréguliers des danseurs et des joueurs, qui tourne encore à plus de 20 FPS, détection comprise.
Si on le compare à DiffusionTrack, sorti six mois plus tôt, les deux articles utilisent un modèle de diffusion ; DiffusionTrack s'en sert pour générer des paires de boîtes sur deux images, DiffMOT seulement pour générer des déplacements. Sur DanceTrack, le second a un HOTA plus élevé de près de 10 points.