Article original
DiffusionTrack: Diffusion Model For Multi-Object Tracking
- Publication
- AAAI 2024Conférence
- Premier dépôt sur arXiv
- arXiv:2308.09905
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingdiffusiontrack2023,
  title = {{DiffusionTrack: Diffusion Model For Multi-Object Tracking}},
  author = {Run Luo and Zikai Song and Lintao Ma and Jinlin Wei and Wei Yang and Min Yang},
  year = {2023},
  eprint = {2308.09905},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2308.09905}
}
L'usage le plus connu des modèles de diffusion, c'est la génération d'images : on part d'un bruit pur, on retire le bruit étape par étape, et l'on obtient à la fin une image nette.
Fin 2022, DiffusionDet transpose cette idée à la détection d'objets. Il ne génère pas des images, mais des boîtes : on sème un tas de boîtes aléatoires sur l'image, et le réseau les ramène étape par étape sur les objets.
Run Luo, Zikai Song et leurs collègues, de l'Institut de technologie avancée de Shenzhen et de l'Université des sciences et technologies de Huazhong, veulent aller un cran plus loin. Si l'on génère non plus une boîte, mais une paire de boîtes, l'une dans l'image précédente, l'autre dans l'image courante, qui encadrent la même personne, alors détection et suivi s'accomplissent ensemble, dans un seul et même processus de débruitage.
Définir le problème
Les auteurs rangent les traqueurs de l'époque en deux familles, et leur trouvent trois défauts communs :
- L'incohérence. Dans les méthodes qui détectent puis suivent, détecteur et traqueur sont entraînés séparément. Les méthodes de détection et suivi conjoints les réunissent bien dans un même réseau, mais détection et suivi y suivent encore chacun leur branche.
- Robustesse et complexité difficiles à concilier. Les méthodes qui détectent puis suivent ont une structure simple, mais au moindre écart de la détection, le suivi se trompe à son tour. Les méthodes conjointes sont plus robustes, mais leur structure est complexe, et leur précision de détection ne vaut pas celle d'un détecteur spécialisé.
- Le manque de souplesse. Dans une même vidéo, certains passages comptent peu de monde et d'autres sont bondés, certaines personnes marchent lentement et d'autres courent, mais la plupart des méthodes appliquent un seul réglage à toute la vidéo.
DiffusionTrack veut traiter ces trois points à la fois dans un cadre unifié.
Résoudre le problème
Générer une paire de boîtes à la fois
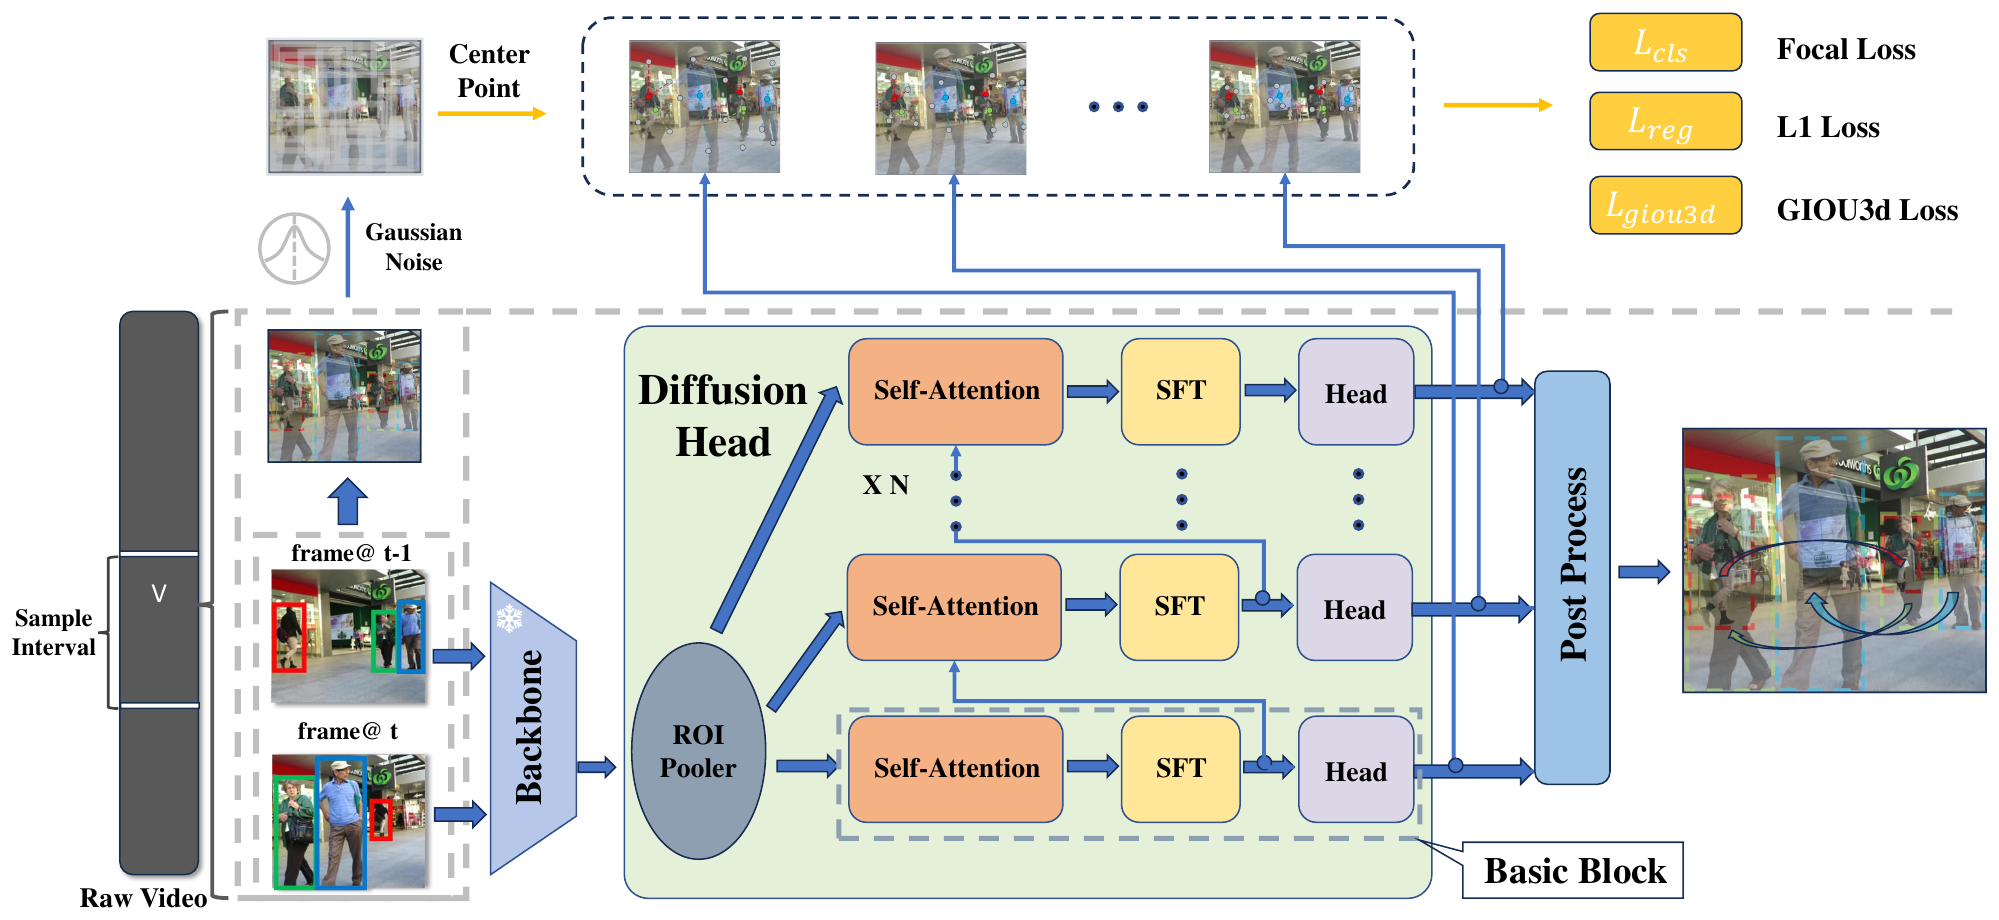
L'unité de données de DiffusionTrack est une paire de boîtes : les boîtes d'un même objet aux images et , soit huit nombres. Le travail du réseau consiste à retrouver la vraie paire à partir d'une paire brouillée par le bruit.
Si les deux images sont identiques, le problème se réduit à une détection d'objets ordinaire. Les auteurs insistent sur ce point, car il montre que détection et suivi sont vraiment entraînés dans le même modèle, avec le même objectif.
Le réseau se divise en deux parties :
- Le backbone (réseau de base). Le YOLOX préentraîné de ByteTrack, avec un FPN, exécuté une fois sur chacune des deux images, puis gelé.
- La tête de diffusion. Pour chaque paire de boîtes bruitées, elle prélève une caractéristique RoI sur la carte de chacune des deux images, et l'affine à travers plusieurs blocs successifs. Chaque bloc produit la position des boîtes, la classe, et un score d'association qui indique si les deux boîtes de la paire sont le même objet.
Chaque bloc contient un module de fusion spatio-temporelle, qui fait échanger des informations aux deux boîtes appariées. La boîte de l'image précédente voit l'image courante, celle de l'image courante voit l'image précédente, et les deux décident ensemble dans quel sens corriger la paire.
Entraînement : salir la bonne réponse
À l'entraînement, on prend deux images d'une même vidéo, séparées de 5 images au plus. Chaque objet présent dans les deux images forme une paire de boîtes correcte, et l'on complète avec des boîtes supplémentaires jusqu'à 500 paires.
On ajoute ensuite à ces 500 paires un bruit gaussien d'intensité variable, selon le calendrier de bruit du modèle de diffusion, et le réseau apprend à les restaurer. L'appariement se fait par l'algorithme hongrois, et la perte a trois termes : une focal loss pour la classe, une perte L1 pour les coordonnées, et une perte 3D GIoU.
La 3D GIoU étend la GIoU. Une paire de boîtes empilée le long de l'axe du temps forme une sorte de tronc de pyramide ; l'intersection et l'union de deux troncs se calculent en additionnant les surfaces des deux images. Le réseau doit ainsi tenir compte des boîtes des deux images à la fois, au lieu de les traiter chacune de son côté.
Inférence : partir des boîtes de l'image précédente
La détection part de boîtes entièrement aléatoires ; le suivi peut s'en passer, puisqu'on sait déjà où se trouvait chaque personne dans l'image précédente.
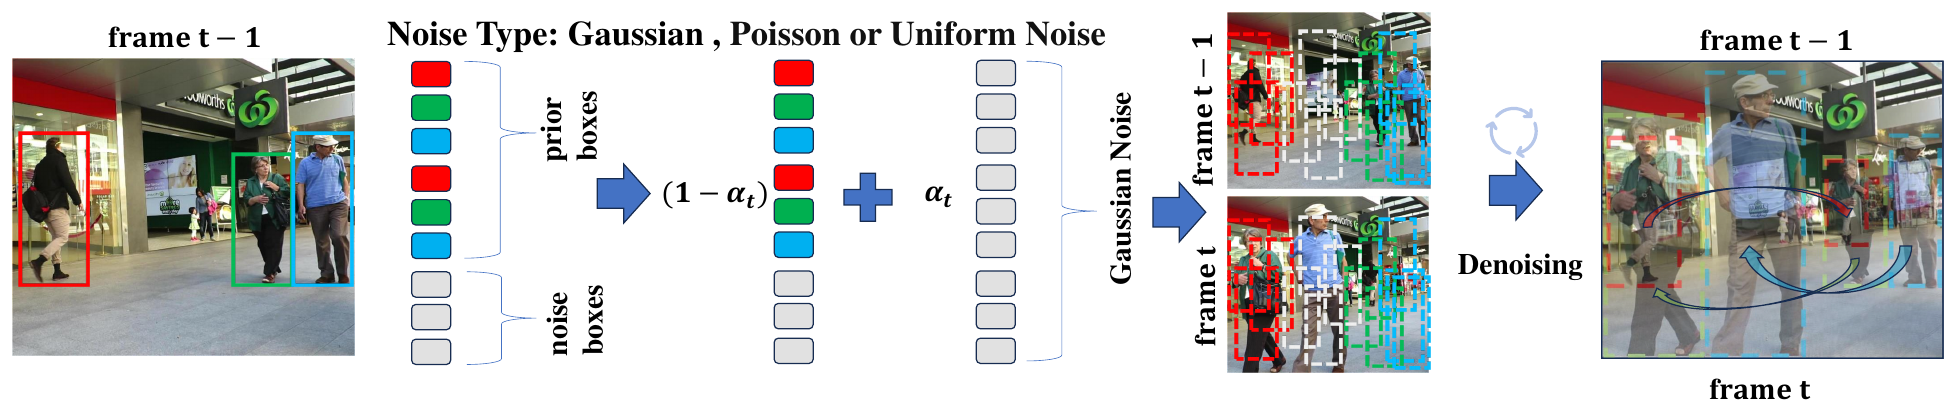
L'inférence se fait en trois temps :
- Rassembler les boîtes. On répète plusieurs fois les boîtes de l'image précédente, et l'on comble les places restantes avec des boîtes gaussiennes aléatoires, jusqu'à un nombre fixe.
- Ajouter le bruit. On mêle le bruit selon .
- Débruiter. Quelques étapes de DDIM donnent les paires de boîtes.
Prenons un exemple. Sur MOT17, on règle 800 boîtes, dont 25 % viennent de l'image précédente. Si 40 personnes étaient suivies dans l'image précédente, cela fait 200 boîtes a priori, chaque personne étant répétée 5 fois ; les 600 restantes sont aléatoires.
Les paires parties des boîtes a priori se chargent de prolonger dans l'image courante les personnes déjà suivies ; celles parties des boîtes aléatoires cherchent les personnes qui viennent d'apparaître, ou rattrapent celles qu'on avait perdues.
Exemple de calcul établi pour cette note.
Après le débruitage, les paires dont le score d'association est inférieur à 0.25 sont écartées, puis deux NMS éliminent les doublons. Les paires restantes sont raccordées aux trajectoires existantes par IoU. Les trajectoires perdues à cause d'une occultation voient leur position estimée par un simple filtre de Kalman, puis sont appariées une seconde fois avec les nouvelles boîtes trouvées.
La quantité de bruit à ajouter dépend de la vitesse des objets. Les auteurs font varier le pas de temps de la diffusion avec le déplacement moyen entre les deux images : plus ça bouge, plus le bruit est fort, et plus le réseau a de marge pour corriger. Différents passages d'une même vidéo peuvent donc recevoir des quantités de bruit différentes ; c'est la « souplesse » évoquée plus haut.
Discussion
Combien d'a priori, quel bruit
Pour toutes les ablations, on entraîne sur la première moitié de l'ensemble d'entraînement de MOT17 et l'on teste sur la seconde :
| Part d'a priori | MOTA | IDF1 | HOTA |
|---|---|---|---|
| 0 % | 71.2 | 65.9 | 58.1 |
| 25 % | 73.6 | 70.0 | 60.7 |
| 50 % | 74.5 | 71.2 | 61.8 |
| 75 % | 74.1 | 71.4 | 61.9 |
| 100 % | 72.9 | 66.8 | 58.4 |
D'après la Table 1(a) de l'article, ensemble de validation de MOT17.
0 % revient à n'utiliser aucune information de l'image précédente et à tout redétecter à chaque image ; 100 %, à n'ajouter aucune boîte aléatoire. Les deux extrêmes font moins bien, et les proportions intermédiaires donnent les meilleurs résultats. Au premier manquent les indices de suivi, au second les boîtes aléatoires qui cherchent les nouveaux venus.
Le bruit des boîtes de complément compte aussi. Le bruit gaussien est le meilleur, avec un HOTA de 60.7 ; avec une loi de Poisson ou une loi uniforme, ou en complétant carrément avec des boîtes de la taille de l'image, le HOTA tombe sous 59.
Pour relier la quantité de bruit au déplacement, une fonction logarithmique fait le mieux, avec un HOTA de 62.6 ; une fonction linéaire donne 60.7, une valeur fixe 58.2.
Plus de boîtes, plus d'étapes
| Boîtes | Étapes | MOTA | HOTA | FLOPs | FPS |
|---|---|---|---|---|---|
| 500 | 1 | 71.5 | 58.4 | 229.6G | 21.05 |
| 500 | 2 | 71.7 | 59.5 | 459.2G | 10.47 |
| 800 | 1 | 73.6 | 60.7 | 367.3G | 15.89 |
| 1000 | 1 | 74.1 | 61.3 | 459.1G | 13.37 |
D'après la Table 1(d) de l'article, ensemble de validation de MOT17, une RTX 3090, FP16.
L'un des avantages des modèles de diffusion, c'est qu'une fois l'entraînement terminé, le nombre de boîtes comme le nombre d'étapes de débruitage se règlent à l'inférence. Un peu plus de boîtes, quelques étapes de plus, et le score s'améliore un peu tandis que la vitesse baisse un peu, sans rien réentraîner.
D'après le tableau, toutefois, ajouter des boîtes rapporte plus qu'ajouter des étapes. Pour un coût de calcul comparable, autour de 459G, 1000 boîtes en 1 étape donnent un HOTA de 61.3, contre 59.5 seulement pour 500 boîtes en 2 étapes. En annexe, les auteurs reconnaissent eux aussi que le débruitage en plusieurs étapes n'apporte qu'un gain limité.
Quand la détection est perturbée
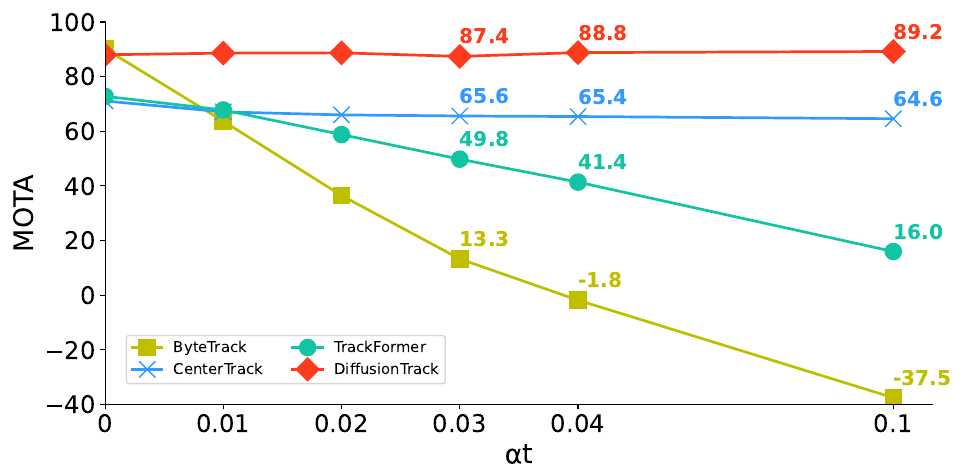
C'est la figure la plus frappante de l'article. Les auteurs mêlent du bruit aux boîtes de détection, dans une proportion allant de 0 à 0.1. ByteTrack, qui dépend entièrement des boîtes de détection, a déjà un MOTA négatif à 0.04 ; DiffusionTrack n'est presque pas affecté.
Le résultat n'a rien de surprenant. Des boîtes bruitées, c'est l'entrée habituelle de DiffusionTrack, et débruiter, son travail de tous les jours.
Pour lire cette figure, il faut faire attention au protocole. D'après la légende, les quatre traqueurs sont entraînés sur l'ensemble d'entraînement de MOT17 puis évalués sur val-half, qui n'est autre que la seconde moitié de cet ensemble d'entraînement. Voilà pourquoi DiffusionTrack, sans perturbation, a un MOTA proche de 89, bien au-dessus des 73.6 des ablations précédentes. On peut comparer l'allure des courbes, mais les valeurs elles-mêmes ne se confrontent pas aux autres tableaux.
Face aux autres méthodes
| Jeu | Méthode | MOTA | IDF1 | HOTA | AssA |
|---|---|---|---|---|---|
| MOT17 | ByteTrack | 80.3 | 77.3 | 63.1 | 62.0 |
| MOT17 | DiffusionTrack | 77.9 | 73.8 | 60.8 | 58.8 |
| MOT20 | ByteTrack | 77.8 | 75.2 | 61.3 | 59.6 |
| MOT20 | DiffusionTrack | 72.8 | 66.3 | 55.3 | 51.3 |
| DanceTrack | OC-SORT | 89.6 | 54.6 | 54.6 | 40.2 |
| DanceTrack | DiffusionTrack | 89.3 | 47.5 | 52.4 | 33.5 |
D'après la Table 2 de l'article pour MOT17 et MOT20, et la Table 3 pour DanceTrack ; ensembles de test, détections privées.
Parmi les méthodes de détection et suivi conjoints, DiffusionTrack est la meilleure du tableau de l'article : un MOTA de 77.9 sur MOT17, au-dessus des 74.1 de TrackFormer et des 71.9 de MOTR. Mais face à ByteTrack et OC-SORT, qui détectent puis suivent, il reste derrière sur les trois jeux de données.
Dans le détail, la force de DiffusionTrack est la détection. Sur DanceTrack, son DetA de 82.2 dépasse même les 80.4 d'OC-SORT ; son AssA n'est en revanche que de 33.5, 6.7 de moins qu'OC-SORT. Sur MOT17, il compte 3 819 changements d'identité, contre 2 196 seulement pour ByteTrack.
Les auteurs testent aussi une version de référence qui n'ajoute du bruit qu'à l'image . Sur MOT17, son HOTA est de 55.9, 4.9 de moins que DiffusionTrack ; sur MOT20, bondé, il n'est plus que de 42.5, et sur DanceTrack, aux mouvements complexes, de 44.0. Selon les auteurs, la version de référence apprend seulement à régresser de la boîte de l'image précédente vers celle de l'image courante, alors que bruiter les deux images ensemble force le réseau à apprendre à distinguer les objets.
Le prix
La tête de diffusion compte 236 millions de paramètres entraînables, et demande environ 30 heures d'entraînement sur 8 RTX 3090. À l'inférence, 800 boîtes en une étape coûtent 367G par image, pour environ 16 FPS. Les auteurs mentionnent aussi en annexe que les petits objets de MOT20 sont mal traités.
Conclusion
DiffusionTrack écrit le suivi comme un problème de débruitage : les boîtes d'une même personne dans deux images sont façonnées peu à peu à partir d'une paire de boîtes bruitées. Détection et suivi sont entraînés avec le même réseau et le même objectif ; le nombre de boîtes et le nombre d'étapes de débruitage se règlent à l'inférence ; et quand les boîtes de détection sont perturbées, il tient bon.
Son point faible, c'est l'association. Ses métriques de détection sont très bonnes, mais ses métriques d'identité ne rattrapent toujours pas plusieurs méthodes fondées sur le filtre de Kalman et l'IoU, et lui-même finit par recourir à l'IoU et au filtre de Kalman pour raccorder les trajectoires.
Les modèles de diffusion ont encore un autre usage en suivi. Six mois plus tard, DiffMOT ne s'en sert pas pour générer des boîtes, mais pour prédire où une personne va aller ensuite.