Article original
StrongSORT: Make DeepSORT Great Again
- Publication
- IEEE Transactions on Multimedia 2023Revue
- Premier dépôt sur arXiv
- arXiv:2202.13514
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{multiobjecttrackingstrongsort2022,
  title = {{StrongSORT: Make DeepSORT Great Again}},
  author = {Yunhao Du and Zhicheng Zhao and Yang Song and Yanyun Zhao and Fei Su and Tao Gong and Hongying Meng},
  year = {2022},
  eprint = {2202.13514},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2202.13514}
}
Les classements du suivi multi-objets sont de plus en plus difficiles à lire.
Chaque article utilise un détecteur différent, Faster R-CNN pour l'un, CenterNet pour l'autre, YOLOX pour un troisième ; les modèles re-ID diffèrent aussi, la quantité de données d'entraînement supplémentaires varie, et chacun ajoute ses propres petites astuces à l'inférence. Quand une méthode a deux points de plus qu'une autre, difficile de dire si c'est l'algorithme d'association qui est meilleur, le détecteur qui est plus fort, ou une astuce qui a ajouté un petit quelque chose.
Yunhao Du et ses collègues de l'Université des postes et télécommunications de Pékin décident de revenir à une vieille connaissance, DeepSORT.
Ce traqueur de 2017 est simple et facile à étendre, très utilisé en ingénierie, mais distancé depuis longtemps dans les classements. Pour les auteurs, s'il est à la traîne, c'est parce que ses pièces sont trop vieilles ; son cadre de suivi n'y est pour rien. Il suffit donc de remplacer les pièces une à une et de voir jusqu'où il peut aller.
Le titre de l'article est « Make DeepSORT Great Again ».
À force de lire des articles, on finit par remarquer que, ces temps-ci, tout le monde est très occupé à rendre leur grandeur aux choses. RepVGG veut rendre sa grandeur à VGG, et dès l'année suivante, quelqu'un veut rendre RepVGG « encore plus » grand ; GCN, FCN, encodeur-décodeur, LoRA, et même Sigmoid avec MSE font la queue pour redevenir grands à leur tour. Un bon slogan de campagne électorale, que le milieu de la recherche a tant usé qu'il en sent le moisi. (Chers auteurs, cette blague peut vraiment prendre sa retraite.)
Heureusement, cette fois, c'est au tour de DeepSORT, et les résultats sont bien au rendez-vous.
Définir le problème
Les auteurs veulent régler deux choses.
La première est la comparaison équitable. Ils veulent fournir une référence solide et équitable, avec de bons détecteurs et modèles re-ID actuels, plus un ensemble ordonné d'astuces d'inférence. C'est en se comparant à cette référence qu'une nouvelle méthode saura où se situe son apport. Les auteurs précisent aussi que cette partie ne revendique aucune nouveauté algorithmique ; leur contribution consiste à démonter proprement DeepSORT et à l'équiper de nouvelles pièces.
La seconde concerne deux formes de « manque » inhérentes au suivi multi-objets :
- L'association manquante (missing association) : un même objet est découpé en plusieurs trajectoires courtes. Les traqueurs en ligne, privés d'information globale, y sont particulièrement sujets.
- La détection manquante (missing detection) : l'objet est pris pour du fond, autrement dit il n'est pas détecté, en général à cause d'une occultation ou d'une résolution trop faible.
Les solutions existantes ont chacune leur prix. Pour relier des trajectoires courtes en longues trajectoires, l'approche courante consiste à utiliser des modèles de liaison globale hors ligne, mais la plupart reposent sur des caractéristiques d'apparence et demandent beaucoup de calcul. Pour combler les détections manquées, on utilise souvent l'interpolation linéaire, qui ignore complètement l'information de mouvement.
Résoudre le problème
D'abord, démonter DeepSORT
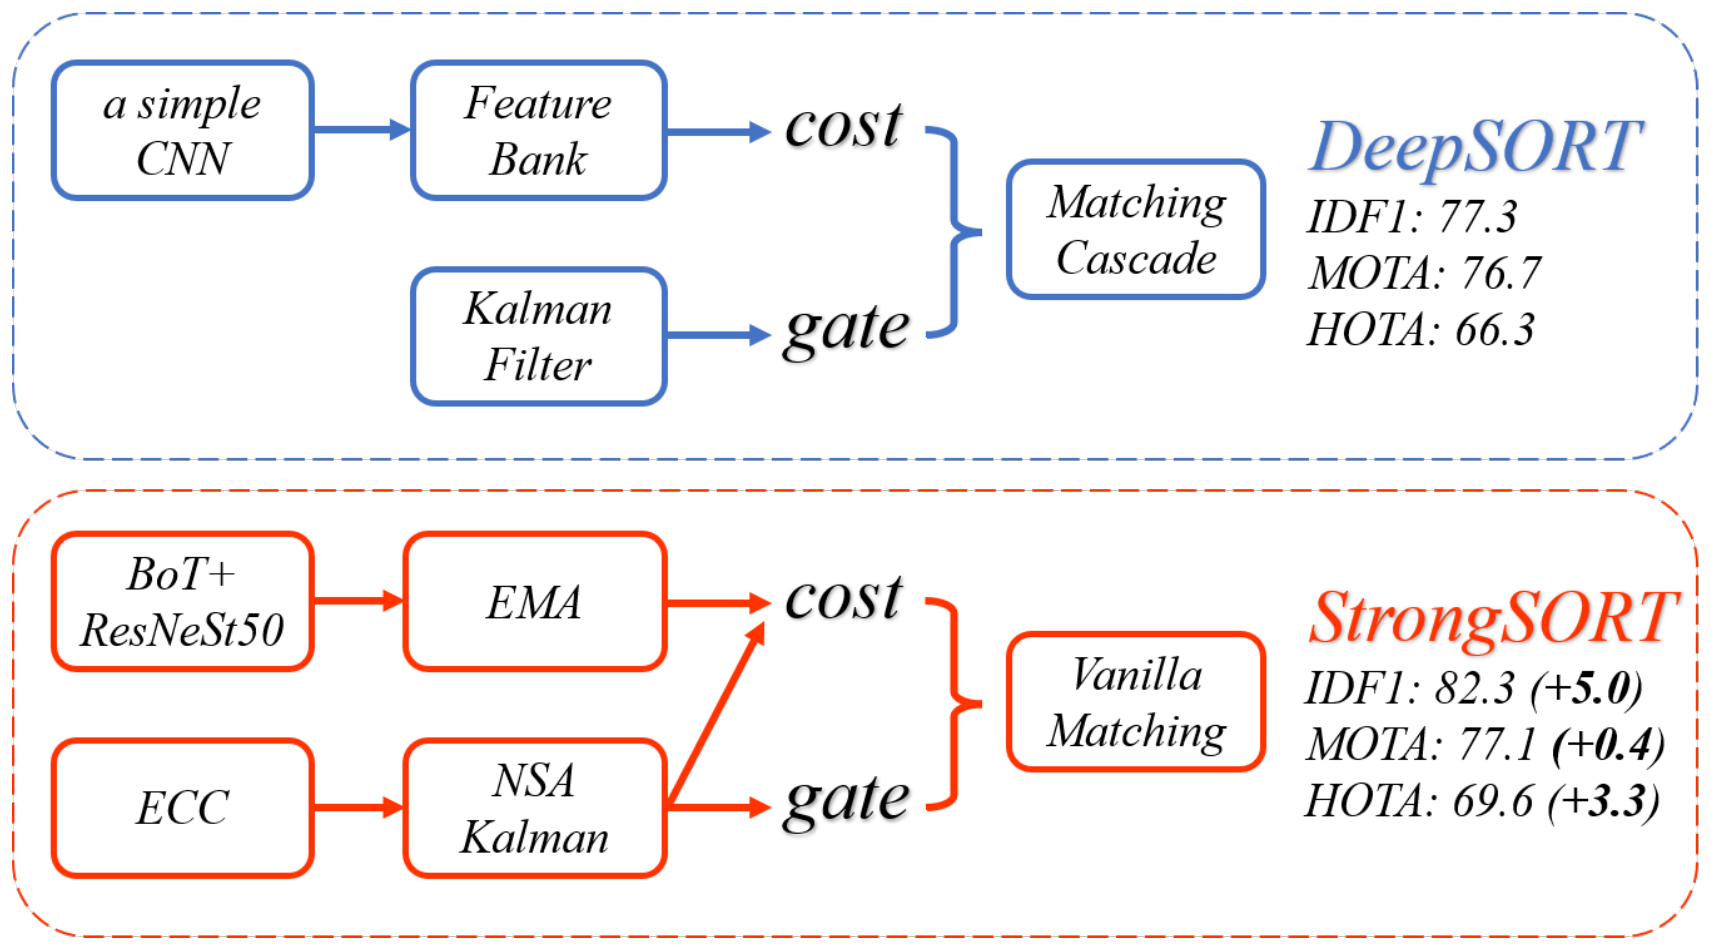
Les auteurs voient DeepSORT comme deux branches.
Branche d'apparence : un CNN simple, préentraîné sur le jeu de données de piétons MARS, extrait les caractéristiques de chaque boîte de détection. Chaque trajectoire garde les caractéristiques de ses 100 dernières images dans une banque de caractéristiques ; la distance d'apparence entre une nouvelle détection et une trajectoire est la distance cosinus entre la détection et la caractéristique la plus proche de la banque.
Branche de mouvement : le filtre de Kalman prédit la position de la trajectoire dans l'image courante, puis la distance de Mahalanobis sert de seuil pour écarter les appariements impossibles.
Enfin, la cascade d'appariement découpe l'appariement en plusieurs sous-problèmes, et laisse choisir en premier les trajectoires vues le plus récemment.
Pour comparer équitablement, il faut d'abord unifier le détecteur. Les scores de la moitié supérieure de la figure sont ceux de DeepSORT une fois son détecteur remplacé par le même YOLOX-X que ByteTrack. À détection identique, les écarts restants viennent tous du traqueur lui-même.
Changer les pièces une à une
Un modèle d'apparence plus fort (BoT). Le CNN simple d'origine est remplacé par BoT, une référence solide du domaine re-ID qui rassemble de nombreuses astuces d'entraînement, avec un backbone ResNeSt50 préentraîné sur DukeMTMC.
Mise à jour des caractéristiques par EMA. La banque de caractéristiques de DeepSORT stocke aussi les caractéristiques de détections occasionnellement très mauvaises. Les auteurs maintiennent plutôt l'état d'apparence de chaque trajectoire par une moyenne mobile exponentielle (EMA) :
est la caractéristique de la détection appariée dans l'image courante, et . L'ancien état d'apparence compte pour 90 %, la nouvelle image pour 10 % seulement, si bien que le bruit d'une seule image fait difficilement dévier l'apparence. On n'a plus non plus à calculer un par un les distances aux 100 caractéristiques de la banque, ce qui va plus vite.
Compensation du mouvement de caméra (ECC). MOTChallenge, DanceTrack et KITTI contiennent tous des vidéos où la caméra bouge. Les auteurs reprennent l'alignement d'images par coefficient de corrélation amélioré (ECC) pour estimer la rotation et la translation globales entre deux images adjacentes, et déplacent d'abord la position prédite des trajectoires pour suivre la caméra. C'est la même méthode que celle de Tracktor++.
Filtre de Kalman NSA. Un filtre de Kalman ordinaire traite de la même façon le bruit d'observation de toutes les boîtes de détection. Le filtre de Kalman NSA (Noise Scale Adaptive), emprunté à GIAOTracker, ajuste le bruit d'observation selon le score de détection :
est le score de détection. Pour une boîte à 0.9, le bruit d'observation n'est plus que le dixième de sa valeur d'origine, et le filtre lui fait davantage confiance ; pour une boîte à 0.6, il en reste encore 40 %, et le filtre s'appuie davantage sur sa propre prédiction.
Coût de mouvement. Dans ses expériences, DeepSORT ne prenait que la distance d'apparence comme coût, le mouvement ne servant que de seuil. StrongSORT combine les deux en un coût pondéré :
Ce poids reprend le réglage de méthodes comme FairMOT.
Appariement ordinaire. Enfin, la cascade d'appariement est supprimée et remplacée par une seule affectation linéaire globale. Nous verrons pourquoi avec les ablations.
Deux extensions : AFLink et GSI
Le traqueur équipé de toutes ces pièces s'appelle StrongSORT. Les auteurs proposent en plus deux algorithmes de post-traitement légers, indépendants du modèle et sans caractéristiques d'apparence ; avec eux, on obtient StrongSORT++. Ces deux algorithmes ont besoin de voir les trajectoires de toute la vidéo ; StrongSORT++ est donc une méthode hors ligne.
AFLink (Appearance-Free Link) : recoller les trajectoires brisées.
AFLink ne regarde que l'information spatio-temporelle de deux trajectoires courtes pour juger s'il s'agit du même objet. Chaque trajectoire courte est réduite à ses 30 dernières images, avec trois nombres par image, le numéro d'image et la position , ; les trajectoires de moins de 30 images sont complétées par des zéros. Une trajectoire courte devient ainsi une petite matrice .
Chacune des deux trajectoires courtes entre dans sa propre branche, et les deux branches ne partagent pas leurs poids :
- Module temporel : quatre couches Conv-BN-ReLU à noyaux , qui ne convoluent que le long de l'axe temporel, avec 32, 64, 128 puis 256 canaux.
- Module de fusion : une couche de convolution , qui fusionne l'information des trois dimensions, numéro d'image, et .
Les sorties des deux branches passent par un pooling, sont aplaties puis concaténées, et entrent dans un classifieur à deux couches entièrement connectées, qui donne la probabilité que les deux trajectoires appartiennent au même objet.
Les données d'entraînement sont découpées directement dans les trajectoires réelles. Les trajectoires annotées sont coupées en trajectoires courtes, avec un bruit spatio-temporel aléatoire, dans un rapport de 1:3 entre exemples positifs et négatifs, et le modèle est entraîné 20 epochs avec une entropie croisée binaire. Tout l'entraînement ne prend qu'une dizaine de secondes.
À l'inférence, on écarte d'abord les paires de trajectoires séparées de plus de 30 images dans le temps ou de plus de 75 pixels dans l'espace, puis on utilise le score d'AFLink comme similarité pour une affectation linéaire ; deux trajectoires ne sont reliées que si le score dépasse 0.95.
GSI (Gaussian-Smoothed Interpolation) : boucher les trous, et lisser les tremblements au passage.
L'interpolation linéaire trace une droite entre les deux bords du trou, sans se soucier de la façon dont l'objet bouge réellement. GSI considère la position des boîtes de chaque trajectoire comme une fonction du temps, ajustée par régression par processus gaussien :
est le de la boîte à l'image , et un bruit gaussien. Pour les images à prédire, la position lissée est donnée par la moyenne a posteriori du processus gaussien :
La largeur du noyau règle le degré de lissage de la trajectoire ; les auteurs l'adaptent à la longueur de la trajectoire : , avec . Le trou maximal interpolé est de 20 images.
GSI ne se contente pas de boucher les trous. Il réajuste toute la trajectoire, ce qui lisse aussi les petits tremblements image par image des boîtes de détection. Les auteurs le voient comme une sorte de filtre du bruit de détection ; avec l'interpolation linéaire, la courbe de vitesse d'une trajectoire tremble fortement, alors qu'avec GSI elle devient bien plus régulière, ce qui aide les applications qui doivent ensuite estimer des vitesses.
Discussion
Le détecteur est un YOLOX-X, entraîné comme dans ByteTrack. À l'inférence, le seuil de NMS est de 0.8, le seuil de score de détection de 0.6 et le seuil de distance d'appariement de 0.45. Les ablations coupent chaque vidéo de l'ensemble d'entraînement de MOT17 en deux moitiés, et toutes les expériences tournent sur une seule V100.
Que vaut chaque pièce ?
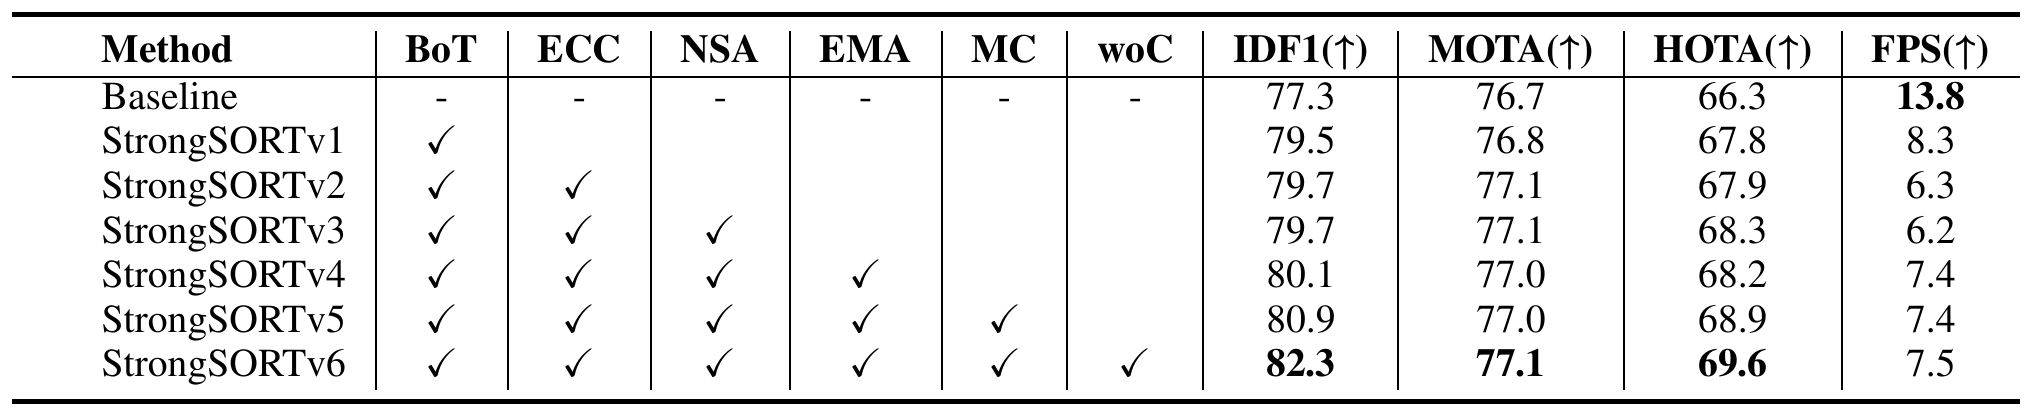
De haut en bas, chaque ligne ajoute une pièce :
- BoT : IDF1 +2.2, HOTA +1.5. De meilleures caractéristiques d'apparence, c'est la modification la plus utile de toutes, mais les FPS tombent de 13.8 à 8.3.
- ECC : IDF1 +0.2, MOTA +0.3, et les FPS tombent encore, à 6.3.
- NSA : HOTA +0.4, MOTA et IDF1 inchangés. Ce qui s'améliore, c'est la précision de localisation, justement ce que HOTA prend en compte et que MOTA et IDF1 comptent peu.
- EMA : IDF1 +0.4, et les FPS remontent à 7.4.
- Coût de mouvement : IDF1 +0.8.
- Suppression de la cascade d'appariement : IDF1 +1.4, HOTA +0.7.
Au bout des six étapes, IDF1 passe de 77.3 à 82.3 et HOTA de 66.3 à 69.6, alors que MOTA ne gagne que 0.4. Ces pièces améliorent surtout l'association ; la détection, elle, n'a pas changé.
La vitesse, en revanche, a presque été divisée par deux.
Pourquoi supprimer la cascade d'appariement ?
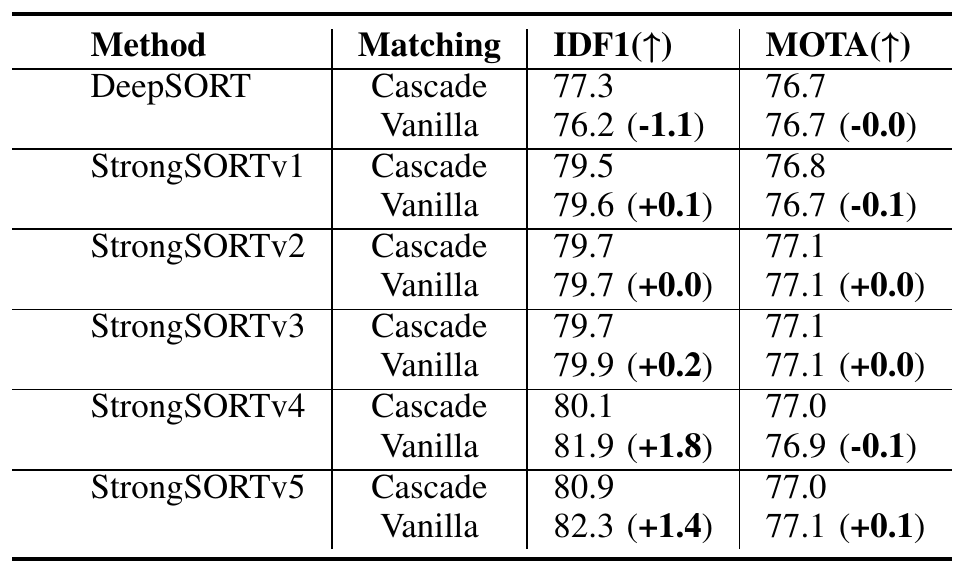
Ce tableau compare la cascade et l'appariement ordinaire sur chacune des versions.
Pour le DeepSORT d'origine, la cascade est utile ; sans elle, IDF1 perd 1.1 point. Mais plus le traqueur est fort, plus le bénéfice de la cascade diminue ; avec v4 et v5, la supprimer fait au contraire gagner 1.8 et 1.4 points d'IDF1.
Nous avons vu, avec DeepSORT, ce qui motive la cascade. La distance de Mahalanobis favorise les trajectoires incertaines ; on laisse donc choisir en premier les trajectoires vues le plus récemment. Les auteurs concluent que cet a priori réduit les appariements confus pour un traqueur faible, mais que lorsque les caractéristiques d'apparence sont assez fortes et que le coût intègre aussi le mouvement, le traqueur se trompe déjà rarement, et cette contrainte supplémentaire finit par l'entraver.
Sur quels traqueurs greffer AFLink et GSI ?
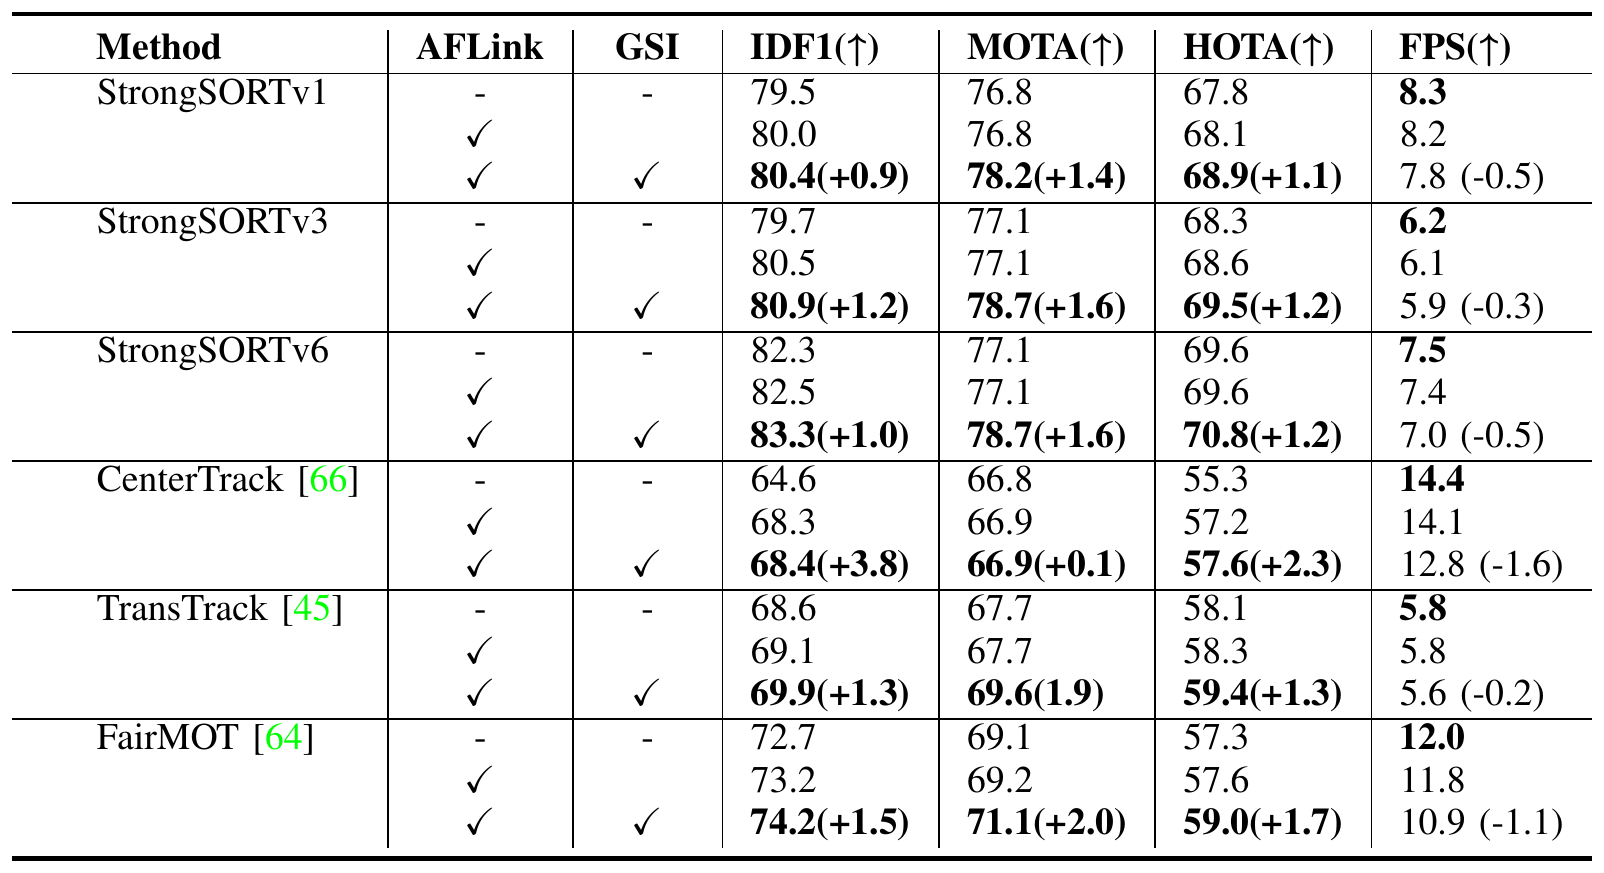
Chaque traqueur occupe trois lignes : la version d'origine, avec AFLink, puis avec GSI en plus.
Plus le traqueur est faible, plus AFLink l'aide. CenterTrack ne fait qu'un appariement local entre images adjacentes, et une personne cachée devient une nouvelle trajectoire dès que la sienne se brise ; avec AFLink, son IDF1 gagne 3.7 points. StrongSORTv6, dont les trajectoires se brisent rarement, ne gagne que 0.2 point.
Selon les auteurs, GSI fait l'inverse ; plus le traqueur est fort, plus il est utile. Il améliore à la fois MOTA et HOTA ; les boîtes ajoutées réduisent les détections manquées, et les boîtes lissées collent mieux aux positions réelles. Mais si une trajectoire contient déjà beaucoup d'associations erronées, GSI lisse tout aussi joliment les mauvaises trajectoires.
Sur MOT17, ils coûtent respectivement 1.7 ms et 7.1 ms par image.
Classements
Sur l'ensemble de test de MOT17, StrongSORT obtient un HOTA de 63.5, un IDF1 de 78.5, un MOTA de 78.3 et 1446 changements d'identité (ID switches). Le DeepSORT reproduit par les auteurs avec YOLOX obtient 61.2, 74.5 et 78.0, et le ByteTrack reproduit (sans interpolation linéaire) 62.8, 77.2 et 78.9. Avec le même détecteur, StrongSORT associe mieux que les deux, et son MOTA est proche de celui de ByteTrack.
StrongSORT++, avec AFLink et GSI, obtient 64.4, 79.5 et 79.6 ; il est alors premier en HOTA, IDF1, AssA et DetA, et dépasse le deuxième de 2.1 points en IDF1 comme en AssA.
Sur MOT20, StrongSORT++ obtient un HOTA de 62.6, un IDF1 de 77.0 et seulement 770 changements d'identité ; mais son MOTA de 73.8 est inférieur aux 77.8 rapportés dans l'article de ByteTrack. Les auteurs l'expliquent par le seuil de score de détection repris de MOT17, qui fait manquer beaucoup de personnes dans les foules de MOT20 ; StrongSORT++ compte 117 920 FN, contre seulement 87 594 pour ByteTrack. C'est justement le problème que l'article ByteTrack voulait résoudre.
Sur DanceTrack, StrongSORT++ obtient un HOTA de 55.6, légèrement au-dessus des 55.1 d'OC-SORT. Détail intéressant, les auteurs retirent sur DanceTrack les deux améliorations liées à l'apparence, BoT et EMA. Les danseurs sont tous habillés à peu près pareil, et les caractéristiques d'apparence n'y servent à rien.
Les limites reconnues par les auteurs
Premièrement, la lenteur. Un cadre à la DeepSORT a besoin d'un modèle re-ID supplémentaire, et StrongSORT ne tourne qu'à 7.5 FPS sur MOT17 et 1.5 FPS sur MOT20. Deuxièmement, un seuil de détection trop élevé, qui tire le MOTA vers le bas sur MOT17 et MOT20. Troisièmement, AFLink ne peut que recoller des trajectoires brisées ; il ne sait pas séparer des trajectoires mélangées.
La suite
StrongSORT est effectivement devenu une référence courante, et des méthodes ultérieures comme Deep OC-SORT l'incluent dans leurs tableaux comparatifs. Un peu plus tard la même année, BoT-SORT emprunte un chemin similaire, en ajoutant à ByteTrack la compensation du mouvement de caméra et la fusion re-ID ; des bibliothèques de suivi open source comme BoxMOT ont aussi intégré StrongSORT à leur liste de traqueurs interchangeables.
Conclusion
Pas de nouveau cadre de suivi, seulement des pièces remplacées une à une. StrongSORT change tour à tour le détecteur, le modèle d'apparence, la mise à jour des caractéristiques, le filtre de Kalman, le coût et l'appariement de DeepSORT, et montre qu'un cadre de 2017 peut encore se placer parmi les meilleurs en 2022. Les vraies nouveautés sont AFLink et GSI, deux post-traitements sans apparence, qui s'exécutent en quelques millisecondes et se branchent à la suite de n'importe quel traqueur.
Il décompose un « traqueur fort » en une suite de gains successifs. Changer de modèle re-ID vaut 2.2 points d'IDF1, supprimer la cascade d'appariement 1.4 point, et une fois tout changé, la vitesse tombe de 13.8 à 7.5 FPS. Au moment de choisir ses astuces, ce barème rend bien service.
Quatre mois plus tard, BoT-SORT montait une compensation de caméra et une re-ID similaires sur ByteTrack, et poussait les résultats sur MOT17 encore un peu plus loin.