Article original
DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models
- Publication
- Lieu de publication non encore vérifié
- Premier dépôt sur arXiv
- arXiv:2402.03300
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{deepseekdeepseekmath2024,
  title = {{DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models}},
  author = {Zhihong Shao and Peiyi Wang and Qihao Zhu and Runxin Xu and Junxiao Song and Xiao Bi and Haowei Zhang and Mingchuan Zhang and Y. K. Li and Y. Wu and Daya Guo},
  year = {2024},
  eprint = {2402.03300},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2402.03300}
}
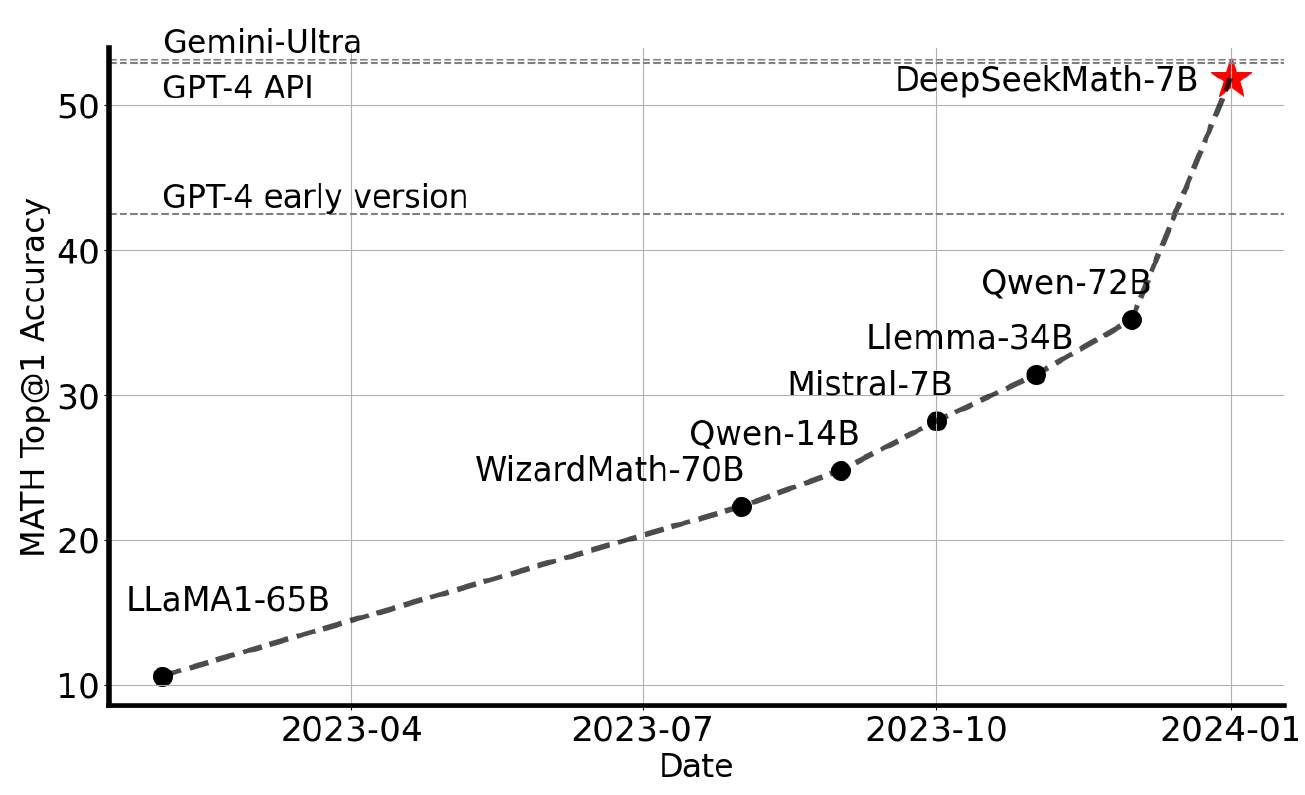
Début 2024, sur MATH, un benchmark de mathématiques de niveau compétition, GPT-4 et Gemini Ultra ont déjà dépassé les 50 %, alors que les modèles open source restent loin derrière. Quelles données ces modèles fermés utilisent, et comment ils sont entraînés, personne à l'extérieur ne le sait.
Shao, Wang, Zhu et leurs collègues de DeepSeek veulent construire un modèle de mathématiques open source, avec seulement 7 milliards de paramètres. Pour cela, ils extraient d'abord 120 milliards de tokens de données mathématiques des pages web publiques de Common Crawl, puis proposent un algorithme d'apprentissage par renforcement plus économe que PPO, baptisé GRPO.
Résultat, sans aucun outil externe ni vote, DeepSeekMath 7B obtient 51.7 % sur MATH, près de Gemini Ultra et de GPT-4 ; avec un vote sur 64 échantillons, il atteint 60.9 %.
Définir le problème
L'article veut répondre à deux questions.
Premièrement, d'où viennent les bonnes données mathématiques ? Les corpus mathématiques existants proviennent surtout d'articles arXiv ou de collections de pages web de taille modeste. Le web public contient-il assez de contenu mathématique, et d'une qualité suffisante ?
Deuxièmement, jusqu'où l'apprentissage par renforcement peut-il pousser le modèle après le fine-tuning supervisé ? PPO était alors l'approche la plus courante, mais il exige d'entraîner en plus un modèle de valeur aussi grand que le modèle lui-même, ce qui coûte cher.
Résoudre le problème
1. Extraire les pages mathématiques de Common Crawl
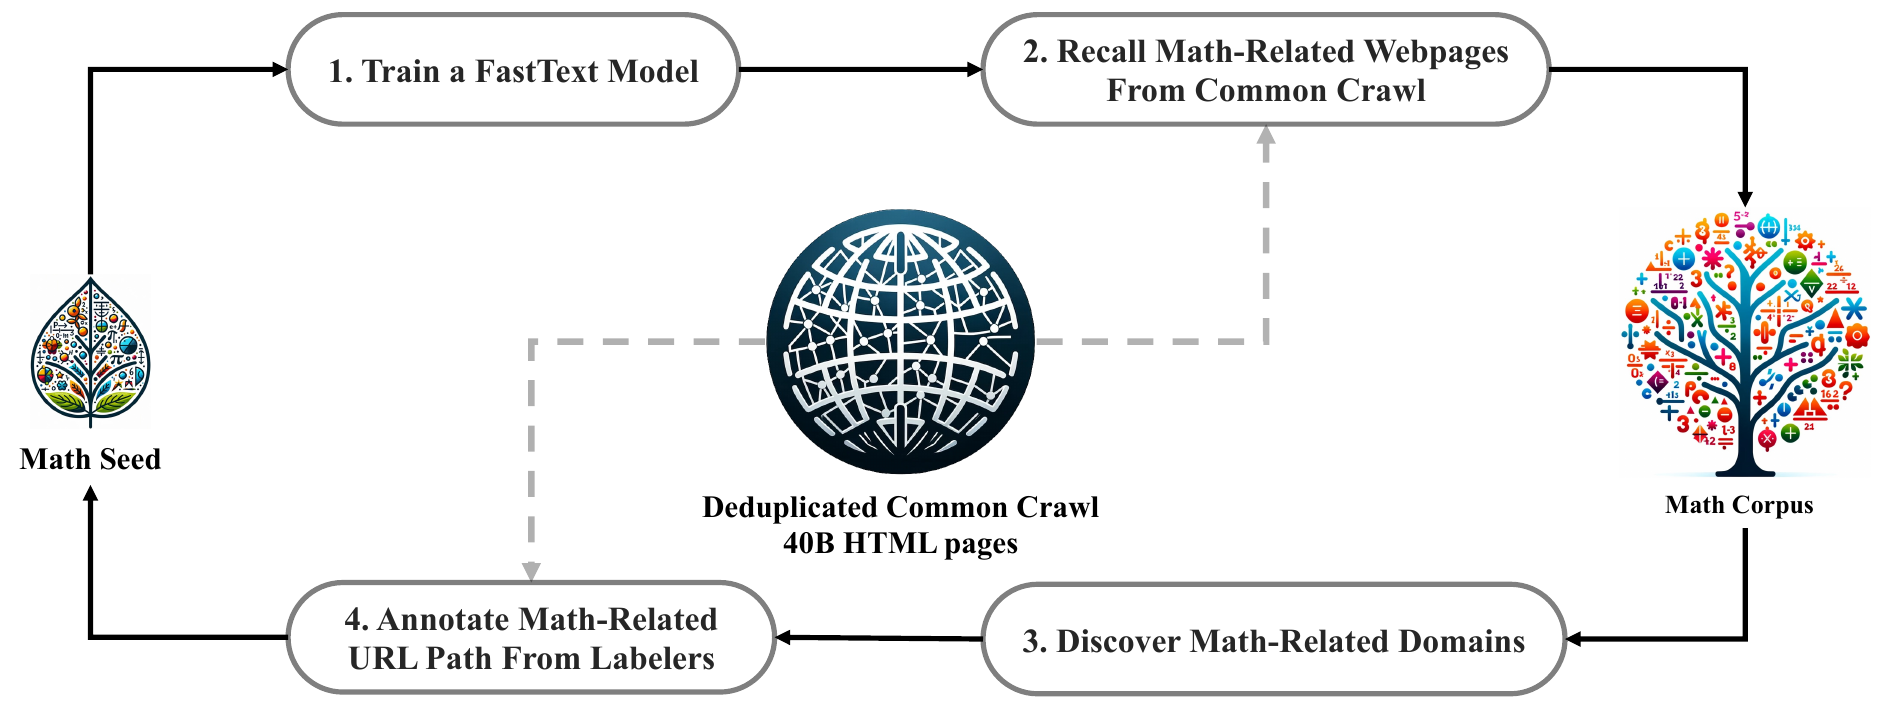
Le processus est une boucle :
- Entraîner un classifieur : on prend comme amorce OpenWebMath, une collection de pages web mathématiques de haute qualité, dont on tire au hasard 500 000 exemples positifs ; on tire aussi au hasard 500 000 pages de Common Crawl comme exemples négatifs, et l'on entraîne un classifieur fastText.
- Récupérer les pages : on déduplique d'abord Common Crawl, ce qui laisse 40 milliards de pages HTML. Le classifieur les note, et l'on ne garde que la tranche la mieux notée. Au premier tour, on garde les 40 premiers milliards de tokens.
- Repérer les domaines mathématiques : au premier tour, le classifieur n'a vu qu'OpenWebMath ; ses exemples positifs manquent de diversité, et beaucoup de pages mathématiques lui échappent. Les auteurs regroupent les pages par domaine ; si plus de 10 % des pages d'un domaine ont été retenues, ce domaine est considéré comme lié aux mathématiques, par exemple mathoverflow.net.
- Annoter les URL à la main : dans ces domaines, des humains indiquent quels chemins d'URL relèvent des mathématiques, par exemple mathoverflow.net/questions. Les pages de ces chemins qui n'ont pas encore été collectées sont ajoutées aux données d'amorce, et l'on réentraîne le classifieur.
Au bout de quatre tours, on obtient 35.5 millions de pages web et 120 milliards de tokens. Près de 98 % des données collectées au quatrième tour l'avaient déjà été au troisième ; on s'arrête donc là.
Pour éviter que des problèmes de benchmark se glissent dans les données d'entraînement, tout segment de texte qui partage une suite de 10 mots identiques avec une sous-chaîne quelconque de benchmarks comme GSM8K, MATH, CMATH ou AGIEval est supprimé en entier ; pour les textes de benchmark de moins de 10 mots, mais d'au moins 3 mots, on utilise une correspondance exacte.
Tester les données sur un petit modèle
Les auteurs entraînent DeepSeek-LLM 1.3B sur chaque corpus mathématique, à raison de 150 milliards de tokens chacun, et comparent les résultats :
| Corpus | Taille | GSM8K | MATH | CMATH |
|---|---|---|---|---|
| Sans entraînement mathématique | - | 2.9 | 3.0 | 12.3 |
| MathPile | 8.9B | 2.7 | 3.3 | 1.2 |
| OpenWebMath | 13.6B | 11.5 | 8.9 | 16.8 |
| Proof-Pile-2 | 51.9B | 14.3 | 11.2 | 19.9 |
| DeepSeekMath Corpus | 120.2B | 23.8 | 13.6 | 41.5 |
D'après la Table 1 de l'article ; sélection de colonnes, chaîne de pensée en few-shot, en %.
DeepSeekMath Corpus arrive en tête partout. Il contient aussi des pages mathématiques en chinois, d'où une progression particulièrement forte sur CMATH, un benchmark chinois ; les corpus uniquement anglais n'aident presque pas sur les benchmarks chinois, et MathPile fait même tomber CMATH de 12.3 % à 1.2 %.
Son autre avantage est sa taille. Les autres corpus sont plus petits ; pour entraîner sur 150 milliards de tokens, il faut les parcourir plusieurs fois, et les performances du modèle saturent vite.
DeepSeekMath-Base 7B
Le modèle de base part de DeepSeek-Coder-Base-v1.5 7B, dont l'entraînement se poursuit sur 500 milliards de tokens. Les données se répartissent ainsi : 56 % de DeepSeekMath Corpus, 4 % de code mathématique AlgebraicStack, 10 % d'arXiv, 20 % de code GitHub et 10 % de pages web générales en chinois et en anglais.
| Modèle | Taille | GSM8K | MATH |
|---|---|---|---|
| Minerva | 540B | 58.8 | 33.6 |
| Mistral | 7B | 40.3 | 14.3 |
| Llemma | 34B | 54.0 | 25.3 |
| DeepSeekMath-Base | 7B | 64.2 | 36.2 |
D'après la Table 2 de l'article ; sélection de lignes et de colonnes, chaîne de pensée en few-shot, en %.
Sur MATH, DeepSeekMath-Base dépasse les autres modèles de base open source de plus de 10 points de pourcentage, et passe aussi devant Minerva 540B, de Google. Minerva repose sur PaLM, avec un entraînement supplémentaire sur des données mathématiques, et compte 77 fois plus de paramètres que DeepSeekMath.
L'entraînement mathématique améliore aussi les capacités générales. Par rapport au point de départ, DeepSeek-Coder-Base-v1.5, MMLU passe de 42.9 % à 54.9 % et BBH de 42.9 % à 59.5 % ; comme les données d'entraînement contiennent aussi du code, les capacités de programmation sont à peu près préservées.
D'abord le code, ensuite les maths
L'idée qu'« apprendre à programmer améliore le raisonnement » revient souvent, mais n'avait pas été vraiment vérifiée. Les auteurs mènent une expérience contrôlée avec un modèle de 1.3B :
| Entraînement | GSM8K | MATH | GSM8K (Py) | MATH (Py) |
|---|---|---|---|---|
| Texte général 400B → maths 150B | 19.1 | 14.4 | 14.3 | 6.7 |
| Code 400B → maths 150B | 21.9 | 15.3 | 17.4 | 9.4 |
| Maths seules 150B | 20.5 | 13.1 | 11.4 | 6.5 |
| Code 400B et maths 150B mélangés | 17.6 | 12.1 | 19.7 | 13.5 |
D'après la Table 6 de l'article ; sélection de lignes et de colonnes, « Py » : résolution avec Python, en %.
Apprendre d'abord le code, puis les maths, donne de meilleurs résultats que commencer par du texte général, que l'on résolve les problèmes avec Python ou non. C'est aussi pour cette raison que les auteurs partent d'un modèle de code.
Entraîner sur un mélange de code et de maths donne la meilleure résolution avec Python, et le modèle oublie moins la programmation ; mais le raisonnement mathématique sans outil se dégrade. Les auteurs supposent qu'un modèle de 1.3B est trop petit pour absorber les deux types de données à la fois.
Les articles arXiv n'aident pas : les corpus mathématiques contiennent souvent des articles arXiv, mais les auteurs constatent qu'un entraînement sur arXiv seul n'apporte aucun progrès net sur les différents benchmarks mathématiques, que le modèle fasse 1.3B ou 7B, et fait même parfois reculer les scores. Les auteurs soulignent aussi les limites de cette conclusion ; ces benchmarks ne mesurent peut-être pas ce qu'apporte arXiv, et le résultat pourrait changer en mélangeant arXiv à d'autres données ou avec un modèle plus grand.
Fine-tuning supervisé
Les données d'instructions mathématiques comptent 776 000 exemples, en chinois et en anglais, avec des problèmes du primaire à l'université. Les solutions prennent trois formats : chaîne de pensée, programme de pensée (on écrit un programme Python pour résoudre le problème), et un format qui alterne raisonnement en langue naturelle et appels à des outils de programmation. Après 500 étapes d'entraînement, avec un batch de 256 et un taux d'apprentissage de , on obtient DeepSeekMath-Instruct 7B, qui atteint 46.8 % sur MATH sans outil et 57.4 % avec outils.
2. GRPO, sans modèle de valeur
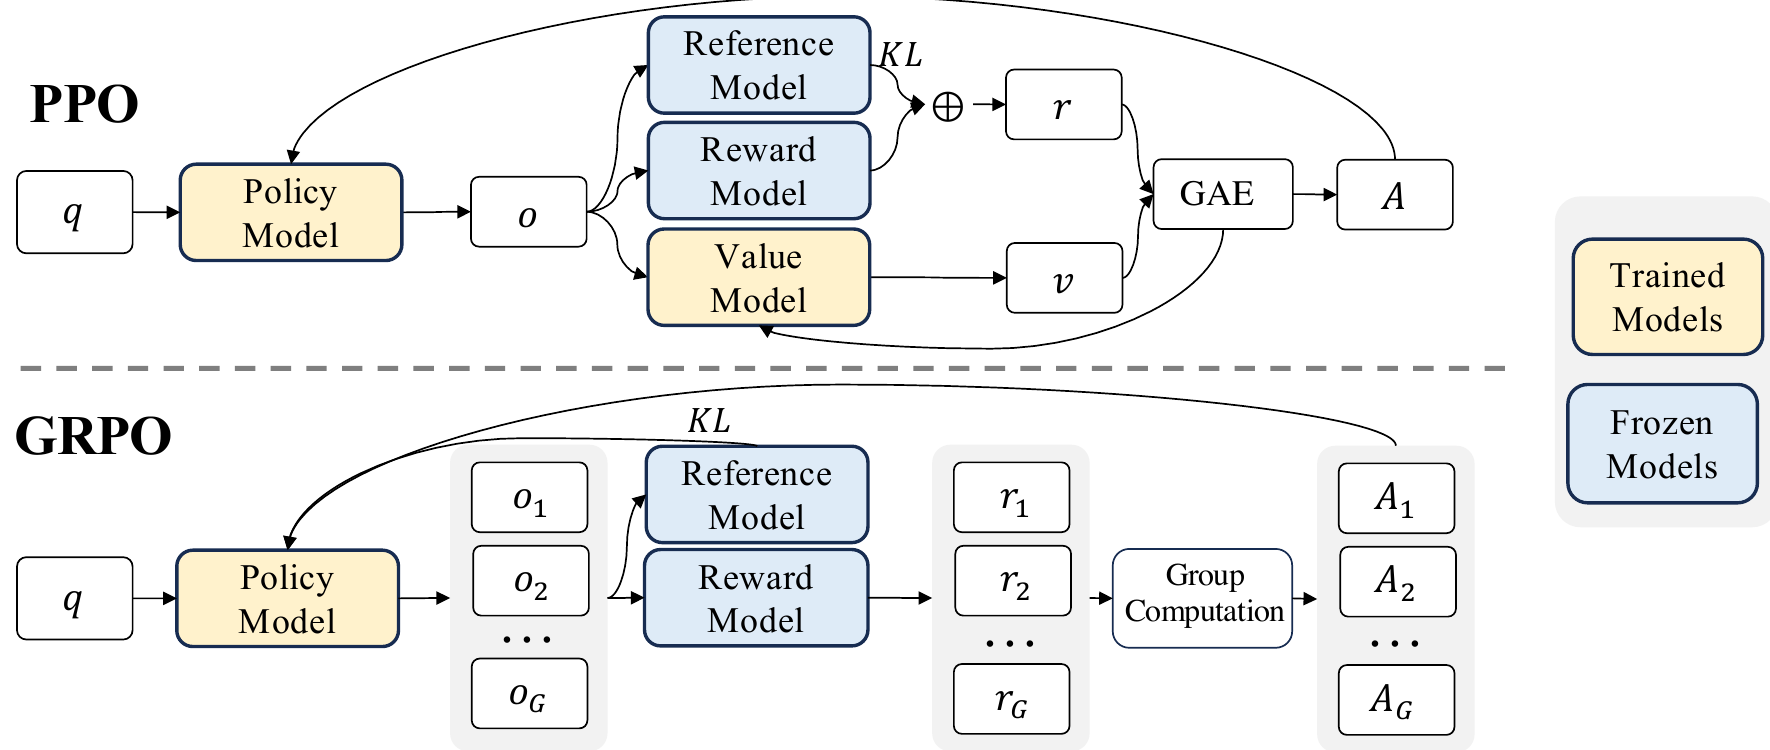
L'objectif de PPO est le suivant :
L'avantage s'y calcule par GAE, ce qui demande une fonction de valeur apprise. Ce modèle de valeur est en général aussi grand que le modèle de politique, ce qui double la mémoire et le calcul. De plus, la récompense d'un modèle de langage n'est en général attribuée qu'au dernier token ; entraîner une fonction de valeur précise à chaque token est déjà difficile en soi.
L'idée de GRPO est directe. Pour un même problème, on fait écrire réponses au modèle et l'on prend la récompense moyenne du groupe comme référence ; on encourage les réponses meilleures que la moyenne et l'on pénalise les moins bonnes, sans avoir besoin de modèle de valeur :
Ici, est le rapport entre les probabilités de la nouvelle et de l'ancienne politique pour le -ième token de la -ième réponse.
Avec la supervision du résultat, le modèle de récompense attribue un score à chaque réponse, que l'on normalise par la moyenne et l'écart-type du groupe ; tous les tokens de la réponse prennent cette même valeur comme avantage :
Faisons le calcul avec une récompense de 1 pour une bonne réponse et de 0 pour une mauvaise :
import statistics

def group_advantages(rewards, eps=1e-8):
    """Supervision du résultat dans GRPO : normalise les récompenses des G réponses à un même problème par la moyenne et l'écart-type du groupe"""
    mean = statistics.mean(rewards)
    std = statistics.pstdev(rewards)          # ici, écart-type de la population
    return [round((r - mean) / (std + eps), 2) for r in rewards]

# 8 réponses échantillonnées pour un même problème : 1 point si juste, 0 si faux
for rewards in ([1, 0, 0, 1, 0, 0, 0, 0], [1, 1, 1, 1, 1, 1, 1, 0], [1] * 8):
    print(rewards, "→", group_advantages(rewards))

# [1, 0, 0, 1, 0, 0, 0, 0] → [1.73, -0.58, -0.58, 1.73, -0.58, -0.58, -0.58, -0.58]
# [1, 1, 1, 1, 1, 1, 1, 0] → [0.38, 0.38, 0.38, 0.38, 0.38, 0.38, 0.38, -2.65]
# [1, 1, 1, 1, 1, 1, 1, 1] → [0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 0.0]
Dans un problème difficile, les rares bonnes réponses reçoivent un fort avantage positif ; dans un problème facile, la seule mauvaise réponse est lourdement pénalisée. Pour un problème où toutes les réponses sont justes (ou toutes fausses), l'avantage de chaque réponse est nul ; ce problème n'apporte rien à l'entraînement, et le calcul consacré à l'échantillonnage est dépensé en pure perte.
Avec la supervision du processus, le modèle de récompense de processus note chaque étape de chaque réponse, avec la même normalisation par la moyenne et l'écart-type des scores de toutes les étapes. L'avantage d'un token est la somme des scores normalisés de toutes les étapes qui le suivent.
Le traitement du KL diffère aussi. PPO ajoute la pénalité KL à la récompense de chaque token ; GRPO ajoute directement le KL à la fonction de perte, pour ne pas perturber le calcul de l'avantage. Le KL utilise l'estimateur ci-dessous, sans biais et jamais inférieur à 0 :
Comparons-le au simple log-rapport des deux probabilités :
import math

def kl_estimate(p_theta, p_ref):
    """Équation (4) de l'article : π_ref/π_θ − log(π_ref/π_θ) − 1, jamais inférieur à 0"""
    ratio = p_ref / p_theta
    return ratio - math.log(ratio) - 1

for p_theta, p_ref in [(0.5, 0.5), (0.6, 0.5), (0.4, 0.5), (0.9, 0.3)]:
    print(f"π_θ={p_theta}  π_ref={p_ref}  log(π_θ/π_ref)={math.log(p_theta / p_ref):+.3f}  éq.(4)={kl_estimate(p_theta, p_ref):.3f}")

# π_θ=0.5  π_ref=0.5  log(π_θ/π_ref)=+0.000  éq.(4)=0.000
# π_θ=0.6  π_ref=0.5  log(π_θ/π_ref)=+0.182  éq.(4)=0.016
# π_θ=0.4  π_ref=0.5  log(π_θ/π_ref)=-0.223  éq.(4)=0.027
# π_θ=0.9  π_ref=0.3  log(π_θ/π_ref)=+1.099  éq.(4)=0.432
Le log-rapport peut être positif ou négatif, si bien que l'estimation pour un token isolé peut être négative ; l'équation (4) vaut 0 quand les deux distributions sont identiques et reste positive dans tous les autres cas, d'autant plus grande que l'écart est important.
GRPO itératif : au fil de l'entraînement, l'ancien modèle de récompense risque de ne plus suivre le modèle de politique. Les auteurs produisent de nouvelles données d'entraînement pour le modèle de récompense à partir des nouveaux échantillons du modèle de politique, y ajoutent 10 % des anciennes données pour poursuivre l'entraînement du modèle de récompense, puis remplacent le modèle de référence par le modèle de politique actuel et continuent l'entraînement.
Configuration d'entraînement
- Données : uniquement les quelque 144 000 problèmes des données SFT qui concernent GSM8K et MATH, au format chaîne de pensée. Les autres problèmes sont volontairement écartés, pour observer l'effet de l'apprentissage par renforcement sur des benchmarks non vus à l'entraînement.
- Modèle de récompense : données d'entraînement construites à la manière de Math-Shepherd, entraînement à partir de DeepSeekMath-Base 7B, taux d'apprentissage de .
- Modèle de politique : taux d'apprentissage de , coefficient KL de 0.04, 64 réponses échantillonnées par problème, 1 024 tokens au maximum, taille de batch de 1 024 ; une seule mise à jour après chaque échantillonnage.
Discussion
Résultats
| Modèle | GSM8K | MATH | MGSM-zh | CMATH |
|---|---|---|---|---|
| Gemini Ultra | 94.4 | 53.2 | - | - |
| GPT-4 | 92.0 | 52.9 | - | 86.0 |
| DeepSeek-LLM-Chat 67B | 84.1 | 32.6 | 74.0 | 80.3 |
| Instruct 7B | 82.9 | 46.8 | 73.2 | 84.6 |
| RL 7B | 88.2 | 51.7 | 79.6 | 88.8 |
D'après la Table 5 de l'article, partie chaîne de pensée sans outil ; sélection de lignes ; Instruct 7B et RL 7B sont les deux modèles 7B de DeepSeekMath ; en %.
GRPO fait passer GSM8K de 82.9 % à 88.2 % et MATH de 46.8 % à 51.7 %, au-dessus de tous les modèles open source de 7B à 70B et de la plupart des modèles fermés, mais encore légèrement en dessous de GPT-4 et de Gemini Ultra.
L'apprentissage par renforcement n'a utilisé que les problèmes anglais de GSM8K et de MATH, mais MGSM-zh et CMATH, en chinois, progressent aussi. Avec outils, MATH passe de 57.4 % à 58.8 % ; là encore il y a progrès, alors que les données d'apprentissage par renforcement sont toutes au format chaîne de pensée.
Une vue unifiée
Les auteurs écrivent les différentes méthodes de fine-tuning sous une même forme. Leurs gradients ont tous cette allure :
Elles ne diffèrent que sur trois points : la source de données (d'où viennent les problèmes et les réponses), la fonction de récompense (d'où vient le signal) et le coefficient de gradient (à quel point encourager ou pénaliser chaque token).
- SFT : des données préparées par des humains ; le coefficient de chaque token vaut 1.
- Fine-tuning par échantillonnage de rejet (RFT) : le modèle SFT échantillonne lui-même, et l'on ne garde que les bonnes réponses ; le coefficient vaut 1 pour une bonne réponse et 0 pour une mauvaise. C'est le même filtrage que dans STaR.
- RFT en ligne : même règle, mais l'échantillonnage se fait à partir du modèle en cours d'entraînement.
- DPO : le modèle SFT échantillonne des paires de réponses, et l'entraînement utilise une perte par paires.
- PPO et GRPO : l'échantillonnage se fait à partir du modèle en cours d'entraînement, et le coefficient, fixé par la récompense, peut être positif ou négatif, avec une amplitude variable.
En comparant ces méthodes sur le modèle Instruct de 1.3B, les auteurs font plusieurs observations :
- L'échantillonnage en ligne fait mieux que hors ligne : au début, le RFT en ligne fait à peu près jeu égal avec le RFT, puis l'emporte nettement en fin d'entraînement ; à mesure que le modèle s'éloigne du modèle SFT, seules les données qu'il échantillonne lui-même restent à sa hauteur.
- Pénaliser les erreurs vaut mieux que seulement encourager les bonnes réponses : GRPO l'emporte sur le RFT en ligne. Le RFT en ligne ne pénalise pas les mauvaises réponses et traite toutes les bonnes réponses de la même façon ; GRPO module la force de l'encouragement et de la pénalité selon l'ampleur de la récompense.
- La supervision du processus fait mieux que la supervision du résultat : GRPO avec supervision du processus l'emporte sur GRPO avec supervision du résultat.
- L'itération est utile : ce point-là est étudié sur le modèle Instruct de 7B ; l'apprentissage par renforcement itératif améliore nettement les performances, surtout au premier tour.
Qu'a vraiment changé l'apprentissage par renforcement ?
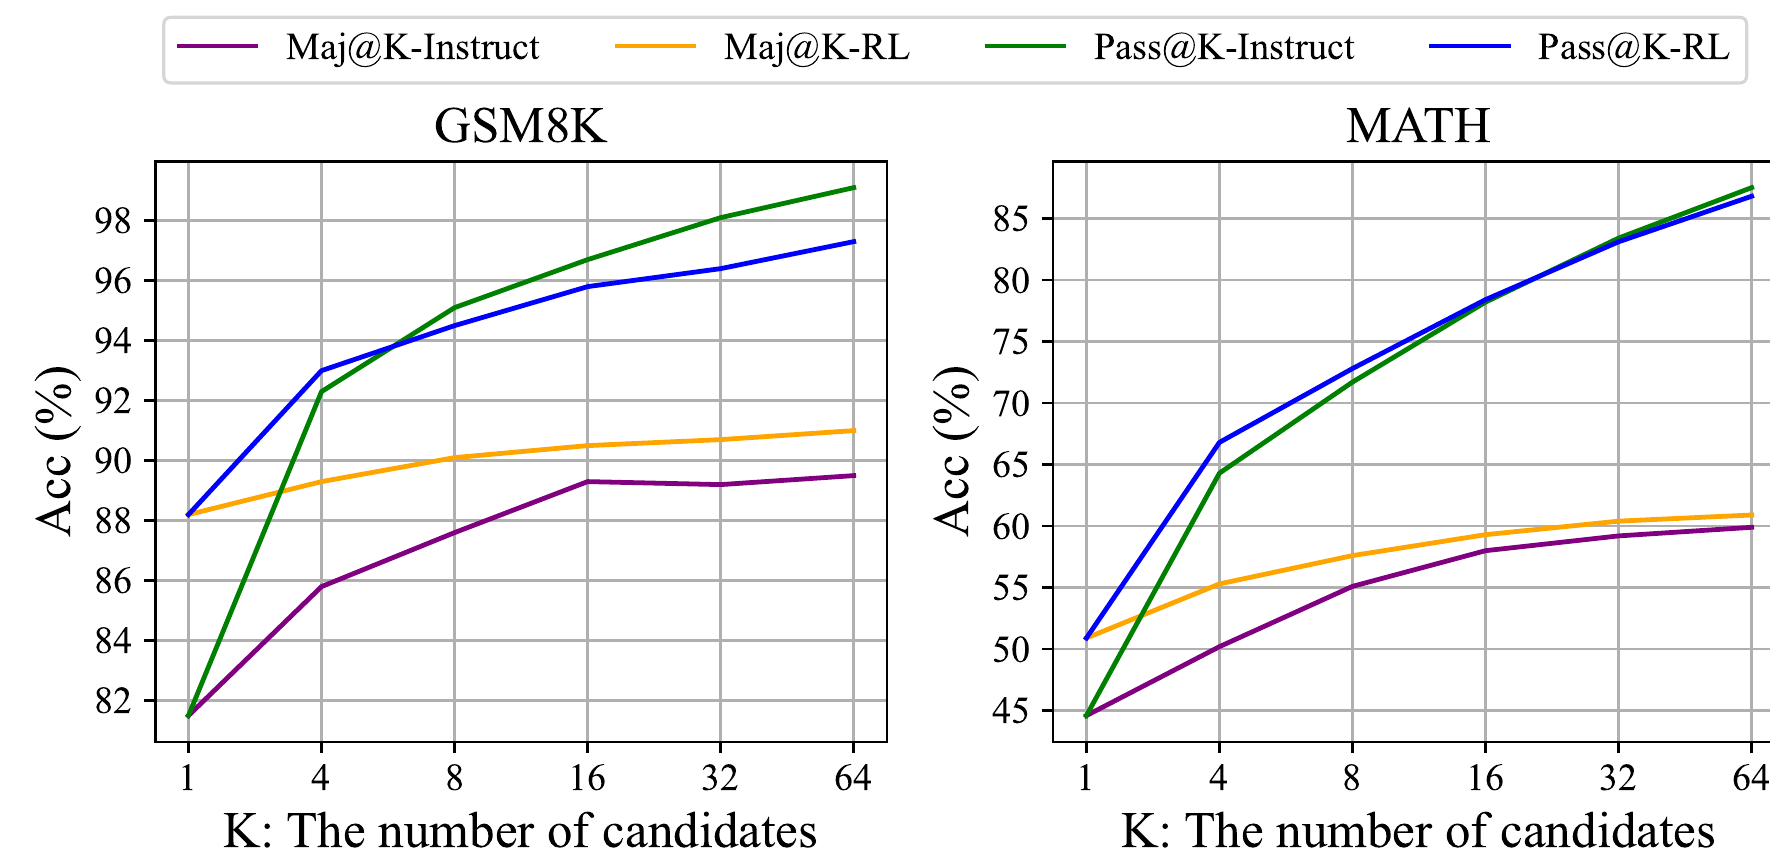
C'est la figure de l'article qui mérite le plus qu'on s'y attarde. Maj@K indique si la réponse retenue par un vote sur échantillons est juste ; Pass@K compte un succès dès qu'une réponse sur est juste.
L'apprentissage par renforcement améliore Maj@K, mais pas Pass@K. Avec assez d'échantillons, le modèle Instruct d'origine résout autant de problèmes. Pour les auteurs, l'apprentissage par renforcement rend la distribution de sortie plus robuste et fait remonter en tête des bonnes réponses qui figuraient déjà parmi les premières ; il n'apprend pas au modèle à résoudre des problèmes qu'il ne savait pas résoudre du tout.
Les auteurs notent aussi, en conclusion, qu'ils n'ont utilisé que les problèmes de la phase SFT et le plus simple des échantillonnages, le nucleus sampling, ce qui explique peut-être que seul Maj@K progresse. Ils comptent essayer des problèmes hors distribution et des stratégies d'échantillonnage plus avancées, comme la recherche arborescente.
Limites
- Géométrie et démonstrations plus faibles : le modèle ne sait pas traiter les problèmes portant sur les triangles ou les ellipses, ce qui, selon les auteurs, tient peut-être à un biais dans le choix des données de préentraînement et de fine-tuning.
- Few-shot moins bon que GPT-4 : GPT-4 progresse quand on lui donne des exemples, alors que DeepSeekMath fait à peu près pareil avec ou sans exemples ; les auteurs l'attribuent à la taille du modèle.
- Signal de récompense peu fiable : les méthodes existantes font entièrement confiance au signal du modèle de récompense, or même PRM800K, annoté soigneusement à la main, contient environ 20 % d'étiquettes erronées. Les auteurs estiment qu'il faut des algorithmes d'apprentissage par renforcement capables de résister à des récompenses bruitées.
La suite
Moins d'un an plus tard, DeepSeek-R1 reprend GRPO, mais remplace la récompense par des règles simples, qui vérifient si la réponse est juste et si le format est correct. Sans modèle de récompense neuronal, plus de modèle de récompense dont on pourrait exploiter les failles. DeepSeek-R1-Zero saute même le fine-tuning supervisé et lance l'apprentissage par renforcement directement depuis le modèle de base. GRPO est ensuite devenu l'un des algorithmes d'apprentissage par renforcement les plus utilisés pour les modèles de raisonnement open source.
GRPO lui-même a aussi été examiné de près. En mars 2025, Dr. GRPO montre que la fonction objectif de GRPO comporte un biais d'optimisation qui allonge artificiellement les réponses pendant l'entraînement, surtout les mauvaises, et propose une version corrigée, sans biais.
L'observation de la Figure 7 a elle aussi été passée à la loupe un an plus tard. En avril 2025, dans Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?, Yue et al. comparent les modèles avant et après apprentissage par renforcement avec des plus grands. Pour un petit , le modèle passé par l'apprentissage par renforcement fait mieux ; pour un grand , c'est au contraire le modèle de base qui obtient le meilleur pass@k. Leur conclusion est que les capacités de raisonnement obtenues par ce type d'apprentissage par renforcement viennent du modèle de base et restent bornées par lui. C'est exactement ce que disait la figure tracée par cet article lui-même en 2024.
Conclusion
Avec 7 milliards de paramètres, DeepSeekMath obtient 51.7 % sur MATH sans outil ni vote, près du GPT-4 de l'époque. Le mérite revient pour moitié aux 120 milliards de tokens de pages mathématiques extraits de Common Crawl par itérations successives, et pour moitié à GRPO, qui supprime le modèle de valeur et compare entre elles les réponses d'un même groupe, pour un même problème.
La partie analytique de l'article est souvent négligée, alors qu'elle pèse lourd. Apprendre le code d'abord, arXiv qui ne sert pas à grand-chose, l'échantillonnage en ligne qui bat le hors-ligne, la pénalisation des erreurs plus efficace que la seule récompense des réussites, ce sont autant de leçons que d'autres ont reprises maintes fois par la suite.
Le plus honnête, c'est la Figure 7. Les auteurs y montrent eux-mêmes que l'apprentissage par renforcement n'améliore que la précision du vote, et pas la proportion de problèmes « résolus au moins une fois », et écrivent franchement que le progrès vient peut-être de ce que les bonnes réponses sont remontées en tête, plutôt que d'un gain de capacité. Un an plus tard, tout le domaine a dépensé beaucoup d'efforts pour le confirmer une nouvelle fois.