Article original
Self-Instruct: Aligning Language Models with Self-Generated Instructions
- Publication
- ACL 2023Conférence
- Premier dépôt sur arXiv
- arXiv:2212.10560
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{modeltuningselfinstruct2022,
  title = {{Self-Instruct: Aligning Language Models with Self-Generated Instructions}},
  author = {Yizhong Wang and Yeganeh Kordi and Swaroop Mishra and Alisa Liu and Noah A. Smith and Daniel Khashabi and Hannaneh Hajishirzi},
  year = {2022},
  eprint = {2212.10560},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2212.10560}
}
L'instruction tuning a besoin de données d'instructions, et à l'époque, ces données étaient presque toutes écrites par des humains.
Dans le monde académique, on réécrivait des jeux de données de NLP existants sous forme d'instructions, comme FLAN ou T0, ou bien des chercheurs rédigeaient ensemble plus de 1 600 tâches, comme dans Super-NaturalInstructions (SuperNI dans la suite). Côté industrie, InstructGPT s'appuyait sur un grand nombre de prompts de vrais utilisateurs, pour lesquels des annotateurs rédigeaient des démonstrations ; aucune de ces données n'a été publiée.
La première approche pose deux problèmes. Les tâches qu'on arrive à écrire sont surtout celles que les chercheurs connaissent bien (classification, questions-réponses, résumé), assez loin de ce que les gens demandent vraiment à un modèle ; et inventer de nouvelles tâches puis rédiger de bonnes réponses demande à la fois de la créativité et de l'expertise, ce qui se fait difficilement à grande échelle.
En décembre 2022, Wang et ses collègues de l'Université de Washington ont une idée qui a l'air un peu paresseuse. Puisque GPT-3 sait tout écrire, autant le laisser poser lui-même les questions, y répondre lui-même, puis se servir de ces données pour le fine-tuner lui-même.
Définir le problème
Précisons d'abord la forme des données d'instructions. Une tâche comporte une instruction et un ou plusieurs couples entrée-sortie ; le modèle doit réaliser .
La frontière entre instruction et entrée est souvent floue. « Écris un essai sur la sécurité à l'école » peut être pris tout entier comme instruction, sans entrée ; on peut aussi prendre « Écris un essai sur le sujet suivant » comme instruction et « la sécurité à l'école » comme entrée. Les auteurs autorisent les entrées vides, pour varier davantage le format des données.
Ce que l'article cherche à savoir, c'est si un modèle de langage qui n'a jamais subi d'instruction tuning, avec seulement une toute petite quantité d'amorces écrites à la main, peut produire des données d'instructions assez bonnes pour apprendre au modèle lui-même à suivre les instructions.
Résoudre le problème
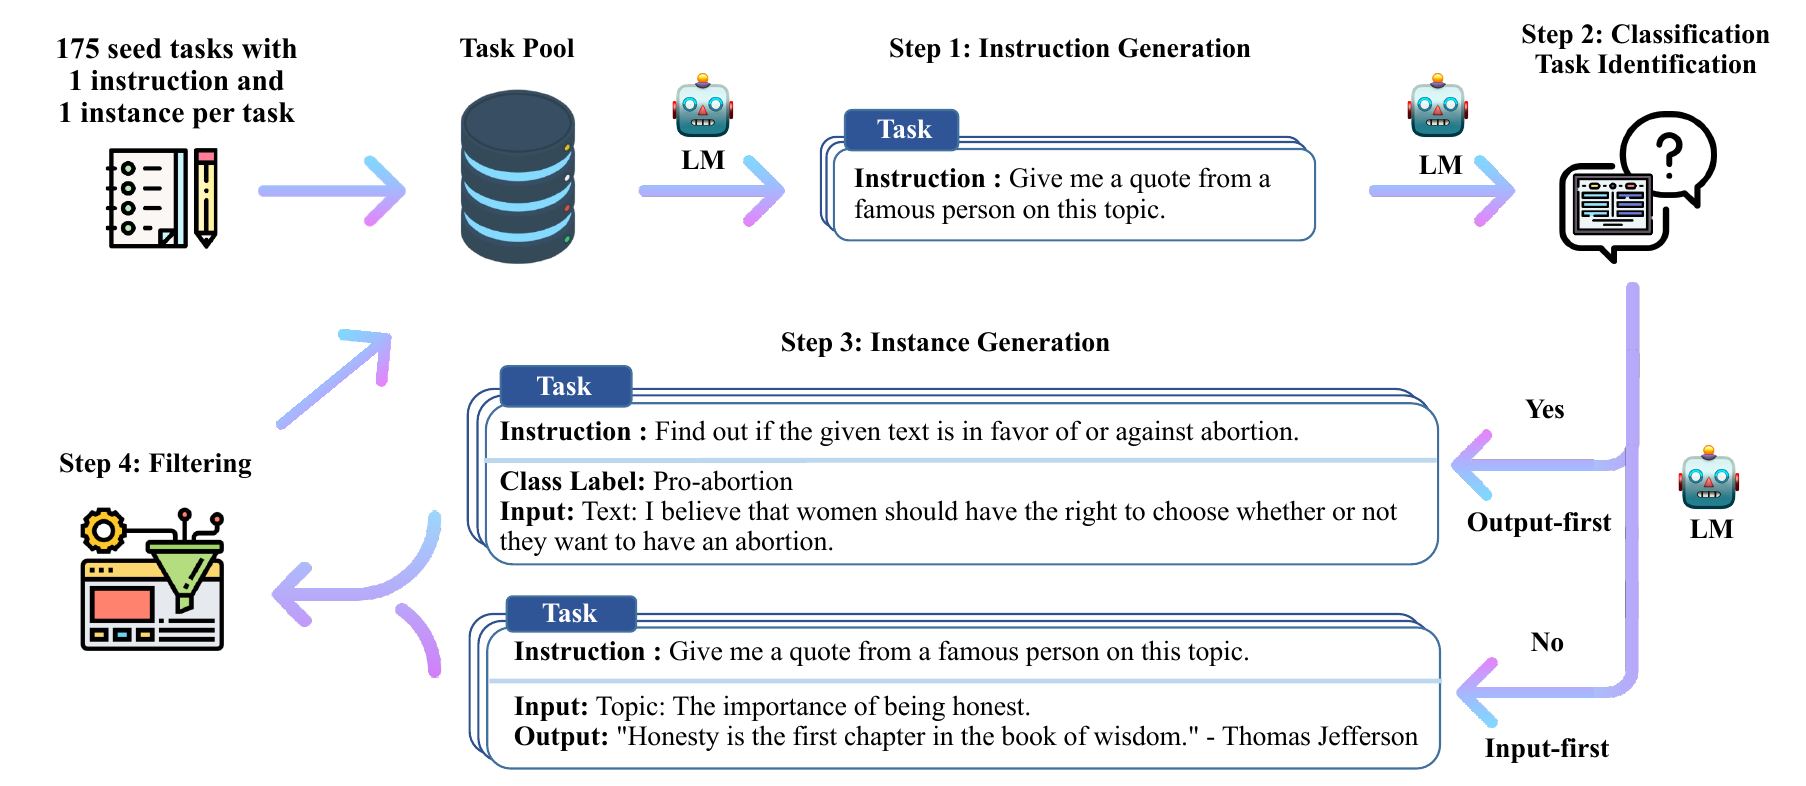
Le pipeline forme une boucle. Les auteurs et leurs collègues de laboratoire écrivent d'abord à la main 175 tâches amorces, chacune avec une instruction et un couple entrée-sortie, et les placent dans le pool de tâches ; les quatre étapes suivantes sont toutes confiées à GPT-3 (davinci, le plus grand modèle de l'API OpenAI), et les nouvelles tâches qui passent le filtrage retournent dans le pool, où elles servent à produire le lot suivant.
Étape 1 : inventer de nouvelles questions
À chaque fois, on tire du pool 8 instructions qui servent d'exemples, dont 6 viennent des amorces humaines et 2 de tâches générées auparavant par le modèle, et l'on demande au modèle d'écrire à la suite de nouvelles instructions. Mêler les productions du modèle sert à rendre les questions de plus en plus variées au fil des tours ; garder une majorité d'amorces humaines empêche la qualité de dériver.
Étape 2 : est-ce une question de classification ?
Il faut ensuite produire une entrée et une sortie pour chaque instruction, et les questions de classification ne se traitent pas comme les autres ; il faut donc d'abord les distinguer. Les auteurs utilisent un prompt few-shot qui montre au modèle 12 instructions de classification et 19 instructions d'un autre type, et lui font dire à quelle catégorie appartient la nouvelle instruction. Par question de classification, on entend ici une tâche dont la sortie se limite à un petit nombre d'étiquettes.
Étape 3 : produire les exemples
Les questions ordinaires suivent l'approche entrée d'abord ; on écrit d'abord une entrée d'après l'instruction, puis la sortie. C'est le même ordre que lorsqu'on utilise un modèle au quotidien.
Appliquée aux questions de classification, cette approche pose problème. Pour la détection d'erreurs grammaticales, par exemple, les entrées écrites par le modèle sont presque toutes des phrases grammaticalement correctes, et les étiquettes penchent lourdement d'un côté. Les questions de classification passent donc à l'approche sortie d'abord ; on commence par lister les étiquettes possibles, puis on écrit une entrée correspondant à chaque étiquette. Pour la question « Détermine si ce texte est pour ou contre le droit à l'avortement », par exemple, le modèle fixe d'abord l'étiquette « Pro-abortion », puis génère un texte favorable au droit à l'avortement.
Étape 4 : filtrer
Le modèle a tendance à se répéter ; chaque nouvelle instruction est donc comparée par ROUGE-L à toutes les instructions du pool, et n'est retenue que si toutes les similarités sont inférieures à 0.7. ROUGE-L repose sur la plus longue sous-séquence commune de deux phrases. Prenons « Give me a quote from a famous person on this topic. », tirée de la figure du pipeline : la candidate « Give me a famous quote on this topic. » ne fait que la reformuler, et elle est écartée. « Find out if the given review is positive or negative. » reprend la tournure de l'autre instruction de la figure, « Find out if the given text is in favor of or against abortion. », mais la tâche passe de la détection d'une prise de position à la polarité d'un avis, et elle est retenue.
D'autres règles de filtrage s'y ajoutent. On écarte les instructions qui contiennent des mots-clés comme image, picture ou graph, que les modèles de langage ne savent pas traiter ; on écarte aussi, pour une même instruction, les exemples strictement identiques, ou ceux qui ont la même entrée mais des sorties différentes ; enfin, quelques règles empiriques suppriment les générations trop longues, trop courtes, ou dont la sortie ne fait que répéter l'entrée.
Fine-tuning
Une fois les données prêtes, on s'en sert pour fine-tuner le GPT-3 même qui les a produites, via l'API de fine-tuning d'OpenAI, sans compter la partie prompt dans la perte, pendant 2 époques. Pour que le modèle ne soit pas tributaire d'un format, instruction et entrée sont assemblées selon différents gabarits ; on ajoute ou non « Task: » devant l'instruction, « Input: » devant l'entrée, on fait varier le nombre de lignes vides entre les deux, etc. Le modèle obtenu s'appelle GPT3Self-Inst.
Ce qui a été produit
On obtient au final 52 445 instructions et 82 439 exemples, dont 11 584 instructions de classification et 35 878 exemples sans entrée.
À quel point ces questions s'éloignent-elles des amorces ? Les auteurs calculent le ROUGE-L entre chaque nouvelle instruction et l'amorce la plus proche ; la plupart des valeurs tombent entre 0.2 et 0.45, avec un pic vers 0.3, et très peu dépassent 0.6, signe que la plupart sont des questions absentes des amorces. La distribution des verbes et de leurs compléments d'objet est elle aussi très dispersée ; les 20 verbes les plus fréquents, avec chacun ses 4 compléments les plus fréquents, ne couvrent que 14 % de l'ensemble des instructions.
La qualité, c'est une autre histoire. Les auteurs tirent au hasard 200 instructions, avec un exemple chacune, et les vérifient eux-mêmes une par une :
| Critère vérifié | Conforme |
|---|---|
| L'instruction décrit une tâche valide | 92 % |
| L'entrée convient à l'instruction | 79 % |
| La sortie est une réponse correcte et acceptable | 58 % |
| Les trois sont sans problème | 54 % |
D'après la Table 2 de l'article.
Près de la moitié des exemples contiennent des erreurs. Selon les auteurs, même quand le contenu est faux, le format est le plus souvent correct, ou au moins en partie, et cela reste utile pour apprendre au modèle « comment répondre à une instruction ».
Discussion
SuperNI : presque au niveau d'InstructGPT001
La première série d'expériences utilise les 119 tâches d'évaluation de SuperNI, avec 100 exemples chacune, en zero-shot, en ne donnant que la définition de la tâche, et mesure le ROUGE-L entre la sortie et la réponse de référence :
| Modèle | Paramètres | ROUGE-L |
|---|---|---|
| GPT-3 | 175B | 6.8 |
| T0 | 11B | 33.1 |
| GPT-3 + données d'entraînement de T0 | 175B | 37.9 |
| GPT3Self-Inst | 175B | 39.9 |
| InstructGPT001 | 175B | 40.8 |
| Tk-Instruct (entraîné sur SuperNI) | 11B | 46.0 |
| GPT-3 + données d'entraînement de SuperNI | 175B | 49.5 |
| GPT3Self-Inst + données d'entraînement de SuperNI | 175B | 51.6 |
D'après la Table 3 de l'article.
Le GPT-3 d'origine ne sait presque pas suivre d'instructions ; il écrit souvent du contenu hors sujet ou répétitif, et ne sait pas quand s'arrêter. Après fine-tuning sur ses propres données, son ROUGE-L gagne 33.1 points, à moins d'un point d'InstructGPT001, qui a été entraîné sur des données privées d'utilisateurs et des annotations humaines. La comparaison se limite à la version 001, car les versions plus récentes ont été entraînées sur les dernières données d'utilisateurs et ont très probablement vu le jeu de test de SuperNI.
Entraîner sur les données d'entraînement de SuperNI elles-mêmes donne évidemment de meilleurs résultats, puisque le style et le format des questions sont les mêmes. Mais en ajoutant les données de Self-Instruct à celles de SuperNI, on passe encore de 49.5 à 51.6, ce qui montre que les deux types de données se complètent.
Usages réels : 252 nouvelles questions
Les tâches de SuperNI sont surtout conçues pour la recherche, et penchent vers la classification. Les auteurs ont donc réfléchi ensemble à des domaines où un modèle de langage pourrait servir, comme la rédaction d'e-mails, les réseaux sociaux, les outils de productivité, le divertissement ou la programmation, et ont écrit des instructions pour chacun, soit 252 questions au total.
Ces questions sont difficiles à noter automatiquement, et pour celles qui portent sur la programmation ou la conversion de logique du premier ordre en langage naturel, un travailleur de crowdsourcing ordinaire ne peut pas juger non plus. Ce sont donc les auteurs qui ont écrit les questions qui notent eux-mêmes les réponses, sur quatre niveaux. A : correcte et satisfaisante ; B : acceptable, avec de petits défauts ; C : répond à l'instruction, mais avec des erreurs nettes ; D : hors sujet ou invalide.
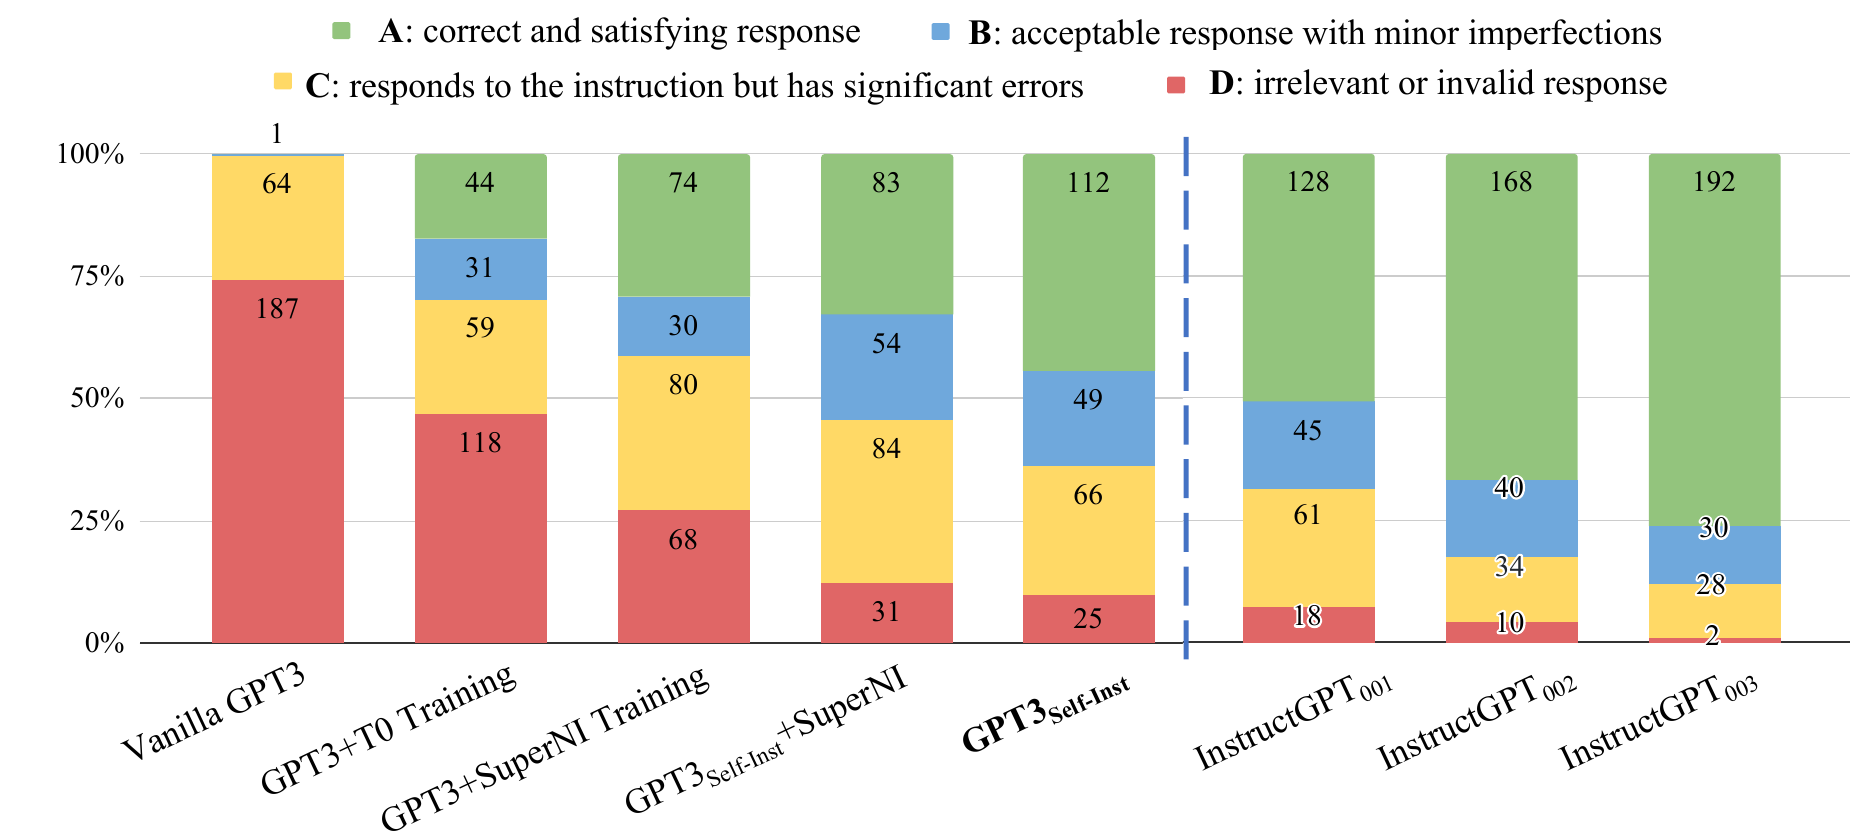
À gauche de la ligne pointillée, GPT-3 et ses différentes versions fine-tunées ; à droite, les trois générations d'InstructGPT d'OpenAI. Tous les modèles répondent aux mêmes 252 questions : 44.4 % des réponses de GPT3Self-Inst sont notées A, contre 50.8 % pour InstructGPT001.
Si l'on compte aussi B comme utilisable, GPT3Self-Inst atteint 63.9 % et InstructGPT001 68.7 %, soit moins de 5 points de pourcentage d'écart ; c'est le « seulement 5 % d'écart » annoncé dans le résumé de l'article. Il fait aussi nettement mieux que GPT-3 fine-tuné sur les données de T0 ou de SuperNI. InstructGPT002 et 003 jouent en revanche dans une autre catégorie ; plus des trois quarts des réponses de 003 sont notées A.
Plus de données, c'est mieux ; la qualité compte davantage
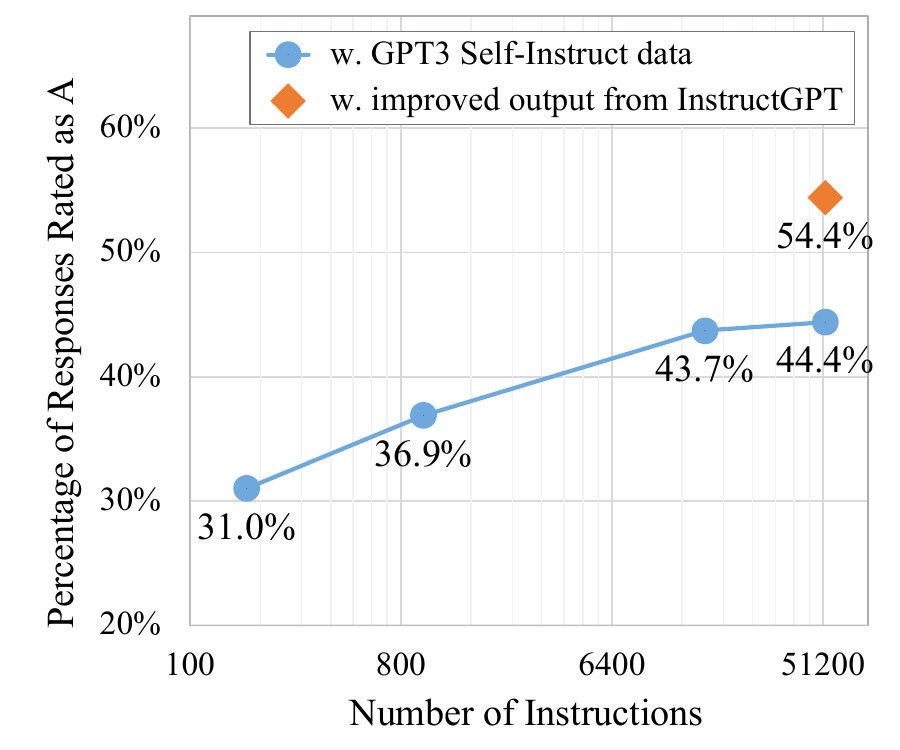
La ligne bleue correspond au fine-tuning sur différents nombres d'instructions Self-Instruct ; la proportion de A passe de 31.0 % à 44.4 %, mais ne bouge presque plus au-delà d'environ 16 000 instructions. Sur SuperNI, la saturation arrive encore plus tôt, et quelques centaines d'instructions suffisent pour atteindre le plafond ; les auteurs supposent que c'est parce que ces données sont très différentes des tâches de NLP typiques.
Le point orange est plus intéressant. Les auteurs gardent toutes les instructions et toutes les entrées, font seulement réécrire les sorties par InstructGPT003, puis fine-tunent GPT-3 dessus ; la proportion de A bondit à 54.4 %, soit 10 points de plus. Autrement dit, on distille les capacités d'InstructGPT003 sur ces questions.
Le coût de l'expérience figure lui aussi en annexe. À l'époque, davinci coûtait 0.02 dollar pour 1 000 tokens ; produire l'ensemble des données a coûté environ 600 dollars, et fine-tuner GPT-3 sur toutes les données, 338 dollars.
Limites
Les auteurs en citent eux-mêmes trois :
- La longue traîne : le modèle excelle sur ce qui est fréquent dans les données de préentraînement ; les gains de Self-Instruct risquent eux aussi de se concentrer sur les tâches courantes, et la méthode peut échouer face à des instructions rares ou très créatives.
- La dépendance aux grands modèles : la méthode repose sur les biais inductifs du modèle de langage lui-même ; elle ne fonctionne peut-être qu'avec de grands modèles, hors de portée de ceux qui manquent de ressources de calcul.
- L'amplification des biais : à force d'auto-génération, on risque d'amplifier de plus en plus les biais sociaux ; la difficulté à équilibrer les étiquettes des questions de classification reflète aussi les préférences initiales du modèle.
Un point mérite d'être ajouté. Self-Instruct n'apporte aucune connaissance nouvelle au modèle ; questions et réponses viennent toutes de GPT-3 lui-même. Ce qu'il enseigne, c'est « comment répondre quand on voit une instruction ». Le simple fait de faire réécrire les sorties par InstructGPT003 fait passer la proportion de A de 44.4 % à 54.4 %, ce qui va dans le même sens.
La suite
Trois mois plus tard, Alpaca, de Stanford, transpose ce pipeline sur LLaMA. Partant des mêmes 175 amorces, l'équipe utilise text-davinci-003 pour produire 52 000 démonstrations d'instructions ; la génération des données coûte moins de 500 dollars, et le fine-tuning de LLaMA-7B moins de 100 dollars. La présentation d'Alpaca précise aussi clairement que le modèle est réservé à la recherche académique, d'une part parce que LLaMA est sous licence non commerciale, d'autre part parce que les conditions d'utilisation d'OpenAI interdisent de se servir de ses sorties pour développer des modèles qui concurrencent OpenAI.
Par la suite, produire des données d'instructions avec un modèle fort est devenu une pratique courante, de plus en plus raffinée. En 2024, Tülu 3 prépare d'abord un grand nombre de « personas », puis demande à GPT-4o de se mettre dans leur peau pour poser des questions, afin de les rendre plus variées, dans la droite ligne de l'idée de Self-Instruct de mêler les productions du modèle.
Conclusion
Avec seulement 175 tâches amorces écrites à la main, Self-Instruct fait produire à GPT-3 plus de 50 000 instructions ; après fine-tuning, le modèle rejoint le niveau d'InstructGPT001 sur SuperNI, et reste à moins de 5 points de pourcentage de lui sur les 252 questions d'usage réel. La génération des données a coûté environ 600 dollars, et le fine-tuning de GPT-3 sur l'ensemble des données 338 dollars.
Pour qui veut fabriquer ses propres données d'instructions, les quatre étapes de l'article restent très pratiques aujourd'hui : mêler un peu de productions du modèle pour la diversité, fixer d'abord l'étiquette puis écrire l'entrée pour les questions de classification, éliminer les doublons par similarité, puis nettoyer les déchets évidents avec des règles. Ce qui demande le plus d'attention, c'est la qualité ; sur 200 instructions vérifiées par les auteurs, l'instruction, l'entrée et la sortie ne sont toutes les trois sans problème que dans 54 % des cas. C'est utilisable, mais il ne faut pas trop s'y fier.
Ceux qui ont repris la méthode n'ont pour la plupart gardé que ce pipeline de génération de questions, en remplaçant « soi-même » par un professeur plus fort. Alpaca a confié questions et réponses à text-davinci-003, Tülu 3 a demandé à GPT-4o d'incarner toutes sortes de personnages pour poser les questions ; dans l'article, le simple fait de faire réécrire les sorties par InstructGPT003 ajoutait déjà 10 points de pourcentage à la proportion de A, ce qui annonçait cette étape.