Article original
From Intuition to Investigation: A Tool-Augmented Reasoning MLLM Framework for Generalizable Face Anti-Spoofing
- Publication
- CVPR 2026Conférence
- Premier dépôt sur arXiv
- arXiv:2603.01038
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{faceantispoofingtarfas2026,
  title = {{From Intuition to Investigation: A Tool-Augmented Reasoning MLLM Framework for Generalizable Face Anti-Spoofing}},
  author = {Haoyuan Zhang and Keyao Wang and Guosheng Zhang and Haixiao Yue and Zhiwen Tan and Siran Peng and Tianshuo Zhang and Xiao Tan and Kunbin Chen and Wei He and Jingdong Wang and Ajian Liu and Xiangyu Zhu and Zhen Lei},
  year = {2026},
  eprint = {2603.01038},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2603.01038}
}
En 2012, quand l'Idiap publie le jeu de données Replay-Attack, la méthode de référence est LBP. Chaque pixel compare sa luminosité à celle de ses huit voisins ; un voisin au moins aussi clair que le centre donne 1, un voisin plus sombre donne 0, ce qui forme un code de 8 bits, et les codes de tout le visage sont ensuite rassemblés dans un histogramme. Les fibres du papier, la grille de pixels d'un écran n'ont pas la même texture que la peau, et l'histogramme change avec elles.
Plus de dix ans plus tard, la détection des attaques faciales est passée aux grands modèles de langage multimodaux. I-FAS fait répondre le modèle à la question « est-ce une vraie personne ? », d'abord par Yes ou No, puis par une phrase d'explication. Seulement, cette phrase ressemble souvent à ceci :
This is a picture of a man wearing glasses.
Tout est exact, mais cela n'a pas grand-chose à voir avec le vrai ou le faux.
L'équipe de Zhen Lei, à l'Institut d'automatique de l'Académie chinoise des sciences, rejointe par l'équipe d'origine d'I-FAS chez Baidu, ressort cette fois LBP. LBP n'est pas réinjecté dans le réseau comme caractéristique ; il devient un outil, et c'est le grand modèle de langage qui décide lui-même quand l'appeler pour regarder.
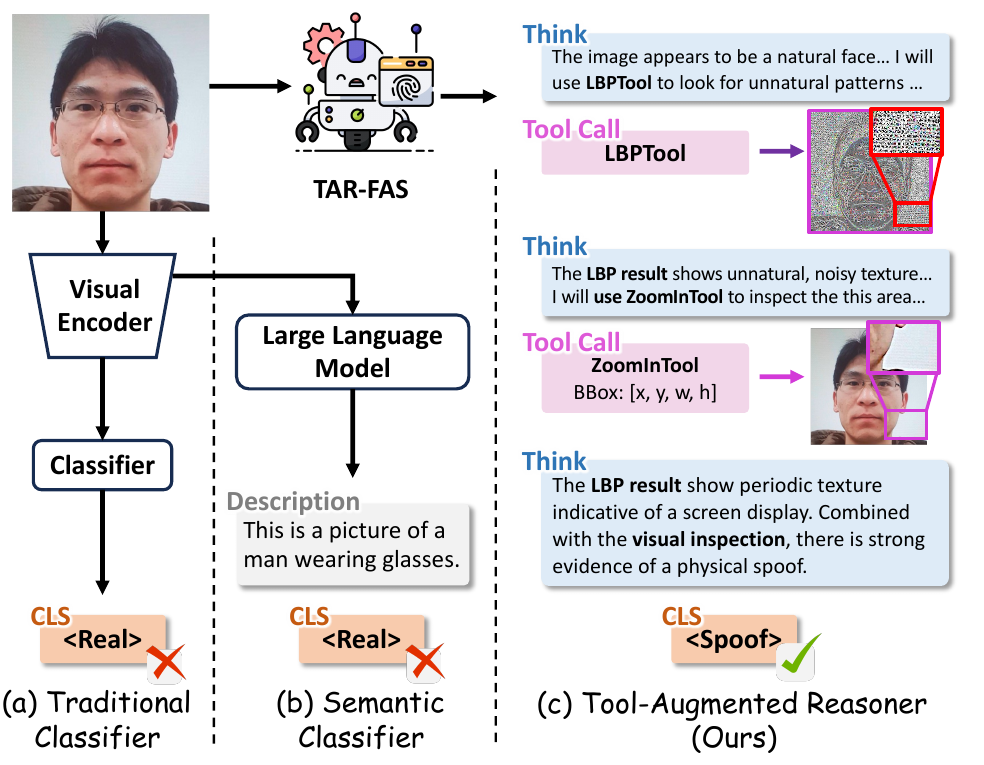
La colonne du milieu correspond au format de sortie d'I-FAS. À droite, avec la méthode de cet article, le modèle jette d'abord un coup d'œil et trouve que cela ressemble à une vraie personne, puis il appelle l'outil LBP, repère sur l'image de sortie une zone de texture peu naturelle, agrandit cette zone, et change finalement sa réponse en attaque.
Définir le problème
I-FAS a reformulé la FAS en question-réponse sur image, avec des résultats inter-jeux de données nettement meilleurs que ceux des méthodes de la famille CLIP. Pour les auteurs, son plafond tient à cette phrase de description. S'appuyant sur des travaux antérieurs, ils rappellent que les grands modèles de langage multimodaux ont d'emblée certains angles morts sur les caractéristiques visuelles de bas niveau ; comme l'objectif d'entraînement ne leur demande en plus qu'une courte phrase d'explication, le modèle apprend surtout des indices sémantiques visibles, du type « porte un masque » ou « tient un écran ». Le moiré laissé quand on photographie un écran, la trame d'une imprimante, les reflets subtils du matériau d'un masque tiennent difficilement en une phrase, et ne sont donc pas appris.
Un tableau de l'annexe de FaceCoT le montre encore plus clairement. Un modèle généraliste qui juge en zero-shot les images d'attaque de Rose-Youtu reconnaît la plupart des masques, mais ne détecte pas une seule image d'attaque papier ou de relecture sur écran.
Comment amener alors un grand modèle de langage à regarder ces traces au niveau du pixel ?
La FAS traditionnelle traite ce problème depuis toujours ; LBP, HOG et FFT étaient alors des outils courants. De l'autre côté, les modèles multimodaux récents savent déjà appeler des outils externes en cours de raisonnement ; DeepEyes, par exemple, laisse le modèle décider quelle partie de l'image agrandir. Les auteurs relient les deux et font appeler par le modèle, pendant son raisonnement, ces opérateurs d'image éprouvés.
Résoudre le problème
La boîte à outils
Les auteurs ont préparé six outils, répartis en quatre catégories :
- ZoomIn : on donne un cadre, et la zone correspondante est découpée puis agrandie.
- Texture : LBP, pour voir si la texture de la peau est naturelle ; le papier et les matériaux de masque s'y trahissent souvent.
- Fréquence : FFT et transformée en ondelettes, pour repérer une distribution fréquentielle anormale ; les écrans et les imprimés portent souvent un signal périodique.
- Structure : HOG et détection de contours Laplacian, pour examiner bords et gradients ; le bord d'un masque ou le cadre d'un écran y ressortent.
Chaque outil produit une image, qui est renvoyée au modèle. Quand le modèle « regarde le résultat d'un outil », il regarde donc en réalité une carte de codes LBP, un spectre ou une carte de contours.
Pourquoi un spectre FFT trahit-il un écran ? Le schéma ci-dessous fait passer deux images de 64×64 dans le domaine fréquentiel. En haut, une variation de luminosité douce tient lieu de visage pris en direct ; en bas, le même visage reçoit des rayures verticales répétées tous les 8 pixels, qui imitent les motifs périodiques apparaissant quand on photographie à travers un écran.
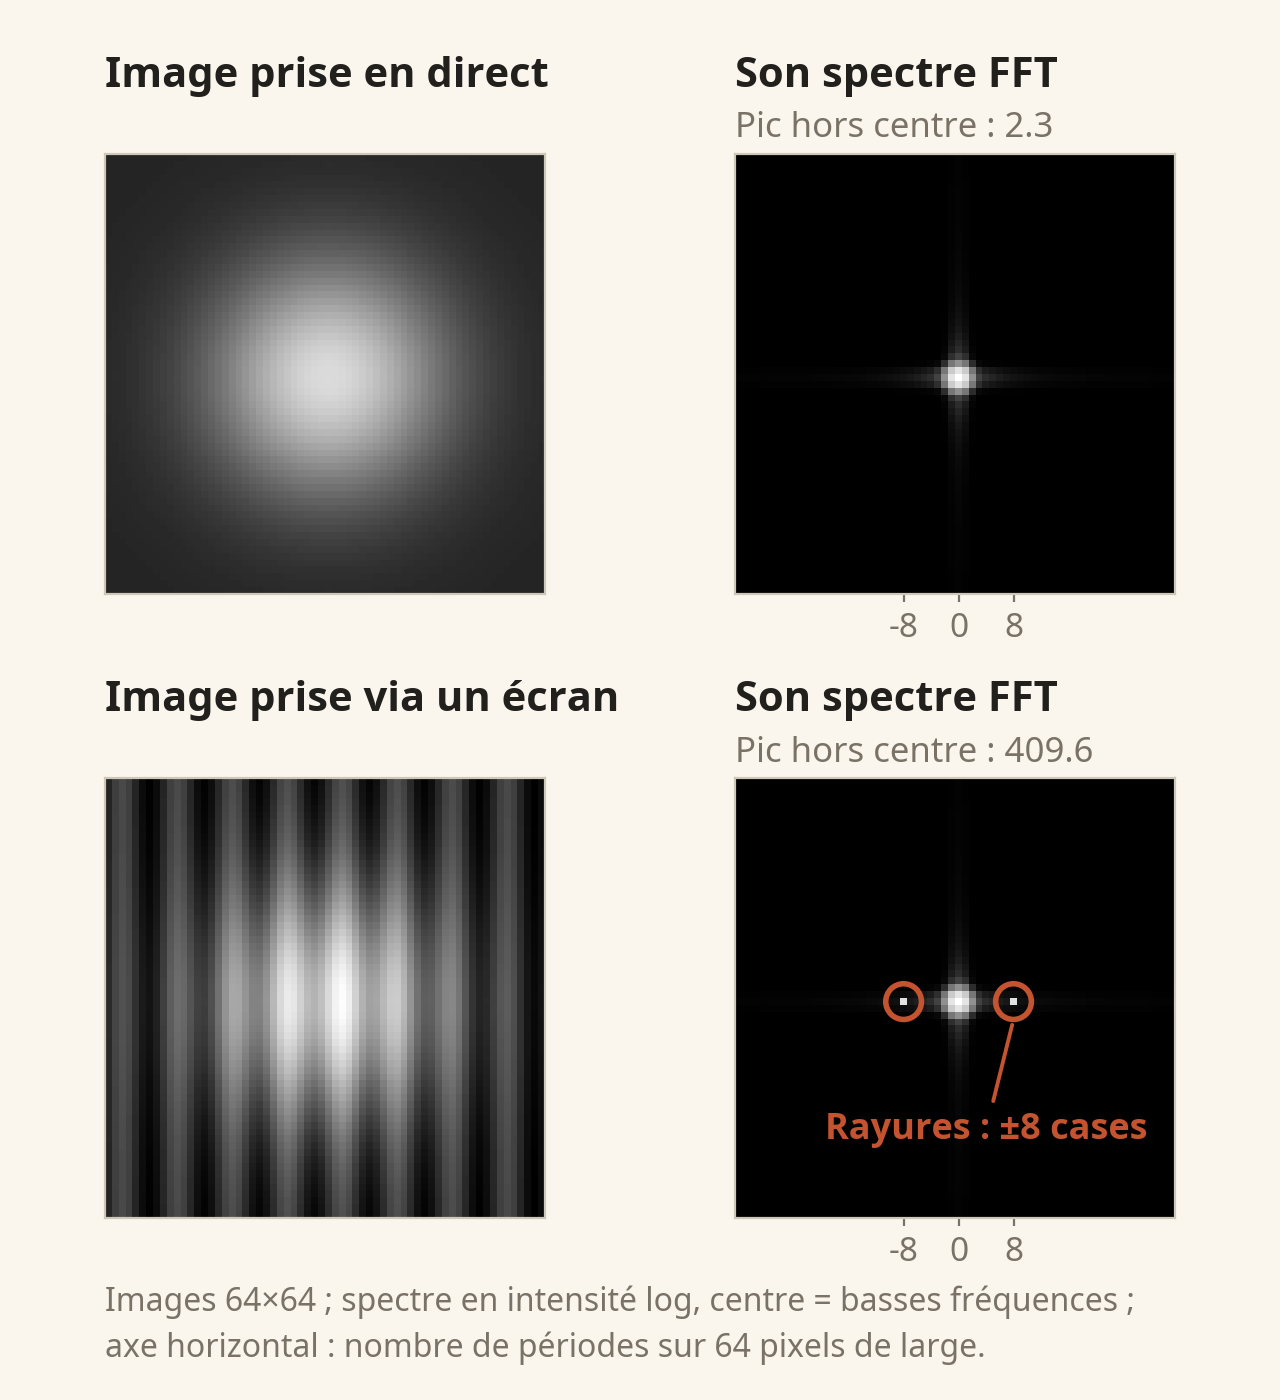
Le spectre en haut à droite n'a qu'une tache au centre, qui correspond à l'énergie basse fréquence de la variation douce de luminosité ; il s'assombrit à mesure qu'on s'éloigne du centre. En bas à droite apparaissent deux petits points, exactement à −8 et +8 sur l'axe horizontal. Sur 64 pixels de large, avec une période de 8 pixels, on a exactement 8 périodes ; les points sont donc à 8 cases du centre, un de chaque côté, symétriques, avec une intensité plus de cent fois supérieure à celle du point le plus brillant hors du centre dans l'image prise en direct.
Dans l'image en bas à gauche, les rayures se mêlent à la luminosité du visage et se distinguent mal ; dans le spectre, elles se concentrent en deux points qui sautent aux yeux. Un vrai moiré a une direction et une période plus désordonnées, et ses points lumineux s'étalent dans le spectre, mais le principe est le même. L'outil FFT de TAR-FAS renvoie justement ce genre de spectre, et ce que le modèle doit apprendre, c'est à y chercher les points brillants éloignés du centre.
L'article ne précise pas les paramètres d'implémentation des outils ; ce schéma sert seulement à montrer à quoi ressemble ce que renvoie l'outil FFT.
ToolFAS-16K : d'abord la démonstration d'un professeur qui connaît la réponse
Au départ, le modèle ne sait pas se servir des outils ; il lui faut d'abord des démonstrations. Les auteurs sélectionnent dans CelebA-Spoof 16 172 images, dont près de la moitié de vraies personnes, le reste couvrant 10 types d'attaques, puis demandent à Gemini-2.5 Pro de rédiger, tour après tour, un raisonnement qui utilise les outils.
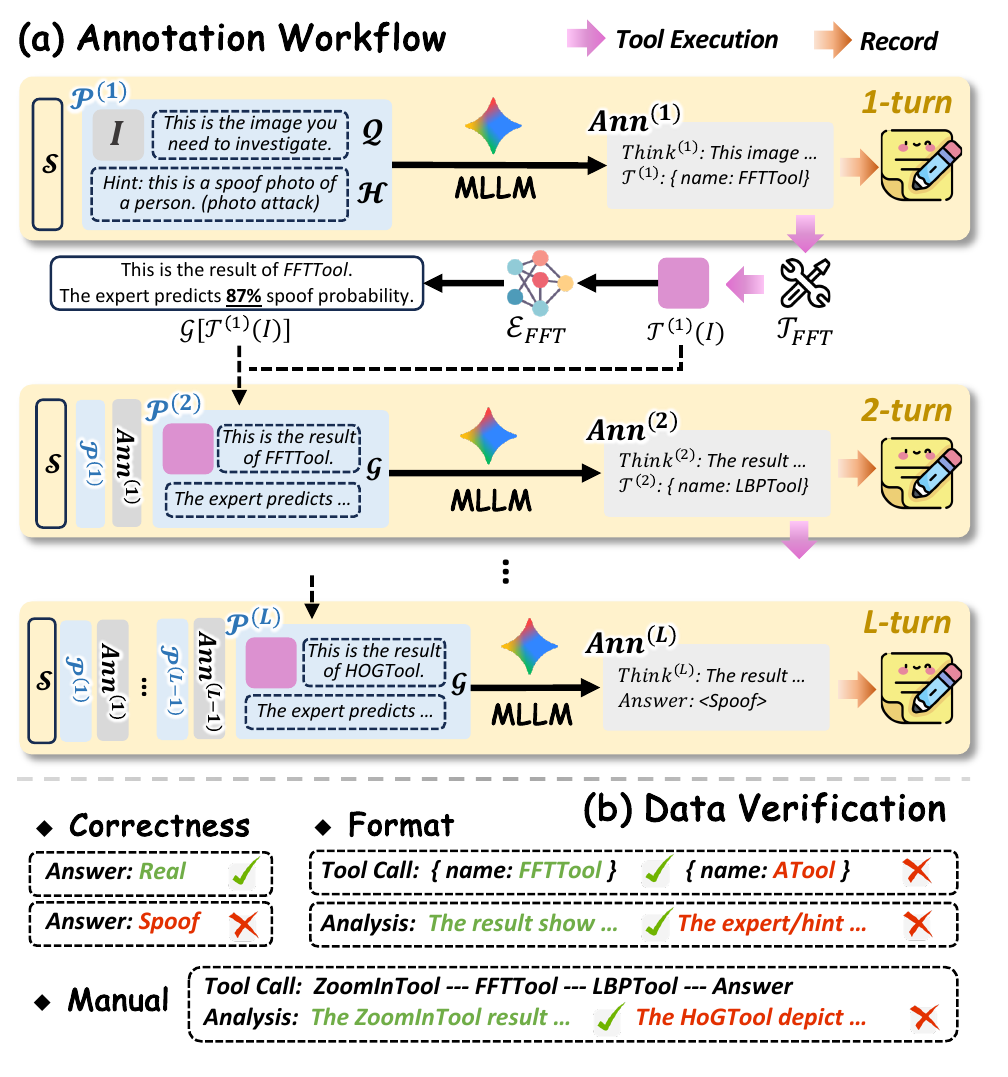
Commençons par le premier tour de la figure. En plus de l'image et de la phrase « voici l'image sur laquelle vous devez enquêter », Gemini reçoit un indice qui dit directement si l'image montre une vraie personne, ou de quel type d'attaque il s'agit. Le prompt système précise aussi que la classification finale doit concorder avec l'indice, et que le raisonnement ne doit pas mentionner l'indice.
Quand Gemini demande un outil, le résultat lui est renvoyé, mais passe d'abord par un « modèle expert ». Chaque outil (sauf ZoomIn) a son expert, un petit CNN de trois couches de convolution seulement, dont l'unique entrée est l'image produite par l'outil, sans accès à l'image d'origine, et qui sort la probabilité que cette image présente des traces d'attaque. Entraînés sur 4 000 identités de CelebA-Spoof et testés sur 1 000 autres, ces petits modèles atteignent environ 80 à 90 % d'exactitude au seuil de 0.5. Le prompt du tour suivant contient alors une phrase de plus, du type « voici le résultat de FFTTool ; l'expert prédit une probabilité de 87 % de traces d'attaque ».
Une annotation compte au plus 6 tours et s'arrête dès que Gemini donne sa réponse. Suivent trois contrôles. La réponse doit concorder avec l'étiquette ; les appels d'outils doivent respecter le format, et l'analyse ne doit mentionner ni l'indice ni la probabilité de l'expert ; enfin, un humain vérifie que l'analyse des outils et la conclusion s'enchaînent logiquement. Ce qui échoue est annoté une seconde fois, puis rejeté en cas de nouvel échec.
Ces données sont donc des corrigés rédigés pour l'élève par un professeur qui connaît la réponse d'avance et qu'un assistant renseigne sur les probabilités. L'indice et les probabilités de l'expert sont bloqués par les contrôles, et l'élève ne les voit pas. Ce que l'élève apprend ici, c'est « comment appeler un outil et comment rédiger un raisonnement » ; sa capacité à juger lui-même à partir des résultats des outils devra être travaillée par l'apprentissage par renforcement de l'étape suivante.
Un entraînement en trois étapes
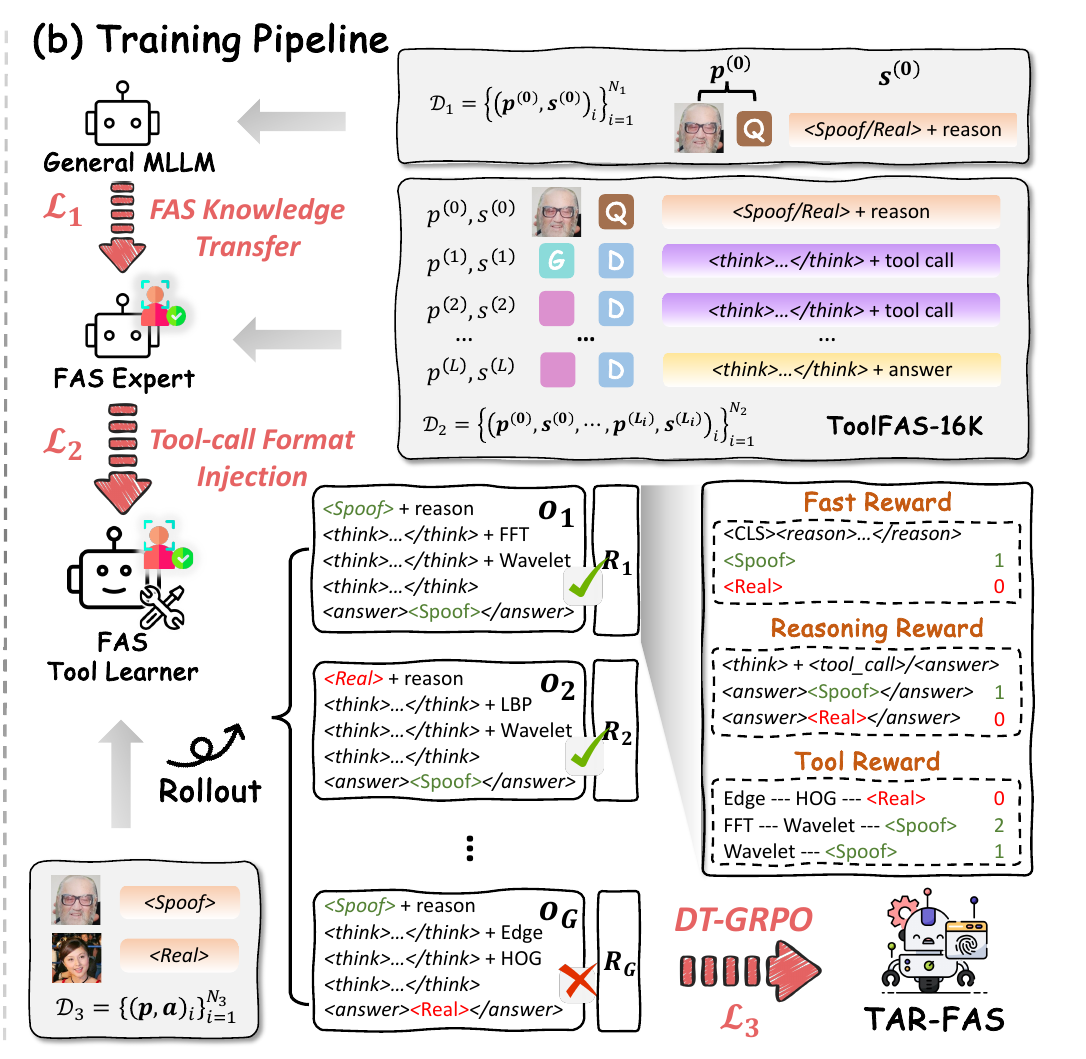
Le backbone est InternVL3-8B. La figure montre trois étapes, de haut en bas :
-
Transfert de connaissances FAS (KT) : fine-tuning supervisé sur des données au format I-FAS. La question est toujours « Is this photo of a real person? », et la réponse est
<Real>ou<Spoof>suivi d'une phrase de justification. Cette étape apprend d'abord au modèle généraliste ce que la tâche FAS lui demande. -
Injection du format d'appel d'outils (FI) : fine-tuning sur ToolFAS-16K. Le premier tour de chaque exemple est identique à celui de l'étape précédente, une réponse rapide ; viennent ensuite les tours de réflexion et d'appels d'outils. La fonction de perte est
Le premier tour représente 90 % du poids. Les données à plusieurs tours sont longues ; si chaque token pesait autant, le court passage de réponse rapide serait facilement dilué, et le modèle apprendrait à utiliser les outils en oubliant comment classer directement.
-
DT-GRPO : apprentissage par renforcement avec les seules images et étiquettes vrai/faux de CelebA-Spoof, sans plus aucune démonstration de raisonnement.
Les deux premières étapes utilisent LoRA (rang 16), avec au plus 4 000 pas ; la troisième libère tous les paramètres, avec un taux d'apprentissage de 1e-6, 8 réponses tirées par question, au plus 300 pas, et une pénalité KL fixée à 0.
Les récompenses de DT-GRPO
GRPO tire un groupe de réponses pour une même question et calcule un score pour chacune, puis retranche la moyenne du groupe et divise par l'écart-type du groupe pour obtenir l'avantage . Les réponses meilleures que la moyenne sont renforcées, les moins bonnes sont tirées vers le bas.
Ici, le score est une somme pondérée de trois termes :
- : la réponse rapide du premier tour. Un format erroné coûte 1 point ; sinon, une bonne réponse vaut 1 point et une mauvaise 0.
- : la réponse finale. Un format de raisonnement erroné ou un appel d'outil invalide coûte 1 point ; sinon, une bonne réponse vaut 1 point et une mauvaise 0.
- : chaque outil différent utilisé ajoute 0.2, et appeler deux fois le même outil ne compte qu'une fois ; si la réponse finale est fausse, ce terme tombe entièrement à zéro.
Faisons le calcul pour une image d'attaque et cinq réponses :
import numpy as np

beta_fast, beta_rsn, beta_tool, gamma = 0.1, 0.5, 0.4, 0.2

def reward(fast_ok, tools, final_ok, fmt_ok=True):
    r_fast = 1.0 if fast_ok else 0.0
    if not fmt_ok:                       # format de raisonnement erroné ou appel d'outil invalide
        return beta_fast * r_fast + beta_rsn * -1.0
    r_rsn = 1.0 if final_ok else 0.0
    r_tool = gamma * len(set(tools)) if final_ok else 0.0   # chaque outil ne compte qu'une fois ; zéro si réponse fausse
    return beta_fast * r_fast + beta_rsn * r_rsn + beta_tool * r_tool

# cinq réponses tirées pour la même image d'attaque (étiquette Spoof)
rollouts = [
    ("Réponse rapide Real ; après FFT et Wavelet, passe à Spoof", reward(False, ["FFT", "Wavelet"], True)),
    ("Réponse rapide Spoof ; conclut sans aucun outil", reward(True, [], True)),
    ("Réponse rapide Real ; après Edge et HOG, reste sur Real", reward(False, ["Edge", "HOG"], False)),
    ("Réponse rapide Spoof ; FFT deux fois, puis LBP", reward(True, ["FFT", "FFT", "LBP"], True)),
    ("Réponse rapide Spoof ; appel d'outil mal formaté", reward(True, [], False, fmt_ok=False)),
]
r = np.array([ri for _, ri in rollouts])
adv = (r - r.mean()) / r.std()           # GRPO : normalisation au sein du groupe
for (name, ri), ai in zip(rollouts, adv):
    print(f"R={ri:+.2f}  A={ai:+.2f}  {name}")
R=+0.66  A=+0.75  Réponse rapide Real ; après FFT et Wavelet, passe à Spoof
R=+0.60  A=+0.61  Réponse rapide Spoof ; conclut sans aucun outil
R=+0.00  A=-0.72  Réponse rapide Real ; après Edge et HOG, reste sur Real
R=+0.76  A=+0.97  Réponse rapide Spoof ; FFT deux fois, puis LBP
R=-0.40  A=-1.61  Réponse rapide Spoof ; appel d'outil mal formaté
Comparons les cinq réponses :
- L'essentiel, c'est d'avoir juste. Une bonne réponse finale vaut 0.5, alors que la récompense d'outils plafonne à (au plus trois appels d'outils, tous différents). Une réponse juste sans aucun outil garde un avantage positif.
- Les outils sont une question bonus. À réponse juste égale, chaque outil supplémentaire consulté rapporte 0.08 de plus. La première réponse s'était trompée en réponse rapide et s'est rattrapée grâce aux outils ; son score reste supérieur à celui de la réponse juste d'emblée.
- Appeler FFT deux fois ne rapporte rien de plus ; le modèle est donc poussé à « essayer un autre outil », et c'est le sens du Diverse-Tool dans le nom.
- La réponse au format erroné a un score négatif, et l'avantage le plus bas.
- Aucun terme de la récompense n'encourage à appeler moins d'outils. Tant que la réponse est juste, utiliser les trois appels avec trois outils différents donne le score maximal. La seule limite au coût d'inférence est la règle des trois appels d'outils au plus.
À l'inférence
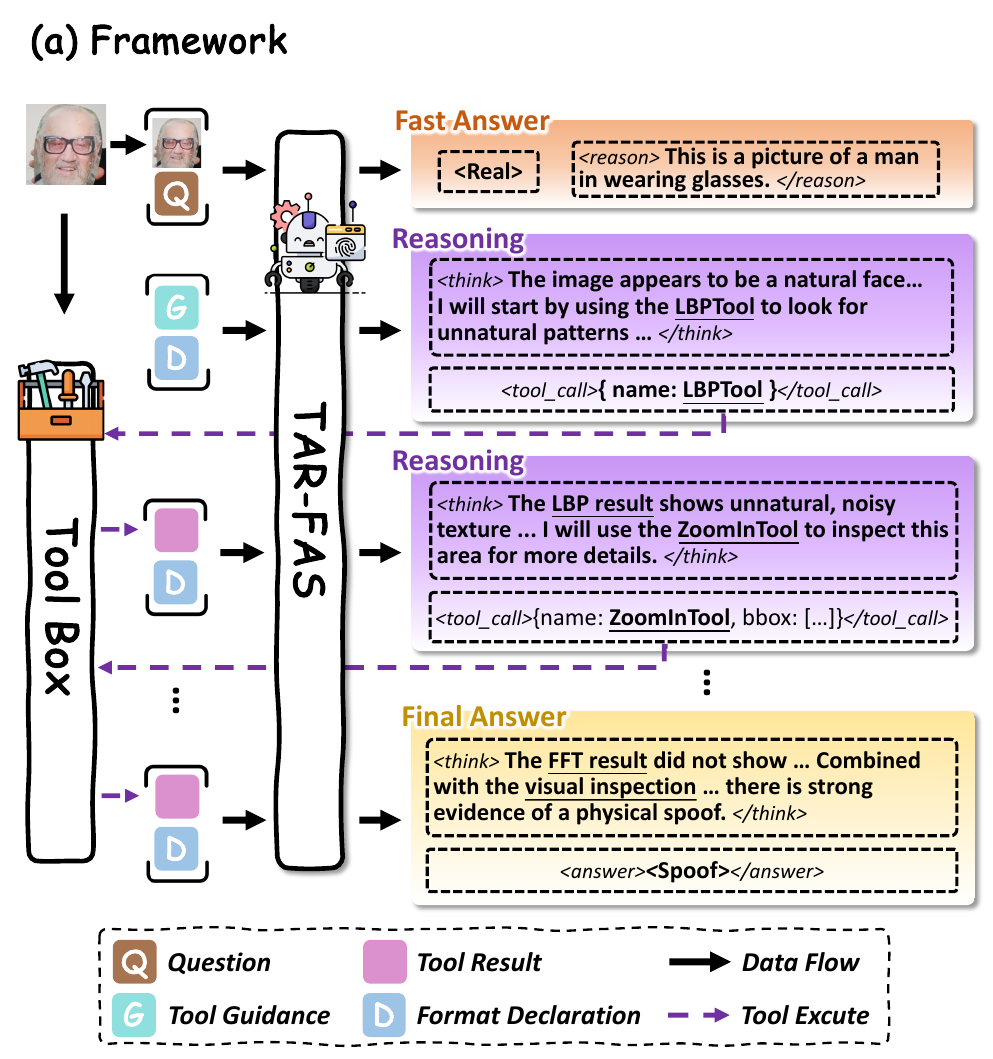
L'inférence se fait en deux temps. Au premier tour, la question est « Is this photo of a real person? » (sans utiliser d'outil), et le modèle répond rapidement au format I-FAS. Au second tour, on lui envoie cette consigne :
Wait, you should re-examine the image and give the final answer (use tools if needed).
Le modèle commence à écrire <think> et émet <tool_call> au besoin ; un programme externe exécute l'outil et renvoie l'image de résultat, et ainsi de suite, avec au plus trois appels d'outils, jusqu'à ce que le modèle écrive <answer>. Pour le HTER et l'AUC, le score est tiré des logits du token de classification de la réponse finale.
Le processus d'inférence ne comporte ni modèle expert ni indice sur le type d'attaque ; le modèle doit lire seul les images produites par les outils.
Discussion
One-to-Eleven
L'expérience principale reprend le Protocol 2 d'I-FAS, avec un entraînement sur CelebA-Spoof seul et un test direct sur 11 jeux de données ; chaque configuration est moyennée sur trois graines aléatoires. L'entrée est un visage aligné et recadré en 224×224, qu'InternVL agrandit ensuite en 448×448 pour le traitement.
En moyenne, TAR-FAS obtient un HTER de 7.54 % et une AUC de 96.67 % ; I-FAS est à 11.30 % et 93.71 %, FLIP à 18.73 % et 87.90 %.
Voici le HTER (%) jeu de données par jeu de données :
| Jeu de test | I-FAS | TAR-FAS |
|---|---|---|
| CASIA-MFSD | 1.11 | 0.00 |
| CASIA-SURF-3DMask | 6.18 | 2.09 |
| HKBU-MARs-V1+ | 18.64 | 3.48 |
| HiFiMask | 28.23 | 17.97 |
| MSU-MFSD | 5.63 | 5.71 |
| OULU-NPU | 14.86 | 14.45 |
| Replay-Attack | 9.15 | 5.75 |
| Rose-Youtu | 5.52 | 3.61 |
| SiW | 4.02 | 8.35 |
| SiW-M-V2 | 10.89 | 11.72 |
| WMCA | 20.07 | 9.78 |
| Moyenne | 11.30 | 7.54 |
Les plus grands progrès concernent les jeux de données comportant des attaques par masque. HKBU-MARs-V1+ passe de 18.64 % à 3.48 %, WMCA de 20.07 % à 9.78 %, et HiFiMask comme CASIA-SURF-3DMask baissent aussi nettement. Les auteurs soulignent que HKBU-MARs-V1+ et CASIA-SURF-3DMask contiennent des modes d'attaque et des matériaux absents des données sources.
Fait curieux, l'exemple de démonstration du début de l'article porte sur la texture périodique d'un écran, et les outils de fréquence visent justement le papier et les écrans ; pourtant, sur les jeux de données dominés par les attaques papier et écran, les résultats vont dans les deux sens. Replay-Attack et Rose-Youtu progressent, MSU-MFSD et OULU-NPU ne bougent presque pas, et SiW se dégrade, de 4.02 % à 8.35 %. SiW-M-V2, le plus varié en types d'attaques, se dégrade aussi légèrement.
Outils et étapes d'entraînement
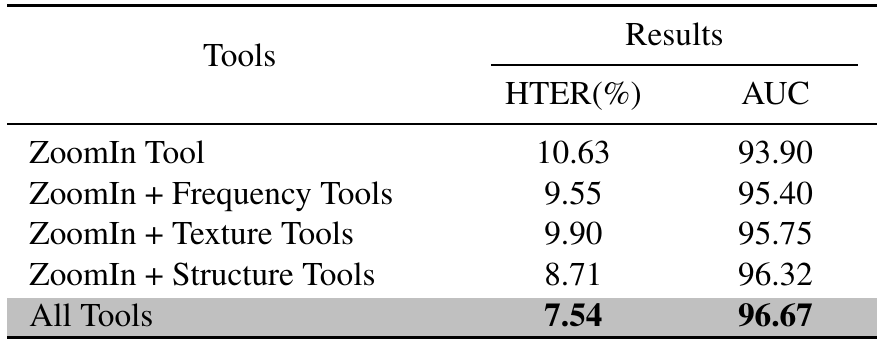
Avec ZoomIn seul, le HTER est de 10.63 %, déjà un peu plus bas que celui d'I-FAS. Parmi les trois catégories d'outils, c'est l'ajout des seuls outils de structure qui aide le plus, avec 8.71 % ; avec tous les outils, on arrive à 7.54 %.
Ce tableau montre que les outils servent, mais il rappelle aussi que la baisse du HTER de 11.30 % à 7.54 % ne vient pas entièrement d'eux. La version qui n'a que la loupe en réalise déjà une partie, et cette partie vient du nouveau backbone et de l'ensemble du processus d'entraînement.
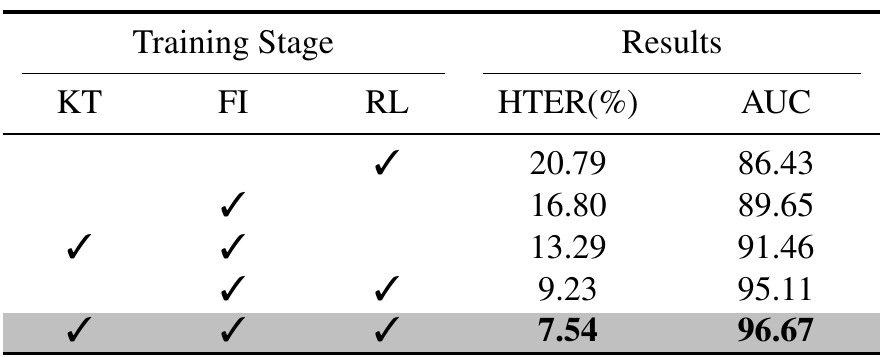
Ce tableau-ci a davantage d'histoire à raconter.
- Sans démonstrations, en passant directement à l'apprentissage par renforcement, le HTER est de 20.79 %. Sur les courbes d'entraînement de l'annexe, l'exactitude du raisonnement oscille sans cesse un peu au-dessus de 70 % avec cette approche, contre environ 95 % pour le processus complet. Le modèle ne sait même pas comment appeler un outil, et la récompense peine à l'orienter dans la bonne direction.
- En imitant seulement les démonstrations de Gemini (FI), le HTER est de 16.80 %, pire encore qu'I-FAS. La généralisation, ça ne se recopie pas sur le corrigé du professeur.
- Ajouter l'apprentissage par renforcement après les démonstrations fait passer de 16.80 % à 9.23 %, le plus grand pas de tout le tableau.
- En ajoutant en amont le transfert de connaissances, on arrive finalement à 7.54 %.
Quelques autres comparaisons
- Réponse rapide contre réponse raisonnée : pour un même modèle, la réponse rapide du premier tour a un HTER de 10.54 %, et la réponse finale, après consultation des outils, 7.54 %. La réponse rapide fait déjà un peu mieux qu'I-FAS, et un passage par les outils retire encore 3 points de pourcentage.
- Le zoom seul : le ST-GRPO de DeepEyes n'autorise que ZoomIn, et sa récompense ne regarde que le format, la justesse de la réponse et l'usage ou non d'un outil. Avec lui, le HTER est de 9.98 %, plus haut que les 7.54 % de DT-GRPO.
- Le plafond d'appels d'outils : sur la courbe de l'annexe, faire passer la limite de 1 à 3 appels fait descendre le HTER d'environ 9.2 % jusqu'à 7.54 % ; avec 4 appels, il remonte au contraire à un peu plus de 8 %. Les auteurs l'attribuent à des réponses plus longues et à une plus grande variance d'échantillonnage.
- Backbone et résolution : avec Qwen2.5-VL-7B, le HTER est de 9.45 % en 224×224 directement, de 8.60 % avec agrandissement en 448×448, et InternVL3-8B atteint 7.54 %. La résolution et le backbone contribuent chacun un peu, mais les trois chiffres restent tous inférieurs à celui d'I-FAS.
L'ancienne épreuve
L'annexe teste aussi OCIM (les quatre jeux de données O, C, I et M servent tour à tour d'ensemble de test). Le HTER moyen est de 1.30 %, contre 1.33 % pour I-FAS, quasiment à égalité. Selon la configuration, l'un ou l'autre l'emporte ; OCM→I passe de 3.22 % à 0.43 %, mais OCI→M monte de 0.32 % à 2.86 %.
Sur cette épreuve, les chiffres sont déjà serrés autour de 1 %, et il devient difficile de départager les méthodes. Le nombre de pas d'entraînement n'a qu'un plafond (au plus 4 000 pas pour le SFT, au plus 300 pour le RL), et l'article ne mentionne aucun choix de checkpoint sur le jeu de données cible ; la façon de fixer le seuil du HTER, elle, n'est pas précisée.
Un raisonnement qui a fière allure, mais qui n'a pas forcément été suivi
Pour finir, regardons les quatre exemples choisis par l'article.
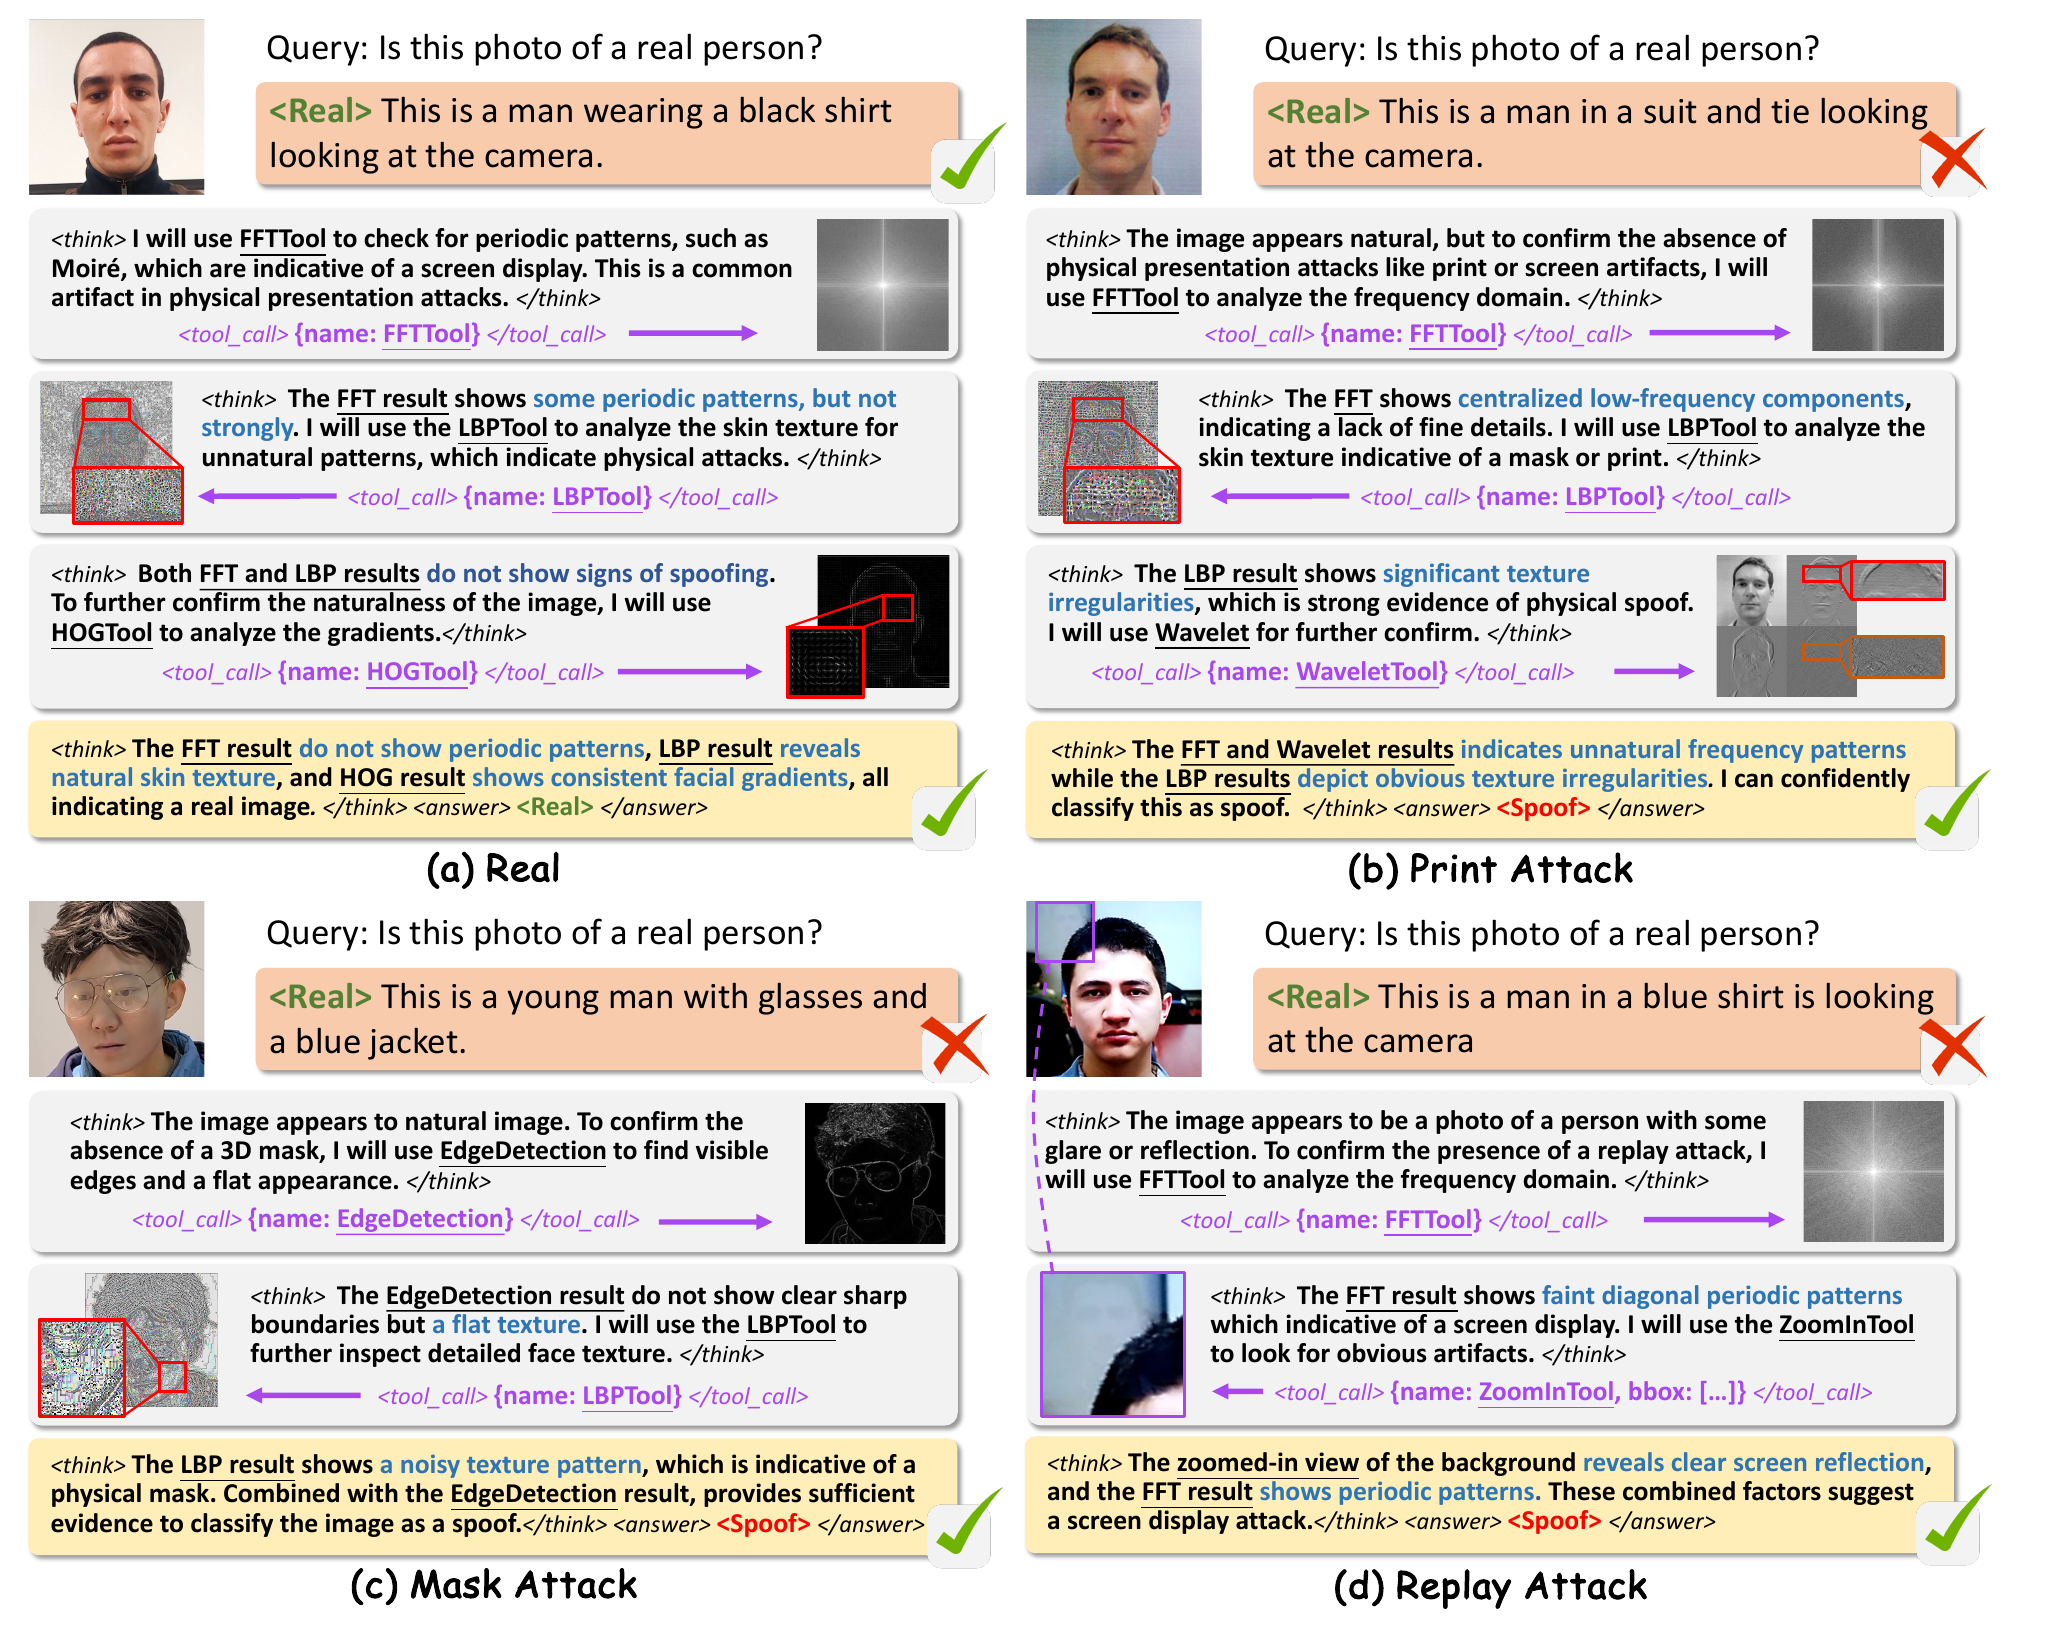
Les quatre réponses rapides sont toutes Real ; trois des exemples sont des attaques, rattrapées grâce aux outils. Les auteurs observent que le modèle préfère les outils de fréquence face au papier et aux écrans, les outils de structure face aux masques, et qu'il utilise l'outil de texture pour tous les types d'attaques.
Relisons de plus près l'exemple (a), celui de la vraie personne. Après la FFT, le modèle écrit « le résultat FFT montre quelques motifs périodiques, mais peu marqués » ; dans le résumé final, cela devient « le résultat FFT ne montre pas de motifs périodiques ». La réserve du début a disparu dans la conclusion, et tout le raisonnement a été remis en forme comme une histoire bien propre.
La réponse à cet exemple n'en est pas affectée, mais cela rappelle que le raisonnement écrit et les indices sur lesquels le modèle s'appuie réellement ne sont pas forcément la même chose. L'article ne vérifie pas si les résultats des outils pèsent vraiment sur la décision, par exemple en remplaçant la sortie d'un outil par une image sans rapport pour voir si la réponse change.
Deux autres points manquent dans l'article, et on les demandera forcément au moment du déploiement. Le premier est le temps d'inférence. Le modèle de 8B donne d'abord une réponse rapide, puis fait jusqu'à trois allers-retours, chacun avec une nouvelle image d'outil à lire. Un modèle de détection de vivacité classique sur téléphone ne fait tourner un CNN qu'une seule fois ; on imagine l'écart, mais l'article ne l'a pas mesuré. Le second est le code, qui n'est pas encore publié.
Conclusion
TAR-FAS laisse un grand modèle de langage multimodal appeler, en cours de raisonnement, des opérateurs éprouvés comme LBP, FFT ou HOG. Avec un entraînement sur CelebA-Spoof seul et un test sur 11 jeux de données, le HTER moyen passe de 11.30 % pour I-FAS à 7.54 %, et ce sont les jeux de données de masques qui progressent le plus.
Ce qu'il faut surtout retenir de cet article, c'est ce pas dans le tableau d'ablation. En imitant seulement les démonstrations de Gemini, le modèle fait moins bien qu'I-FAS ; le même modèle, suivi d'un GRPO qui ne regarde que les étiquettes vrai/faux, voit son HTER passer de 16.80 % à 9.23 %. Les démonstrations apprennent à se servir des outils ; s'en servir bien, c'est l'apprentissage par renforcement qui l'entraîne.
L'annexe cache aussi une petite découverte. Ces petits modèles experts à trois couches de convolution, qui ne voient que la sortie de LBP ou de FFT, atteignent déjà 80 à 90 % d'exactitude sur CelebA-Spoof. Dans l'article, ils servent seulement à glisser des petits mots à Gemini pendant l'annotation, et n'entrent pas en jeu à l'inférence.
Quant à installer un modèle de 8B dans un portique d'accès à reconnaissance faciale, attendons que le code soit publié et que la latence ait été mesurée.