Article original
Harnessing Chain-of-Thought Reasoning in Multimodal Large Language Models for Face Anti-Spoofing
- Publication
- CVPR 2026Conférence
- Premier dépôt sur arXiv
- arXiv:2506.01783
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@misc{faceantispoofingfacecot2025,
  title = {{Harnessing Chain-of-Thought Reasoning in Multimodal Large Language Models for Face Anti-Spoofing}},
  author = {Honglu Zhang and Zhiqin Fang and Ningning Zhao and Saihui Hou and Long Ma and Renwang Pei and Zhaofeng He},
  year = {2025},
  eprint = {2506.01783},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2506.01783}
}
Si l'on montre à un grand modèle de langage multimodal généraliste la photo d'une photo et qu'on lui demande « est-ce une attaque ? », que se passe-t-il ?
L'annexe de cet article fait justement cette expérience. Les auteurs donnent directement les images d'attaque de Rose-Youtu à un modèle sans fine-tuning, calculent pour chaque type la proportion qu'il classe comme attaque, puis comparent avec les résultats obtenus après entraînement avec FaceCoT :
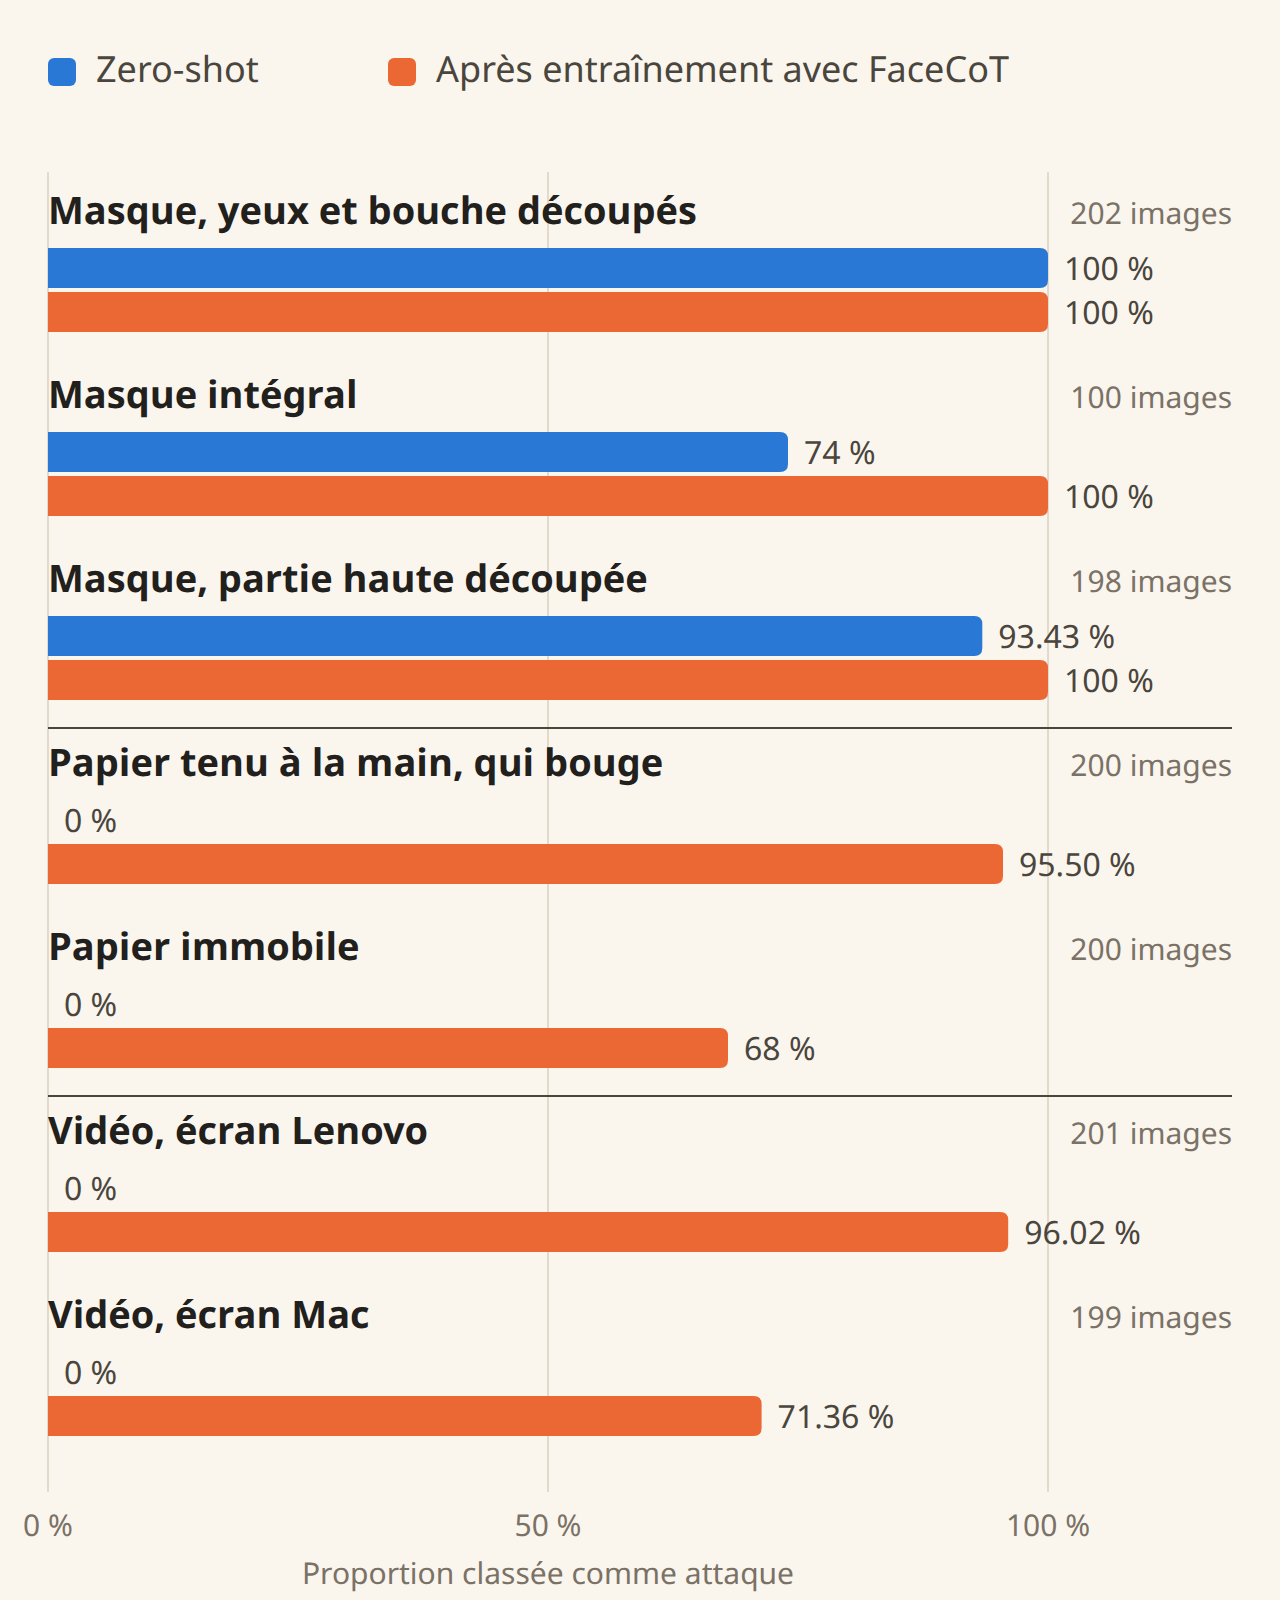
La plupart des masques sont reconnus ; sur papier comme sur écran, pas une seule image n'est détectée. Pour un modèle généraliste, un visage affiché sur un écran, c'est un visage, tout simplement.
Pour l'équipe de Didi Chuxing, de l'Université des postes et télécommunications de Pékin et de l'Université normale de Pékin, ce qui manque, ce sont les données. Les jeux de données de détection des attaques faciales ne contiennent que des images et des étiquettes vrai/faux ; pour apprendre à un grand modèle de langage à expliquer pas à pas ce qui fonde son jugement, il faut d'abord un jeu de questions-réponses image-texte. Ils ont donc construit FaceCoT, 1.08 million de questions-réponses accompagnées chacune d'un raisonnement en six parties, puis conçu une méthode d'entraînement en deux étapes pour s'en servir.
Définir le problème
I-FAS fait d'abord répondre le modèle vrai ou faux, puis lui fait ajouter une phrase d'explication. Cette phrase vient d'un modèle de description ajusté, qui y fait apparaître des supports d'attaque comme screen ou paper. C'est un peu plus de sémantique qu'une simple étiquette, mais cela reste une seule phrase.
Ce que veulent les auteurs, c'est le processus de jugement complet. Regarder d'abord l'image entière, puis le visage, relever les détails des traits et de la peau, ensuite raisonner, décrire la méthode d'attaque, et seulement à la fin conclure. Pour y parvenir, il faut des données où chaque exemple contient ce raisonnement rédigé, et une méthode d'entraînement capable d'apprendre à la fois le raisonnement et la classification.
Sur la méthode d'entraînement, les auteurs donnent une raison à part. Si l'on mélange le texte de raisonnement et l'étiquette de classification dans un entraînement de bout en bout, la classification converge vite et l'entraînement se termine avant que le raisonnement soit bien appris ; l'encodeur visuel n'a alors aucune occasion d'apprendre quoi que ce soit de ces descriptions détaillées.
Résoudre le problème
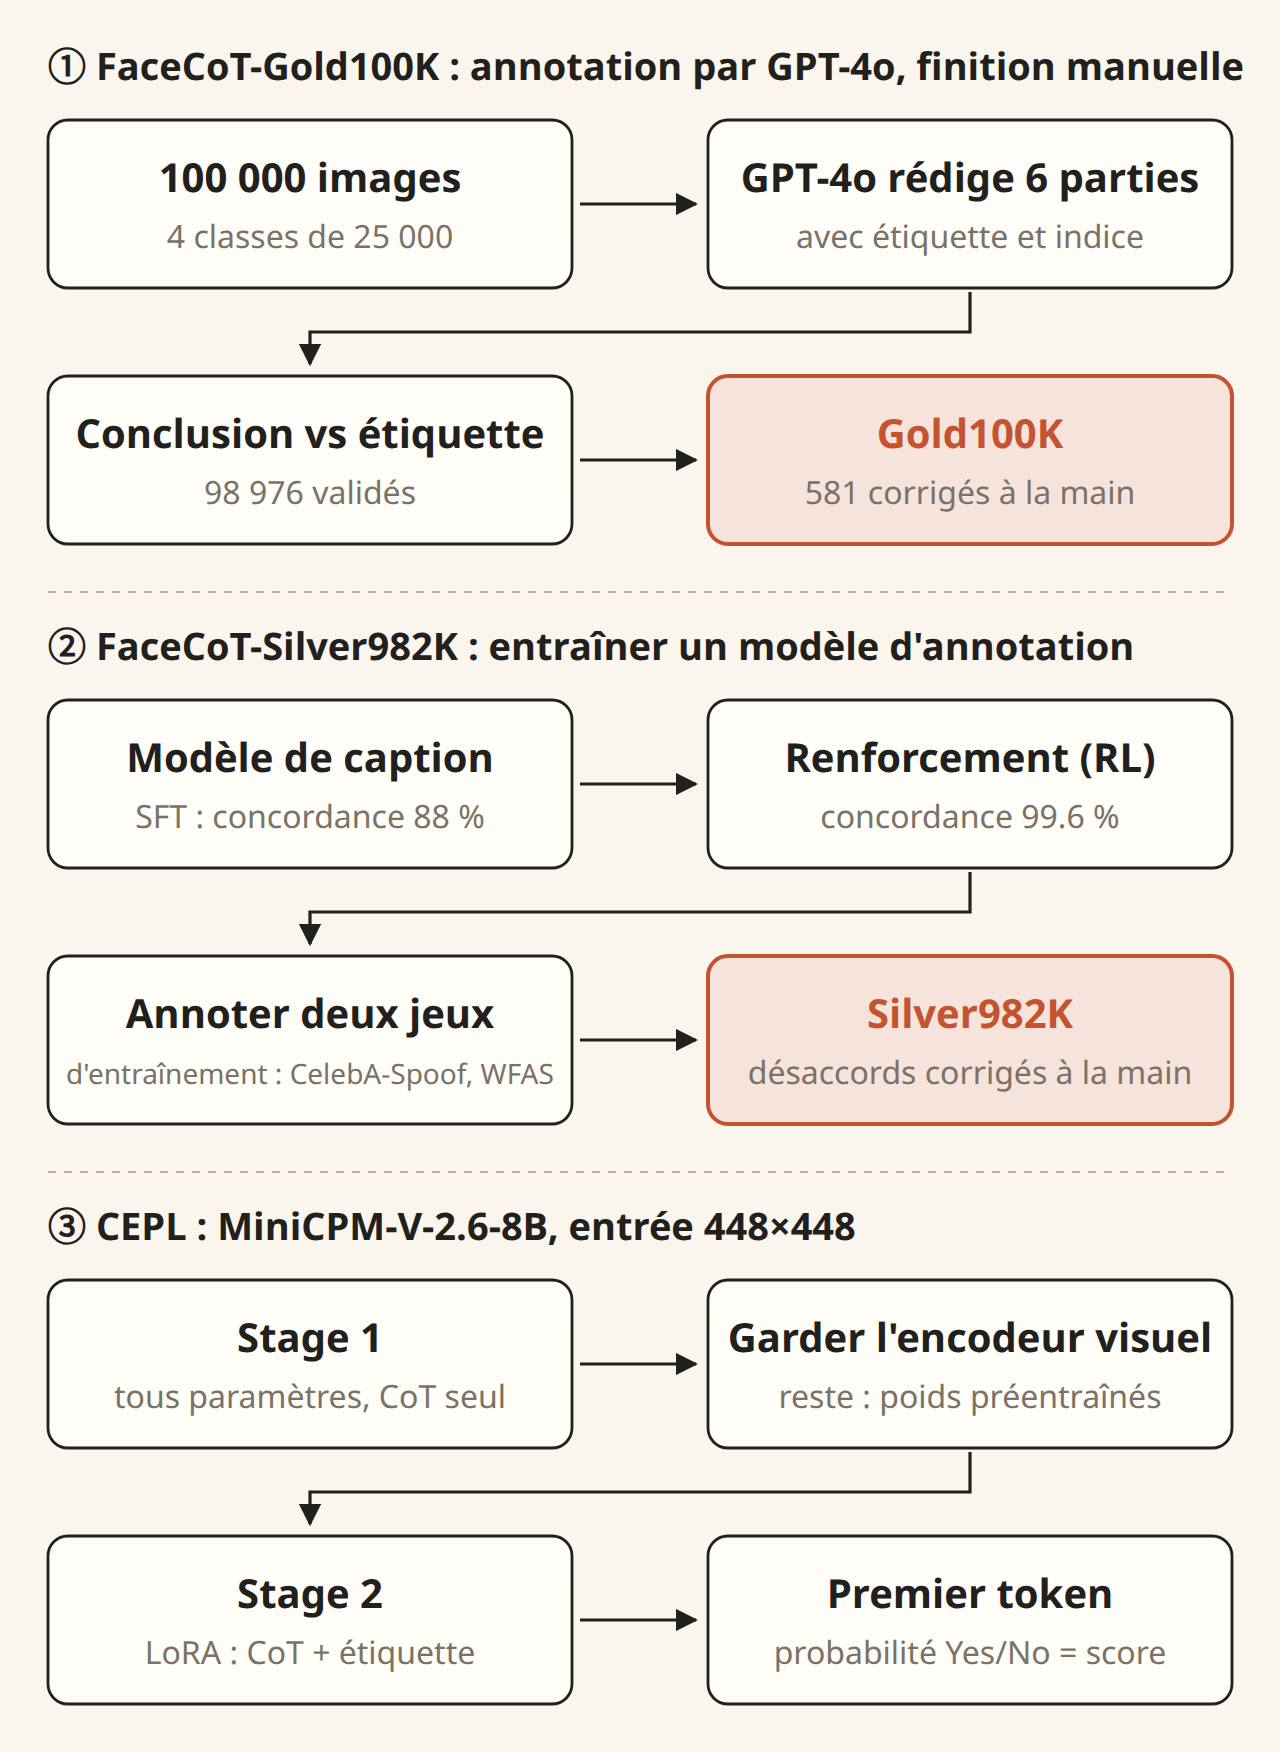
L'ensemble se déroule en trois parties. Les deux premières fabriquent les données, la troisième entraîne le modèle.
D'où viennent les données
Les images proviennent de deux jeux de données. CelebA-Spoof compte 625 000 images, 10 000 personnes et 10 types d'attaques ; WFAS, collecté sur le terrain dans des environnements non contrôlés, compte 1.38 million d'images, dont 853 000 attaques et 529 000 vraies personnes, et couvre 14 types d'attaques.
Les 100 000 images sélectionnées sont réparties en quatre classes de 25 000 :
- Vraies personnes : toutes issues de WFAS, dont les scènes sont les plus variées.
- Impression : 5 000 photos et 5 000 affiches ; 3 000 chacun pour les journaux, les albums, le A4, l'impression du visage et l'impression du haut du corps.
- Relecture : 10 000 pour le téléphone, 10 000 pour la tablette et 5 000 pour l'écran d'ordinateur.
- Masque : 12 768 masques 3D, 10 579 masques partiels, 1 488 figurines (garage kit) et 165 poupées réalistes.
Les trois grandes classes d'attaque regroupent en tout 14 types d'attaques. Dans chaque classe, les auteurs ont cherché à garder des effectifs proches d'une sous-catégorie à l'autre.
Un raisonnement en six parties
Chaque réponse est découpée en six balises :
<Caption>Ce que montre l'image entière</Caption>
<Facial Description>L'apparence du visage</Facial Description>
<Facial Attributes>Détails des yeux, du nez, de la bouche, de la peau, etc.</Facial Attributes>
<Reasoning>Juger pas à pas à partir des informations précédentes</Reasoning>
<Spoofing Description>Méthode d'attaque et traces clés</Spoofing Description>
<Conclusion>Yes ou No</Conclusion>
La question est « Vous êtes un expert en détection des attaques faciales ; répondez : est-ce une attaque ? ». Yes désigne donc une attaque, et No une vraie personne.
L'exemple du début de l'article montre une personne qui tient un masque en papier imprimé d'un visage de femme, percé aux yeux, au nez et à la bouche. Les six parties disent, dans l'ordre :
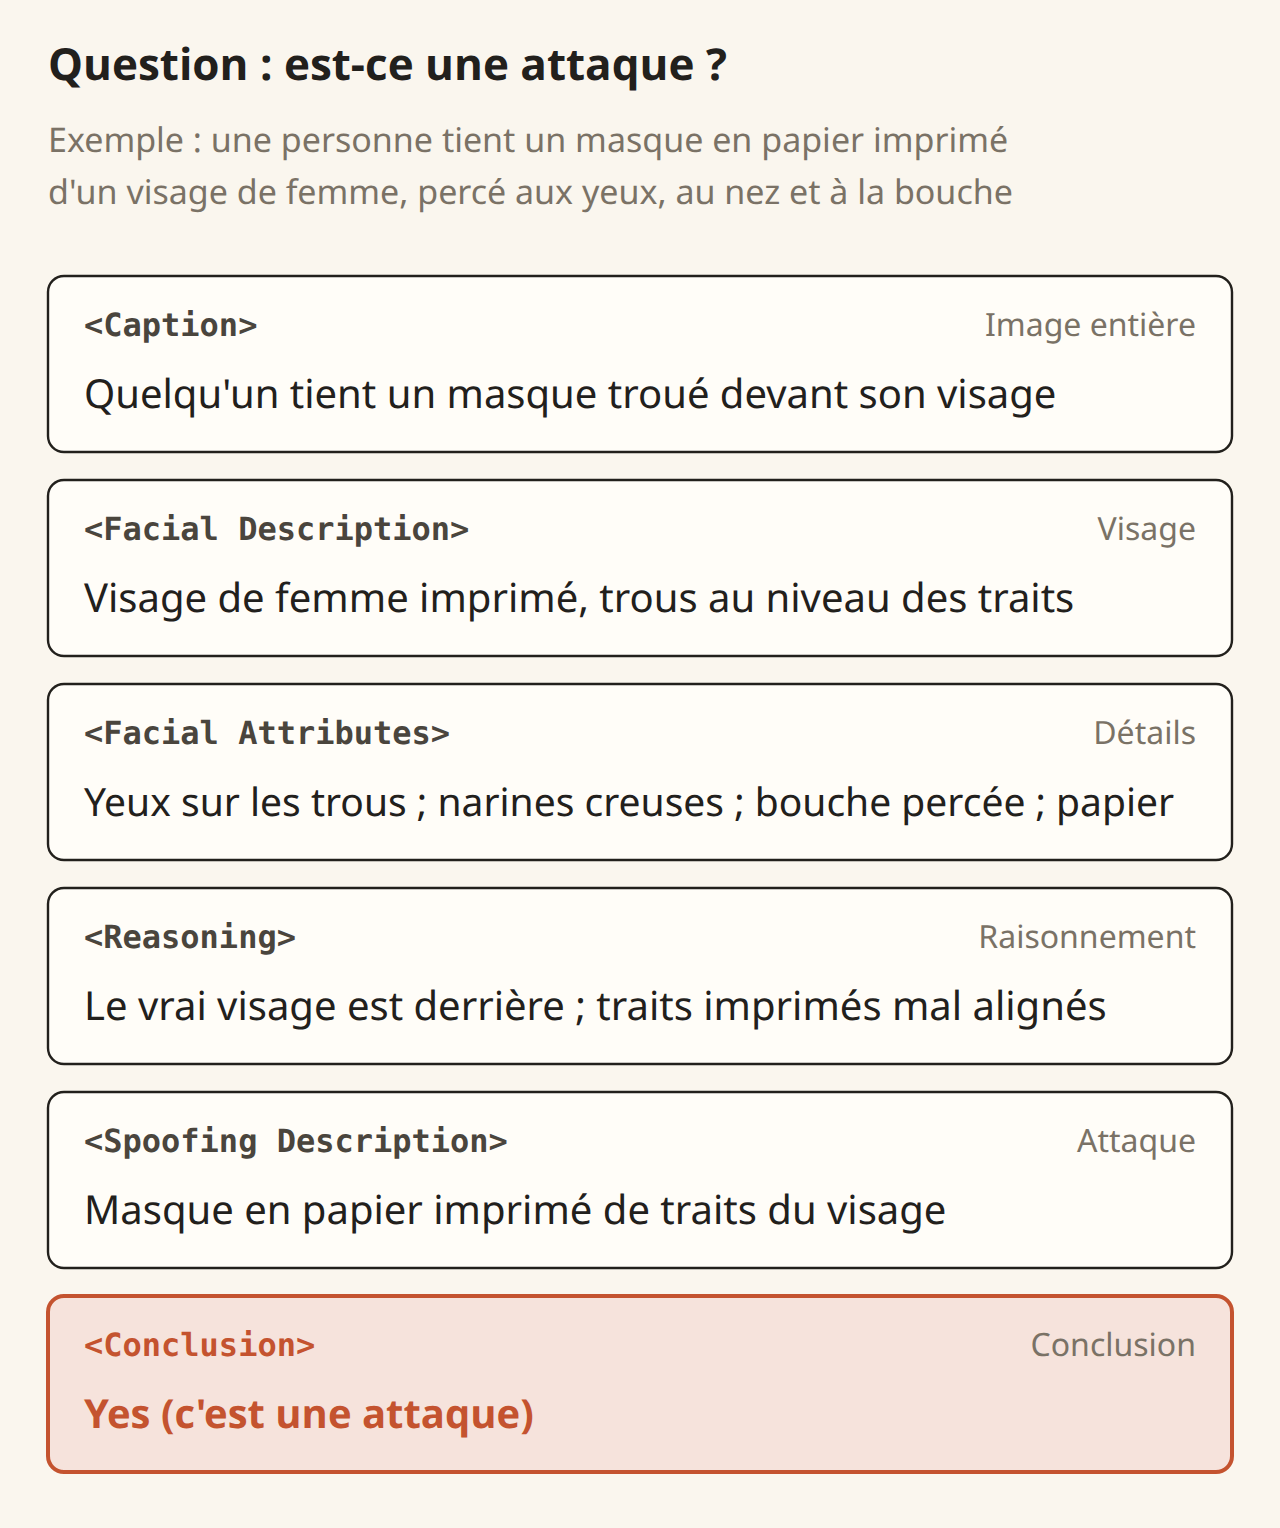
Du large au précis, de l'ensemble au détail, et la conclusion seulement à la fin. Les auteurs disent imiter ainsi l'ordre dans lequel un humain distingue le vrai du faux.
GPT-4o écrit avec la réponse sous les yeux
Les six parties de Gold100K sont rédigées par GPT-4o. L'annexe précise les cinq éléments que GPT-4o reçoit à chaque fois : l'image, le prompt système, la question, l'indice, et l'étiquette de l'image.
Le prompt système lui fait jouer le rôle d'« examinateur », lui impose le format en six parties et exige que la conclusion corresponde exactement à la réponse attendue. GPT-4o ne rédige donc pas son propre jugement, mais un corrigé détaillé écrit en connaissant déjà la réponse.
Pourquoi lui donner la réponse et un indice ? L'annexe donne un exemple. Sur la photo d'un journal japonais, GPT-4o voit bien qu'il s'agit du contenu d'un journal, mais juge que ce n'est pas une attaque. Il le justifie par un visage net et naturel, sans trace de retouche, et par l'absence, dans le journal, de tout signe d'échange de visage ou de falsification. Il a compris « attaque » au sens de falsification numérique.
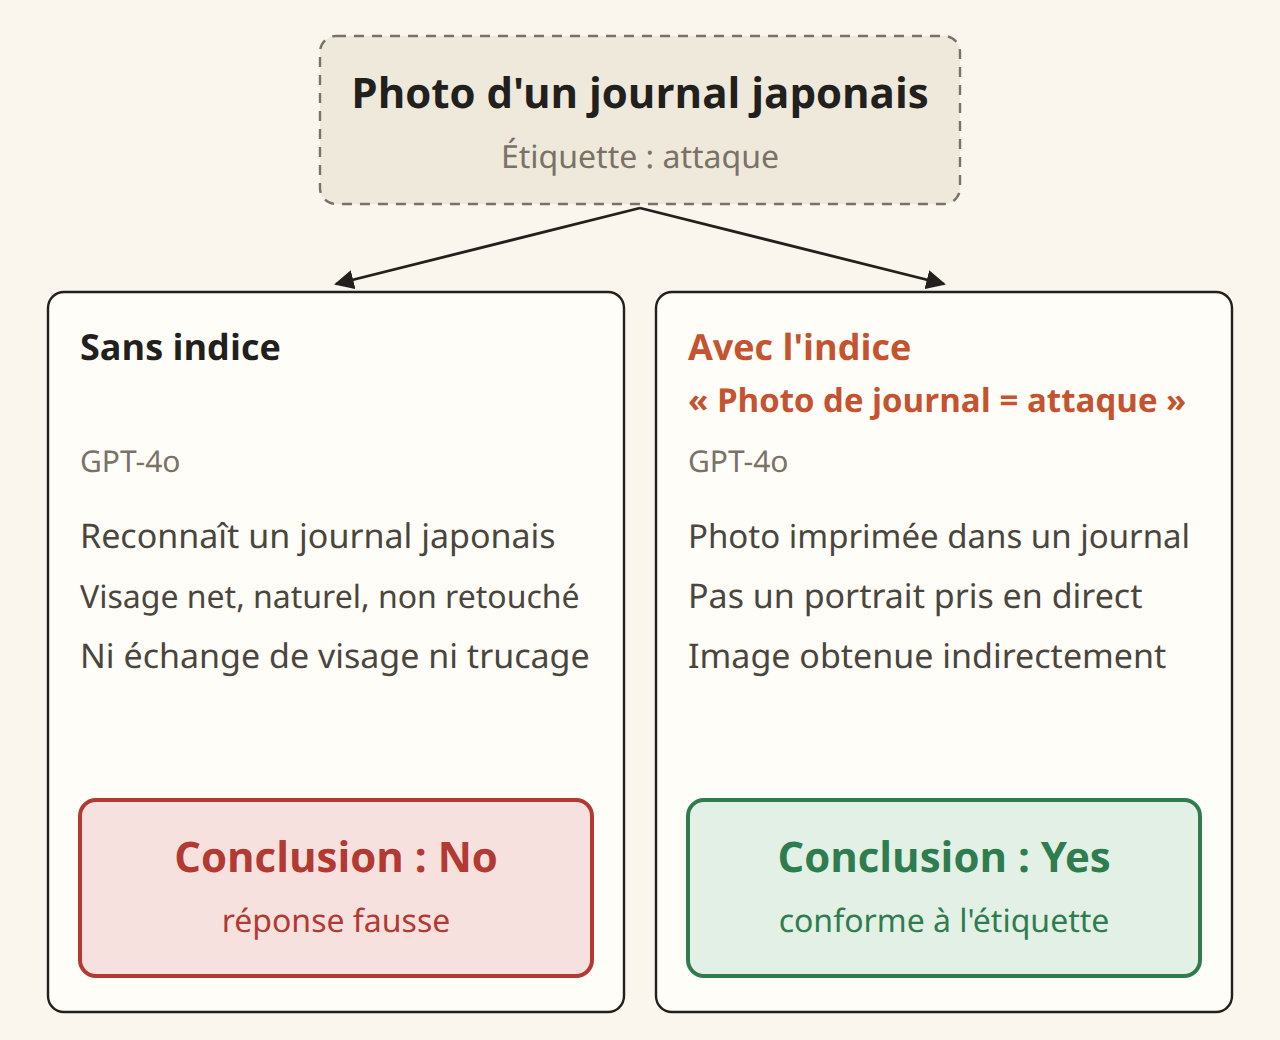
Avec l'indice « photographier un journal est une attaque », GPT-4o change d'avis. Ce que le journal imprime, c'est bien une vraie personne ; savoir si la photo d'un journal est une attaque relève des règles propres à la tâche FAS. Les auteurs ont donc écrit un indice pour chacun des dix types d'attaques papier et écran, par exemple « photographier une affiche est une attaque » ou « photographier un écran de téléphone est une attaque ». Pour les masques, le modèle fait la différence tout seul, et ils n'en ont pas ajouté.
Si le modèle zero-shot prend tous les papiers et tous les écrans pour de vraies personnes, c'est sans doute aussi en partie pour cette raison. Personne ne lui a appris cette règle.
Une fois le texte rédigé, une expression régulière extrait le contenu de <Conclusion> pour le comparer à l'étiquette. Au premier passage, 98 976 exemples concordent ; les autres sont annotés une seconde fois par GPT-4o, et les 581 qui ne concordent toujours pas sont classés comme cas difficiles et confiés à des humains. Ceux-ci vérifient d'abord la conclusion, cherchent ensuite où le raisonnement ou la description s'est trompé, corrigent, puis remettent en cohérence les parties suivantes.
GPT-4o coûte environ 0.01 dollar par image, soit environ 1 000 dollars pour 100 000 images.
Passer à 982 000 exemples
Pour annoter encore un million d'images, GPT-4o plus le travail humain coûteraient trop cher. Les auteurs entraînent plutôt un modèle de caption spécialisé dans la rédaction du raisonnement en six parties.
D'abord, un fine-tuning supervisé sur Gold100K. Utilisé pour annoter des images jamais vues, ce modèle ne produit une conclusion conforme à l'étiquette que dans 88 % des cas ; les défauts courants sont les erreurs de contenu et les dérives de format. Vient ensuite une phase d'apprentissage par renforcement, avec seulement deux récompenses. Une conclusion conforme à l'étiquette rapporte 1 point, un format conforme au gabarit en six parties rapporte 1 point ; une pénalité KL le retient pour qu'il ne s'éloigne pas trop de la version issue du fine-tuning supervisé. À l'issue de cette phase, sur 2 000 images non annotées tirées au hasard, le taux de concordance monte à 99.6 %.
Les ensembles d'entraînement de CelebA-Spoof et de WFAS, annotés par ce modèle, forment Silver982K, dont environ 368 000 exemples de vraies personnes. Les échantillons dont la conclusion ne concorde pas avec l'étiquette sont, là aussi, corrigés à la main. L'entraînement du modèle de caption prend environ une journée sur 8 A100, l'annotation elle-même environ 288 heures GPU ; le nettoyage manuel des deux sous-ensembles a occupé 6 annotateurs pendant trois jours.
CEPL : d'abord entraîner les yeux, ensuite apprendre à parler
Le backbone est MiniCPM-V-2.6-8B, composé d'un encodeur visuel, d'un resampler et d'un modèle de langage ; l'entrée est redimensionnée en 448×448. CEPL (CoT-Enhanced Progressive Learning) comporte deux étapes :
- Stage 1, préentraînement d'amélioration visuelle : fine-tuning de tous les paramètres, avec pour seule supervision le texte du raisonnement en six parties. Le but est que l'encodeur visuel, en suivant les descriptions détaillées du texte, comme le bord d'un masque, la matière du papier ou les reflets d'un écran, apprenne à prêter attention à ces endroits.
- Stage 2, entraînement conjoint multitâche : seul l'encodeur visuel du Stage 1 est conservé ; le resampler et le modèle de langage reviennent à leurs poids préentraînés d'origine, le modèle de langage reçoit un LoRA, puis l'entraînement utilise à la fois le texte de raisonnement et l'étiquette binaire.
Pourquoi réinitialiser le modèle de langage au Stage 2 ? L'article dit seulement qu'il s'agit de conserver les détails appris par l'encodeur visuel et de rendre aux autres modules leurs poids préentraînés, sans plus d'explication. Une lecture possible est que le Stage 1 n'est qu'un moyen d'entraîner l'encodeur visuel grâce à la supervision textuelle, et que ce que le modèle de langage y apprend n'a pas besoin d'être gardé.
L'entraînement utilise AdamW, un taux d'apprentissage de 1e-6, au plus 10 époques, des lots de 256 et 8 A100 ; chaque expérience est moyennée sur trois graines aléatoires.
D'où vient le score
Le HTER et l'AUC, les métriques de la FAS, demandent un score continu. L'annexe détaille la méthode. On désactive l'aléa pour un décodage glouton, on prend les logits de Yes et de No au premier token généré par le modèle, et on applique un softmax :
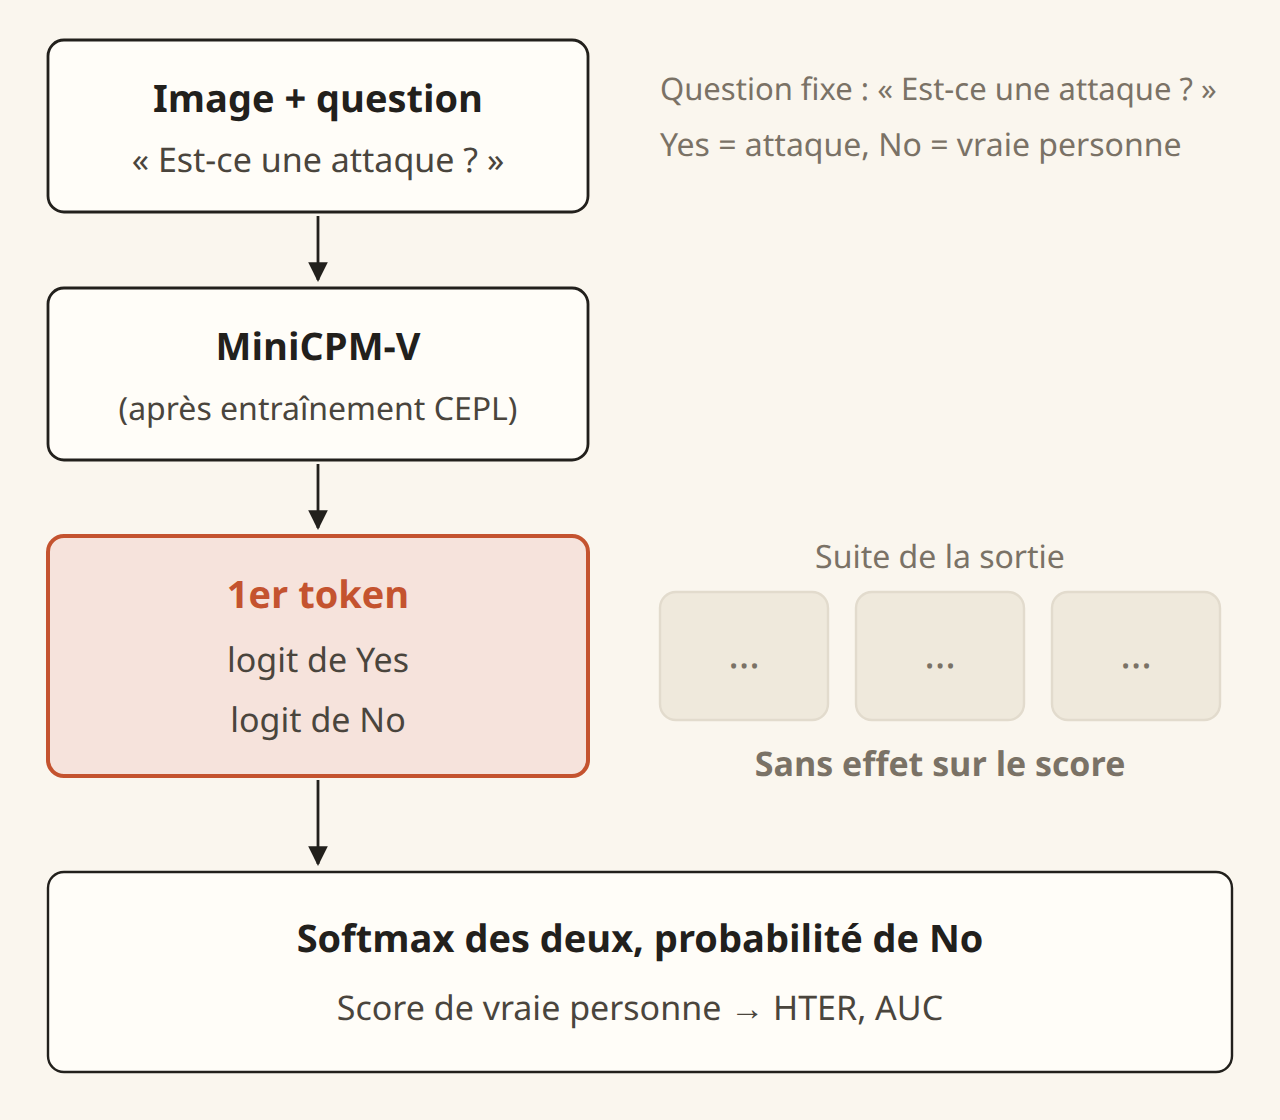
Quand le premier token sort, aucun texte de raisonnement n'a encore été produit. Les scores des tableaux mesurent donc la capacité du modèle à répondre directement. Le raisonnement en six parties agit sur la façon dont le modèle apprend ; le score lui-même est fixé avant qu'apparaisse le moindre texte de raisonnement.
Discussion
One-to-Eleven
Le protocole reprend le Protocol 2 d'I-FAS. Après l'entraînement, le modèle est testé directement sur 11 jeux de données : MSU-MFSD, CASIA-MFSD, Replay-Attack, OULU-NPU, SiW, Rose-Youtu, HKBU-MARs-V1+, WMCA, SiW-M-V2, CASIA-SURF-3DMask et HiFiMask.
Pour comparer, il faut bien distinguer les données d'entraînement. Les méthodes de référence du tableau sont toutes entraînées sur CelebA-Spoof seul, alors que le modèle des auteurs existe en trois versions. HTER et AUC sont des moyennes sur les 11 jeux de données (%) :
| Méthode | Images d'entraînement | HTER | AUC |
|---|---|---|---|
| ViTAF | CelebA-Spoof | 23.85 | 82.82 |
| ViT-L | CelebA-Spoof | 21.08 | 85.61 |
| FLIP | CelebA-Spoof | 18.73 | 87.90 |
| I-FAS | CelebA-Spoof | 11.30 | 93.71 |
| Ours-CelebA | CelebA-Spoof | 8.56 | 96.37 |
| Ours-100K | Gold100K | 7.65 | 96.59 |
| Ours-All | Les 1.08 million | 6.30 | 97.77 |
La « baisse de 5 points de pourcentage du HTER » annoncée par l'article oppose Ours-All à I-FAS. Ours-All dispose en plus des images de WFAS ; les conditions diffèrent. La version aux conditions les plus proches est Ours-CelebA, qui n'utilise que les images de CelebA-Spoof ; avec elle, le HTER passe de 11.30 % à 8.56 %. Son raisonnement en six parties est rédigé par le modèle de caption, lequel a appris sur Gold100K, qui contient des images de WFAS.
Jeu de données par jeu de données, l'effet des données d'entraînement est plus net (HTER, %) :
| Jeu de test | I-FAS | CelebA | All |
|---|---|---|---|
| CASIA-SURF-3DMask | 6.18 | 6.21 | 0.40 |
| HiFiMask | 28.23 | 28.68 | 15.93 |
| HKBU-MARs-V1+ | 18.64 | 6.96 | 7.34 |
| OULU-NPU | 14.86 | 9.47 | 5.86 |
| WMCA | 20.07 | 11.51 | 10.16 |
| SiW | 4.02 | 0.79 | 0.48 |
| MSU-MFSD | 5.63 | 8.33 | 5.00 |
| Replay-Attack | 9.15 | 9.87 | 12.75 |
- Sur CASIA-SURF-3DMask et HiFiMask, avec CelebA-Spoof seul, le résultat est presque identique à celui d'I-FAS ; il faut ajouter WFAS pour une nette amélioration. Les progrès sur ces deux jeux de données viennent surtout des données de masques de WFAS.
- HKBU-MARs-V1+, lui aussi un jeu de données de masques, passe de 18.64 % à 6.96 % avec CelebA-Spoof seul. OULU-NPU, WMCA et SiW progressent aussi nettement dès CelebA-Spoof seul.
- Il y a aussi des cas en sens inverse. Sur MSU-MFSD, la version CelebA-Spoof seul fait moins bien qu'I-FAS ; sur Replay-Attack, ajouter des données fait au contraire monter le HTER de 9.87 % à 12.75 %, au-dessus des 9.15 % d'I-FAS.
CoT, CEPL et résolution
Les ablations sont toutes entraînées sur Gold100K. Voici, réunis sur un même graphique, les HTER dispersés dans plusieurs tableaux :
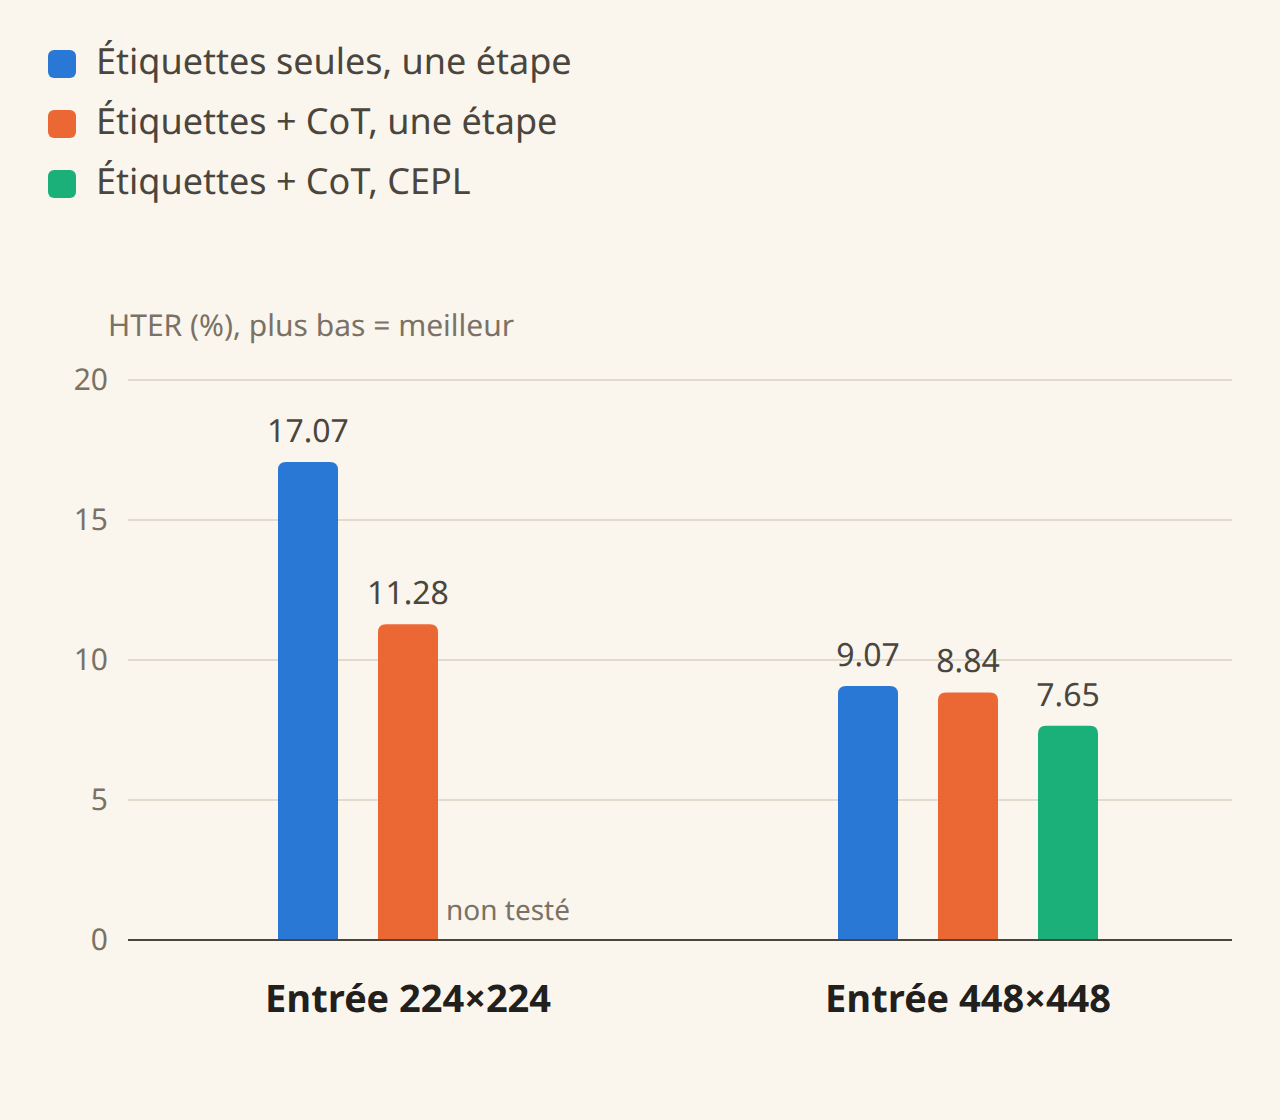
Lisons ce graphique dans l'ordre :
- C'est la résolution qui pèse le plus. Avec les étiquettes seules, passer de 224 à 448 fait baisser le HTER de 17.07 % à 9.07 %.
- Le CoT aide surtout à basse résolution. En 224, ajouter le raisonnement en six parties fait baisser le HTER de près de 6 points de pourcentage ; en 448, toujours avec un entraînement en une seule étape, la baisse n'est que de 0.23. Selon l'interprétation des auteurs, le texte de raisonnement aide le modèle à retrouver des détails illisibles à basse résolution. Inversement, quand l'image est assez nette, ce texte n'a plus grand-chose à compléter.
- En 448, la différence vient de CEPL, de 8.84 % à 7.65 %.
- Ajouter de l'apprentissage par renforcement après CEPL n'améliore rien, avec un HTER de 7.80 %. Les auteurs estiment que les données supervisées sont déjà assez nombreuses et que le gain marginal de l'apprentissage par renforcement est faible.
L'annexe signale aussi que la plupart des méthodes FAS, I-FAS compris, utilisent des entrées en 224×224. Dans le tableau principal, cet article se compare en 448×448 ; d'après les ablations ci-dessus, ce seul point peut lui donner un avantage non négligeable.
La qualité des données fait aussi l'objet d'une comparaison. Avec un entraînement sur les données annotées par le modèle de caption issu du seul fine-tuning supervisé, le HTER est de 8.00 % ; avec la version enrichie d'apprentissage par renforcement, il descend à 6.87 %.
Autre backbone, zero-shot, ancienne épreuve
- Changer de backbone : en zero-shot, le HTER moyen de MiniCPM-V-2.6-8B est de 17.91 %, et de 6.30 % après entraînement ; Qwen2.5-VL-7B passe de 19.60 % en zero-shot à 9.32 % après entraînement. Les deux backbones en profitent, et MiniCPM-V obtient le meilleur résultat.
- Les attaques les plus difficiles : sur Rose-Youtu, après entraînement, les moins bien détectées restent le papier immobile (68.00 %) et la vidéo lue sur un écran Mac (71.36 %).
- OCIM : l'annexe reprend aussi l'ancienne épreuve où les quatre jeux de données O, C, I et M servent tour à tour d'ensemble de test ; le HTER moyen est de 1.06 %, contre 1.33 % pour I-FAS. Sur les quatre configurations, deux ont un HTER moins bon que celui d'I-FAS : ICM→O, avec 2.81 % contre 1.74 %, et OCI→M, avec 0.42 % contre 0.32 %. Les auteurs le reconnaissent eux-mêmes, les AUC de cette épreuve dépassent toutes 99 % et ne départagent plus vraiment les méthodes.
Questions encore ouvertes
- Le seuil du HTER : l'article n'explique pas comment le seuil est fixé, ni quel checkpoint est retenu parmi les 10 époques au plus. L'AUC n'a pas besoin de seuil et en est moins affectée.
- La fidélité du raisonnement : le raisonnement en six parties a été écrit à l'origine par GPT-4o avec la réponse sous les yeux, et c'est cette façon d'écrire que le modèle apprend ; le score, lui, est pris au premier token, avant tout raisonnement. L'article ne vérifie pas si les raisons écrites par le modèle sont bien les indices sur lesquels il s'appuie réellement. Dans leurs limites, les auteurs mentionnent aussi que FaceCoT pourrait servir à évaluer l'explicabilité, mais ils ne l'ont pas encore fait.
- Le coût d'inférence : un modèle de 8B avale des images en 448×448, et l'article ne donne aucun temps d'inférence.
- L'ouverture : le jeu de données s'obtient en signant un accord et en faisant une demande aux auteurs, pour un usage académique uniquement ; seules les annotations textuelles sont diffusées, et il faut obtenir soi-même les images auprès de CelebA-Spoof et de WFAS. Sur GitHub, les poids du modèle et le code doivent être « publiés après l'acceptation officielle de l'article », et restent pour l'instant marqués comme non publiés.
Conclusion
FaceCoT constitue un jeu de questions-réponses FAS de 1.08 million d'exemples, chacun avec un raisonnement en six parties. Les 100 000 premiers sont rédigés par GPT-4o avec la réponse sous les yeux, puis finalisés à la main ; le reste vient d'un modèle d'annotation ajusté par apprentissage par renforcement. Entraîné dessus, MiniCPM-V descend à 6.30 % de HTER moyen sur One-to-Eleven ; avec les seules images de CelebA-Spoof, il obtient encore 8.56 %.
Le plus utile reste pourtant le tableau d'ablation. Avec les étiquettes seules, passer l'entrée de 224 à 448 fait déjà baisser le HTER de 17.07 % à 9.07 % ; en 448, le raisonnement en six parties n'apporte plus que 0.23 point de pourcentage dans un entraînement en une seule étape. Si votre modèle FAS multimodal mange encore des visages en 224, augmentez d'abord la résolution, et décidez ensuite s'il vaut la peine de payer 1 000 dollars à GPT-4o pour rédiger des corrigés.
TAR-FAS, présenté au même CVPR, a pris un autre chemin. Plutôt que d'allonger le raisonnement, il laisse le modèle appeler en cours de raisonnement de vieux outils comme LBP ou FFT pour examiner l'image. Les deux articles utilisent le même One-to-Eleven ; avec un entraînement sur CelebA-Spoof seul, les 7.54 % de TAR-FAS sont un peu plus bas que les 8.56 % de cet article, mais le backbone et la résolution d'entrée diffèrent.
Quant aux papiers et aux écrans du début, pris pour de vraies personnes, on ne peut pas tout reprocher au modèle généraliste. Au départ, même GPT-4o avait besoin qu'on le lui rappelle pour savoir que photographier un journal, c'est déjà tricher.