Article original
An Unbiased Benchmark for Domain Generalization Face Anti-Spoofing
- Publication
- SIBGRAPI Workshops 2025Atelier (workshop)
Citer cet article · BibTeX
La référence correspond à la version liée et cite les auteurs de l’article original.
@inproceedings{faceantispoofingunbiaseddgfas2025,
  title = {{An Unbiased Benchmark for Domain Generalization Face Anti-Spoofing}},
  author = {Raul Almeida and Bruno Kamarowski and Bernardo Biesseck and Luiz Coelho and Roger Granada and David Menotti},
  year = {2025},
  booktitle = {SIBGRAPI Workshops},
  url = {https://sol.sbc.org.br/index.php/sibgrapi_estendido/article/view/38278}
}
En détection d'usurpation faciale inter-jeux de données, l'épreuve la plus courante de ces dernières années s'appelle OCIM. Quatre jeux de données, OULU-NPU (O), CASIA-FASD (C), Replay-Attack (I) et MSU-MFSD (M) : on en prend trois pour l'entraînement et un pour le test, par exemple OCI→M. De 2019 à 2025, le HTER de ce test est passé de près de 18 % à moins de 1 %.
Raul Almeida, David Menotti et leurs collègues de l'Université fédérale du Paraná, au Brésil, avec des chercheurs d'unico, une entreprise brésilienne de vérification d'identité, reviennent sur la façon dont ces chiffres sont mesurés. Comme l'annonce déjà leur titre, l'épreuve actuelle est biaisée.
C'est un article court de travail en cours, six pages seulement ; les expériences sont de petite taille, mais la question est posée sans détour.
Définir le problème
Dans un processus d'apprentissage automatique ordinaire, les données sont réparties en trois parts. L'ensemble d'entraînement met à jour les poids, l'ensemble de validation décide quand s'arrêter et quels hyperparamètres retenir, et l'ensemble de test n'est consulté qu'une fois, quand tout est figé.
OCIM n'en a que deux. Les trois jeux de données sources servent à l'entraînement, et le quatrième joue à la fois le rôle de validation et de test. Pendant l'entraînement, on évalue sur l'ensemble de test à la fin de chaque époque, puis on rapporte l'époque la meilleure. Pour les auteurs, cela revient à lorgner sans cesse le sujet d'examen pendant les révisions.
Pourquoi est-ce important ? Parce qu'en déploiement, il n'y a pas de sujet d'examen. Une fois en ligne, le modèle rencontre de nouveaux téléphones, de nouveaux éclairages, de nouvelles attaques, et personne ne vous donne d'avance les étiquettes de ces données pour choisir l'époque qui leur convient le mieux. Un score choisi sur l'ensemble de test paraît meilleur que celui qu'on peut réellement obtenir.
Meilleur de combien ? Faisons le calcul dans un cas extrême. Supposons que le vrai taux d'erreur du modèle vaille 10 % à chaque époque, sans aucun progrès ; l'ensemble de test compte 40 vidéos de vraies personnes et 80 d'attaques, et chaque mesure du HTER fluctue à cause de l'échantillonnage. On répète la même expérience 2 000 fois pour voir combien rapporte en moyenne « retenir la plus basse parmi N époques » :
import numpy as np

rng = np.random.default_rng(0)
n_live, n_spoof, true_error, trials = 40, 80, 0.10, 2000

def measured_hter(epochs):
    apcer = rng.binomial(n_spoof, true_error, (trials, epochs)) / n_spoof
    bpcer = rng.binomial(n_live, true_error, (trials, epochs)) / n_live
    return (apcer + bpcer) / 2

for epochs in (1, 10, 30, 100):
    best = measured_hter(epochs).min(axis=1)        # dans chaque expérience, on retient l'époque la plus basse
    print(f"époques regardées : {epochs:>3}, plus basse retenue : moyenne {best.mean():.1%}")
époques regardées :   1, plus basse retenue : moyenne 9.9%
époques regardées :  10, plus basse retenue : moyenne 5.8%
époques regardées :  30, plus basse retenue : moyenne 4.6%
époques regardées : 100, plus basse retenue : moyenne 3.6%
Le modèle n'a pas changé du tout ; plus on regarde souvent l'ensemble de test, plus le chiffre retenu est flatteur. Avec 100 regards, un modèle à 10 % peut annoncer 3.6 %. Dans un vrai entraînement, les modèles des différentes époques sont réellement plus ou moins bons, et retenir le meilleur n'est pas que de la chance ; mais dès que le choix se fait sur l'ensemble de test, cette part de chance se mêle au chiffre rapporté, et on ne peut plus l'en distinguer après coup.
Les auteurs signalent aussi que des travaux antérieurs avaient remarqué le problème, mais n'y avaient apporté que des corrections partielles. SA-FAS, par exemple, rapporte en plus la moyenne des 10 dernières époques, et certains articles ajoutent des métriques plus proches du déploiement comme le TPR@FPR. Ces pratiques rapprochent les chiffres de la réalité, mais l'ensemble de test reste consulté pendant l'entraînement. À leur connaissance, disent les auteurs, c'est le premier travail consacré spécifiquement à ce biais et qui propose une épreuve de remplacement.
Résoudre le problème
La seule modification consiste à ajouter un jeu de données.
Ce cinquième jeu de données peut s'utiliser de deux façons :
- Comme ensemble de validation : OCIM garde son entraînement et son test, mais l'évaluation de chaque époque se fait sur le nouvel ensemble de validation, qui sert à choisir la meilleure époque ; le HTER n'est calculé qu'une fois sur l'ensemble de test d'origine, à la fin de l'entraînement.
- Comme ensemble de test : le quatrième jeu de données d'origine devient l'ensemble de validation, et le score final se mesure sur le nouveau jeu de données.
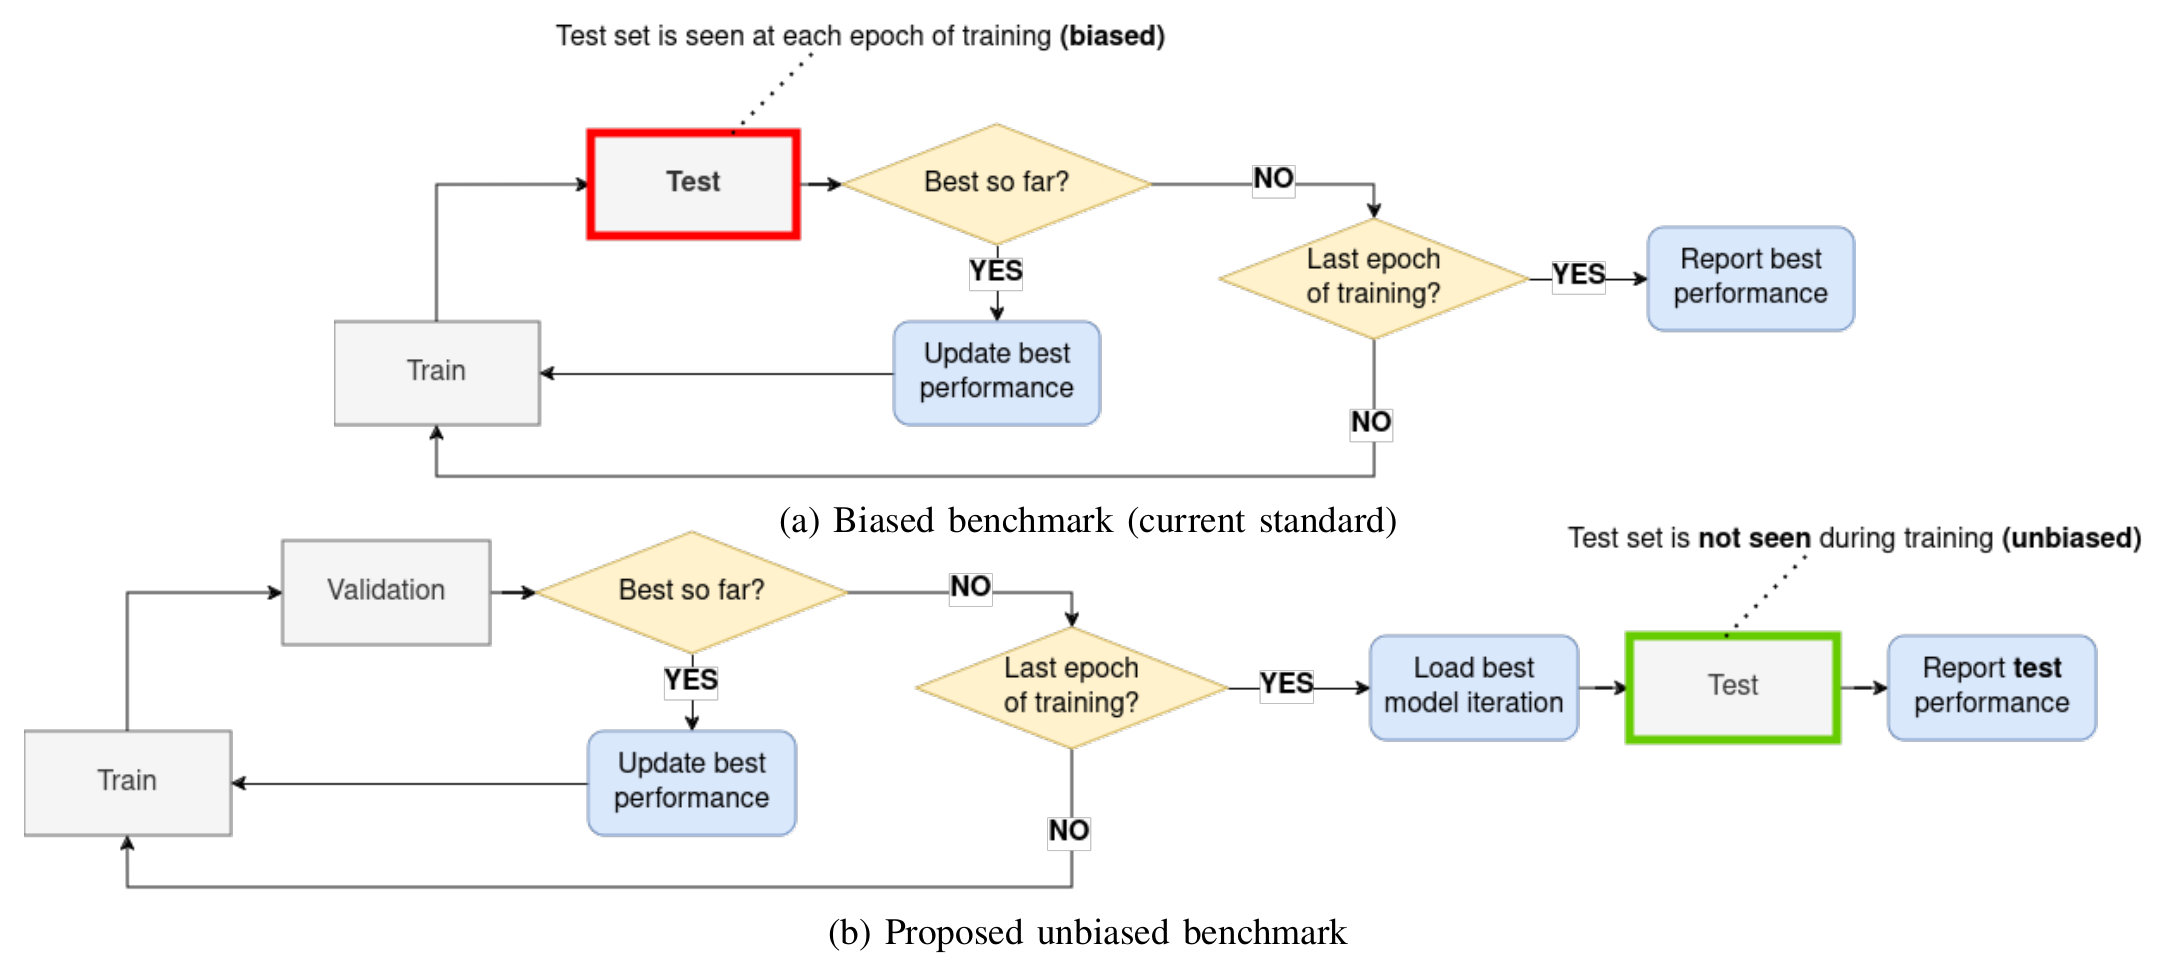
Les deux boucles sont presque identiques ; elles ne diffèrent que par la case qui, dans la boucle, désigne le « meilleur ». En haut, c'est le Test encadré de rouge, consulté à chaque époque ; en bas, c'est Validation, et le Test sort de la boucle pour n'être exécuté qu'une seule fois, à la fin.
Dans les deux cas, l'ensemble de test n'apparaît plus du tout pendant l'entraînement. Les auteurs préfèrent la première façon, car on veut toujours voir les scores sur les quatre jeux de données familiers O, C, I et M.
Comment choisir le cinquième jeu de données ? Les auteurs ont pris en compte quatre critères : le volume de données, les types d'attaques, le nombre de sujets et la variété des échantillons. Ils retiennent finalement deux candidats :
| Jeu de données | Année | Sujets | Vrais | Faux | Types |
|---|---|---|---|---|---|
| CASIA | 2012 | 50 | 150 | 450 | papier, écran |
| Replay | 2012 | 50 | 200 | 1 000 | papier, écran |
| MSU | 2014 | 35 | 70 | 210 | papier, écran |
| Oulu | 2017 | 55 | 720 | 2 880 | papier, écran |
| SiW | 2018 | 165 | 1 320 | 3 300 | papier, écran |
| Rose-Youtu | 2018 | 20 | 897 | 1 601 | papier, écran, masque |
SiW et Rose-Youtu ont une taille comparable à celle d'OULU-NPU, sont plus récents et varient en éclairage, en environnement et en attaques ; SiW varie en outre en pose et en expression. Rose-Youtu comprend des attaques au masque en papier, que les auteurs retirent pour que le test ne porte toujours que sur l'impression et la relecture, sans nouveau type d'attaque.
Côté modèles, les auteurs en retiennent quatre : ResNet-18 et ResNet-50 préentraînés sur ImageNet comme références, plus deux méthodes dont le code est public et dont la réexécution se rapproche des articles d'origine, SA-FAS et GAC-FAS. Les métriques restent le HTER et l'AUC.
Discussion
Réexécuter d'abord l'épreuve d'origine
Les auteurs commencent par réexécuter SA-FAS et GAC-FAS avec l'épreuve d'origine, où l'ensemble de test sert aussi de validation, et testent même les poids fournis par les auteurs de GAC-FAS. Avec le code d'origine et les mêmes données, les chiffres s'écartent pourtant de ceux de l'article d'origine. Sur OCI→M, par exemple, l'article de GAC-FAS annonce 5.00 %, les poids fournis donnent aussi 5.00 %, et un réentraînement donne 7.92 % ; sur OMI→C, les trois chiffres sont 8.20 %, 10.00 % et 12.22 %.
Avec le même code, un simple réentraînement peut donc faire varier le résultat de plusieurs points. Dans la suite, les auteurs comparent toujours leurs propres réexécutions entre elles.
Choisir avec un ensemble de validation
Le résultat principal figure dans la Table III. Voici le cas où SiW sert de validation. À gauche de la flèche, l'épreuve d'origine ; à droite, la validation sur SiW ; l'unité est le HTER (%) :
| Jeu de test | SA-FAS | GAC-FAS |
|---|---|---|
| OULU-NPU | 12.13 → 13.81 | 10.52 → 7.91 |
| Replay-Attack | 9.00 → 21.50 | 5.00 → 8.55 |
| CASIA-FASD | 14.00 → 26.67 | 12.22 → 9.14 |
| MSU-MFSD | 11.43 → 11.43 | 7.92 → 7.31 |
SA-FAS passe de 9.00 % à 21.50 % sur Replay-Attack et de 14.00 % à 26.67 % sur CASIA-FASD, soit à peu près le double ; rien ne change sur MSU-MFSD.
GAC-FAS fait exactement l'inverse : trois tests sur quatre s'améliorent, et les 7.91 % sur ICM→O sont même inférieurs aux 8.60 % annoncés dans son article d'origine. Les auteurs classent ce point parmi les découvertes inattendues, sans en analyser la cause. On peut au moins en retenir qu'avec une autre épreuve, les chiffres d'une même méthode ne bougent pas forcément dans le même sens.
Les deux références ResNet n'évoluent pas non plus de la même façon. Avec la validation sur SiW, ResNet-18 se dégrade sur les quatre tests, par exemple de 31.50 % à 37.50 % sur OCM→I ; ResNet-50 s'améliore au contraire sur deux tests, de 32.08 % à 25.42 % sur OCI→M et de 33.33 % à 32.78 % sur ICM→O, et les auteurs le citent avec GAC-FAS parmi les cas qui s'améliorent.
L'ensemble de validation se choisit aussi
Avec Rose-Youtu comme ensemble de validation, tous les modèles se dégradent en général. Par exemple, SA-FAS sur OMI→C obtient 26.67 % avec la validation sur SiW et 40.67 % avec la validation sur Rose-Youtu. Même chose quand Rose-Youtu sert d'ensemble de test : il est bien plus difficile que SiW. Avec O, C et I pour l'entraînement et MSU-MFSD pour la validation, le test final sur SiW donne un HTER de 10.05 % pour SA-FAS et de 9.58 % pour GAC-FAS ; sur Rose-Youtu, on passe à 25.18 % et 32.74 %. Les deux mêmes modèles restent à peu près utilisables sur un nouveau jeu de données, mais sur un autre, le HTER grimpe au-delà de 25 %.
Les auteurs examinent aussi l'EER sur l'ensemble de validation et le HTER sur l'ensemble de test. En général, le score de validation est meilleur que celui de test, ce qui concorde, selon les auteurs, avec la littérature en apprentissage automatique. Les expériences validées sur Rose-Youtu montrent la tendance inverse ; les auteurs y voient l'effet probable d'un écart de domaine entre données de validation et de test, et en tirent l'hypothèse que le domaine de SiW est plus proche que celui de Rose-Youtu des quatre jeux de test.
Cela soulève une nouvelle question. L'ensemble de test reste sous enveloppe, mais le choix du jeu de données de validation modifie lui aussi l'époque retenue et le score final. Les auteurs recommandent d'essayer les deux ; si l'on ne peut faire qu'une seule configuration, prendre SiW comme validation, avec les quatre tests ICM→S→O, OCM→S→I, OCI→S→M et OMI→S→C.
Sur des données collectées hors laboratoire
Enfin, les auteurs testent sur WFAS les modèles SA-FAS et GAC-FAS entraînés sur OCIM. WFAS est un jeu de données construit par collecte sur Internet, avec 1 383 246 images, 469 920 personnes et 17 types d'attaques, soit environ 300 fois la taille de SiW. Les étiquettes de son ensemble de test ne sont pas publiques ; on ne peut obtenir l'APCER, le BPCER et l'ACER que via la plateforme de la compétition.
Les deux méthodes obtiennent un ACER compris entre 28.62 % et 32.54 %, et chacune l'emporte sur deux tests. Le vainqueur de la compétition WFAS obtient 2.82 %. Les auteurs entraînent aussi GAC-FAS directement sur l'ensemble d'entraînement de WFAS et prennent le modèle de la dernière itération : son ACER est de 21.51 %.
WFAS contient beaucoup de types d'attaques absents d'OCIM ; ce test mesure à la fois la généralisation à de nouveaux jeux de données et à de nouveaux types d'attaques, ce qui n'était pas le problème visé par ces méthodes à leur conception. C'est pourtant exactement la situation que l'on rencontre en déploiement.
Conclusion
Le problème que traite l'article est très clair. La convention OCIM laisse consulter l'ensemble de test à répétition pendant l'entraînement, et les chiffres rapportés sont meilleurs que ce qu'on obtient réellement en déploiement. La correction des auteurs est tout aussi simple, avec un jeu de données de plus comme ensemble de validation et un ensemble de test regardé seulement à la fin de l'entraînement.
D'après les expériences, l'ampleur du biais dépend de la méthode. Le HTER de SA-FAS double à peu près sur deux tests, tandis que GAC-FAS s'améliore le plus souvent. Le classement « qui est le meilleur » peut donc lui-même changer avec l'épreuve. Le choix de l'ensemble de validation influe aussi sur les résultats : SiW et Rose-Youtu donnent des chiffres très différents.
Les limites sont à garder en tête. C'est un travail en cours, qui ne réexécute que deux méthodes de généralisation de domaine et deux références ResNet ; l'article ne précise pas combien de graines aléatoires ont été utilisées par expérience, et les réexécutions elles-mêmes s'écartent des articles d'origine. Les auteurs indiquent dans l'article l'emplacement du code et précisent qu'il sera rendu public après la publication.
Pour qui doit mettre un modèle en production, en revanche, la démarche s'applique telle quelle à son propre processus d'évaluation : choisir l'époque et le seuil sur des données qui ne sont pas l'ensemble de test, et n'ouvrir l'ensemble de test qu'à la toute fin.