原始論文
Object-Centric Learning with Slot Attention
- 發表版本
- NeurIPS 2020會議
- arXiv 首次提交
- arXiv:2006.15055
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingslotattention2020,
  title = {{Object-Centric Learning with Slot Attention}},
  author = {Francesco Locatello and Dirk Weissenborn and Thomas Unterthiner and Aravindh Mahendran and Georg Heigold and Jakob Uszkoreit and Alexey Dosovitskiy and Thomas Kipf},
  year = {2020},
  eprint = {2006.15055},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2006.15055}
}
這篇不是追蹤論文。
它出現在這個系列裡,是因為後面有人拿它來做多目標追蹤。在那之前,得先弄懂它在做什麼。
2020 年,Google Brain 的一個團隊提出了 Slot Attention。作者名單裡,通訊作者 Thomas Kipf 是 GCN 的作者,指導者之一 Alexey Dosovitskiy 幾個月後發表了 ViT。同一年,DETR 用一組物件查詢把偵測改寫成集合預測,TrackFormer、MOTR 後來又把物件查詢變成了軌跡查詢。Slot Attention 做的事情和 DETR 有幾分相似,出發點卻完全不同,它不給任何標註,讓模型自己把畫面拆成一個一個物體。
定義問題
卷積網路抽出來的特徵圖,是一種「分散式」的表示。特徵圖上的每個位置,都混著這個位置附近所有東西的資訊;整張圖裡有幾個物體、各自在哪裡,並沒有被明確地分開來。
很多需要推理的任務,卻希望輸入是一組一組的物體,例如這裡有一個紅色立方體、那裡有一個綠色圓柱。物理模擬、多智能體、視覺推理,都是以物體為單位在運作。作者把這種表示稱為物件中心(object-centric)的表示。
問題是,要從原始影像得到它很難,通常要靠監督,或是為特定任務設計的架構。所以很多研究乾脆跳過這一步,直接拿模擬器或遊戲引擎裡的物體狀態來用。
既有的幾種作法各有毛病:
- IODINE、MONet 這類無監督的場景分解模型,要反覆「解碼、和原圖比對、再編碼」好幾輪,訓練很慢。
- 膠囊網路的每個膠囊會特化成某一類物體,換一種沒見過的組合就泛化不了。
- DETR、Set Transformer 這類集合預測方法,每個查詢都有自己的一組可學習參數。訓練時用 100 個查詢,測試時就只能是 100 個。
作者想要一個可以直接接在卷積網路後面的模組。它輸入 個特徵向量,輸出 個「slot」,每個 slot 描述一個物體;而且每個 slot 都長得一樣,任何一個都能綁定任何一個物體,數量也能在測試時改變。
解決問題
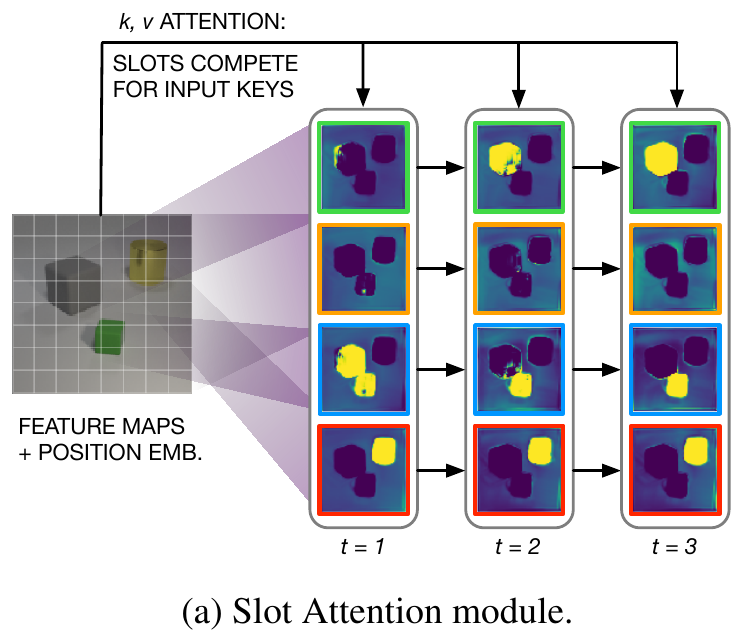
這張圖要從左往右看。左邊的特徵圖是輸入,右邊是四個 slot 在三輪迭代中各自在看哪裡。一開始大家都看得很模糊,越到後面,每個 slot 就越專注在一個物體上。
一輪迭代
一開始, 個 slot 從同一個高斯分布隨機抽樣:
和 是所有 slot 共用的可學習參數。slot 數量可以在測試時改變,原因就在這裡,要幾個就抽幾個。
接著重複 次(論文用 )。每一輪先用三個線性投影,把輸入變成鍵 、值 ,把 slot 變成查詢 ,算出點積注意力的分數:
一般的注意力,是對每個查詢在輸入這個方向做 softmax;Slot Attention 反過來,對每個輸入在 slot 這個方向做 softmax:
也就是說,每一個輸入特徵,都要把自己的 1 分配給 個 slot。
接著,每個 slot 把分到的輸入取加權平均,作為更新的內容:
最後用一個 GRU,以上一輪的 slot 為狀態、這一輪的更新為輸入,算出新的 slot,再接一個可有可無的殘差 MLP。輸入和 slot 在每一輪開頭都會先做 LayerNorm。
算一次看看
我們用 4 個輸入、2 個 slot 走一遍。假設算出來的分數 是:
| slot 1 | slot 2 | |
|---|---|---|
| 輸入 1 | 2.0 | 0.0 |
| 輸入 2 | 1.5 | 0.5 |
| 輸入 3 | 0.0 | 1.8 |
| 輸入 4 | 0.2 | 2.2 |
對每一列做 softmax,每個輸入把自己分給兩個 slot:
| slot 1 | slot 2 | |
|---|---|---|
| 輸入 1 | 0.881 | 0.119 |
| 輸入 2 | 0.731 | 0.269 |
| 輸入 3 | 0.142 | 0.858 |
| 輸入 4 | 0.119 | 0.881 |
slot 1 主要拿到輸入 1、2,slot 2 主要拿到輸入 3、4。再對每一欄做正規化,slot 1 的加權平均權重是 0.470、0.390、0.076、0.064,slot 2 是 0.056、0.126、0.403、0.414。兩個 slot 就像兩個聚類中心,各自分走了一群輸入。
為什麼要反過來做 softmax?假設兩個 slot 剛好長得一樣,查詢相同,分數的兩欄都是 2.0、1.5、0.0、0.2。
- 用一般的注意力,對輸入做 softmax,兩個 slot 會得到一模一樣的權重 0.524、0.318、0.071、0.087,兩個都盯著輸入 1、2,沒有人去管輸入 3、4。
- 用 Slot Attention 的作法,每個輸入在兩個 slot 之間平分,各拿 0.5。誰也搶不走誰的,輸入 3、4 也一定有人分到。
每個輸入都必須被分給某個 slot,slot 之間於是有了競爭:一個 slot 想多拿一點,別的 slot 就得少拿一點。經過 GRU 更新、再進入下一輪,原本微小的差異會被放大,最後各自鎖定一個物體。作者在附錄的消融也驗證了這點,把 softmax 改回對輸入做,兩個任務的表現都明顯變差。
至於為什麼用加權平均、不用加權和?因為分數是對 slot 正規化的,每個 slot 拿到的總量並不固定,上例是 1.873 和 2.127,一個沒分到物體的 slot 可能趨近於 0。用加權和,更新的大小會跟著忽大忽小;用平均,訓練才穩定。
整個模組的計算量是 。
對稱性
作者證明了 Slot Attention 有兩個性質:對輸入的順序不變,對 slot 的順序等變。打亂輸入,輸出不變;打亂初始 slot 的順序,輸出也只是跟著打亂。
這保證了每個 slot 都用同一種格式表示物體,不會有「1 號 slot 專門負責立方體」這種事。DETR 的物件查詢則不同,每個查詢有自己的參數,訓練久了常會各自偏好某些位置或大小。
兩種用法
無監督的物件發現。 把 Slot Attention 放進一個自編碼器。編碼器是卷積網路加上位置嵌入,再接 Slot Attention;解碼器把每個 slot 各自展開成一張圖,輸出 RGB 和一張遮罩。所有 slot 的遮罩在 slot 之間做 softmax,當作混合權重,把各自的圖合成一張,和原圖比較重建誤差。整個過程不需要任何標註。
有監督的集合預測。 編碼器一樣,每個 slot 接一個共用的 MLP,預測物體的屬性。預測和標籤的順序都是任意的,所以用匈牙利演算法配對,和 DETR 的作法相同。
討論
物件發現
作者在三個合成資料集上評估:CLEVR6(最多 6 個物體的 CLEVR 立體場景)、Multi-dSprites(彩色的 2D 形狀)和 Tetrominoes(俄羅斯方塊)。指標是 ARI,衡量分割結果和真實物體的吻合程度,排除背景,100 是完美。
| 方法 | CLEVR6 | Multi-dSprites | Tetrominoes |
|---|---|---|---|
| Slot Attention | 98.8 | 91.3 | 99.5 |
| IODINE | 98.8 | 76.7 | 99.2 |
| MONet | 96.2 | 90.4 | — |
| Slot MLP | 60.4 | 60.3 | 25.1 |
整理自原論文 Table 1,ARI(%),五個隨機種子的平均。Tetrominoes 排除了一次失敗的訓練。
Slot MLP 是把 Slot Attention 換成一個 MLP 的基準,輸出的 slot 有固定順序。它的分數低得多,說明「每個 slot 格式相同、可以綁定任何物體」這個設計是必要的。
Slot Attention 和 IODINE 打平或更好,真正的差距在效率。在 CLEVR6 上,一張 16 GB 的 V100 可以用 64 的批次大小,IODINE 只能用 4;8 張 V100 訓練約 24 小時,IODINE 要大約 7 天。
作者也坦白了一個失敗模式。在 Tetrominoes 上,偶爾會有一次訓練卡在把畫面切成橫條紋的解,五次裡有一次。這種情況重建誤差明顯偏高,訓練時就看得出來;表上的分數排除了這一次。
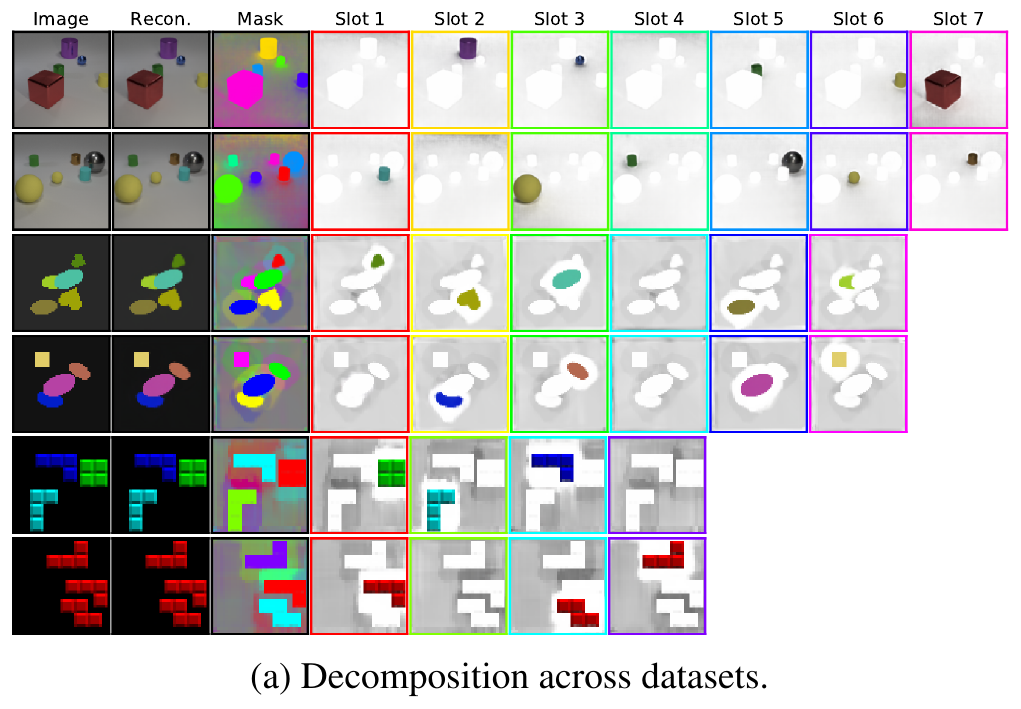
從這張圖可以看到,slot 比物體多的時候,多出來的 slot 會保持空白,只分到一點背景。作者也觀察到,均勻的背景常常被分散到所有 slot,而不是集中在其中一個;這不影響物體的分離和重建。
如果把每一輪迭代的注意力畫出來,第二輪時各個 slot 就已經開始專注在單一物體上,第一輪則還會把幾個物體混在同一個 slot 裡。
比訓練時更多的迭代、更多的物體
訓練時用 3 輪迭代,測試時增加到 7 輪,分數還會繼續上升。用 CLEVR6 訓練、在最多 10 個物體的 CLEVR10 上測試,把 slot 從 7 個增加到 11 個,分割的表現仍然很好。這正是共用初始分布帶來的好處,DETR 那種每個查詢各有參數的設計做不到。
為了確認它不只是靠顏色在分群,作者也試了只看形狀的版本。在黑底白色的二值化 Multi-dSprites 上,ARI 是 69.4,IODINE 是 64.8;在灰階的 CLEVR6 上是 98.5。
集合預測
在 CLEVR10 上預測每個物體的形狀、材質、顏色、大小和位置,以 AP 衡量。Slot Attention 和先前的 DSPN 相當或更好,而 DSPN 用的是更深的 ResNet-34 編碼器。增加測試時的迭代次數同樣有幫助;用 6 個物體的場景訓練、在更多物體的場景測試,AP 只會緩慢下降。
這個任務只訓練模型預測屬性,從沒給過任何分割的標註,但 slot 的注意力圖卻自然地把物體分開了,ARI 達到 78.0。
消融與限制
附錄的消融裡,幾個設計都證明有用。加權平均比加權和穩定;位置嵌入對預測物體位置不可或缺;所有 slot 共用初始分布,在無監督任務上比每個 slot 各自一組參數好,也才能在測試時增加 slot;至少要迭代兩輪以上。slot 的數量只需要給一個大致的上限,不必剛好等於物體數。
作者也說明了限制。所有實驗都在受控的合成資料上進行;物件發現用的解碼器和重建損失和 IODINE 相同,預期遇到複雜的背景和紋理時一樣會吃力,可能需要換成感知損失或對比損失。
結論
Slot Attention 用一個很小的改動,把注意力的 softmax 從輸入那一側換到 slot 那一側,讓一組長得一樣的 slot 互相競爭,最後各自認領畫面中的一個物體。加上共用的初始分布和 GRU 更新,它不用標註就能把合成場景分解成物體,訓練比 IODINE 快好幾倍,slot 的數量和迭代次數都能在測試時調整。
作者在結論裡列出的第一個下一步,就是把它用在影片上。一年多後,同樣出自 Kipf 等人的 SAVi 把 slot 延伸到影片,讓上一幀的 slot 成為下一幀的初始值,同一個物體就能跨幀被同一個 slot 抓住。這聽起來已經很像追蹤了。
再過一年多,有人把這套物件中心的作法,正式帶進了多目標追蹤。