原始論文
Iterative Scale-Up ExpansionIoU and Deep Features Association for Multi-Object Tracking in Sports
- 發表版本
- WACV Workshops 2024研討會(Workshop)
- arXiv 首次提交
- arXiv:2306.13074
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{multiobjecttrackingdeepeiou2023,
  title = {{Iterative Scale-Up ExpansionIoU and Deep Features Association for Multi-Object Tracking in Sports}},
  author = {Hsiang-Wei Huang and Cheng-Yen Yang and Jiacheng Sun and Pyong-Kun Kim and Kwang-Ju Kim and Kyoungoh Lee and Chung-I Huang and Jenq-Neng Hwang},
  year = {2023},
  eprint = {2306.13074},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2306.13074}
}
SportsMOT 那篇有一張消融表很讓人在意。同樣是用 IoU 關聯,先用卡爾曼濾波預測位置的版本,HOTA 是 64.1;不預測、直接拿軌跡上一幀的框去比,反而是 71.5。
如果預測只會幫倒忙,那何必預測?
華盛頓大學 Jenq-Neng Hwang 實驗室的 Hsiang-Wei Huang、Cheng-Yen Yang、Jiacheng Sun,和韓國電子通信研究院(ETRI)、臺灣國家高速網路與計算中心的合作者,提出了 Deep-EIoU。它把卡爾曼濾波整個拿掉,改用一個撐得很大的框來找人,再加上外觀特徵分辨是誰。
這個方法在 SportsMOT 上拿到 77.2 的 HOTA,比 SportsMOT 論文裡最好的方法高出 3 分。
定義問題
作者列出運動場景難追的三個原因:
- 遮擋嚴重。 比賽的對抗很激烈,球員常常擠成一團、互相擋住,比行人追蹤嚴重得多。
- 外觀相似。 同一隊的球員穿一樣顏色的球衣。
- 動作無法預測。 籃球的胯下運球、足球的鏟球、排球的扣殺,速度和方向都會在一瞬間改變。
主流的追蹤器,不管是融合外觀和運動的,還是只靠運動的,大多以卡爾曼濾波預測位置。卡爾曼濾波假設線性運動和高斯雜訊,物體的運動一旦不符合,預測就會偏。OC-SORT 試著修補卡爾曼濾波;C-BIoU 用平均位移取代它,再把框撐大來彌補估計誤差。
Deep-EIoU 更進一步,連運動估計都不做了。
解決問題
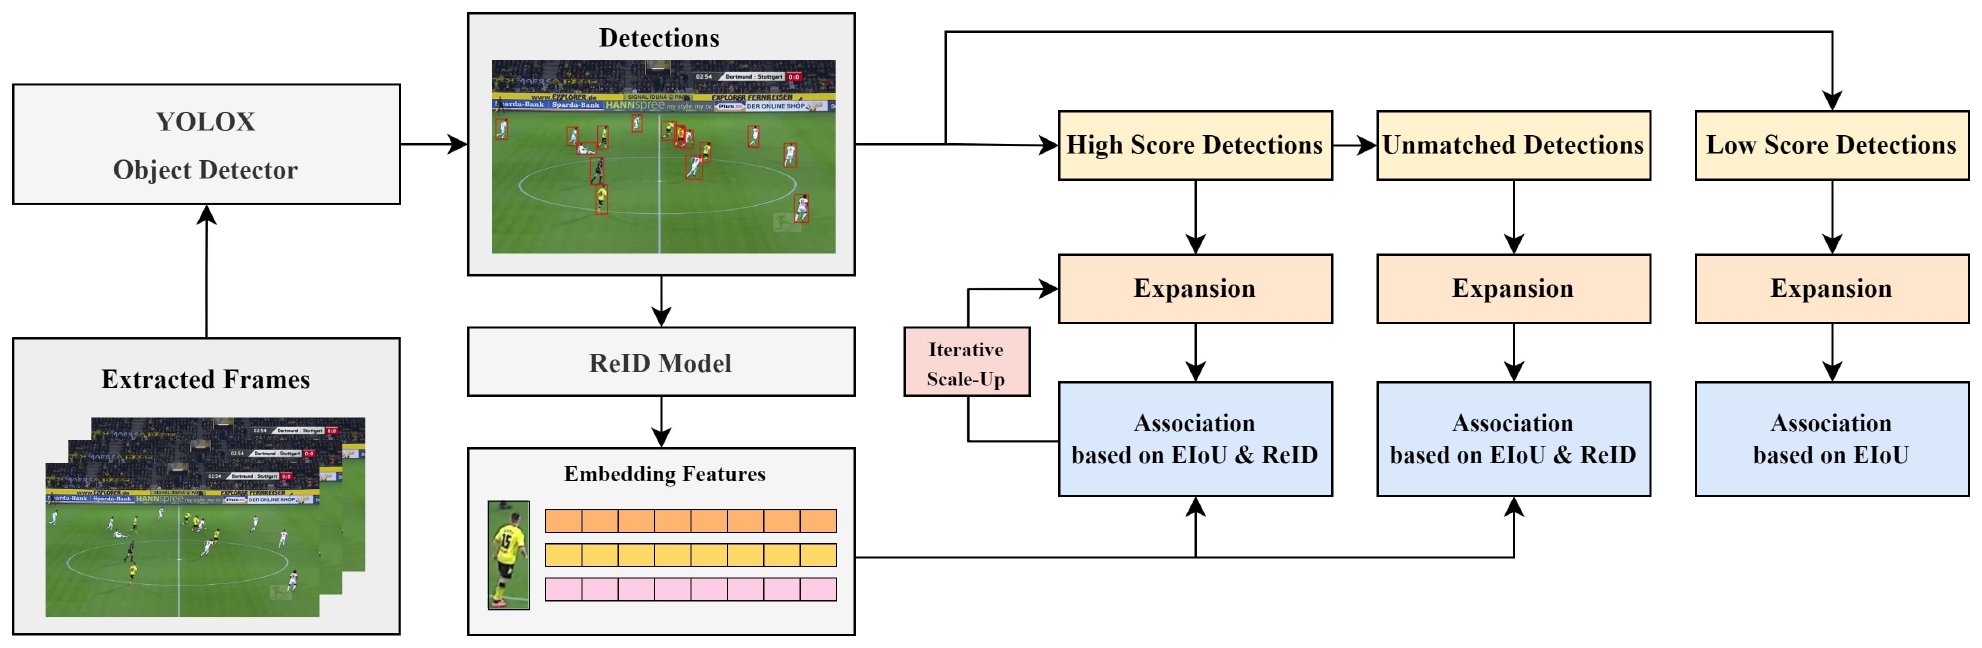
整體仍是先偵測、再關聯的架構,只用過去和現在的資訊,可以線上執行。每一幀先用 YOLOX 偵測球員,再用 ReID 模型抽出每個框的外觀特徵,接著算出軌跡和偵測之間的成本,交給匈牙利演算法配對。
和一般追蹤器最大的差別,在於軌跡用來比對的那個框。Deep-EIoU 不預測軌跡這一幀會在哪裡,直接拿軌跡最後一次被看到的框,和新的偵測比。
撐得很大的框
位置的部分,用的是擴張 IoU(ExpansionIoU,EIoU)。作者說明這個想法來自 C-BIoU,但他們發現,在運動員身上,框要撐得更大才好。
擴張由比例 控制。一個寬 、高 的框,擴張長度是
這個長度再分成兩半,加到框的兩側:左上角往外移 ,右下角也一樣。所以擴張後的框,寬和高都是原本的 倍。官方程式的寫法和這個定義一致。
預設的 ,框的寬高就變成原本的 3.4 倍,面積將近 12 倍。換算成 C-BIoU 的寫法,相當於緩衝比例 1.2;C-BIoU 在 DanceTrack 上最好的緩衝只有 0.3 到 0.4。
我們沿用 C-BIoU 筆記裡的例子比較。一個寬 40、高 100 像素的球員,下一幀往右移了 50 像素,原本的 IoU 是 0:
| 擴張後的框 | 同一人(50 px) | 鄰居(70 px) | 鄰居(100 px) | |
|---|---|---|---|---|
| C-BIoU() | 64 × 160 | 0.12 | 0 | 0 |
| Deep-EIoU() | 136 × 340 | 0.46 | 0.32 | 0.15 |
本文整理的算例,兩個框大小相同、高度對齊。
擴到這麼大,球員就算瞬間移動了一個多身寬,也還找得到。代價也很明顯,左右三個身寬以內的人,全都變成了候選人。這時就得靠外觀把人分開。
外觀和位置怎麼合起來
外觀的成本是軌跡和偵測特徵向量的餘弦距離:
很多方法會把外觀成本和 IoU 成本加權相加,作者沒有這樣做,而是採用 BoT-SORT 的作法。先調整外觀成本,如果 或 ,調整後的外觀成本 ;否則 。第一階段的成本再取兩者中較小的那個:
這裡 、。
外觀要能派上用場,兩者得長得夠像,位置也要夠近(EIoU 至少 0.5)。只要有一項不滿足,外觀成本就設成 1,等於不參考外觀;兩項都滿足時,外觀成本再打對折。最後在外觀和位置的成本裡取比較小的那個。
所以外觀只能讓本來就靠得近的配對「更確定」,不能把兩個離得遠、只是長得像的人硬湊在一起。這在同隊球員球衣都一樣的情況下特別重要。
先配有把握的
配對沿用 ByteTrack 的分層。信心分數至少 0.6 的高分偵測,通常比較少被遮住,外觀特徵也比較可靠,所以先拿高分偵測和軌跡配對,用的就是上面結合外觀和 EIoU 的成本;信心在 0.1 到 0.6 之間的低分偵測,第二輪只用 EIoU 和剩下的軌跡配;低於 0.1 的直接丟掉。
另外,作者拿掉了一般追蹤器對框的長寬比限制,因為球員可能倒在地上,不像行人大多是站著走路。遺失的軌跡保留 60 幀,比行人追蹤常用的 30 幀長,因為球場上的遮擋更嚴重。
逐步放大,不必調參
C-BIoU 的消融已經顯示,緩衝比例是一個敏感的超參數。作者指出,實際的運動員追蹤系統很難調它:系統要線上即時運作,沒辦法事後反覆實驗;真實場景也拿不到測試資料的真值,根本無從找起。
於是他們不找最佳的 ,而是在高分偵測的配對階段,讓 從小到大逐步增加,重複配對:
從 0 開始。第一輪用 ,把重疊最多、最有把握的配對先配好;沒配上的,下一輪用大一點的框再找。預設 、步長 ,共兩輪,也就是 0.7 和 0.8。
討論
SportsMOT
偵測器是 YOLOX-X,從 COCO 預訓練權重開始,在 SportsMOT 的訓練集和驗證集上微調 80 個 epoch。ReID 模型用 OSNet,從行人重識別資料集 Market-1501 的權重開始,再用 SportsMOT 真值框裁出的 31,279 張球員圖微調。
| 方法 | 訓練資料 | HOTA | AssA | DetA | IDF1 |
|---|---|---|---|---|---|
| BoT-SORT | 訓練集 | 68.7 | 55.9 | 84.4 | 70.0 |
| OC-SORT | 訓練集 | 71.9 | 59.8 | 86.4 | 72.2 |
| Deep-EIoU | 訓練集 | 74.1 | 63.1 | 87.2 | 75.0 |
| OC-SORT | 訓練+驗證 | 73.7 | 61.5 | 88.5 | 74.0 |
| MixSort-OC | 訓練+驗證 | 74.1 | 62.0 | 88.5 | 74.4 |
| Deep-EIoU | 訓練+驗證 | 77.2 | 67.7 | 88.2 | 79.8 |
整理自原論文 Table 2,SportsMOT 測試集。BoT-SORT 以官方程式重跑,其他基準數字取自 SportsMOT 論文。
用同樣的訓練資料比,Deep-EIoU 在兩種設定下都是最好的。訓練加驗證集時,HOTA 比 MixSort-OC 高 3.1 分,關聯的 AssA 高 5.7 分;偵測的 DetA 則差不多,甚至略低。差距幾乎全部來自關聯。
SoccerNet
SoccerNet-Tracking 有 201 段足球影片,每段 30 秒,要追的不只是球員,還有守門員、裁判和球。為了只比追蹤,所有方法都直接使用資料集提供的真值框。
Deep-EIoU 的 HOTA 是 85.4,第二名的 OC-SORT 是 78.1,BoT-SORT 是 77.0,ByteTrack 和 DeepSORT 只有 71.5 和 69.6。
每個零件的貢獻
| 設定 | HOTA |
|---|---|
| 基準(只有 EIoU) | 71.4 |
| +外觀(ReID) | 75.3 |
| +逐步放大 | 77.2 |
| +線性插值 | 77.2 |
整理自原論文 Table 4,SportsMOT 測試集。
- 外觀貢獻最多,3.9 分。 雖然同隊球員長得很像,外觀仍是重要的線索。這和 SportsMOT 論文「相似但可分辨」的結論一致。
- 逐步放大再加 1.9 分。 作者也說明,這一步同時把遺失軌跡的保留時間從 30 幀加長到 60 幀,所以這 1.9 分是兩者合起來的效果。
- 線性插值幾乎沒有影響,多不到 0.1 分。
只用 EIoU、沒有外觀的基準是 71.4,和 SportsMOT 論文裡「不用卡爾曼的 IoU」那一列(71.5)很接近。兩篇的偵測器訓練方式不同,只能粗略對照;從這組數字來看,單靠把框撐大,並沒有比不預測的 IoU 好多少;Deep-EIoU 多出來的分數,主要來自外觀和逐步放大。
擴張比例真的不用調嗎
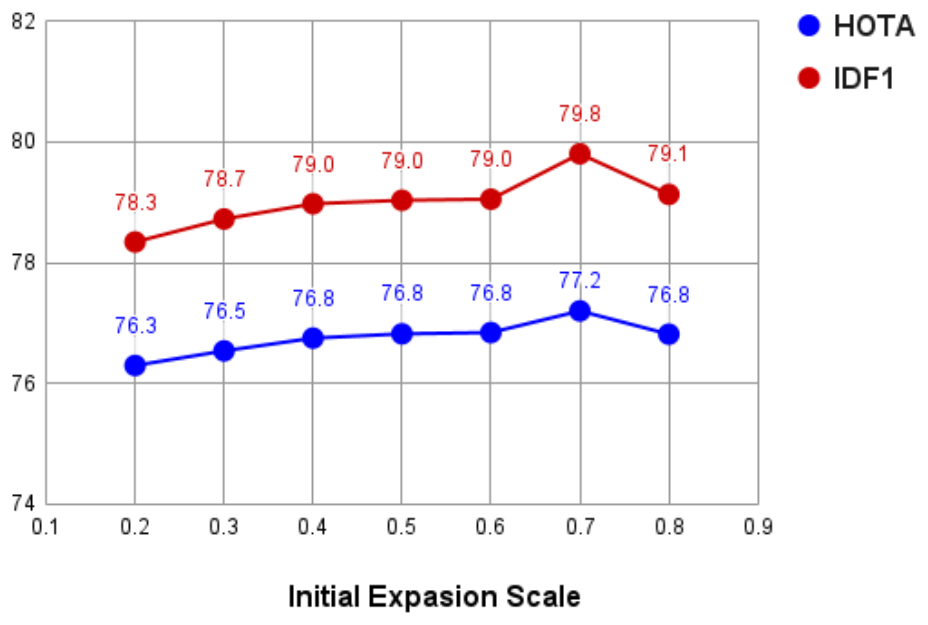
作者把初始擴張比例從 0.2 改到 0.8,其他設定不變。HOTA 都在 76.3 到 77.2 之間,全部高於先前最好的 74.1。作者據此認為,逐步放大讓這個方法不需要調參。
這張圖也可以換個角度讀。初始比例 0.2 時,兩輪的擴張是 0.2 和 0.3,框的寬高放大到 2.4 到 2.6 倍;調到 0.7,放大到 3.4 到 3.6 倍,HOTA 也只多 0.9 分。在這個範圍內,擴多大其實影響不大。
不過圖上最小的擴張也有 2.4 倍,已經比 C-BIoU 的設定大。作者說「比 C-BIoU 擴得更大明顯更好」,這張圖並沒有直接比較到;真正讓 Deep-EIoU 拉開距離的,從消融表看,還是外觀和逐步放大。
EIoU 也能幫卡爾曼濾波
最後,作者把 EIoU 直接放進兩個以卡爾曼濾波為基礎的追蹤器,預測框和偵測框都先擴張再算 IoU。ByteTrack 的 HOTA 從 62.8 升到 67.5,BoT-SORT 從 68.7 升到 71.3。
所以 EIoU 不只適用於不預測的追蹤器,也可以當作一個隨插即用的小技巧。但即使加了 EIoU,這兩個卡爾曼追蹤器仍然輸給什麼都不預測的 Deep-EIoU。
限制
作者在論文裡列了兩個限制:
- 沒有離線的軌跡修正。 球員離開畫面再回來,線上追蹤器很難認回來。作者提到可以加上後處理或更強的記憶機制,但這篇沒有做。
- 速度。 加上偵測器和 ReID 模型,整套流程在一張 RTX 4080 上約每秒 14.6 幀,比只看運動的追蹤器慢;換成更輕量的偵測器和 ReID 模型,可以加快。
結論
Deep-EIoU 在運動場景做了一個大膽的選擇。它不預測球員下一幀會在哪裡,只拿最後一次看到的位置,把框撐到 3.4 倍大去找人,再用外觀把撐大後湧進來的候選人篩掉。外觀只能讓已經夠近的配對更確定,不能把遠處長得像的人拉過來;擴張比例則從小到大試兩輪,省去調參。
消融顯示,三個設計裡貢獻最大的是外觀,其次是逐步放大。只用 EIoU 的基準,和 SportsMOT 論文裡不預測的 IoU 相去不遠。
2025 年的一篇多目標追蹤綜述,把 Deep-EIoU 描述為 C-BIoU 的推廣,從固定兩段擴張變成逐步放大,並在 SportsMOT 的比較表上列為第二,只輸給綜述作者自己的方法。綜述也提醒,Deep-EIoU 只在 SportsMOT 和 SoccerNet 上評測過。
至於論文自己承認的第一個限制,球員出畫面再回來認不得,同一個實驗室在一年多後用 GTA 回答了。