原始論文
Linear Mode Connectivity and the Lottery Ticket Hypothesis
- 發表版本
- ICML 2020會議
- arXiv 首次提交
- arXiv:1912.05671
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmerginglinearmodeconnectivity2019,
  title = {{Linear Mode Connectivity and the Lottery Ticket Hypothesis}},
  author = {Jonathan Frankle and Gintare Karolina Dziugaite and Daniel M. Roy and Michael Carbin},
  year = {2019},
  eprint = {1912.05671},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1912.05671}
}
固定網路的初始權重、固定超參數,訓練兩次,結果還是會不一樣。每個 epoch 的資料順序不同,資料增強抽到的裁切、翻轉也不同;這些隨機性,論文統稱為 SGD 雜訊。
MIT 的 Jonathan Frankle、Element AI 的 Gintare Karolina Dziugaite、多倫多大學與 Vector Institute 的 Daniel Roy,以及 MIT 的 Michael Carbin,想知道這些雜訊到底改變了多少。兩次訓練的結果,是同一個解的兩種近似,還是落進了兩個不同的谷?
Frankle 和 Carbin 在 2018 年提出彩票假說(lottery ticket hypothesis),在小網路上找到一些很稀疏、從初始化就能單獨訓練到全精度的子網路,換到 ImageNet 這種規模卻找不到。這篇論文的另一半,就是用同一套工具去解釋這件事。
定義問題
作者提出的工具叫不穩定性分析(instability analysis)。
取一個網路 的某個狀態 ,可能是隨機初始化的 ,也可能是訓練了 步的 。把它複製兩份,用不同的 SGD 雜訊各自訓練到結束,得到 和 。再拿一個函數比較這兩組權重。
比較的方法是沿直線混合兩者:
是錯誤率。沿線最高的錯誤率,減去兩個端點錯誤率的平均,就是這條線上的「錯誤障礙高度」:
障礙高度接近 0,就說兩者線性模式連通(linear mode connectivity),這個網路狀態對 SGD 雜訊是穩定的。作者用 2% 當門檻, 取 30 個等距的值,每個設定跑三個初始化、每個初始化三種資料順序,一共九組平均。
假設兩個終點的錯誤率是 8% 和 10%,沿線最高是 45%,障礙就是 個百分點。若最高只有 10%,障礙是 1 個百分點,就落在作者的穩定門檻內。這個定義會把端點本來的誤差算進去,所以比較時不能只看中點有多高,也要看兩端有多好。
此外,30 個位置是實驗中的離散近似。這裡量的是分類錯誤率,和交叉熵的損失障礙有關,卻是不同指標;預測類別相同,信心仍可能不同。下文的「穩定」都沿用這個量測與門檻。
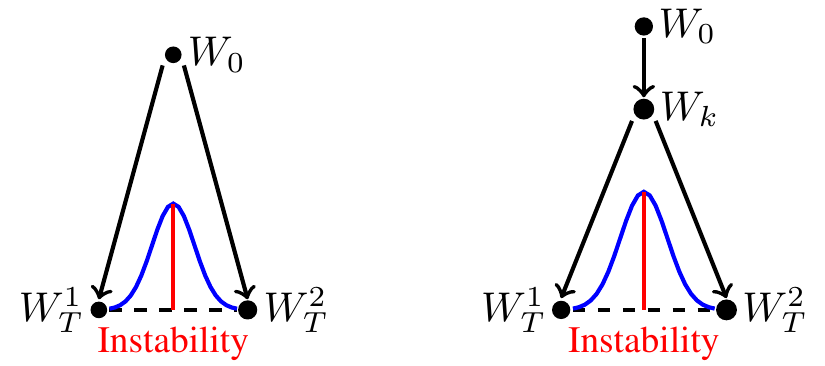
左圖從初始化就分岔,右圖先一起走 步再分岔。只要把 從 0 一路往後掃,就能看出網路從哪一步開始「定下來」。
解決問題
從初始化就分岔
作者測了五個網路,MNIST 上的 LeNet、CIFAR-10 上的 ResNet-20 與 VGG-16、ImageNet 上的 ResNet-50 與 Inception-v3;CIFAR 的兩個網路另外還有學習率較低、以及加上暖身的變體。
從 就複製,除了 LeNet,其他網路全都不穩定。沿直線混合兩份訓練結果,訓練與測試錯誤率都升到隨機猜測的程度。LeNet 的錯誤率也有上升,但不到一個百分點。
同一個初始化,只是資料順序和增強不同,最後就落進了兩個直線不通的谷。對大一點的網路來說,初始權重相同還不夠。
掃過 k
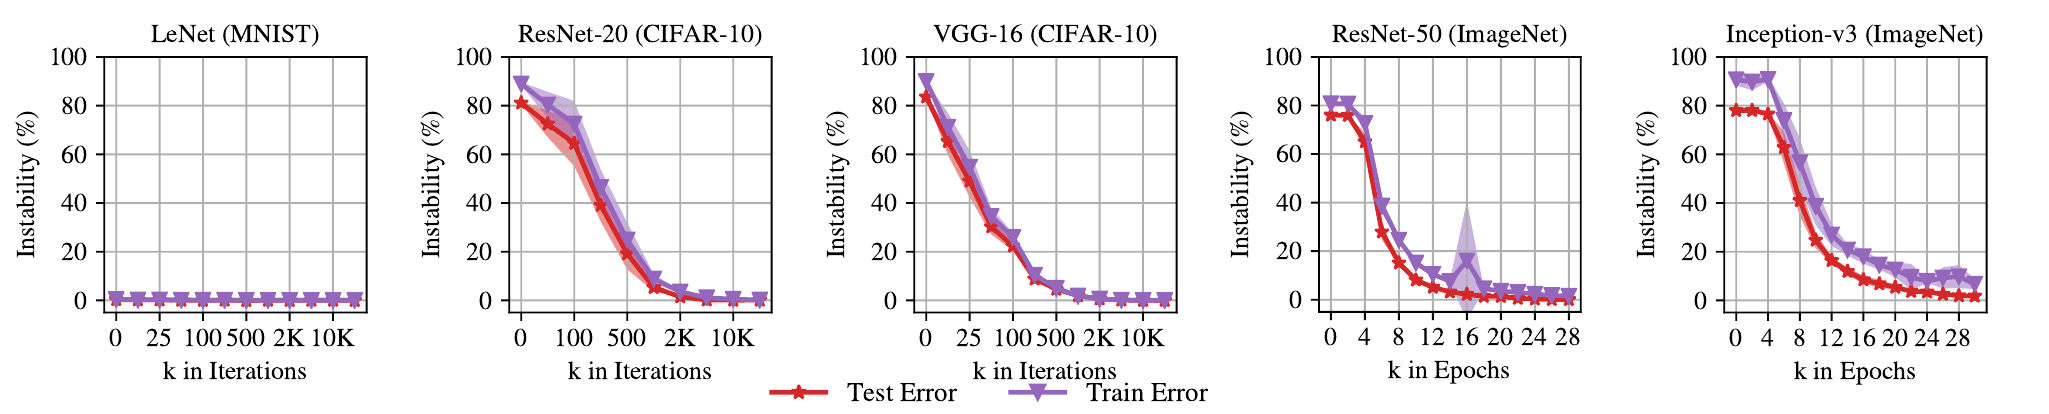
每張圖的橫軸是複製之前先訓練了幾步,縱軸是測試集上的不穩定性。除了 LeNet,每條線都從很高的地方開始往下掉,掉到 0 附近就停住。
掉到門檻以下的時間點都很早。ResNet-20 在第 2,000 次迭代、VGG-16 在第 1,000 次,分別只走完訓練的 3% 和 1.5%。ImageNet 上晚一些,ResNet-50 在第 18 個 epoch(全程的 20%),Inception-v3 在第 28 個 epoch(16%)。
過了這個點,實驗抽到的不同資料順序與增強,會把模型帶到線性連通的區域。這是多組訓練的觀察,門檻也會隨架構、排程與量測資料而變。
| 完整網路 | 訓練總長 | 測試不穩定性低於 2% 的起點 |
|---|---|---|
| LeNet/MNIST | 24,000 次更新 | 初始化就穩定 |
| ResNet-20/CIFAR-10 | 63,000 次更新 | 約第 2,000 次,3% |
| VGG-16/CIFAR-10 | 63,000 次更新 | 約第 1,000 次,1.5% |
| ResNet-50/ImageNet | 90 epochs | 約第 18 個 epoch,20% |
| Inception-v3/ImageNet | 171 epochs | 約第 28 個 epoch,16% |
依原論文 Figure 3 與訓練設定整理。這裡列的是標準設定,未混入低學習率與 warmup 變體。
ImageNet 還有一個細節。測試集的障礙已降到門檻內,訓練集的障礙仍可能稍高;ResNet-50 的訓練穩定時間更晚,Inception-v3 在作者掃描的範圍內甚至還沒達到訓練穩定。說「第 18 個 epoch 定下來」,得連同測試錯誤率這個條件一起記住。
是時間短,還是真的定了?
這裡有一個可能的混淆。 越大,複製之後剩下的訓練步數 就越少,兩份結果本來就比較沒機會走遠。不穩定性下降,會不會只是因為訓練時間變短?
作者另做一組對照,複製之後一律訓練完整的 步,學習率排程也從頭開始。在 ResNet-20 和 VGG-16 上,兩種做法的不穩定性曲線幾乎重疊。剩餘訓練時間的長短,不是造成穩定的原因。
作者還檢查了分岔時的模型是否早就學完了。ResNet-20 第 2,000 次更新時的測試錯誤率約 25%,最終還能降到 8.3%;VGG-16 第 1,000 次約 20%,最終是 6.3%。它們在參數空間裡也還比較靠近初始化,而非最後的權重。後面仍有很長一段訓練,穩定描述的是後續會走進哪一片線性連通區域,準確率還會繼續改善。
討論
稀疏子網路的成敗
論文後半回到彩票假說。
彩票假說的證據來自迭代式量級剪枝(iterative magnitude pruning,IMP)。把網路訓練完,剪掉絕對值最小的權重,剩下的權重倒回初始值,再重新訓練;反覆幾輪,直到達到目標稀疏度。ImageNet 的兩個網路為了省計算,一次剪到位。若這個子網路能訓練到和完整網路一樣的準確率,作者稱它為「matching」。
在 LeNet 上,IMP 找到的子網路是 matching;在 ResNet-20、VGG-16 的標準設定和 ImageNet 上就不行。ResNet-50 只保留 30% 的權重時,完整網路是 76.1%,倒回初始值的 IMP 子網路只有 73.7%,和隨機剪枝差不多。
作者用不穩定性分析看這些子網路,發現兩件事對得很整齊。從初始化就 matching 的子網路,從初始化就穩定;不 matching 的子網路,從初始化就不穩定。
既然完整網路要先訓練一小段才會穩定,那剪枝後不要倒回初始值,改倒回第 步呢?結果,原本不 matching 的子網路,倒回稍後的步數就變成 matching;而開始 matching 的時間點,和子網路變穩定的時間點幾乎重合。ResNet-50 和 Inception-v3 的 IMP 子網路,分別在第 5 和第 6 個 epoch 就穩定了,比完整網路的第 18 和第 28 個 epoch 早得多。
這讓彩票假說的觀察延伸到了 ImageNet,只是「彩票」不在初始化,而在訓練早期。
倒回的是哪一份權重
把 IMP 寫成操作會更清楚。先保存完整網路在第 步的 ,再用二元遮罩 表示哪些參數留下。每輪從 訓練到結束,依訓練後的權重絕對值更新 ,剪掉目前仍存活參數中最小的 20%,然後再倒回同一份 。兩輪之後保留的是 ,並非每次減去原始參數的 20%。
遮罩是看過訓練終點後才找出來的,所以這套實驗花了多次訓練。它證明早期權重裡存在好子網路;若要拿來節省實際訓練時間,還得處理尋找遮罩的成本,以及稀疏運算能否得到硬體加速。
對照組也很有用。一組隨機剪枝,但保留 IMP 的各層保留比例;另一組沿用 IMP 找到的遮罩,重新隨機初始化存活權重。這樣可以分開檢查「連線結構」和「對應權重」的作用。在選定的極端稀疏度下,多數這類隨機子網路即使延後倒回,也維持不穩定且較差的準確率。
例如標準 ResNet-20 保留 16.8% 權重,IMP 子網路約在第 500 次更新就穩定;VGG-16 保留 1.5%,約在第 1,000 次穩定。ImageNet 兩組都保留 30%,穩定起點則是前面提過的第 5 和第 6 個 epoch。稀疏子網路的穩定時間可以比完整網路更早,參數較少與是否穩定並沒有簡單的單調關係。
穩定以後,還可能太小
作者又把 CIFAR-10 的稀疏度一路往上推。ResNet-20 保留約 80.0% 到 13.4% 權重時,能找到達到完整網路準確率的 IMP 子網路;VGG-16 對應的範圍約是 16.8% 到 1.2%。再少下去,在掃過的倒回時間裡,連 IMP 也找不到 matching 子網路。
這裡的 matching 在跨稀疏度分析中容許約 0.2 個百分點的準確率下降。極端稀疏時,變穩定仍會伴隨錯誤率下降,但容量已不足以追上完整網路。因此穩定和成功訓練的關聯很強,拿它當成所有子網路都能達標的充分條件就會過頭。
附錄還用 距離、餘弦距離、預測分歧與逐樣本損失差比較兩個終點。完整網路的參數距離隨分岔時間平順下降,沒有在穩定點突然歸零;相同區域內的兩個終點仍可以相隔很遠。線性插值額外告訴我們的是,中間那整段參數是否也好用,單看兩點的距離無法回答。
對模型合併的意義
這篇論文沒有談模型合併,但它碰到了合併最基本的前提,也就是兩個模型什麼時候可以直接平均。
在論文的設定裡,兩份複製用的是同樣的資料和超參數,只差在 SGD 雜訊。只要它們一起走過訓練早期那一段,直線混合就不會遇到障礙,相加除以二也不會掉進高損失區。
後來的預訓練加微調,把共同的訓練路徑拉得很長,提供了研究合併的好起點。不過微調資料和目標各不相同,這已經超出這篇只改變 SGD 雜訊的實驗;能否相加,還要看後來的研究與實際插值曲線。
結論
這篇論文把「兩次訓練會不會落進同一個谷」變成一個可以量的問題。量出來的結果,除了很小的網路,從初始化出發不會;只要一起走過訓練最前面的 1.5% 到 20%,之後就會。
同一個工具也替彩票假說補上了一塊。找不到好子網路的設定,換成倒回訓練早期的權重,就找得到了。
如果你要把兩個模型的權重直接平均,先想想它們最後一次走同一條路,是在什麼時候。