原始論文
The Role of Permutation Invariance in Linear Mode Connectivity of Neural Networks
- 發表版本
- ICLR 2022會議
- arXiv 首次提交
- arXiv:2110.06296
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingpermutationinvariance2021,
  title = {{The Role of Permutation Invariance in Linear Mode Connectivity of Neural Networks}},
  author = {Rahim Entezari and Hanie Sedghi and Olga Saukh and Behnam Neyshabur},
  year = {2021},
  eprint = {2110.06296},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2110.06296}
}
損失地形的研究,在 2018 年前後告訴我們一件奇怪的事。
兩個從不同隨機初始化訓練出來的網路,中間可以找到一條彎曲的低損失路徑;可是直接連一條直線,損失還是會在中間衝高。彎路走得通,直線卻過不去。
TU Graz 與 Google 的 Entezari、Sedghi、Saukh 與 Neyshabur 想到一個可能的原因。神經網路的隱藏單元沒有固定順序,把同一層的神經元換個位置,網路算出來的函數完全一樣,參數向量卻變成另一個點。兩個網路在直線上撞牆,也許只是因為它們的神經元「排錯了位置」。
他們把這個想法寫成一個猜想,並且直接承認它很大膽。
定義問題
障礙怎麼量
令 是網路在某組參數下的損失(例如訓練誤差)。兩組參數 、 之間的線性插值障礙定義為
第一項是插值模型的損失,第二項是兩端損失的線性插值。兩者相減,量的是「比直線預期多出來的那一截」。
這和 Frankle 等人的定義略有不同。Frankle 用兩端損失的平均 當基準;兩端損失相等時兩種定義一樣,不相等時,這個版本不會把「損失從一端線性變到另一端」也算成障礙。
時,就說兩個網路線性模式連通(linear mode connectivity, LMC)。作者在實驗中發現,只在 量一次,和取整條路徑的上確界差距小於 ,所以之後的圖都只報中點的值。
先看障礙跟什麼有關
在提出猜想前,作者先做了一輪普查。架構有單層 MLP、兩層卷積的 Shallow CNN、VGG 與 ResNet,資料集有 MNIST、SVHN、CIFAR-10、CIFAR-100。每個設定訓練 10 個不同種子的模型,取 5 組隨機配對量訓練誤差的障礙。
- 寬度:障礙先隨寬度上升,到了某個寬度又開始下降,形狀很像 double descent。作者對照測試誤差,發現障礙的峰值大約落在模型剛好能擬合訓練資料的寬度。簡單的資料集(MNIST、SVHN)比 CIFAR 更早開始下降。
- 深度:MLP 和 Shallow CNN 固定每層寬度 ,每多加一層,障礙就明顯變高。VGG 和 ResNet 的障礙一直卡在很高的位置,不隨寬度改變。
- 任務難度:MLP 在 MNIST 上的障礙只有 0.0174,到 CIFAR-100 是 0.7965;Shallow CNN 從 0.0161 到 0.4861。淺層網路的障礙和測試誤差高度正相關。ResNet18 和 VGG16 在四個資料集上都在 0.84 到 0.99 之間,測試誤差低,障礙卻很高。
普查的結論是,寬可以降低障礙,深會提高障礙。這些現象需要一個解釋。
解決問題
兩種不變性
一個網路經過某種變換後,表示的函數不變,就說網路對這個變換具有不變性。常見的有兩種。
第一種是 ReLU 的正齊次性。把某個神經元的輸入權重乘上 、輸出權重除以 ,函數不變。作者認為這種不變性不重要,因為 SGD 的隱式偏好會讓各層權重的大小趨於平衡,收斂到特定的縮放方式。
第二種是排列不變性。把第 層的隱藏單元重新排列,參數變成
其中 是排列矩陣,輸入層與輸出層不排列。 調換這一層輸出的順序, 把前一層的排列抵銷回來。對 SGD 來說,每一種排列出現的機率都一樣,所以排列對損失地形的影響值得認真看。
用一個單隱藏層網路來確認這件事。隱藏層有 個單元,把第一層權重的列、偏置,以及第二層權重的欄,用同一個排列一起重排:
def permute(params, p):
    W1, b1, W2, b2 = params        # W1: [h, d], b1: [h], W2: [10, h], b2: [10]
    return [W1[p], b1[p], W2[:, p], b2]
在本文後面的小實驗中,對寬度 16、64、256 的網路各做一次隨機排列,torch.allclose 比較排列前後在整個資料集上的輸出,三次都回傳 True。函數一模一樣,但在參數空間裡,它們是相隔很遠的兩個點。
寬度 的一層就有 種排法。同一個函數,在參數空間裡有天文數字般的分身。
猜想
作者的猜想白話來說是這樣的:
大多數 SGD 的解都屬於一個集合 ;只要對 裡的元素做適當的排列,任兩個元素之間的線性插值都沒有障礙。
正式版本加上了寬度條件。存在某個寬度 ,只要網路夠寬,就存在一個解集合 與一個指定排列的函數 ,讓 裡任兩個解在排列後的障礙近似為零,而且 SGD 的解有很高的機率落在 裡。
如果猜想成立,損失地形上看起來分隔的許多盆地,其實只是同一個盆地被排列複製出來的分身。
理論:只證得了最簡單的情況
作者證明了一個很受限的版本。對一個單隱藏層、ReLU 的全連接網路 ,在隨機初始化時,權重從指定的均勻分布抽樣,以高機率存在一個排列,讓兩個網路插值後的輸出和兩端輸出的插值之間,誤差只有
是隱藏單元數、 是輸入維度。夠寬時,誤差趨近於零。
這個定理只談初始化,不談訓練後的網路。指數裡的 也說明,輸入維度越高,需要的寬度增加得非常快。作者自己說,更複雜的證明也許能延伸到 NTK 範圍,但留給未來。
實驗:排列空間太大,換個方式驗證
直接驗證要搜尋排列,但排列的數量隨寬度階乘成長。作者試過暴力搜尋,單隱藏層 MLP 最多只能做到 16 個神經元,那已經是 種排列。
就算用更聰明的搜尋演算法,失敗時也無法分辨是演算法不夠強,還是根本不存在那樣的排列。
作者換了一個角度。給定一個 SGD 解 ,把它所有的排列收集起來,形成一個集合
一定滿足猜想,因為裡面每個元素都是 的分身,把排列反轉回去,障礙就是零。論文稱 為「我們的模型」,真實的 SGD 解集合 則稱為「真實世界」。
接下來只要檢查 和 的行為是否一樣。如果一個獨立訓練的解 和 之間的障礙,跟 和「 的隨機排列」之間的障礙,在各種寬度、深度、資料集下都差不多,那麼「 其實就是 的某個排列,再加上一點小擾動」就是一個合理的解釋。
自己跑一次看看
這個論證可以在很小的規模上重現。
下圖是本文另外做的小實驗,不是論文的結果。資料是 sklearn 內建的 8×8 手寫數字(1,797 張),模型是單隱藏層 ReLU MLP,用不同種子訓練兩個模型 A 和 B,訓練損失都在 0.001 左右。接著比較三種線性插值:A 到 B、A 到「隨機排列後的 A」,以及 A 到「對齊後的 B」。
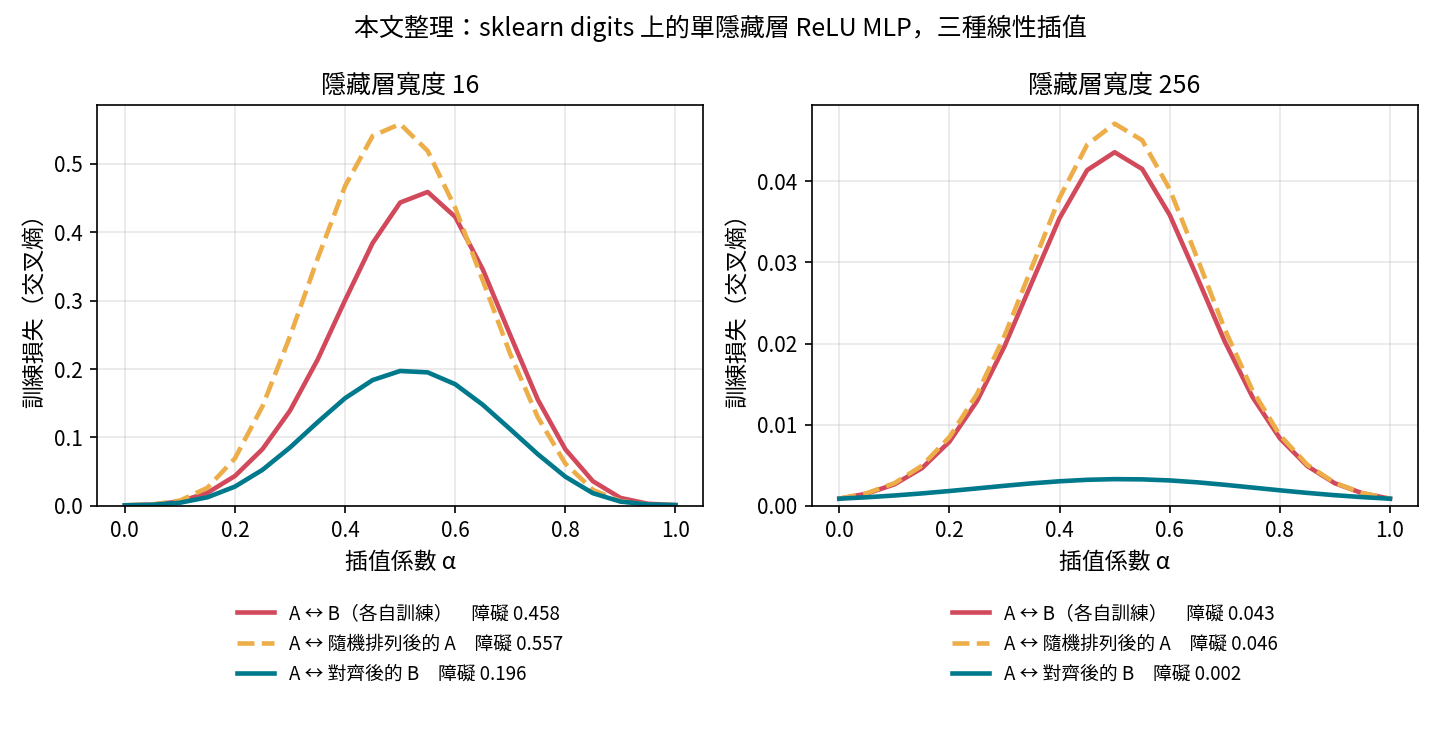
先看紅線和橘線。A 和 B 是各自訓練出來的模型,A 和排列後的 A 是同一個函數,兩條曲線的山峰卻差不多高。論文的核心觀察就是這個,獨立訓練造成的障礙,和「純粹換座位」造成的障礙,高度相近。
藍綠線是另外加的。把 B 的隱藏單元依照激活值的相關性,用匈牙利演算法一對一配到 A 上,再做插值。寬度 16 時障礙從 0.458 降到 0.196,寬度 256 時從 0.043 降到 0.002。這種對齊方法來自後續研究,不是這篇論文用的搜尋法;放在這裡,是讓你看到「排對位置」實際上能做到什麼程度。
另外,寬度 64 時三個障礙分別是 0.094、0.070、0.006。寬度越大,障礙越低,對齊之後也越接近零,和論文普查的趨勢一致。
論文的證據
回到論文。作者在 MLP 和 Shallow CNN 上比較 與 ,在各種寬度、深度與資料集下,兩者的障礙曲線幾乎重疊。
接著加入搜尋。作者用模擬退火(simulated annealing)找排列,這是旅行推銷員問題常用的近似演算法。有兩個版本:
- SA1:直接最小化五個解兩兩之間的平均障礙。
- SA2:先把排列後的解平均成一個模型,最小化這個平均模型的訓練誤差。
兩者效果差不多,SA2 便宜很多,之後只用 SA2。但它在五個解同時對齊的設定下,幾乎降不了障礙。
作者因此縮小搜尋空間,只拿兩個解,固定 ,只排列 。這樣一來,MNIST 和 SVHN 上的 MLP 與 Shallow CNN 障礙都明顯下降,單層 MLP 在 MNIST 上甚至對所有寬度都降到零。更重要的是,搜尋前後, 和 的障礙仍然幾乎一樣。搜尋在 上成功的地方,在 上也成功;在 上失敗的地方,在 上也失敗。
全部實驗加起來訓練了三千多個網路,作者把它們畫成一張密度圖,「真實世界」與「我們的模型」的障礙大致沿著對角線分布。
討論
這篇論文的論證方式很有意思。它沒有證明猜想,而是設計一組「如果猜想是錯的,應該會看到差異」的實驗,結果沒有看到差異。作者用的字眼也很謹慎,說這些嘗試「沒能推翻」猜想。
但證據的強弱要分開看。
最有說服力的是淺層網路。MLP 和 Shallow CNN 上, 與 在搜尋前後都很像,搜尋也真的能在簡單資料集上把障礙降到零。
深層網路的證據比較弱。VGG 和 ResNet 的障礙在 和 上都很高,模擬退火在兩邊都找不到能降低障礙的排列。「兩邊都失敗」和猜想相容,但也無法區分是搜尋演算法太弱,還是深層網路根本有其他障礙。作者也承認,搜尋空間的大小是這篇最大的限制,而且所有實驗都只有影像辨識。
的論證本身也有一個隱含前提。 和 在「直接插值的障礙」與「搜尋後的障礙」上相似,不保證兩者在「最佳排列下的障礙」上也相似;後者才是猜想真正在講的事。
後續研究補上了深層網路這一塊。Git Re-Basin 改用權重比對,在把寬度放大很多倍的 ResNet 上,第一次讓 CIFAR-10 上兩個獨立訓練的模型做到零障礙;它也構造了一個非 SGD 解的反例,說明猜想裡「SGD 的解」這個限定詞不能省略。下一篇要看的 REPAIR,則找到深層網路對齊後仍有障礙的另一個原因,問題出在插值後激活值的變異數。
結論
這篇論文提出一個簡單的想法:損失地形上很多看似不同的盆地,可能只是同一個盆地的排列分身。
它的理論只覆蓋單隱藏層、隨機初始化的情況;實驗則用「拿一個解的排列,模擬獨立訓練的解」這個巧妙的替代,在淺層網路上給出相當一致的支持。
想親手感受這件事,不需要大模型。訓練兩個小 MLP,隨便打亂其中一個的隱藏單元,把它跟原本的自己做插值,你會看到一座和兩個獨立模型之間差不多高的山。