原始論文
An Unbiased Benchmark for Domain Generalization Face Anti-Spoofing
- 發表版本
- SIBGRAPI Workshops 2025研討會(Workshop)
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@inproceedings{faceantispoofingunbiaseddgfas2025,
  title = {{An Unbiased Benchmark for Domain Generalization Face Anti-Spoofing}},
  author = {Raul Almeida and Bruno Kamarowski and Bernardo Biesseck and Luiz Coelho and Roger Granada and David Menotti},
  year = {2025},
  booktitle = {SIBGRAPI Workshops},
  url = {https://sol.sbc.org.br/index.php/sibgrapi_estendido/article/view/38278}
}
跨資料集的人臉防偽,近幾年最常見的考法是 OCIM。四個資料集 OULU-NPU(O)、CASIA-FASD(C)、Replay-Attack(I)、MSU-MFSD(M),每次拿三個訓練、一個測試,例如 OCI→M。從 2019 年到 2025 年,這組測試的 HTER 從將近 18% 一路降到 1% 以下。
巴西巴拉那聯邦大學的 Raul Almeida、David Menotti 等人,和巴西身分驗證公司 unico 的研究者一起,回頭看這些數字是怎麼量出來的。他們的答案寫在標題裡,現行的考法有偏差。
這是一篇進行中研究的短論文,只有六頁,實驗規模不大,但問題問得很直接。
定義問題
一般的機器學習流程,資料分三份。訓練集拿來更新權重,驗證集拿來決定什麼時候停、選哪一組超參數,測試集等一切都定案了才看一次。
OCIM 只有兩份。三個來源資料集拿來訓練,第四個資料集同時扮演驗證集和測試集。訓練時,每跑完一個 epoch 就在測試集上評估一次,最後回報表現最好的那個 epoch。作者指出,這就等於在訓練過程中一直偷看考卷。
為什麼這件事重要?因為部署時根本沒有考卷。模型上線後遇到的是新手機、新光線、新攻擊,沒有人會先給你這批資料的標籤,讓你挑出最適合它的那一個 epoch。在測試集上挑出來的成績,會比真正能拿到的成績好看。
好看多少?我們用一個極端的情況算算看。假設模型每個 epoch 的真實錯誤率都固定是 10%,完全沒有在進步;測試集有 40 段真人、80 段攻擊,每次量 HTER 都會因為抽樣而上下跳。把同樣的實驗重複 2,000 次,看「從 N 個 epoch 裡挑最低的那個」平均會報出多少:
import numpy as np

rng = np.random.default_rng(0)
n_live, n_spoof, true_error, trials = 40, 80, 0.10, 2000

def measured_hter(epochs):
    apcer = rng.binomial(n_spoof, true_error, (trials, epochs)) / n_spoof
    bpcer = rng.binomial(n_live, true_error, (trials, epochs)) / n_live
    return (apcer + bpcer) / 2

for epochs in (1, 10, 30, 100):
    best = measured_hter(epochs).min(axis=1)        # 每次實驗挑最低的那個 epoch
    print(f"看 {epochs:>3} 個 epoch,挑最低:平均 {best.mean():.1%}")
看   1 個 epoch,挑最低:平均 9.9%
看  10 個 epoch,挑最低:平均 5.8%
看  30 個 epoch,挑最低:平均 4.6%
看 100 個 epoch,挑最低:平均 3.6%
模型一點都沒變,只是在測試集上看得越多次,挑出來的數字就越漂亮。看 100 次,10% 的模型可以報出 3.6%。真實的訓練過程裡,各個 epoch 的模型本來就有好有壞,挑最好的那一個不全是運氣;但只要挑的依據是測試集,這一份運氣就會混進回報的數字裡,事後也分不出來。
作者也提到,先前有研究注意到這個問題,但都只做了部分修補。例如 SA-FAS 另外回報最後 10 個 epoch 的平均,有的論文加報 TPR@FPR 這類更貼近部署的指標。這些做法讓數字更接近實際,可是測試集仍然在訓練過程中被看過。作者說,就他們所知,這是第一篇專門處理這個偏差、並提出替代考法的研究。
解決問題
做法只有一個改動,多加一個資料集。
這第五個資料集有兩種用法:
- 加進來當驗證集:OCIM 照舊訓練與測試,但每個 epoch 改在新的驗證集上評估,用它挑出最好的 epoch,訓練結束後才在原本的測試集上算一次 HTER。
- 加進來當測試集:原本的第四個資料集退回去當驗證集,最終成績改在這個新資料集上量。
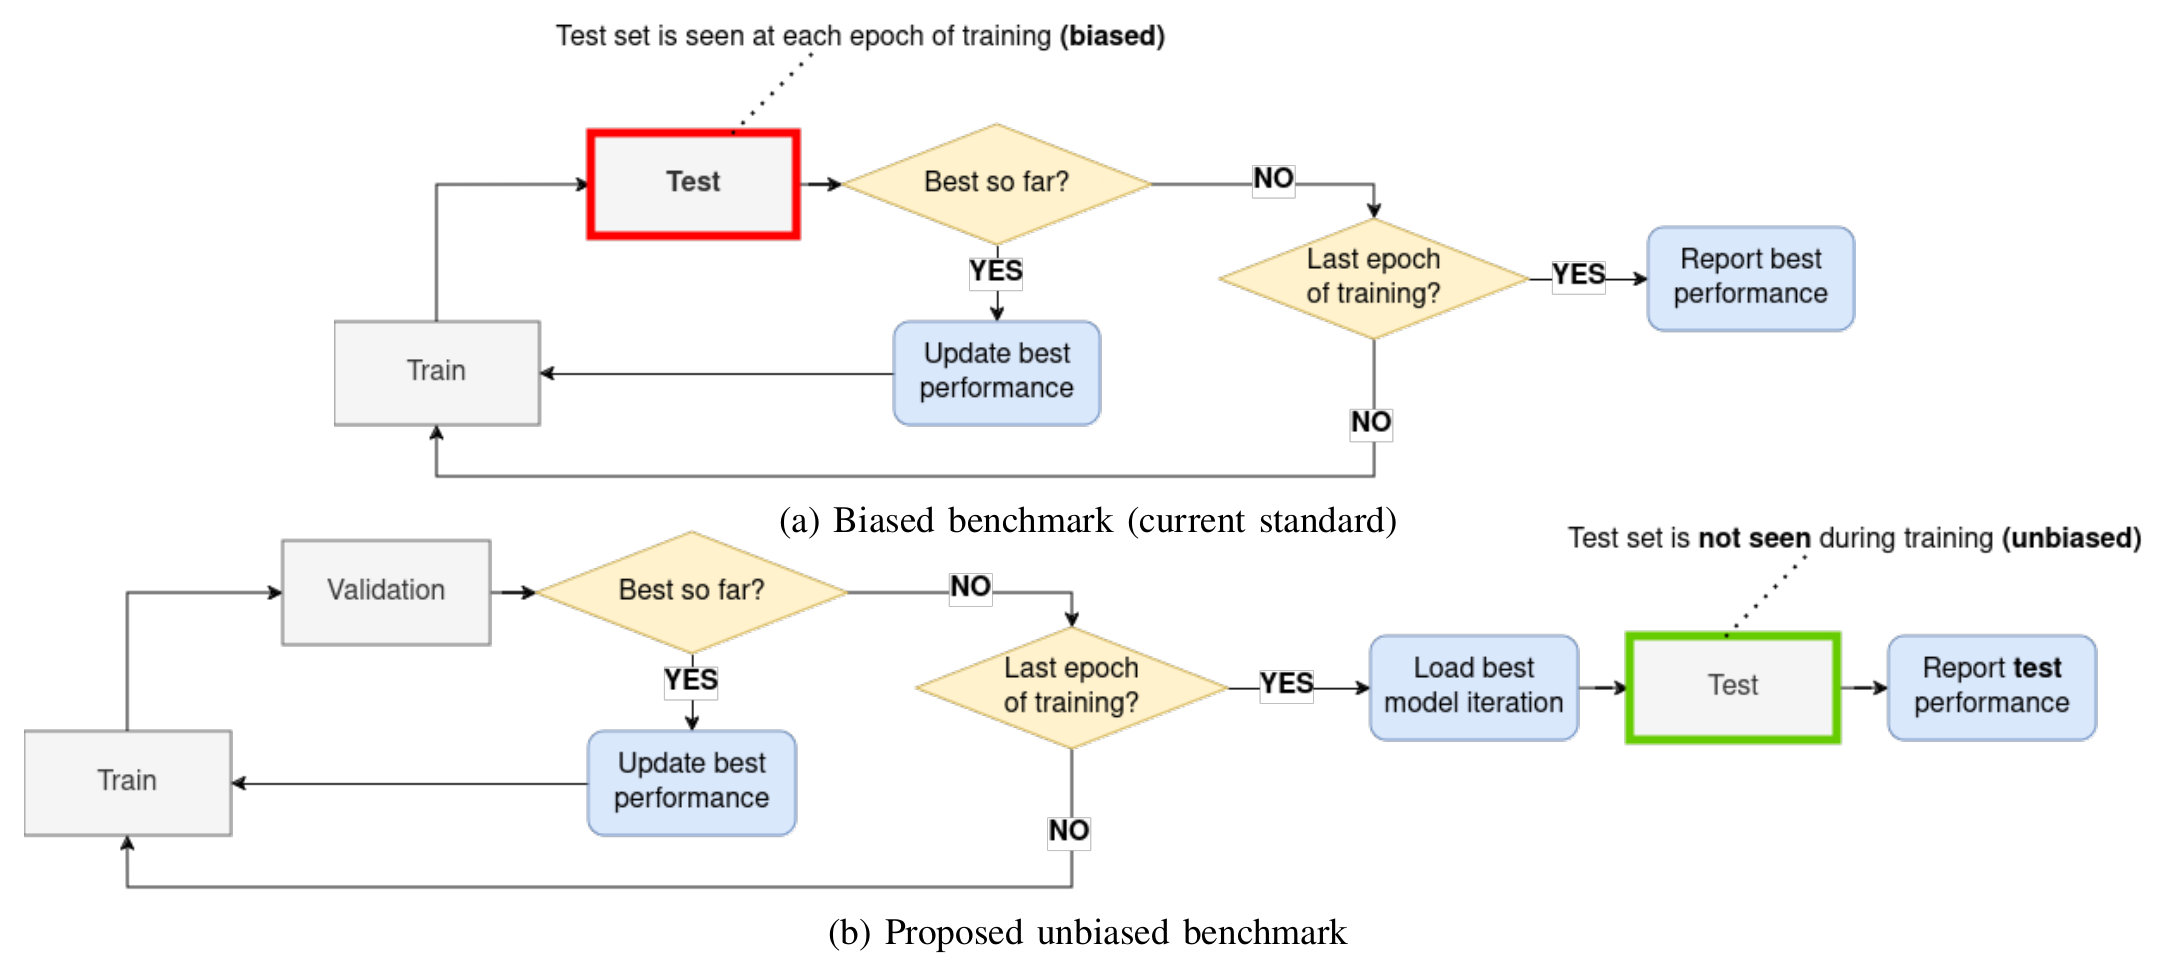
兩張流程圖的迴圈長得幾乎一樣,差別在迴圈裡負責「挑最好」的那一格。上面是紅框的 Test,每跑完一個 epoch 就看一次;下面換成 Validation,Test 移到迴圈外面,最後只跑一次。
兩種用法都讓測試集在訓練過程中完全不出現。作者比較推薦第一種,因為大家還是想在 O、C、I、M 這四個熟悉的資料集上看成績。
第五個資料集怎麼挑?作者考慮了四件事:資料量、攻擊類型、受試者人數、樣本變化。最後選了兩個候選:
| 資料集 | 年份 | 受試者 | 真人 | 攻擊 | 攻擊類型 |
|---|---|---|---|---|---|
| CASIA | 2012 | 50 | 150 | 450 | 列印、重播 |
| Replay | 2012 | 50 | 200 | 1,000 | 列印、重播 |
| MSU | 2014 | 35 | 70 | 210 | 列印、重播 |
| Oulu | 2017 | 55 | 720 | 2,880 | 列印、重播 |
| SiW | 2018 | 165 | 1,320 | 3,300 | 列印、重播 |
| Rose-Youtu | 2018 | 20 | 897 | 1,601 | 列印、重播、面具 |
SiW 和 Rose-Youtu 的規模和 OULU-NPU 相當,年份也比較新,光線、環境與攻擊都有變化,SiW 另有姿勢和表情的變化。Rose-Youtu 有紙面具攻擊,作者把它拿掉,讓測試仍然只有列印和重播,不混進新的攻擊類型。
模型方面,作者選了四個:ImageNet 預訓練的 ResNet-18 與 ResNet-50 當基準,再加上兩個有公開程式碼、而且重跑結果接近原論文的方法 SA-FAS 和 GAC-FAS。指標沿用 HTER 與 AUC。
實驗結果討論
先重跑一次原本的考法
作者先用原本的考法,也就是測試集兼任驗證集,重跑 SA-FAS 和 GAC-FAS,連 GAC-FAS 作者提供的權重也拿來測。即使用的是原始程式碼和同樣的資料,數字還是和原論文有落差。以 OCI→M 為例,GAC-FAS 原論文是 5.00%,作者提供的權重也是 5.00%,自己重新訓練是 7.92%;在 OMI→C 上,三個數字分別是 8.20%、10.00%、12.22%。
同一份程式碼,重新訓練一次,就可能差上好幾個百分點。後面的比較,作者都拿自己重跑的數字對自己重跑的數字。
換成驗證集來挑
主要的結果在 Table III。下面摘出 SiW 當驗證集的情況。箭頭左邊是原本的考法,右邊是改用 SiW 驗證,單位是 HTER(%):
| 測試資料集 | SA-FAS | GAC-FAS |
|---|---|---|
| OULU-NPU | 12.13 → 13.81 | 10.52 → 7.91 |
| Replay-Attack | 9.00 → 21.50 | 5.00 → 8.55 |
| CASIA-FASD | 14.00 → 26.67 | 12.22 → 9.14 |
| MSU-MFSD | 11.43 → 11.43 | 7.92 → 7.31 |
SA-FAS 在 Replay-Attack 上從 9.00% 升到 21.50%,在 CASIA-FASD 上從 14.00% 升到 26.67%,大約都翻倍;MSU-MFSD 上沒變。
GAC-FAS 的情況正好相反,四組裡有三組變好了,ICM→O 的 7.91% 甚至低於它原論文回報的 8.60%。作者把這點列為意外的發現,沒有進一步分析原因。至少可以確定,換了考法之後,同一個方法的數字不一定往同一個方向走。
兩個 ResNet 基準也各走各的。ResNet-18 改用 SiW 驗證之後,四組全部變差,例如 OCM→I 從 31.50% 升到 37.50%;ResNet-50 則有兩組變好,OCI→M 從 32.08% 降到 25.42%,ICM→O 從 33.33% 降到 32.78%,作者把它和 GAC-FAS 一起列為變好的例子。
驗證集也有挑法
把 Rose-Youtu 當驗證集時,所有模型普遍都更差。例如 SA-FAS 在 OMI→C 上,用 SiW 驗證是 26.67%,用 Rose-Youtu 驗證是 40.67%。把 Rose-Youtu 當測試集時也一樣,它比 SiW 難得多。以 O、C、I 訓練、MSU-MFSD 當驗證集為例,最後在 SiW 上測,SA-FAS 和 GAC-FAS 的 HTER 是 10.05% 與 9.58%;換到 Rose-Youtu 上測,變成 25.18% 與 32.74%。同樣兩個模型,在一個新資料集上還算可用,換到另一個,HTER 就升到兩成五以上。
作者另外看了驗證集上的 EER 和測試集上的 HTER。一般來說,驗證成績會比測試成績好,作者說這和機器學習文獻的經驗一致。用 Rose-Youtu 驗證的實驗卻呈現相反的趨勢,作者認為可能是驗證資料和測試資料之間的領域差距,並由此推測,SiW 的領域比 Rose-Youtu 更接近四個測試資料集。
這帶出一個新問題。測試集收起來了,但選哪一個資料集當驗證集,也會改變挑出來的 epoch 和最後的成績。作者的建議是兩個都試;如果只能做一組,就用 SiW 當驗證集,跑 ICM→S→O、OCM→S→I、OCI→S→M、OMI→S→C 這四組。
拿到野外的資料上
最後,作者把在 OCIM 上訓練的 SA-FAS 和 GAC-FAS,拿到 WFAS 上測。WFAS 是用網路爬取建立的資料集,有 1,383,246 張影像、469,920 個人、17 種攻擊,大約是 SiW 的 300 倍大。它的測試集標籤不公開,只能透過競賽平台拿到 APCER、BPCER 與 ACER。
結果兩個方法的 ACER 都落在 28.62% 到 32.54% 之間,各自贏兩組。WFAS 競賽的冠軍是 2.82%。作者也讓 GAC-FAS 直接在 WFAS 的訓練集上訓練,取最後一個 iteration 的模型,ACER 是 21.51%。
WFAS 有很多 OCIM 沒有的攻擊類型,這組測試同時考了跨資料集和跨攻擊類型,本來就不是這些方法設計時要解的題目。不過,部署時遇到的正是這種情況。
結論
這篇論文要解決的問題很清楚。OCIM 的慣例讓測試集在訓練過程中被反覆查看,回報的數字比部署時實際能拿到的好看。作者的修正也很簡單,多一個資料集當驗證集,測試集等訓練結束才看。
從實驗看,這個偏差有多大,取決於方法。SA-FAS 在兩組測試上的 HTER 大約翻倍,GAC-FAS 反而大多變好。這讓「誰比較好」的排名本身也可能跟著考法改變。驗證集的挑法也會影響結果,SiW 和 Rose-Youtu 給出的數字差很多。
限制也要一起看。這是一篇進行中的研究,只重跑了兩個 DG 方法和兩個 ResNet 基準,論文沒有交代每組實驗跑了幾個隨機種子;重跑出來的數字本身就和原論文有落差。作者在論文裡附上了程式碼的位置,並說明會在發表後公開。
要把模型放上線的人,倒是可以直接照這個做法改自己的評估流程。挑 epoch 和門檻時,用一份測試集以外的資料,測試集留到最後再打開。