原始論文
Harnessing Chain-of-Thought Reasoning in Multimodal Large Language Models for Face Anti-Spoofing
- 發表版本
- CVPR 2026會議
- arXiv 首次提交
- arXiv:2506.01783
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{faceantispoofingfacecot2025,
  title = {{Harnessing Chain-of-Thought Reasoning in Multimodal Large Language Models for Face Anti-Spoofing}},
  author = {Honglu Zhang and Zhiqin Fang and Ningning Zhao and Saihui Hou and Long Ma and Renwang Pei and Zhaofeng He},
  year = {2025},
  eprint = {2506.01783},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2506.01783}
}
把一張翻拍的照片拿給通用的多模態大型語言模型,問它「這是攻擊嗎?」,會怎樣?
這篇論文的附錄剛好做了這個實驗。作者把 Rose-Youtu 的攻擊影像直接交給沒有微調過的模型,逐類算它判成攻擊的比例,再和用 FaceCoT 訓練後的結果對照:
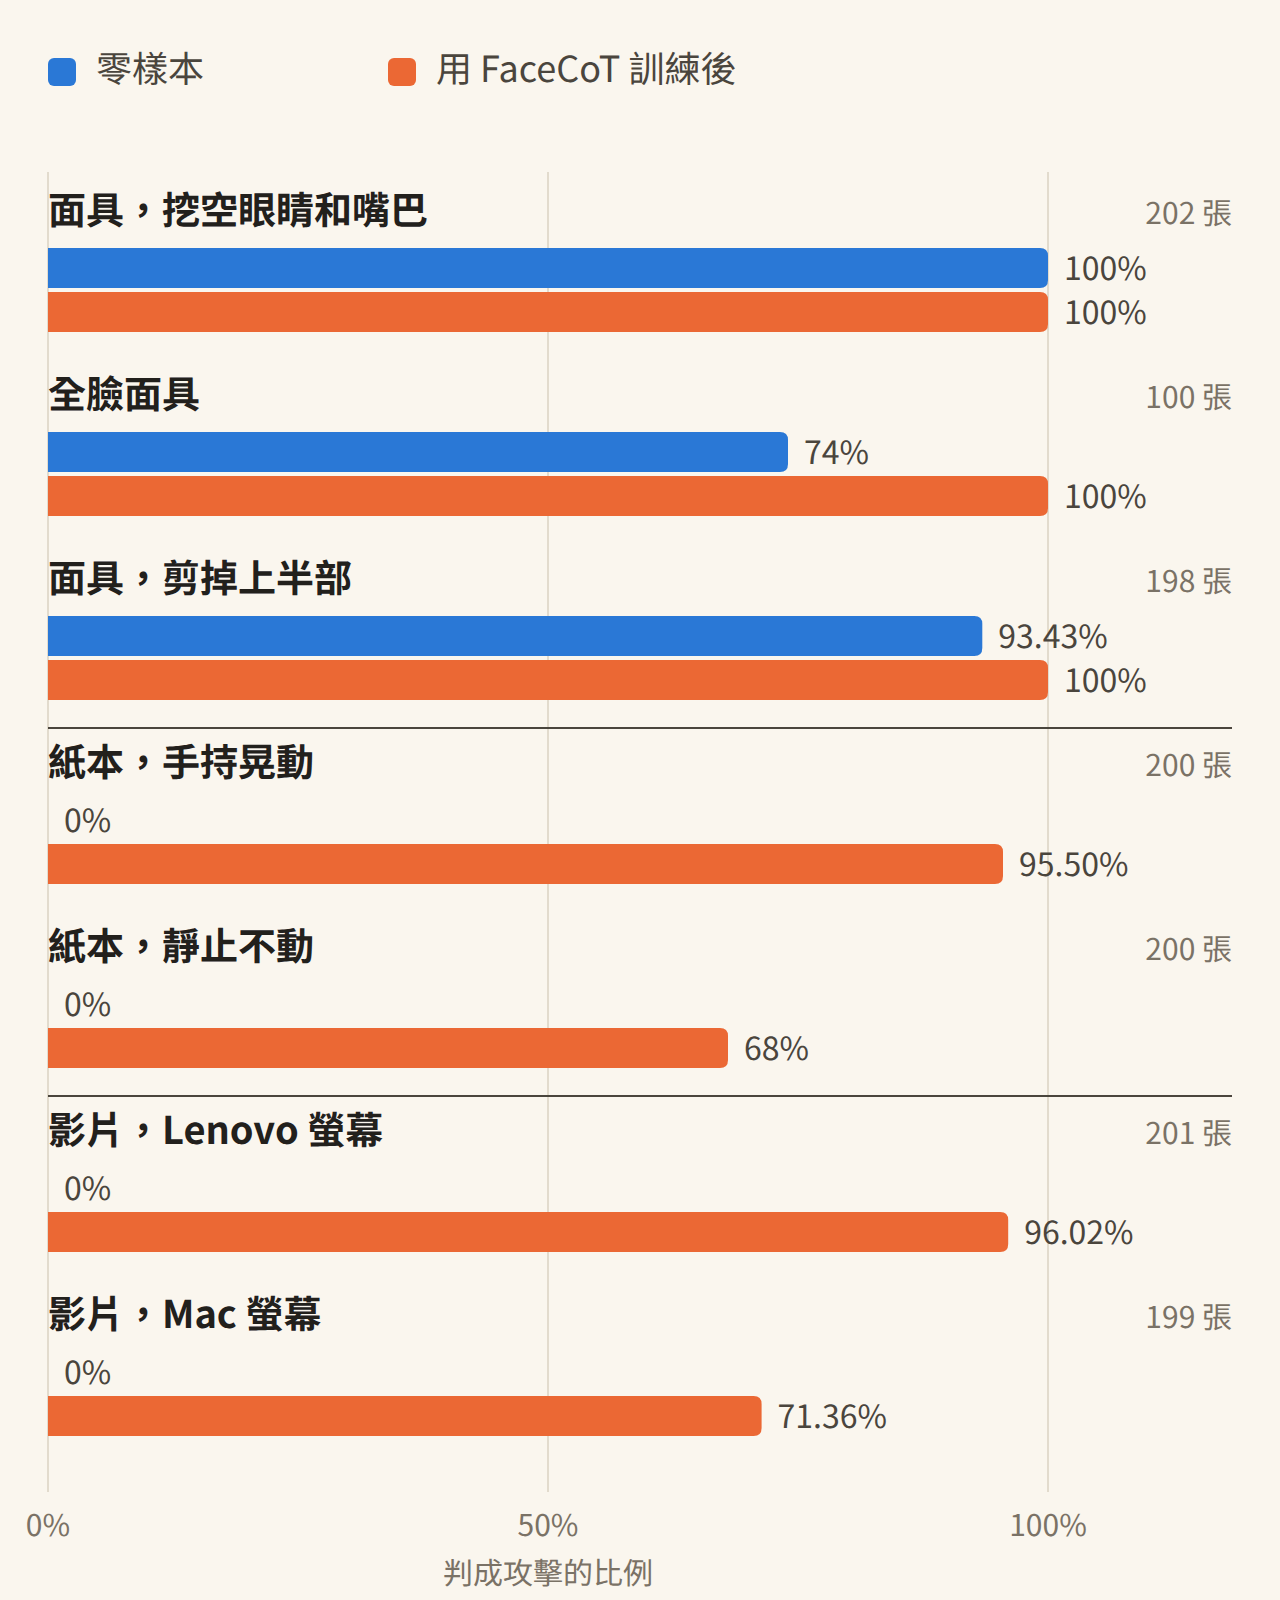
面具大多認得出來,紙本和螢幕一張都沒抓到。對一個通用模型來說,螢幕裡的那張臉,看起來就是一張臉。
滴滴出行、北京郵電大學與北京師範大學的團隊認為,缺的是資料。防偽資料集只有影像和真假標籤,要教大型語言模型一步步說出判斷依據,得先有一份圖文問答資料。於是他們做了 FaceCoT,108 萬筆問答、每筆都附六段推理,再設計一套兩階段的訓練方法來用它。
定義問題
I-FAS 讓模型先回答真假,再接一句說明。說明由一個微調過的描述模型產生,會在句子裡帶出 screen、paper 這類攻擊媒介。這比單純的標籤多了一點語意,但終究只有一句話。
作者想要的是完整的判斷過程。先看整張圖,再看臉,列出五官與皮膚的細節,然後推理、描述攻擊手法,最後才下結論。要做到這件事,需要一份每筆都寫好這種推理的資料,也需要一個能同時學會推理與分類的訓練方法。
訓練方法這一點,作者另外說了理由。如果把推理文字和分類標籤混在一起端到端訓練,分類收斂得快,推理還沒學好,訓練就結束了;視覺編碼器也就沒機會從那些細節描述裡學到東西。
解決問題
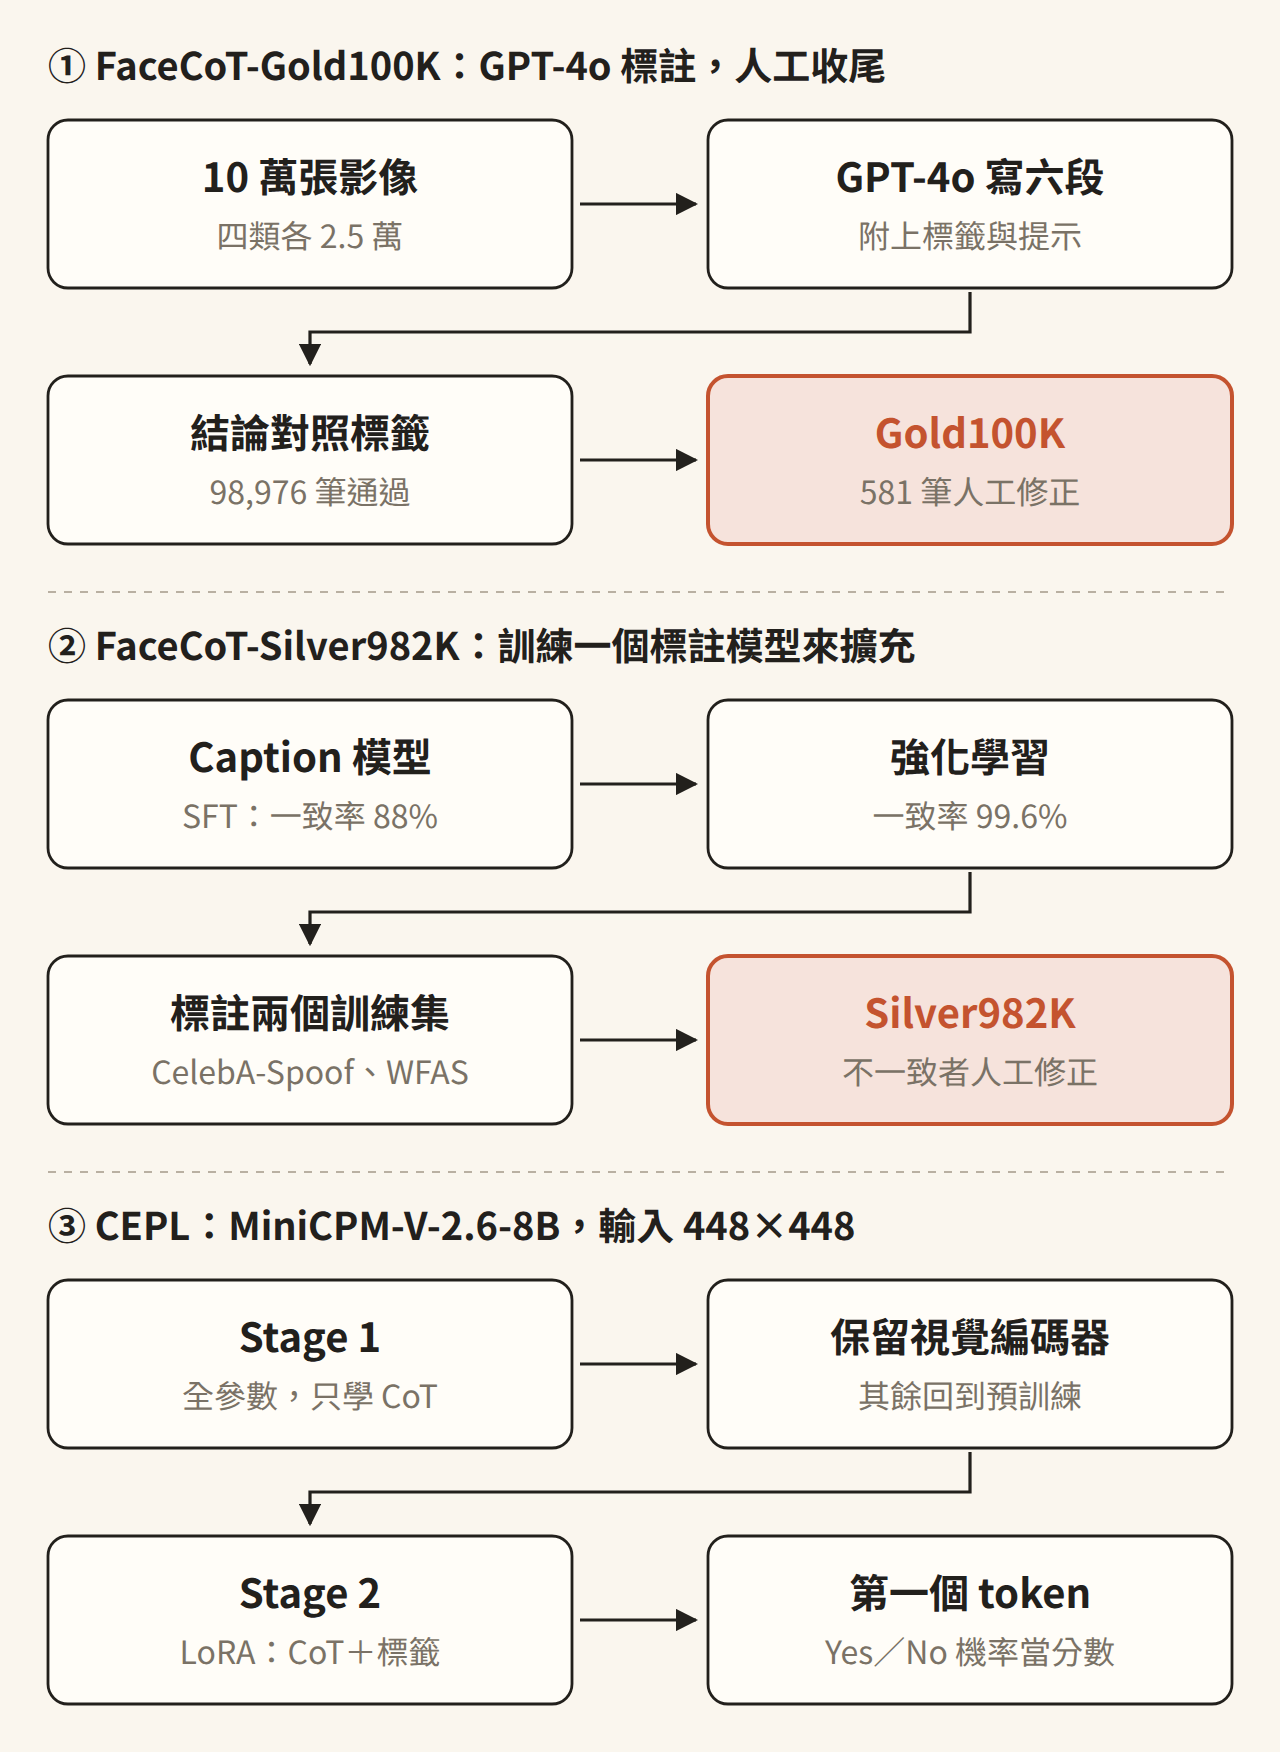
整套流程分三段。前兩段造資料,第三段訓練模型。
資料從哪裡來
影像來自兩個資料集。CelebA-Spoof 有 62.5 萬張影像、1 萬個人、10 種攻擊;WFAS 是在不受控環境下收集的野外資料,有 138 萬張影像,其中 85.3 萬張攻擊、52.9 萬張真人,涵蓋 14 種攻擊。
精選的十萬張分成四類,每類 2.5 萬張:
- 真人:全部取自 WFAS,因為它的場景最多樣。
- 列印:照片、海報各 5,000,報紙、相簿、A4、臉部印刷、上半身印刷各 3,000。
- 重播:手機、平板各 10,000,電腦螢幕 5,000。
- 面具:3D 面具 12,768、局部面具 10,579、公仔(garage kit)1,488、擬真人偶 165。
三大類底下一共 14 種攻擊。每一類裡,作者盡量讓各種子類別的張數接近。
六段推理
每筆答案都切成六個標籤:
<Caption>整張圖在拍什麼</Caption>
<Facial Description>臉部的樣子</Facial Description>
<Facial Attributes>眼睛、鼻子、嘴巴、皮膚等細節</Facial Attributes>
<Reasoning>綜合前面的資訊,一步步判斷</Reasoning>
<Spoofing Description>攻擊手法與關鍵痕跡</Spoofing Description>
<Conclusion>Yes 或 No</Conclusion>
問題是「你是人臉防偽專家,請回答:這是攻擊嗎?」,所以 Yes 代表攻擊,No 代表真人。
論文開頭的例子是一個人手拿印著女性臉孔的紙面具,眼睛、鼻子、嘴巴的位置都挖了洞。六段的內容依序是:
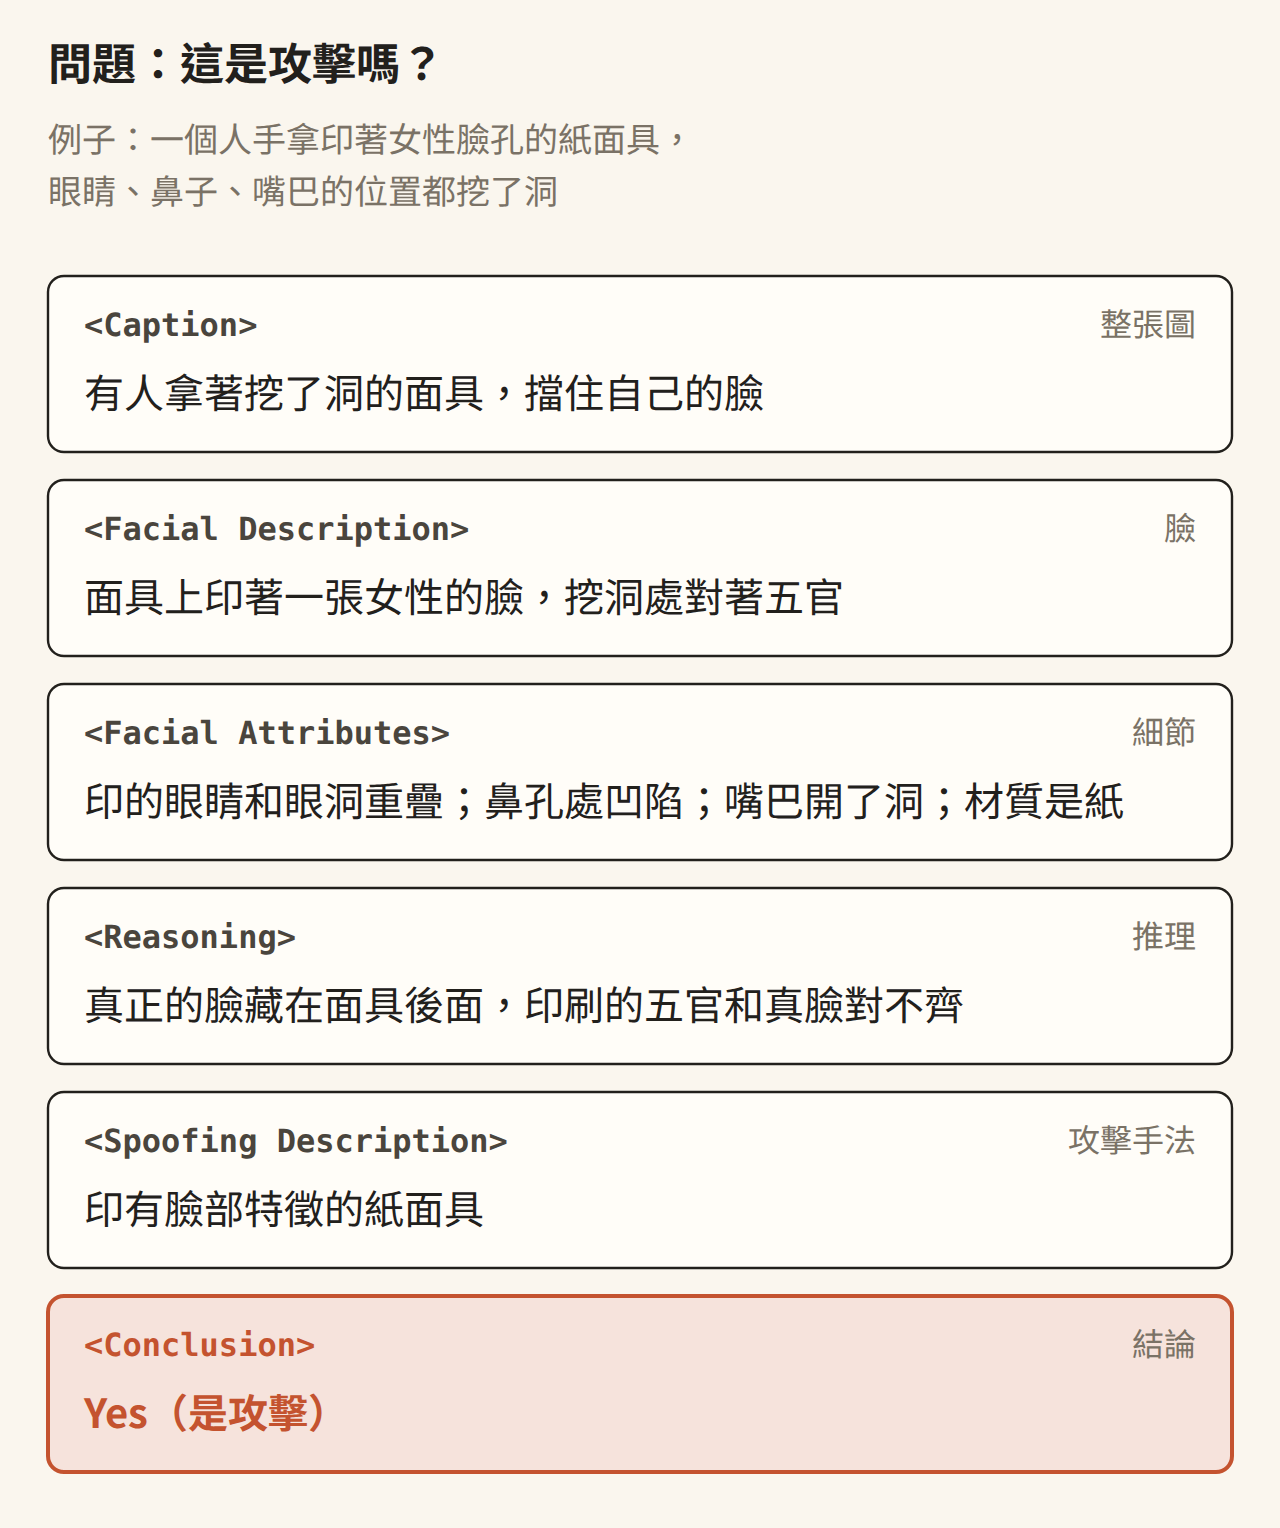
由大到小、由整體到局部,最後才下結論。作者說這是模仿人判斷真假的順序。
讓 GPT-4o 對著答案寫
Gold100K 的六段文字由 GPT-4o 撰寫。附錄交代了 GPT-4o 每次收到的五樣東西:影像、系統提示、問題、提示,還有這張圖的標籤。
系統提示要它扮演「審查員」,照六段格式回答,而且結論必須和標準答案完全一致。所以 GPT-4o 寫的不是自己的判斷,而是一份已經知道答案的詳解。
為什麼要給答案和提示?附錄有一個例子。一張翻拍日本報紙的影像,GPT-4o 看出了這是報紙上的內容,卻判定這不是攻擊。它的理由是臉部清楚自然、沒有修圖痕跡,報紙也沒有帶來換臉或竄改的跡象。它把「攻擊」理解成了數位竄改。
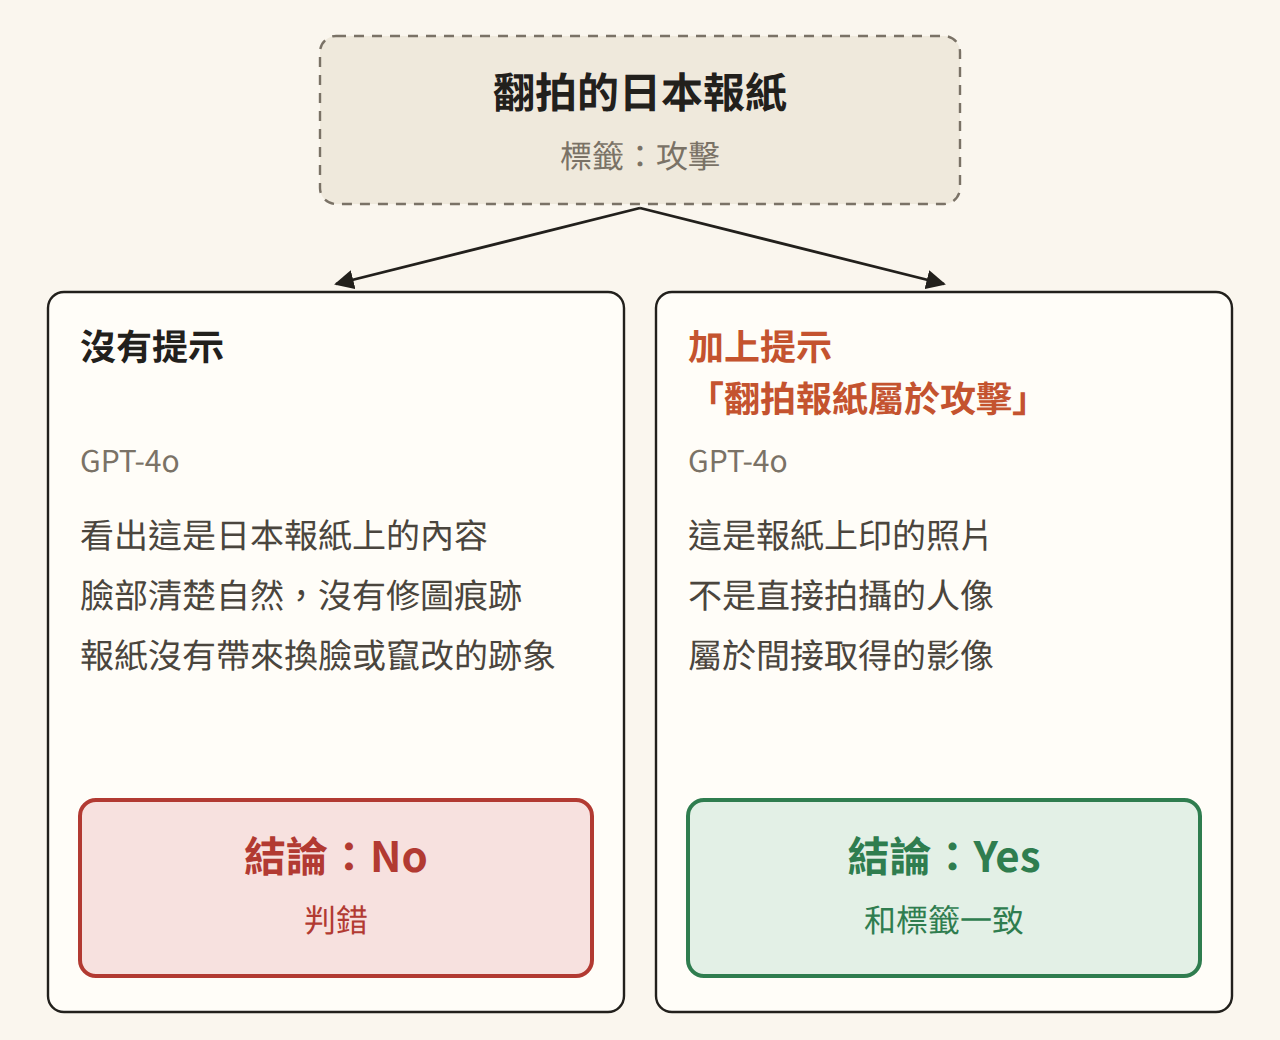
加上「翻拍報紙屬於攻擊」這句提示,GPT-4o 就改口了。報紙上印的確實是一個真人;拍一張報紙算不算攻擊,是防偽這個任務自己的規矩。所以作者替十種紙本與螢幕攻擊各寫了一句提示,例如「翻拍海報屬於攻擊」「翻拍手機螢幕屬於攻擊」。面具類模型自己分得清楚,就沒有加。
零樣本模型把紙本和螢幕全當成真人,原因大概也包括這一點。它沒被教過這條規矩。
寫完之後,用正規表示式抓出 <Conclusion> 的內容和標籤比對。第一輪有 98,976 筆對得上,其餘再請 GPT-4o 標一次,還是對不上的 581 筆列為困難樣本,交給人工處理。人工先確認結論,再找出推理或描述哪裡出錯,修正後把後面幾段重新接順。
GPT-4o 的費用大約每張 0.01 美元,十萬張約一千美元。
擴充到九十八萬筆
要再多標一百萬張,GPT-4o 加人工就太貴了。作者改訓練一個專門寫六段推理的 caption 模型。
先在 Gold100K 上做監督式微調。拿它去標沒看過的影像,結論和標籤一致的只有 88%,常見的毛病是內容寫錯和格式跑掉。接著加一段強化學習,獎勵只有兩項。結論和標籤一致得 1 分,格式符合六段模板得 1 分;再用 KL 懲罰拉住它,不讓它離監督式微調的版本太遠。做完之後,在隨機抽出的 2,000 張未標影像上,一致率升到 99.6%。
用這個模型標完 CelebA-Spoof 和 WFAS 的訓練集,就是 Silver982K,其中真人約 36.8 萬筆。結論和標籤對不上的樣本,同樣交給人工修正。訓練 caption 模型用 8 張 A100 大約一天,標註本身約 288 GPU 小時;兩個子集的人工清理,是 6 位標註員做了三天。
CEPL:先練眼睛,再學說話
骨幹是 MiniCPM-V-2.6-8B,由視覺編碼器、resampler 和語言模型組成,輸入縮放到 448×448。CEPL(CoT-Enhanced Progressive Learning)分兩個階段:
- Stage 1,視覺強化預訓練:全參數微調,只用六段推理文字當監督。目的是讓視覺編碼器跟著文字裡的細節描述,例如面具的邊緣、紙張的材質、螢幕的反光,學會去注意那些地方。
- Stage 2,多任務聯合訓練:只留下 Stage 1 的視覺編碼器,resampler 和語言模型都回到原本的預訓練權重,語言模型加上 LoRA,再同時用推理文字和二元標籤訓練。
Stage 2 為什麼要把語言模型重置?論文只說要保留視覺編碼器學到的細節,其他模組恢復預訓練權重,沒有多做解釋。一種理解方式是,Stage 1 只是借文字監督來訓練視覺編碼器的手段,語言模型在那一階段學到的東西不必留下。
訓練用 AdamW,學習率 1e-6,最多 10 個 epoch,批次 256,8 張 A100,每組實驗跑三個隨機種子取平均。
分數從哪裡來
防偽的指標 HTER 和 AUC 需要一個連續的分數。附錄寫明了做法,關掉隨機性做貪婪解碼,取模型生成的第一個 token 是 Yes 或 No 的 logits,做 softmax:
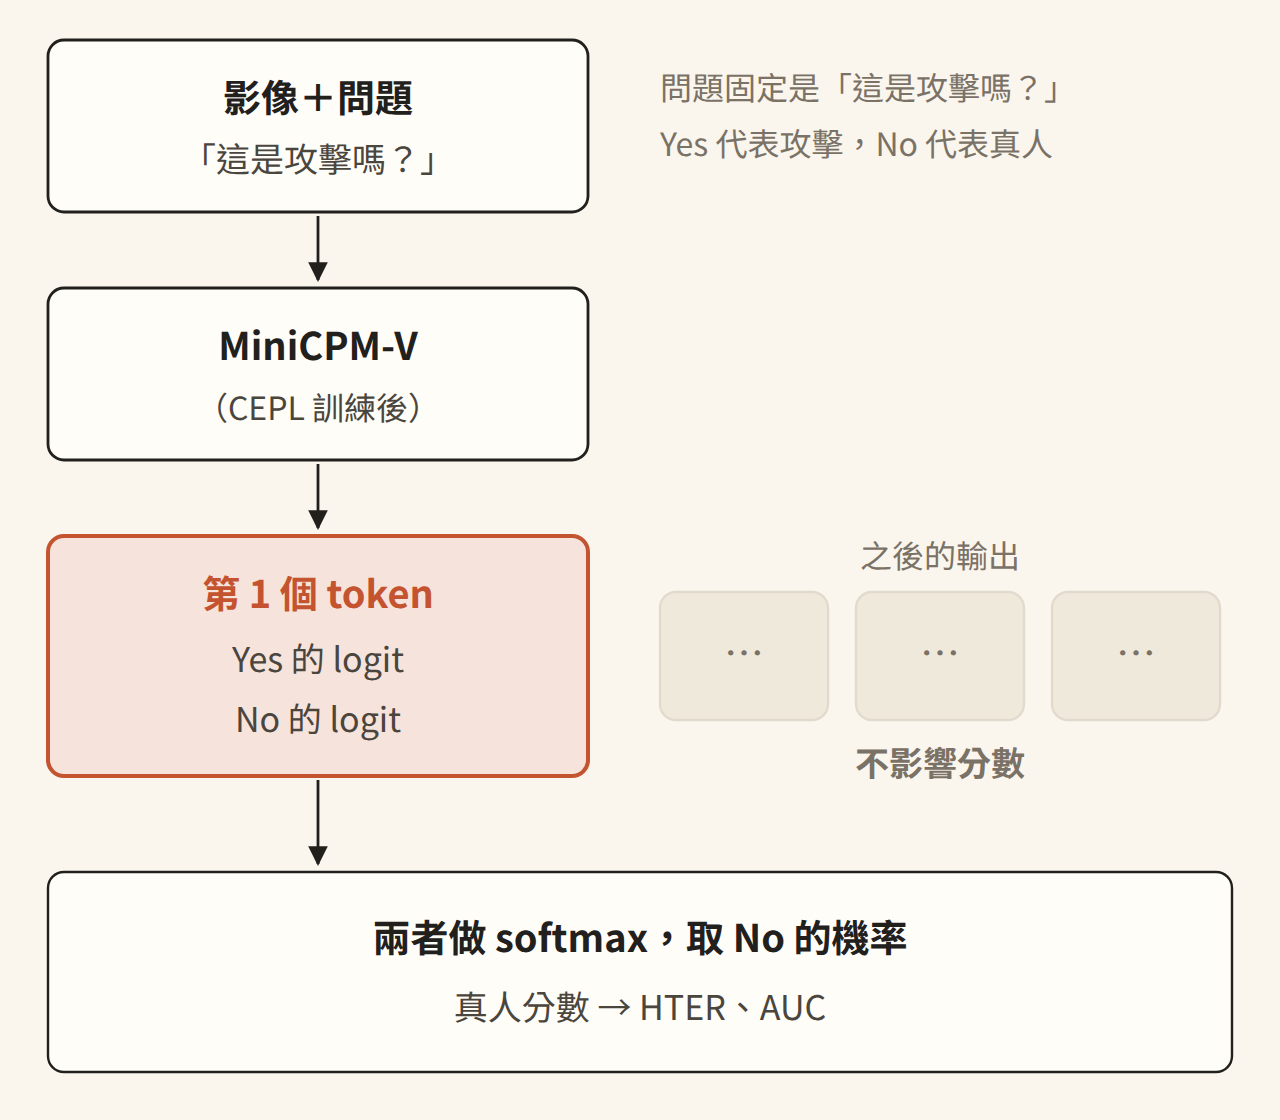
第一個 token 出來的時候,還沒有任何推理文字。所以表格裡的成績,量的是模型直接回答的能力。六段推理影響的是模型怎麼學,分數本身在推理文字出現之前就決定了。
討論
One-to-Eleven
協定沿用 I-FAS 的 Protocol 2,訓練完直接在 11 個資料集上測:MSU-MFSD、CASIA-MFSD、Replay-Attack、OULU-NPU、SiW、Rose-Youtu、HKBU-MARs-V1+、WMCA、SiW-M-V2、CASIA-SURF-3DMask、HiFiMask。
比較時要分清楚訓練資料。表中的基準方法都只用 CelebA-Spoof 訓練,作者的模型則有三個版本。HTER 與 AUC 都是 11 個資料集的平均(%):
| 方法 | 訓練影像 | HTER | AUC |
|---|---|---|---|
| ViTAF | CelebA-Spoof | 23.85 | 82.82 |
| ViT-L | CelebA-Spoof | 21.08 | 85.61 |
| FLIP | CelebA-Spoof | 18.73 | 87.90 |
| I-FAS | CelebA-Spoof | 11.30 | 93.71 |
| Ours-CelebA | CelebA-Spoof | 8.56 | 96.37 |
| Ours-100K | Gold100K | 7.65 | 96.59 |
| Ours-All | 全部 108 萬筆 | 6.30 | 97.77 |
論文說的「HTER 降了 5 個百分點」,指的是 Ours-All 對上 I-FAS。Ours-All 多了 WFAS 的影像,條件不同。條件最接近的是 Ours-CelebA,只用 CelebA-Spoof 的影像,HTER 從 11.30% 降到 8.56%。它用的六段推理由 caption 模型撰寫,而 caption 模型是在含有 WFAS 影像的 Gold100K 上學出來的。
逐個資料集看,訓練資料的影響更清楚(HTER,%):
| 測試資料集 | I-FAS | CelebA | All |
|---|---|---|---|
| CASIA-SURF-3DMask | 6.18 | 6.21 | 0.40 |
| HiFiMask | 28.23 | 28.68 | 15.93 |
| HKBU-MARs-V1+ | 18.64 | 6.96 | 7.34 |
| OULU-NPU | 14.86 | 9.47 | 5.86 |
| WMCA | 20.07 | 11.51 | 10.16 |
| SiW | 4.02 | 0.79 | 0.48 |
| MSU-MFSD | 5.63 | 8.33 | 5.00 |
| Replay-Attack | 9.15 | 9.87 | 12.75 |
- CASIA-SURF-3DMask 和 HiFiMask,只用 CelebA-Spoof 時和 I-FAS 幾乎一樣,加進 WFAS 才大幅改善。這兩個資料集的進步,主要來自 WFAS 裡的面具資料。
- 同樣是面具資料集的 HKBU-MARs-V1+,只用 CelebA-Spoof 就從 18.64% 降到 6.96%。OULU-NPU、WMCA、SiW 也在只用 CelebA-Spoof 時就明顯進步。
- 也有反方向的。MSU-MFSD 只用 CelebA-Spoof 時比 I-FAS 差;Replay-Attack 加進更多資料後,反而從 9.87% 升到 12.75%,比 I-FAS 的 9.15% 還高。
CoT、CEPL 與解析度
消融實驗都在 Gold100K 上訓練。把散在幾張表裡的 HTER 畫在一起:
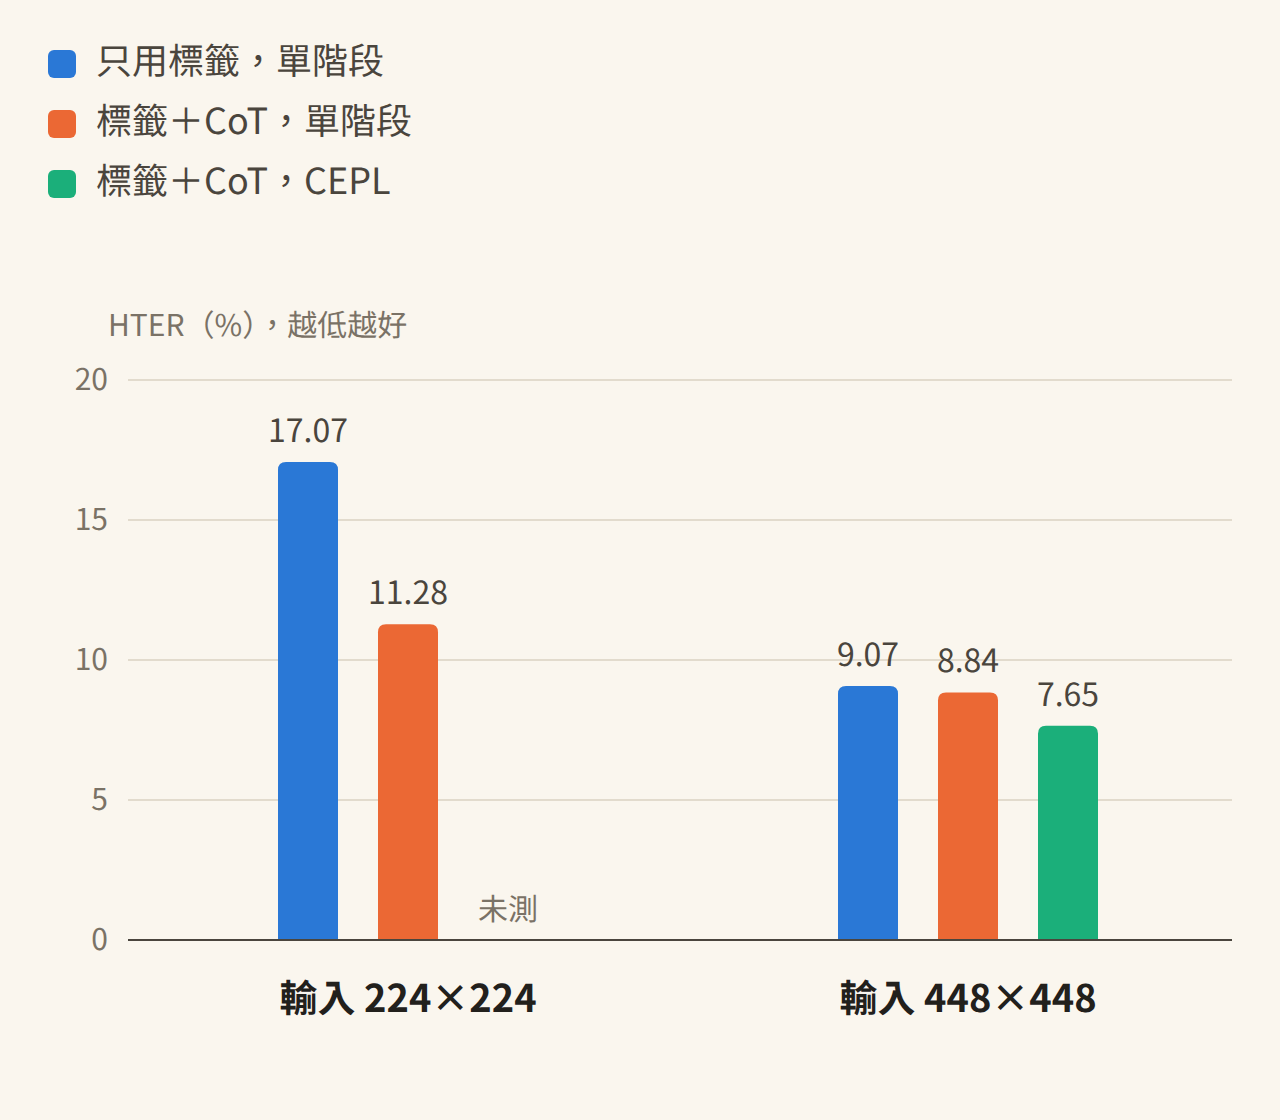
依序看這張圖:
- 影響最大的是解析度。只用標籤,從 224 換成 448,HTER 從 17.07% 降到 9.07%。
- CoT 在低解析度時幫最多。224 下加入六段推理,HTER 降了將近 6 個百分點;到了 448,同樣是單階段訓練,只降 0.23。作者的解讀是,推理文字幫模型找回低解析度下看不清的細節。反過來說,影像夠清楚的時候,那段文字能補的就不多了。
- 448 下有差的是 CEPL,從 8.84% 降到 7.65%。
- CEPL 之後再加強化學習,沒有更好,HTER 是 7.80%。作者認為監督資料已經夠多,強化學習的邊際效益很小。
附錄也提到,包括 I-FAS 在內,多數防偽方法都用 224×224 的輸入。主表裡這篇用 448×448 去比,從上面的消融來看,光是這一項就可能佔了不小的優勢。
資料品質也有一組對照。用只做監督式微調的 caption 模型標出來的資料訓練,HTER 是 8.00%;換成加了強化學習的版本,降到 6.87%。
換骨幹、零樣本、舊考法
- 換骨幹:MiniCPM-V-2.6-8B 零樣本的平均 HTER 是 17.91%,訓練後 6.30%;Qwen2.5-VL-7B 零樣本 19.60%,訓練後 9.32%。兩個骨幹都受益,MiniCPM-V 的結果比較好。
- 最難的攻擊:在 Rose-Youtu 上,訓練後抓得最差的仍是靜止的紙本(68.00%)和 Mac 螢幕播放的影片(71.36%)。
- OCIM:附錄另外跑了 O、C、I、M 四個資料集輪流當測試集的舊考法,平均 HTER 1.06%,I-FAS 是 1.33%。四組裡有兩組的 HTER 輸給 I-FAS:ICM→O 是 2.81% 對 1.74%,OCI→M 是 0.42% 對 0.32%。作者自己也說,這組考法的 AUC 都已經超過 99%,分不太出高下。
還沒回答的問題
- HTER 的門檻:論文沒說門檻怎麼決定,也沒說最多 10 個 epoch 裡用的是哪一個 checkpoint。AUC 不需要門檻,受的影響比較小。
- 推理是否忠實:六段推理最早是 GPT-4o 看著答案寫的,模型學的是這種寫法;評分又取自推理之前的第一個 token。模型寫出來的理由,是否就是它實際依賴的線索,論文沒有檢驗。作者在限制裡也提到,FaceCoT 可以拿來評估可解釋性,但這次還沒做。
- 推論成本:8B 的模型吃 448×448 的影像,論文沒有報推論時間。
- 開放程度:資料集要簽協議向作者申請,只限學術用途,而且只釋出文字標註,影像得自己向 CelebA-Spoof 和 WFAS 取得。GitHub 上寫著模型權重和程式碼「論文正式接受後公開」,目前仍標示為未公開。
結論
FaceCoT 做了一份 108 萬筆、每筆六段推理的防偽問答資料。前十萬筆由 GPT-4o 對著答案寫、人工收尾,其餘由一個用強化學習調過的標註模型擴充。拿它訓練 MiniCPM-V,One-to-Eleven 的平均 HTER 降到 6.30%;只用 CelebA-Spoof 的影像,也有 8.56%。
不過最實用的是消融表。只用標籤,把輸入從 224 換成 448,HTER 就從 17.07% 降到 9.07%;在 448 下,六段推理在單階段訓練裡只再幫了 0.23 個百分點。如果你手上的多模態防偽模型還在吃 224 的人臉,先把解析度調上去,再決定要不要花一千美元請 GPT-4o 寫詳解。
同一屆 CVPR 的 TAR-FAS 走了另一條路。它沒有把推理寫得更長,改讓模型在推理途中叫出 LBP、FFT 這些老工具來看。兩篇用的是同一套 One-to-Eleven,只用 CelebA-Spoof 訓練時,TAR-FAS 的 7.54% 比這篇的 8.56% 低一些,只是骨幹和輸入解析度都不一樣。
至於開頭那些被當成真人的紙本和螢幕,倒也不能全怪通用模型。一開始,連 GPT-4o 都要人提醒,才知道拍一張報紙也算犯規。