原始論文
Sharpness-Aware Minimization for Efficiently Improving Generalization
- 發表版本
- ICLR 2021會議
- arXiv 首次提交
- arXiv:2010.01412
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{optimizerssam2020,
  title = {{Sharpness-Aware Minimization for Efficiently Improving Generalization}},
  author = {Pierre Foret and Ariel Kleiner and Hossein Mobahi and Behnam Neyshabur},
  year = {2020},
  eprint = {2010.01412},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2010.01412}
}
同一個 ResNet,用 SGD 訓練,最後停在一個又尖又窄的洞裡;換一種訓練法,停在一個寬寬的碗底。兩個點的訓練損失都很低,模型的參數也一樣多。
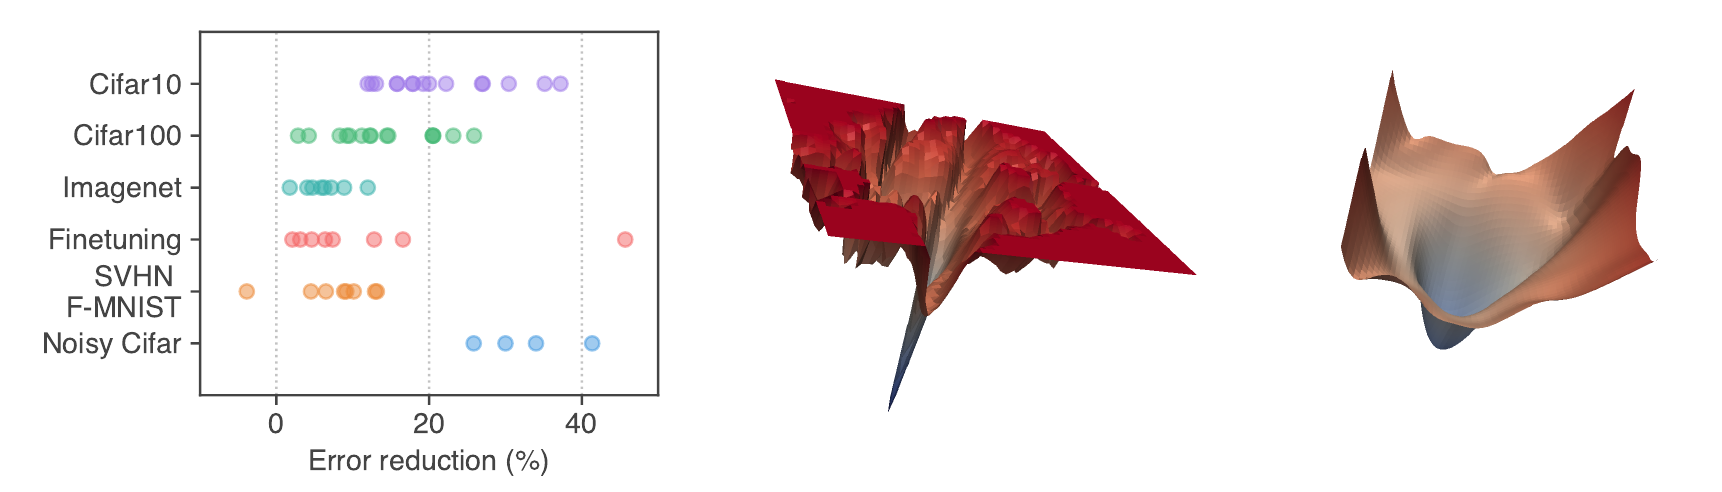
中間和右邊這兩張地形圖,是 Google Research 的 Pierre Foret、Ariel Kleiner、Hossein Mobahi 與 Alphabet 旗下 Blueshift 的 Behnam Neyshabur 放在論文第一頁的畫面(用的是拿掉殘差連接的 ResNet-56)。左圖是他們的戰績。幾十組設定裡,換成 SAM 後錯誤率幾乎都下降,降幅從幾個百分點到四成以上都有。
「平坦的最小值泛化比較好」這個說法很老,至少能追到 1990 年代。這篇的作法是,既然想要平坦,就把平坦直接寫進目標函數裡,而且要便宜到能拿去訓練 ImageNet。
定義問題
現代神經網路的參數多到可以把訓練資料整個背下來。訓練損失有很多個幾乎一樣低的最小值,它們在測試集上的表現卻差很多,選哪一個,很大程度取決於優化器和它的設定。
尖銳度(sharpness)和泛化的關係已經有很多研究。Keskar 等人觀察到大批次訓練容易停在尖的最小值、泛化較差;Jiang 等人在 2019 年比較了 40 種複雜度度量,以尖銳度為基礎的度量和泛化差距的相關最高。
問題在於,過去提出的尖銳度度量大多很難算,更難微分。Entropy-SGD 改去正則化局部熵,SWA 把訓練末段的權重平均起來,可以落到較平坦的位置,但它沒有直接最小化尖銳度。作者要的是一個可以直接優化尖銳度、又能擴展到大模型的程序。
解決問題
從泛化界到 min-max
起點是一個 PAC-Bayes 泛化界(Theorem 1 的非正式版本)。對任意 ,高機率下
是母體損失, 是訓練損失, 是一個遞增函數。把右邊拆開:
中括號量的是「從 出發,在半徑 的球裡,損失最多能升多少」,就是尖銳度。作者把 換成一般的 L2 正則 ,得到 SAM 的目標:
不再找「本身損失低」的點,改找「整個鄰域的損失都低」的點。
一階近似:
內層的最大化沒辦法精確求解。作者對 在 做一階泰勒展開:
在範數球裡讓內積最大,答案是經典的對偶範數問題。取 時,解就是把梯度縮放到長度 :
也就是沿著梯度方向往「上坡」走 那麼遠。附錄裡也試了 (),效果不如 ;隨機方向、同樣長度的擾動也不如沿梯度的擾動。
接著要算 的梯度。 本身是 的函數,連鎖律會帶出一項 ,裡面藏著 Hessian:
第二項可以用 Hessian-vector product 算,作者為了省計算直接丟掉,最後的梯度是
到擾動後的點 去取梯度,再拿這個梯度更新原本的 。
丟掉二階項是近似,作者在附錄做了對照。訓練前半段,有沒有二階項的兩種更新方向幾乎一樣,cosine 相似度接近 1;接近收斂時才分開,而且不含二階項的版本測試錯誤反而較低,作者坦承「quite unclear」。他們也試過內層多走幾步投影梯度上升,把最壞點找得更準,CIFAR-10 的測試錯誤在 1、2、3、5 步時分別是 2.77%、2.76%、2.73%、2.77%,差不多;CIFAR-100 多步稍好一些(16.72% 對 16.6% 左右)。
兩次梯度
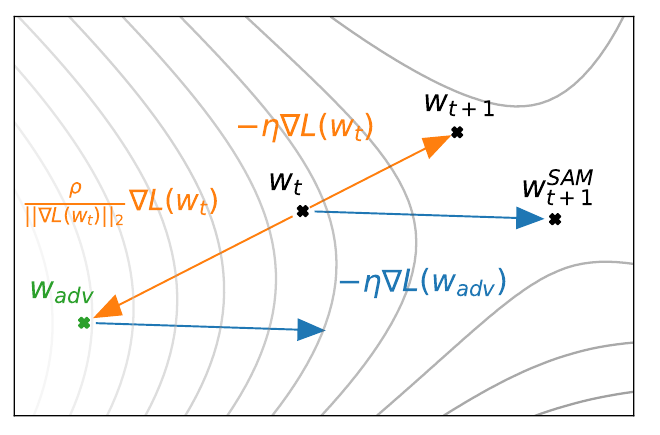
沿著這張圖走一遍。從 開始,一般的 SGD 會沿 走到右上的 。SAM 先反過來,沿梯度往上坡走一小段,到達 ,這是半徑 內損失最高的點的一階估計。在 算梯度,得到藍色箭頭 ;把這支箭頭搬回 出發,終點才是 SAM 的 。兩個終點方向不同,SAM 走的是「最壞情況下也能下降」的方向。
所以每一步要兩次前向與反向傳播,計算量是原本的兩倍。寫成 PyTorch,基底優化器是一般的 SGD:
import torch

def sam_step(model, loss_fn, x, y, base_opt, rho=0.05):
    """一次 SAM 更新(p = 2):先走到鄰域裡最壞的點,再拿那裡的梯度更新原本的權重"""
    params = [p for p in model.parameters() if p.requires_grad]

    loss_fn(model(x), y).backward()                    # 第 1 次反傳:∇L(w)
    with torch.no_grad():
        norm = torch.norm(torch.stack([p.grad.norm() for p in params]))
        eps = [rho * p.grad / (norm + 1e-12) for p in params]   # ε̂ = ρ ∇L / ‖∇L‖₂
        for p, e in zip(params, eps):
            p.add_(e)                                  # w → w + ε̂
    base_opt.zero_grad()

    loss_fn(model(x), y).backward()                    # 第 2 次反傳:∇L(w + ε̂)
    with torch.no_grad():
        for p, e in zip(params, eps):
            p.sub_(e)                                  # 回到 w
    base_opt.step()                                    # w ← w − η ∇L(w + ε̂)
    base_opt.zero_grad()
這裡的範數是把所有參數的梯度串成一條向量來算的,整個模型共用一個 。
怎麼選
是 SAM 唯一新增的超參數。作者在 裡用 10% 的訓練資料當驗證集挑選,CIFAR 上挑出來的值在 0.02 到 0.2 之間;他們也說 是「solid default」,附錄把全部 CIFAR 與微調實驗改用 0.05 重跑,結果和調過 的版本多半相同或只差一點,全部仍勝過不用 SAM 的基準。ImageNet 的實驗全部用 0.05。
注意 是參數空間裡的絕對距離。同一個 0.05,對數值大的權重是小擾動,對數值小的權重是大擾動。這件事後面會再出現。
討論
比較條件
每個實驗都是把原本的訓練程序直接換成 SAM。因為 SAM 每步算兩次梯度,作者讓不用 SAM 的基準跑兩倍的 epoch,取標準長度與加倍長度中較好的那個;他們說多數情況下加長沒有明顯幫助。每組設定跑 5 次,報平均與 95% 信賴區間。實作用 JAX;多卡時,每張卡用分到的子批次各自算 與 SAM 梯度,最後再平均。這個細節後面會變得很重要。
CIFAR
CIFAR 的模型是已經被調得很好的 WideResNet、Shake-Shake 與 PyramidNet,本身就帶有各種正則化。挑幾行看:
| 模型與增強 | CIFAR-10 | CIFAR-100 |
|---|---|---|
| WRN-28-10,200 ep,基本 | 2.7/3.5 | 16.5/18.8 |
| WRN-28-10,1800 ep,AA | 1.6/2.2 | 12.8/16.1 |
| PyramidNet,基本 | 2.7/4.0 | 14.6/19.7 |
| PyramidNet+ShakeDrop,AA | 1.4/1.6 | 10.3/10.6 |
整理自原論文 Table 1;每格為「SAM/SGD」的測試錯誤率(%),AA 是 AutoAugment。
一個單純的 WideResNet 加上 SAM,CIFAR-10 錯誤率從 2.2% 降到 1.6%,原本得靠 PyramidNet 加 ShakeDrop 這類複雜組合才到得了。在已經重度正則化的 PyramidNet+ShakeDrop 上,改善就小得多,CIFAR-100 從 10.6% 到 10.3%,但這也是當時不用額外資料的最佳成績。
ImageNet
ResNet-50、101、152,批次 4096,SGD 加動量、cosine 排程、label smoothing,,最多訓練 400 個 epoch。
| 模型 | 100 ep | 200 ep | 400 ep |
|---|---|---|---|
| ResNet-50 | 22.5/22.9 | 21.4/22.3 | 20.9/22.3 |
| ResNet-101 | 20.2/21.2 | 19.4/20.9 | 19.0/22.3 |
| ResNet-152 | 19.2/20.4 | 18.5/20.3 | 18.4/20.9 |
整理自原論文 Table 2;每格為「SAM/標準訓練」的 top-1 錯誤率(%)。
橫著讀這張表。標準訓練從 200 到 400 epoch 不進反退,ResNet-101 從 20.9% 退到 22.3%,是典型的過擬合;SAM 一路變好。再按計算量對齊,SAM 跑 200 epoch 的成本約等於標準訓練 400 epoch,ResNet-50 是 21.4% 對 22.3%,ResNet-152 是 18.5% 對 20.9%,SAM 仍然贏。換成 100 對 200 epoch,ResNet-50 的 SAM 是 22.5%,略輸標準訓練的 22.3%。
微調
從公開的 EfficientNet 檢查點微調,EfficientNet-L2 本身已經用 NoisyStudent 在 ImageNet 加 JFT 上訓練到 88.2%。加上 SAM 微調後,ImageNet 的 top-1 錯誤率從 11.8% 降到 11.39%,CIFAR-100 從 4.07% 到 3.92%,Stanford Cars 從 4.93% 到 4.04%;其中 ImageNet 與 CIFAR-100 都刷新了當時紀錄。微調時凍結了 BN 的統計量,ImageNet 只訓練 10 個 epoch。
標籤雜訊
既然 SAM 找的是「附近都不怕擾動」的參數,作者猜它對訓練資料的雜訊也比較有抵抗力。實驗把 CIFAR-10 訓練集一部分標籤隨機打亂,測試集保持乾淨,訓練 ResNet-32 共 200 個 epoch:
| 方法 | 20% | 40% | 60% | 80% |
|---|---|---|---|---|
| SGD | 84.8 | 68.8 | 48.2 | 26.2 |
| Mixup | 93.0 | 90.0 | 83.8 | 70.2 |
| SAM | 95.1 | 93.4 | 90.5 | 77.9 |
| Bootstrap+SAM | 95.4 | 94.2 | 91.8 | 79.9 |
| MentorMix | 95.6 | 94.2 | 91.3 | 81.0 |
整理自原論文 Table 4;欄位是雜訊比例,數值為乾淨測試集準確率(%);MentorMix 為文獻數字。
80% 的標籤是錯的時候,SGD 只剩 26.2%,SAM 還有 77.9%。單純用 SAM,就勝過所有專門處理雜訊標籤的方法,只輸 MentorMix;先訓練一次、再用模型自己的預測當標籤重訓(Bootstrap),就和 MentorMix 差不多。 在這組實驗取 0.1,80% 雜訊時改成 0.05 才收斂得穩。
m-sharpness:每張卡各自擾動
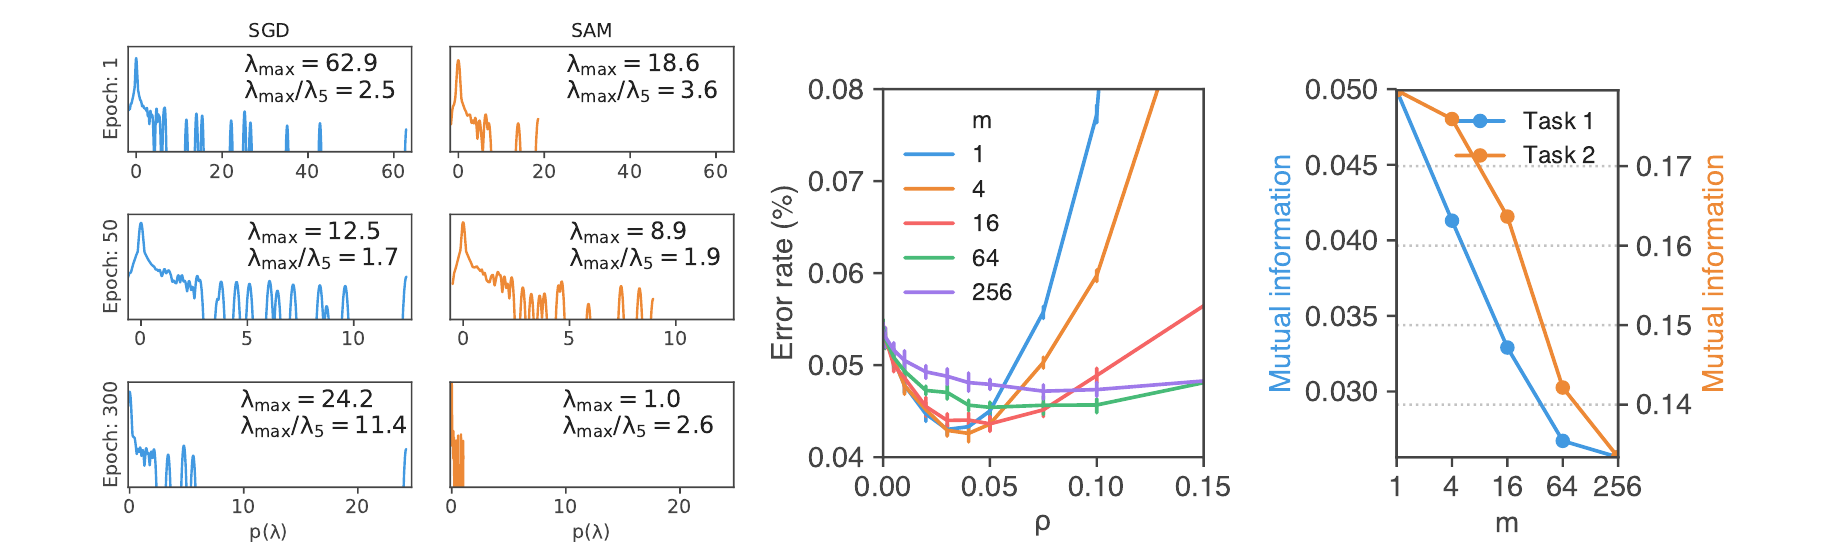
前面提過多卡時每張卡各自算擾動。這等於把目標改成「每 筆資料各自做一次最大化,再加總」, 是每張卡分到的樣本數;作者把這種尖銳度叫 m-sharpness。
先看中圖。縱軸雖然標著 %,數值是比例,0.05 就是 5%。 時錯誤率約 5.3%。 與 的最低點約 4.3%,但 超過 0.05 之後很快變差; 的紫線最平,最低也只到約 4.7%。小 的效果較好,剛好也和多卡平行的需求相容。右圖則顯示, 越小,m-sharpness 對實際泛化差距的預測力越強。作者據此認為,m-sharpness 可能比全訓練集的尖銳度更能描述泛化。
左邊六張小圖確認 SAM 真的停在曲率較低的地方。這是不含 BN 的 WideResNet-40-10,用 Lanczos 方法估 Hessian 的特徵值分佈;訓練結束時,SGD 的最大特徵值約 24,SAM 約 1.0;描述整體分佈的 從 11.4 降到 2.6。
這一節有個實作上的推論。在 PyTorch 的 DistributedDataParallel 裡,backward() 會自動把各卡的梯度平均,第一次反傳若照常同步, 就變成用整個批次算的, 一下子變大。davda54/sam 的建議是第一次反傳放在 model.no_sync() 裡,保持每張卡各自擾動。
後來對 SAM 的理解
尖銳度本身有問題
SAM 發表前三年,Dinh 等人就指出「平坦」這個概念在深度網路上站不太穩。ReLU 滿足 ,所以把某一層權重乘 、下一層除以 ,網路算出來的函數完全一樣,但損失地形在參數空間裡的形狀被拉伸了。他們先在單隱藏層網路上證明、再推廣到多層,對任何 Hessian 不為零的最小值,都能找到函數相同、Hessian 譜範數任意大的參數。函數一樣,泛化當然一樣,尖銳度卻可以隨便調,所以在原始參數座標下量的尖銳度,本身沒辦法解釋泛化。
SAM 的 也有同樣的問題,它是參數空間裡的絕對距離。ASAM(Kwon 等人,2021)把擾動範圍改成依權重大小縮放,約束改成 ,其中 ,這樣的「adaptive sharpness」在上述縮放下不變。 時擾動變成 ,權重越大的座標擾動越大; 因此要大約 10 倍(CIFAR-10 用 0.5、CIFAR-100 用 1.0)。ResNet-50 在 ImageNet 的 top-1 準確率,SGD、SAM、ASAM 分別是 75.79%、76.39%、76.63%。
泛化界解釋不了 SAM
Andriushchenko 與 Flammarion(2022)回頭檢查 SAM 的理論依據。泛化界推導出來的是對全訓練集做最大化的版本,他們稱為 n-SAM;論文實際在用的是每批次擾動的 m-SAM。在 CIFAR 上實測,隨機擾動幾乎沒用,n-SAM 也幾乎沒用,只有低 的版本(例如 128-SAM)明顯改善泛化。如果泛化界是原因,n-SAM 應該最好,結果剛好相反。他們的結論是,現有的泛化界解釋不了 SAM,而且以 m-sharpness 衡量的「更平坦」也不一定帶來更好的泛化。
他們也提出一些可用的觀察。在對角線性網路上,1-SAM 的隱式偏差偏好較稀疏的解,比 n-SAM 和一般訓練都強;在 CIFAR 上,只在最後約 10% 的 epoch 從一般訓練切到 SAM,就能明顯改善泛化,所以可以拿 SAM 微調現成模型。
2023 年 Andriushchenko 等人把範圍拉到 ImageNet 上的 Transformer、CLIP 微調和 BERT。結果是尖銳度(包括 adaptive sharpness)和泛化的相關並不好,反而和學習率之類的訓練設定相關;在好幾個情況下,越尖的最小值在分佈外資料上表現越好。
被用得很多
理論吵歸吵,SAM 在實務上被廣泛使用。Chen 等人(2022)發現,不用大規模預訓練、只用簡單資料增強在 ImageNet 從頭訓練時,ViT 收斂到的最小值極尖;加上 SAM 後,ViT-B/16 的 top-1 從 74.6% 升到 79.9%,MLP-Mixer-B/16 從 66.4% 升到 77.4%。NFNet 最大的 F6 模型,也是加上 SAM 才拿到 86.5% 的準確率。
結論
SAM 把「整個鄰域的損失都要低」寫成一個 min-max 目標,用一階近似把內層最大化變成「沿梯度往上走 」,再在那個點取梯度更新原本的權重。代價是每步兩次反向傳播。在 CIFAR、ImageNet、微調與雜訊標籤上,它都普遍勝出;CIFAR 的比較還讓基準多跑了一倍的 epoch。
實際要用, 是好的起點,預算要抓兩倍;帶 BN 的模型記得第二次前向不要更新統計量,多卡時第一次反傳別同步,讓每張卡各自擾動。預算不夠的話,可以只在訓練最後一段、或微調時開 SAM。
至於「平坦才會泛化」這句話,到 2023 年還有論文在反駁;SAM 倒是一直被拿來用。