原始论文
Large Batch Optimization for Deep Learning: Training BERT in 76 minutes
- 发表版本
- ICLR 2020会议
- arXiv 首次提交
- arXiv:1904.00962
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{optimizerslamb2019,
  title = {{Large Batch Optimization for Deep Learning: Training BERT in 76 minutes}},
  author = {Yang You and Jing Li and Sashank Reddi and Jonathan Hseu and Sanjiv Kumar and Srinadh Bhojanapalli and Xiaodan Song and James Demmel and Kurt Keutzer and Cho-Jui Hsieh},
  year = {2019},
  eprint = {1904.00962},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1904.00962}
}
LARS 投稿 ICLR 2018 时被拒了。审稿结论写得很具体,指出它只在 ImageNet 一个任务上验证、多了超参数,逐层缩放学习率也没有理论依据。
一年后,LARS 的第一作者 Yang You 到 Google Brain 当学生研究员,带回一篇把这几条意见都回应了的论文。新的任务是 BERT,新的优化器是 LAMB,另外还有两条收敛定理。标题也不客气,直接写上「76 分钟」。
定义问题
BERT-Large 的预训练分两段,先用长度 128 的序列跑 90 万步,最后 10 万步改用长度 512,batch 都是 512。在 16 块 TPUv3 上大约要 3 天(论文测得 81.4 小时)。
想缩短时间,最直接的办法是加机器、加大 batch,但两条现成的路都走不通。一条是 LARS,它在 ResNet-50 上把 ImageNet 训练压到几分钟,换到 BERT 却不灵:
| batch | 512 | 4K | 8K | 16K | 32K |
|---|---|---|---|---|---|
| LARS | 90.72 | 90.54 | 90.55 | 89.59 | 发散 |
| LAMB | 91.75 | 91.14 | 91.26 | 91.35 | 91.48 |
整理自原论文 Table 2,SQuAD v1.1 开发集 F1,节选部分列;官方 BERT-Large 的 F1 为 90.395。
另一条是 BERT 本来就在用的 AdamW。作者试了三种调法,分别是照 BERT 的默认设置、照搬 LAMB 的超参数,以及自己重调。到 16K 时 F1 只有 88.1,达不到 90.4 的目标;附录的调参表里,预热短一点的设置全部发散。到了第一段 64K、第二段 32K 的混合 batch,「调了很久也得不到合理的结果」。
能不能保留 Adam 逐元素自适应的好处,再加上 LARS 那种逐层的信任比例,让 BERT 撑过 32K?这是这篇要回答的问题。
解决问题
两步改造
作者先把 LARS 抽象成一个套在任何基础优化器上的通用策略。假设基础算法(SGD 或 Adam)每层的更新是 ,改成:
- 每一层的更新先归一化成单位长度:。
- 学习率逐层乘上 , 是权重范数的某个函数。
以 SGD 为基础,第 层的更新就是
第一步只留下方向,丢掉梯度的大小。这会让更新有偏,但作者认为 batch 很大时梯度的方向大致可靠,偏差不大;好处是梯度忽然变得极大或极小,都不会直接放大成更新。第二步让更新的量级跟着权重走。实践中作者用
也就是把权重范数夹在上下界之间,避免刚初始化、范数很小或很大的层拿到离谱的比例。论文没有交代 、 实际设成多少。
若 ,整体学习率相当于乘上 ,正是 LARS 的 trust ratio。作者另外把这个比值解读成该层梯度 Lipschitz 常数倒数的粗略估计,曲率大的层自动走小步。
LAMB
把基础优化器换成 Adam,就是 LAMB(Layer-wise Adaptive Moments optimizer for Batch training)。每一步先照 Adam 算一阶、二阶矩并做偏差修正:
接着把解耦的权重衰减加进去,再对整层做 trust ratio 的缩放:
这里有两层自适应。 在层内逐元素调整步子,trust ratio 在层与层之间拉齐更新相对于权重的比例。权重衰减放在范数里面,是作者刻意的选择,衰减项和 Adam 的更新一起决定这一层要走多远。默认值是 、、、,学习率用 BERT 原本的线性衰减 。作者还指出, 时 LAMB 退化成 signSGD,学习率乘上该层维度的平方根。
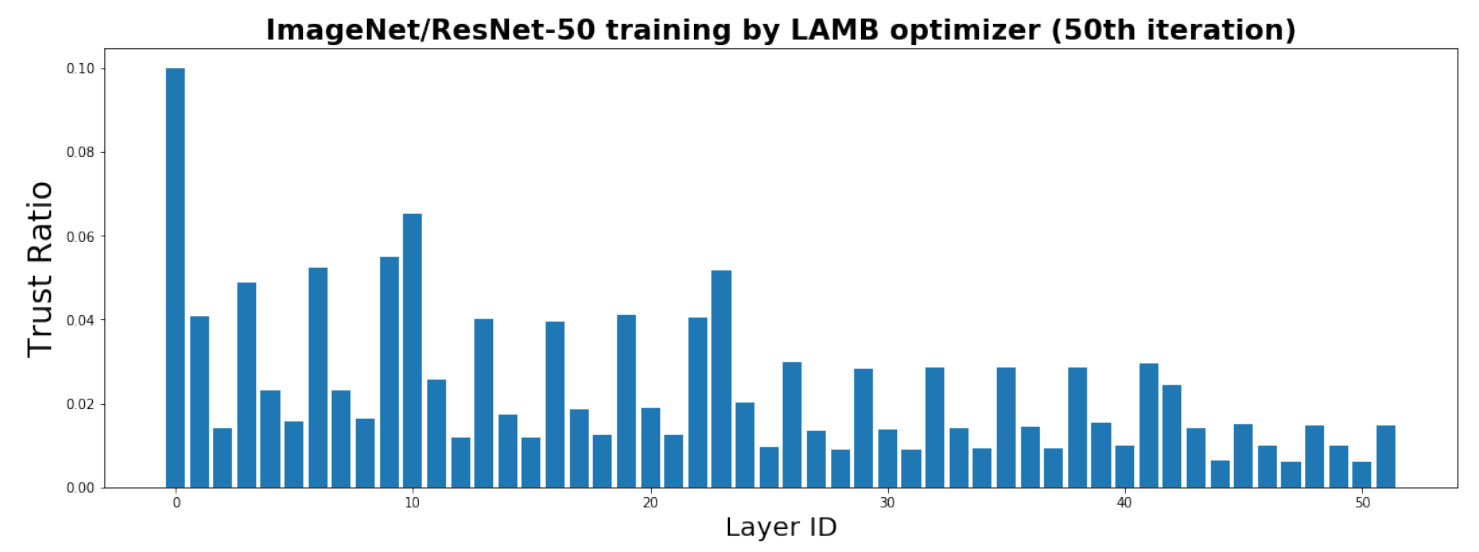
这张附录图记录了 ResNet-50 训练到第 50 次迭代时每一层的 trust ratio。横轴是层的编号,纵轴是比例。第一层最高,约 0.10;后段最低的几层只有 0.006 左右,相差十几倍,同一个残差块里的几层还会高低交替。作者把这解读为 trust ratio 在帮「学得慢的层」加速。
收敛分析
这是 LARS 当年被要求补上的部分。作者在非凸、带 正则化的随机优化下,假设损失对第 层是 -smooth,定义 (最陡的那一层)与 ( 层的平均)。
对照组是 SGD。batch 大小 等于总步数 、学习率选得恰当时,SGD 的界取决于 。直觉和 LARS 那张各层比值表一样,全网络共用一个学习率,就只能迁就最陡的那一层。
LARS(Theorem 2)与 LAMB(Theorem 3)的界则换成 ,前提包括:
- ,也就是 batch 大到和总步数同阶;
- 分析只做 、权重衰减 的情况;
- 有正的上下界 ;
- LAMB 依赖 的那个界,还要求 、每层参数一样多; 时作者只得到一个较差的界,并说相信 时的实际表现应该比 更好,留待未来研究。
两边的收敛准则也不同,SGD 测的是梯度范数的平方,LARS 测的是各层梯度范数加总后的平方。作者在附录说明,只有梯度比曲率和噪声「更稠密」时,LARS 的界才胜过 SGD,否则 SGD 的上界比较好。换句话说,这两条定理说明了逐层缩放在某些条件下有好处,而实验用的 、 不在定理的范围内。
讨论
3 天到 76 分钟
BERT 的实验沿用官方的数据(Wikipedia 25 亿词加 BooksCorpus 8 亿词)与 SQuAD v1.1 的微调流程,微调设置一律不改。LAMB 只调一个学习率,batch 加大时连这个也不重调,按平方根规则缩放,batch 512 用 ,每加倍乘上 ,到 32K 是 ;预热比例则从总步数的 1/320 一路加到 1/5。epoch 数固定,batch 越大步数越少。
| batch | 步数 | TPUv3 | 时间 | F1 |
|---|---|---|---|---|
| 512(官方) | 1000k | 16 | 81.4 h | 90.395 |
| 512 | 1000k | 16 | 82.8 h | 91.752 |
| 4K | 125k | 128 | 693.6 m | 91.137 |
| 16K | 31,250 | 512 | 200.0 m | 91.345 |
| 32K | 15,625 | 1024 | 101.2 m | 91.475 |
| 64K/32K | 8,599 | 1024 | 76.19 m | 90.584 |
整理自原论文 Table 1,节选部分行。
32K 是一整个 TPUv3 Pod(1,024 块芯片)在序列长度 512 时放得下的上限。15,625 步里,长度 128 跑 14,063 步、长度 512 跑 1,562 步,约 100 分钟,用 64 倍的资源换到 49.1 倍的加速。
要再快,作者让两段用不同的 batch。第一段序列短,batch 可以开到 131,072,但从 65,536 再往上已经没有加速,于是第一段用 65,536、第二段回到 32,768。batch 由大变小时训练会乱掉,作者的处理是在第二段开头把学习率从 0 重新预热一次,再照常衰减。这样总共 8,599 步,76 分钟。
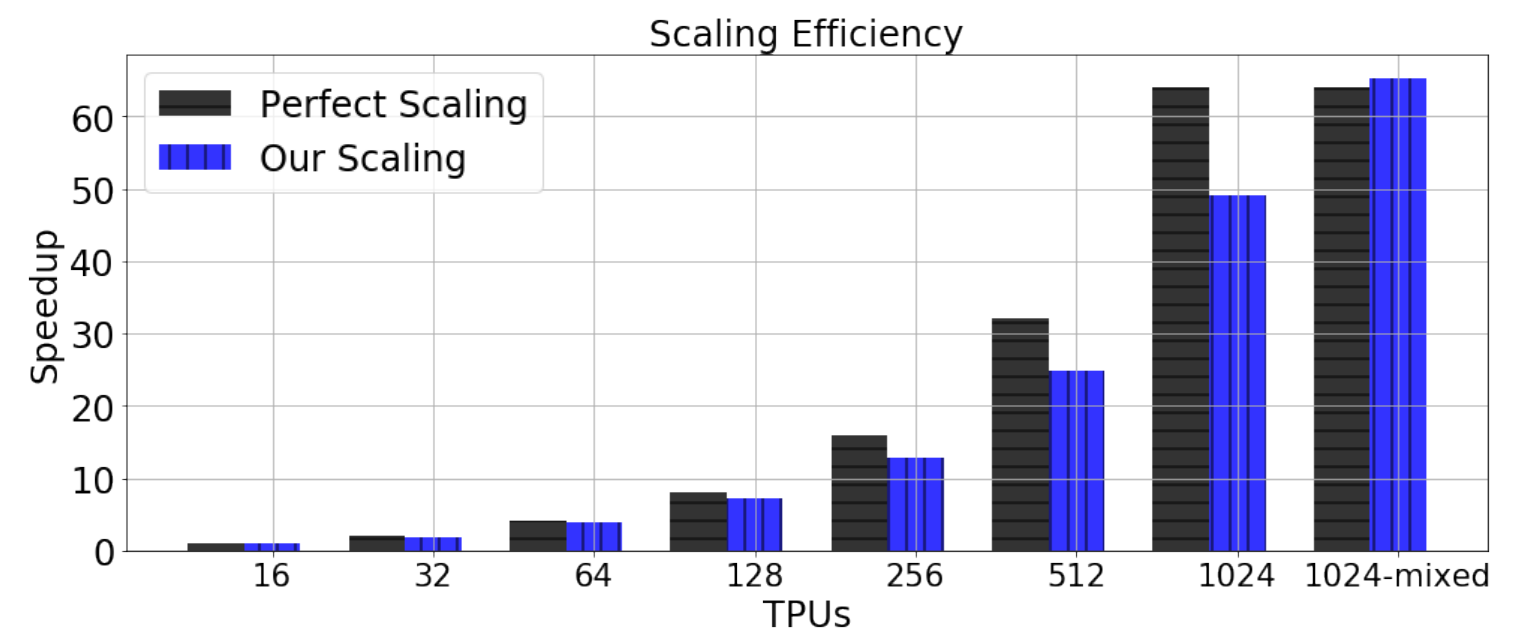
黑色柱子是理想的线性加速,蓝色是实测。1,024 块芯片、batch 32K 时只拿到 49 倍;作者把差距归因于梯度同步的通信量,BERT 有 3 亿个参数,ResNet-50 只有 2,500 万。最右边的混合 batch 测到 65.2 倍,超过理想值并不奇怪,它的步数比固定 32K 时少了将近一半。
76 分钟这个数字要配着 F1 一起读。混合 batch 的 90.584 高于官方 BERT 的 90.395,却是 LAMB 自己所有设置里最低的一个,其他设置都在 91.1 到 91.9 之间。
ImageNet
ResNet-50 这边,作者想证明 LAMB 这种自适应方法也能达到动量 SGD 的水平。batch 16K、90 个 epoch,AdaGrad、Adam、AdamW 充分调参后只有 55.38%、66.04%、67.27%;套上 Goyal 等人的预热与分段衰减,也只到 72.01%、73.48%、73.07%。Goyal 等人报告的动量 SGD 是 75.20%,LAMB 是 76.66%。batch 从 512 到 32K、完全不重调时,LAMB 的 top-1 都在 76.42% 到 77.11% 之间,32K 最低;和 LARS 相比,32K 是 76.4% 对 76.3%。
Reality Check
两年后,Google 的 Nado 等人在〈A Large Batch Optimizer Reality Check〉中重做了 BERT 的实验,结论直接写在副标题上,传统的通用优化器在各种 batch size 下都够用。
他们沿用同一套两段式设置与相同的步数,只把 LAMB 换回 Adam,认真重调:
| batch | 步数 | LAMB | Adam |
|---|---|---|---|
| 32K | 15,625 | 91.48 | 91.58 |
| 64K/32K | 8,599 | 90.58 | 91.04 |
| 64K | 7,818 | – | 90.46 |
整理自 Nado 等人 Table 3,SQuAD v1.1 开发集 F1;LAMB 的数字取自 LAMB 论文。
batch 32K 时,Adam 的预训练损失也比较低,1.277 对 1.342。全程用 64K,Adam 在 7,818 步就达到 90.46,比 LAMB 的混合 batch 还少了七百多步。
双方的条件差在哪里?Nado 等人点出两个实现细节,可能让 LAMB 论文里的 Adam 吃了亏。一是 BERT 开源代码里的 Adam 没有偏差修正,而偏差修正本身就有预热的效果;二是 BERT 的学习率调度在衰减起点有一个断崖,衰减在预热期间就被错误地套用了,这段代码存在于 GitHub 上三千多份 BERT 训练代码的副本里。调参的力度也不一样。Nado 等人对两段预训练分别搜索学习率、、、预热曲线的次方与权重衰减,每段约 30 次试验,64K 的第二段用了 130 次, 固定为 。反过来说,他们没有重跑 LAMB,比较的是步数而非实测的墙钟时间;他们的论点是 Adam 计算比较简单,同样的步数在优化过的系统上不会比较慢。
他们也在 ResNet-50 上(batch 32,768、6,000 步)把 LAMB 原封不动地套到所有参数,结果只有 27.3%;BatchNorm 参数和偏置项改用 Adam 之后回到 76.3%。逐层归一化对某些参数确实可能有害,而 LAMB 论文没有说明这些参数怎么处理。他们在讨论里写道,LARS 和 LAMB 的更新规则和「大 batch」的关系,并不比动量或 Adam 更深;收敛界依赖的假设(没有动量、)离实践很远,Adam 也能证出类似的界。
另一个角度来自 MoCo v3。Chen、Xie 与 He 在 2021 年用自监督方法训练 ViT 时也试了 LAMB,在 ViT-B/16、batch 4096 的设置下,LAMB 在学习率 时拿到 72.5%,略胜 AdamW;学习率调到 和 ,准确率就掉了 1.6 和 6.0 个百分点。作者认为它对学习率太敏感,不方便拿来做消融比较。
结论
从 81 小时到 76 分钟,LAMB 靠的是把 LARS 的逐层信任比例搬到 Adam 上,再加上 1,024 块 TPUv3、混合 batch 与第二段的重新预热;它也补上了 LARS 缺的收敛定理。后来的检验显示,只要 Adam 的实现没有缺陷、每一段都认真调过,同样的 batch 与步数下它不输 LAMB;定理成立的条件也和实际训练差得很远。
换用 LAMB 之前,先看清楚库里实现的是哪一版,偏差修正、、梯度预先归一化各有没有,LayerNorm 和偏置项是否排除在 trust ratio 之外。然后用同样的步数,认真调一组有偏差修正的 Adam 当对照。
76 分钟的纪录,最后是被 LAMB 想取代的 Adam 用更少的步数追平的。