原始论文
UCMCTrack: Multi-Object Tracking with Uniform Camera Motion Compensation
- 发表版本
- AAAI 2024会议
- arXiv 首次提交
- arXiv:2312.08952
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingucmctrack2023,
  title = {{UCMCTrack: Multi-Object Tracking with Uniform Camera Motion Compensation}},
  author = {Kefu Yi and Kai Luo and Xiaolei Luo and Jiangui Huang and Hao Wu and Rongdong Hu and Wei Hao},
  year = {2023},
  eprint = {2312.08952},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2312.08952}
}
只靠运动来跟踪的方法,最怕镜头在动。
人明明站着不动,镜头一转,他在画面上的位置就跑了一大段。卡尔曼滤波预测的框和新检测到的框对不上,IoU 掉到 0,跟踪就断了。
常见的解法有两种:加上外观特征,或是做相机运动补偿(CMC),每一帧都估计镜头怎么动,再把轨迹的位置修正回来。BoT-SORT、StrongSORT、Deep OC-SORT 都这样做。两种方法都有效,但都要额外的计算。逐帧的相机运动补偿要在每一帧提取特征点、算光流或做图像配准,视频分辨率一高就很吃力。
长沙理工大学的 Kefu Yi、Kai Luo、Wei Hao 等人提出 UCMCTrack,换了一个角度。与其在画面上跟踪,不如把每个人投影回地面上去跟踪;镜头的晃动,就当成运动模型里的噪声来处理。整段视频只用一组固定的补偿参数,不必逐帧计算。
定义问题
作者想回答的是,能不能只用运动线索,又不怕镜头移动,而且不必逐帧做相机运动补偿?
他们认为问题出在 IoU 和图像平面。
IoU 是最常用的关联距离,但只要两个框没有重叠,它就是 0。镜头抖动、采样率低、目标移动快,都会让预测框和检测框完全分开。GIoU、DIoU、C-BIoU 这些改进,让不重叠的框也能算出分数,但它们都还是在图像平面上计算。
图像平面上的位置,混进了镜头的运动和透视的变形。同样是往前走一步,靠近镜头的人在画面上移动得多,远处的人移动得少。人实际上是在地面上走路,真正有规律的运动,要到地面上才看得到。
SparseTrack 用估计的伪深度、Quo Vadis 把位置投影到鸟瞰图上算距离,都朝这个方向走了一步,但它们还是搭配 IoU 使用,也没有处理投影带来的不确定性。
解决问题
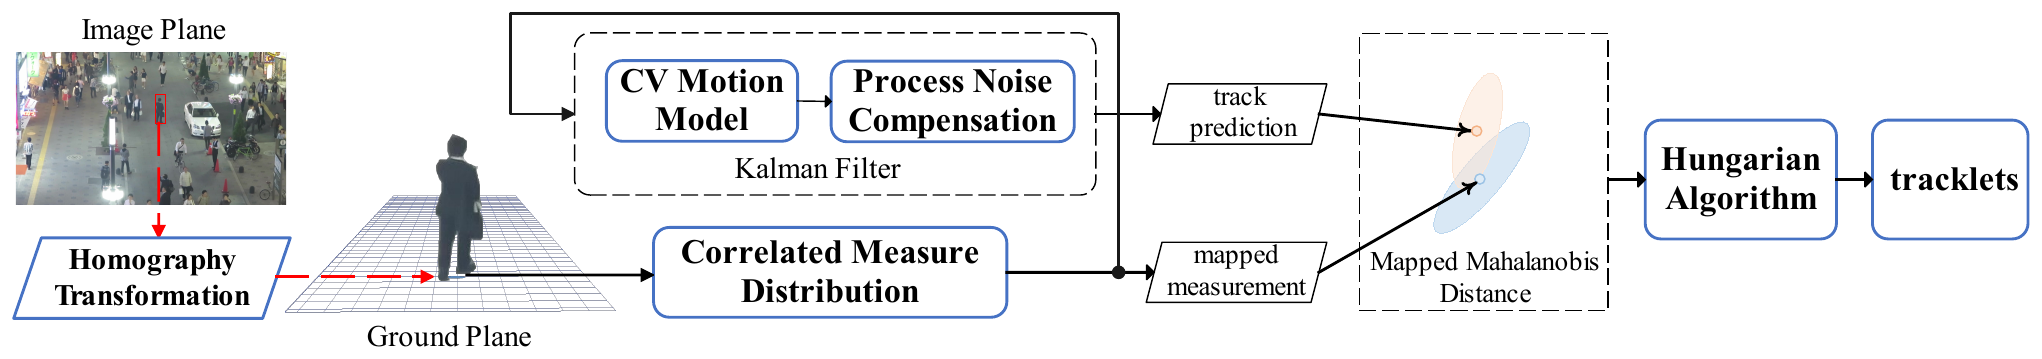
UCMCTrack 仍然是先检测、再关联,只用运动线索。它改的是在哪里建运动模型、用什么距离匹配,以及怎么处理镜头的晃动。
在地面上建运动模型
一个人的检测框,取它底边的中点,大致就是脚踩在地上的位置。用相机的内参和外参,把这个点从图像坐标 投影到地面坐标 :
是由相机内参和外参组成的投影矩阵, 是尺度因子。
卡尔曼滤波就在地面上运行,状态只有地面位置和速度 ,用最简单的匀速模型。SORT 系列跟踪的是框的中心、面积和长宽比,这里则完全不管框的大小。
投影之后,误差也要跟着投影
检测器的误差是在图像上产生的。作者假设图像上的误差在两个方向上相互独立,大小和框的宽高成比例:
是检测噪声系数,、 是检测框的宽高。
这个误差投影到地面上,两个方向就不再独立了。用投影的一阶近似,地面上的误差协方差是
由投影矩阵 的逆矩阵元素和地面位置组成。 不是对角矩阵,说明地面上的误差在 、 两个方向强烈相关,作者称之为相关观测分布(Correlated Measurement Distribution,CMD)。
这在直觉上很合理。从斜上方往下拍,一个人在画面上上下偏了几个像素,投影到地面上,可能就是沿着视线方向前后差了一大段。所以地面上的不确定性,是一个沿着视线方向拉长、而且倾斜的椭圆,而不是一个正圆。
用马氏距离取代 IoU
有了地面上的预测和带有不确定性的观测,匹配的距离就用马氏距离。作者称之为映射马氏距离(Mapped Mahalanobis Distance,MMD),分三步:
- 残差:, 是投影到地面的观测, 是卡尔曼滤波预测的状态。
- 残差的协方差:, 是预测的协方差。
- 归一化的马氏距离:
第一项是一般的马氏距离,残差落在不确定性大的方向上不太扣分,落在不确定性小的方向上扣很多。第二项 则把不确定性本身也算进去。不确定性越大,距离的基础值越高,一个很模糊的观测,就不会因为「什么都有可能」而轻易配上。
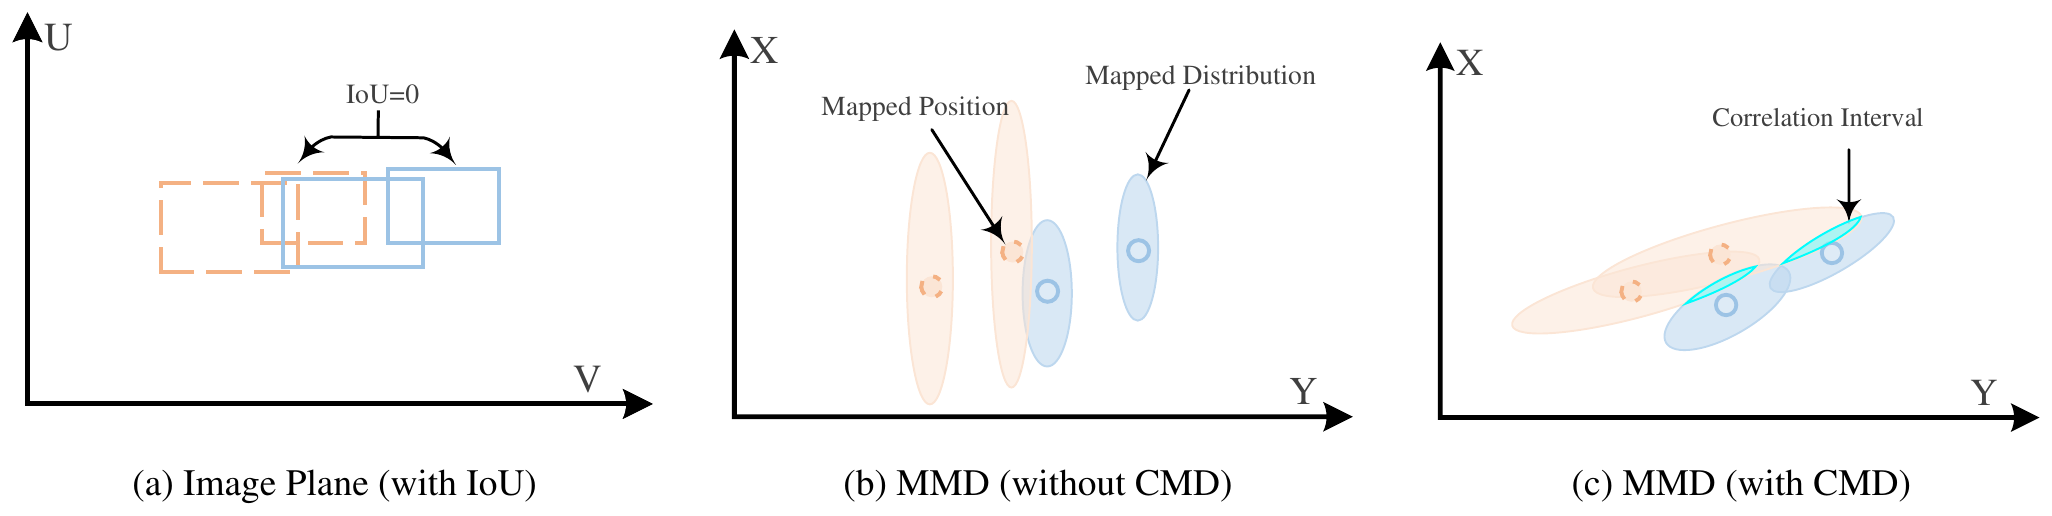
这张图把三种情况并排。(a) 图像上的两组框没有重叠,IoU 完全帮不上忙。(b) 改到地面上算距离,但如果把误差当成两个方向独立,椭圆都是竖直的,距离最近的反而是错的那一个。(c) 用了相关观测分布,椭圆沿着真正的不确定方向倾斜,正确的匹配才浮现出来。
把镜头晃动当成噪声
最后是镜头的运动。作者不去估计每一帧镜头怎么动,而是把它看成一个造成加速度的噪声来源。在时间间隔 内,一个未知的加速度 会让位置和速度分别改变
把它写成矩阵 ,卡尔曼滤波的过程噪声协方差就是
、 称为过程补偿因子,分别吸收镜头倾斜和旋转造成的运动噪声。过程噪声放大,卡尔曼滤波就会更相信新的观测、容许预测偏得更多,镜头一晃造成的位移,就不会让跟踪断掉。
这两个因子在同一段视频里固定不变,这就是标题里「均匀的相机运动补偿」(Uniform Camera Motion Compensation)的意思。和逐帧的相机运动补偿相比,它不需要任何图像处理。作者表示,给定检测结果后,UCMCTrack 在单个 CPU 上每秒可以处理超过 1,000 帧。
其余的流程和 SORT 一样:用匈牙利算法匹配;没配上的轨迹累计丢失时间,超过阈值就删除;没配上、置信度又够高的检测,建立新轨迹。整个方法没有用到 IoU,也没有外观特征。
相机参数从哪里来
把点投影到地面,需要相机的内参和外参。KITTI 提供了这些参数,但 MOT17、MOT20 和 DanceTrack 都没有,作者是手动估计的。
官方代码附带了一个估计工具,用户手动调整三个旋转角、焦距和平移量,让画面上的虚拟地面网格线和图像里的地面对齐。README 也说明,这样估出来的参数未必非常精确,但对 UCMCTrack 来说已经够用。
讨论
检测都沿用 ByteTrack 公开的 YOLOX 权重,KITTI 则用 PermaTrack 的检测结果。UCMCTrack+ 是额外加上 ECC 图像配准的版本,和 StrongSORT 的做法一致。
主要结果
| 方法 | MOT17 HOTA | MOT17 IDF1 | DanceTrack HOTA | DanceTrack AssA |
|---|---|---|---|---|
| ByteTrack | 63.1 | 77.3 | 47.3 | 31.4 |
| OC-SORT | 63.2 | 77.5 | 55.1 | 40.4 |
| C-BIoU | 64.1 | 79.7 | 60.6 | 45.4 |
| SparseTrack | 65.1 | 80.1 | 55.5 | 39.1 |
| BoT-SORT* | 65.0 | 80.2 | — | — |
| Deep OC-SORT* | 64.9 | 80.6 | 61.3 | 45.8 |
| UCMCTrack | 64.3 | 79.0 | 63.4 | 51.1 |
| UCMCTrack+ | 65.8 | 81.1 | 63.6 | 51.3 |
整理自原论文 Table 1、Table 2,测试集;标*的方法另外使用了外观特征。
- MOT17: 不加图像配准的 UCMCTrack 是 64.3,和其他纯运动方法差不多;加上之后的 UCMCTrack+ 是 65.8,比用了外观特征的 BoT-SORT、Deep OC-SORT 还高。
- DanceTrack: 差距更大。UCMCTrack 的 HOTA 是 63.4,比 C-BIoU 高 2.8,衡量关联的 AssA 从 45.4 升到 51.1。只靠位置的运动模型,在舞者身上赢过了加了外观的 Deep OC-SORT。
- MOT20: UCMCTrack 是 62.8,和 MotionTrack 打平,略低于 SparseTrack 的 63.4,也低于用了外观的 Deep OC-SORT(63.9)。这里加不加图像配准都一样,多半是因为 MOT20 的镜头本来就是固定的。
- KITTI: 这是一个 10 FPS、镜头跟着车子移动的驾驶数据集。UCMCTrack 的汽车 HOTA 是 77.1,比 OC-SORT 的 76.5 高;但加上图像配准的 UCMCTrack+ 反而掉到 74.2。作者推测是图像配准的参数估得不准。
每个组件的贡献
消融以 ByteTrack 为基准,在 MOT17 和 DanceTrack 的验证集上逐步替换:
| 设置 | MOT17 HOTA | MOT17 IDF1 | DanceTrack HOTA | DanceTrack IDF1 |
|---|---|---|---|---|
| ByteTrack(IoU) | 68.4 | 77.1 | 47.9 | 47.3 |
| 换成 MMD | 68.1 | 75.9 | 46.3 | 43.8 |
| +相关观测分布 | 70.4 | 79.7 | 55.1 | 53.9 |
| +过程噪声补偿 | 72.0 | 82.2 | 60.4 | 62.6 |
整理自原论文 Table 4,验证集。
- 只把 IoU 换成马氏距离,反而变差。 作者的解释是,IoU 同时考虑了位置和框的高度,MMD 只看地面上的一个点。他们也提到,以后可以把高度信息加进 MMD。
- 加上相关观测分布,就超过了 IoU。 DanceTrack 上从 46.3 跳到 55.1,多了将近 9 分。误差的形状投影对了,地面上的距离才有意义。
- 过程噪声补偿再加一大截。 MOT17 多 1.6 分,DanceTrack 多 5.3 分,IDF1 更是多了 8.7 分。
关于第 3 点,作者自己也说,DanceTrack 大部分视频并没有明显的视角移动,镜头几乎是固定的。那过程噪声补偿在这里补偿的是什么?以下是本文的推测:放大过程噪声,让卡尔曼滤波更愿意相信新的观测、容许更大的预测误差,它吸收的多半是舞者本身突然变向、变速造成的偏差,而不是镜头的晃动。从这个角度看,它和 OC-SORT 修正卡尔曼滤波、C-BIoU 把框撑大,处理的其实是同一个问题。
逐帧补偿,还要不要做
| 设置 | MOT17 HOTA | DanceTrack HOTA |
|---|---|---|
| ByteTrack | 68.4 | 47.9 |
| ByteTrack+逐帧补偿 | 71.0 | 47.6 |
| UCMCTrack | 72.0 | 60.4 |
| UCMCTrack+逐帧补偿 | 73.0 | 59.2 |
整理自原论文 Table 5,验证集。
在 MOT17 上,UCMCTrack 单独使用就比「ByteTrack 加逐帧补偿」好,两者再叠加还能多 1 分。但在 DanceTrack 上,加逐帧补偿反而让两个方法都变差。作者的解释是,DanceTrack 的镜头几乎不动,做了图像配准反而让重叠在一起的人产生微小的位移,配错轨迹。
补偿因子要按场景调
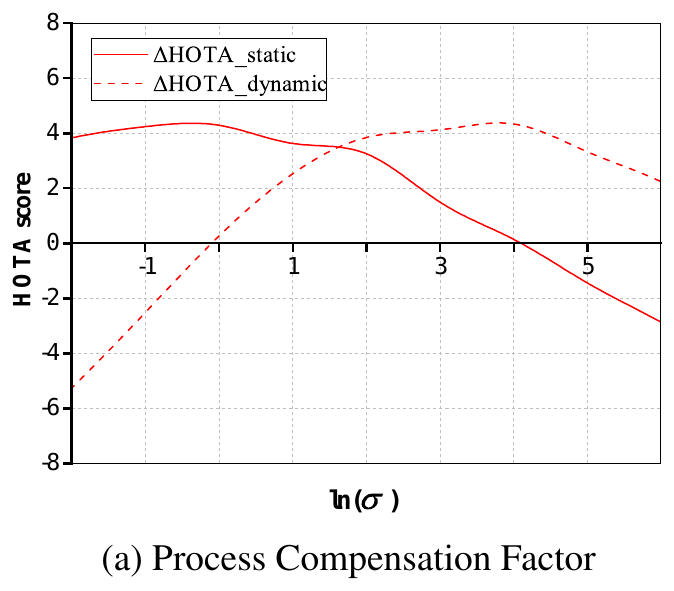
作者把 MOT17 验证集分成镜头固定和镜头移动两组,扫过不同的补偿因子。两组的曲线几乎是反过来的。镜头固定的视频,补偿因子小一点最好,太大反而比基准差;镜头移动的视频,补偿因子要大到 附近,太小则会比基准差 5 分。
所以「均匀」指的是同一段视频里固定不变,不同视频之间还是得各自设置。至于检测噪声系数 ,在 0.05 时最好,在 0.04 到 0.1 之间影响都不大。
相机参数估错了怎么办
相机参数是手动估的,难免有误差。作者分别在外参的三个旋转轴上加入误差:绕竖直轴的偏航误差影响很小,因为它不太会让估出来的地面变形;另外两个轴的误差一大,地面就会明显扭曲,表现也跟着下降。这时就得重新调整参数,让估出来的地面和实际的地面对齐。
这也是使用这个方法时最实际的门槛。官方代码的 issue 里,有好几条都在询问相机参数该怎么估、能不能全自动估计。
结论
UCMCTrack 把多目标跟踪从图像平面搬回地面。检测框的底边中点投影到地面,误差也一起投影成倾斜的椭圆,再用马氏距离取代 IoU;镜头的晃动则当成卡尔曼滤波的过程噪声,整段视频一组参数。它不用外观、不做逐帧的图像配准,在 MOT17 和 DanceTrack 上都追上甚至超过了用外观特征的方法。
代价是需要相机参数,而大部分公开数据集并没有提供,得手动估计;作者也承认,这个方法假设所有人都站在同一个平面上,遇到楼梯、看台、斜坡这类场景就不成立。
跟踪器在画面上看到的,是投影过的世界。把它还原回地面,很多看似不规则的运动,其实只是透视和镜头晃动造成的错觉。