原始论文
Object-Centric Learning with Slot Attention
- 发表版本
- NeurIPS 2020会议
- arXiv 首次提交
- arXiv:2006.15055
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingslotattention2020,
  title = {{Object-Centric Learning with Slot Attention}},
  author = {Francesco Locatello and Dirk Weissenborn and Thomas Unterthiner and Aravindh Mahendran and Georg Heigold and Jakob Uszkoreit and Alexey Dosovitskiy and Thomas Kipf},
  year = {2020},
  eprint = {2006.15055},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2006.15055}
}
这篇不是跟踪论文。
它出现在这个系列里,是因为后来有人拿它来做多目标跟踪。在那之前,得先弄懂它在做什么。
2020 年,Google Brain 的一个团队提出了 Slot Attention。作者名单里,通讯作者 Thomas Kipf 是 GCN 的作者,指导者之一 Alexey Dosovitskiy 几个月后发表了 ViT。同一年,DETR 用一组目标查询把检测改写成集合预测,TrackFormer、MOTR 后来又把目标查询变成了轨迹查询。Slot Attention 做的事情和 DETR 有几分相似,出发点却完全不同,它不给任何标注,让模型自己把画面拆成一个一个物体。
定义问题
卷积网络提取出来的特征图,是一种「分布式」的表示。特征图上的每个位置,都混着这个位置附近所有东西的信息;整张图里有几个物体、各自在哪里,并没有被明确地分开。
很多需要推理的任务,却希望输入是一组一组的物体,例如这里有一个红色立方体、那里有一个绿色圆柱。物理模拟、多智能体、视觉推理,都是以物体为单位在运作。作者把这种表示称为以物体为中心(object-centric)的表示。
问题是,要从原始图像得到这种表示很难,通常要靠监督,或是为特定任务设计的架构。所以很多研究干脆跳过这一步,直接拿模拟器或游戏引擎里的物体状态来用。
已有的几种做法各有毛病:
- IODINE、MONet 这类无监督的场景分解模型,要反复「解码、和原图比对、再编码」好几轮,训练很慢。
- 胶囊网络的每个胶囊会特化成某一类物体,换一种没见过的组合就泛化不了。
- DETR、Set Transformer 这类集合预测方法,每个查询都有自己的一组可学习参数。训练时用 100 个查询,测试时就只能是 100 个。
作者想要一个可以直接接在卷积网络后面的模块。它输入 个特征向量,输出 个「slot」,每个 slot 描述一个物体;而且每个 slot 都长得一样,任何一个都能绑定任何一个物体,数量也能在测试时改变。
解决问题
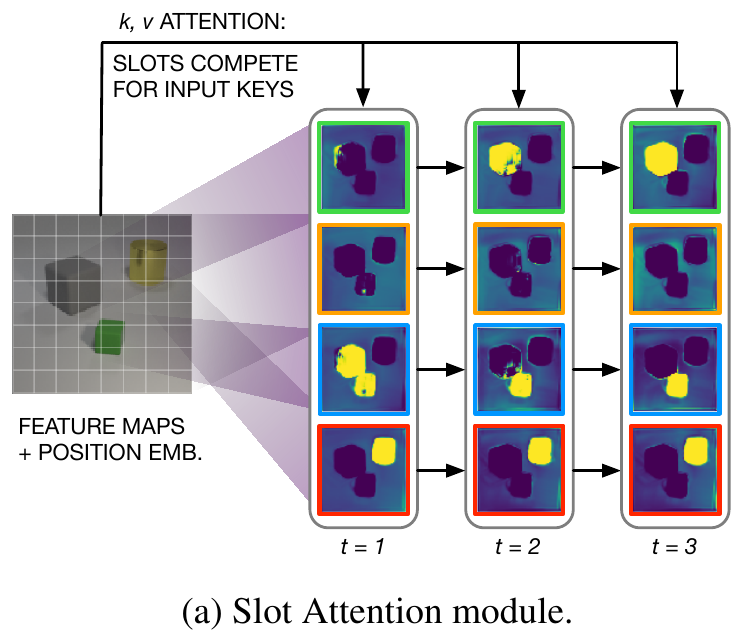
这张图要从左往右看。左边的特征图是输入,右边是四个 slot 在三轮迭代中各自在看哪里。一开始大家都看得很模糊,越到后面,每个 slot 就越专注在一个物体上。
一轮迭代
一开始, 个 slot 从同一个高斯分布中随机采样:
和 是所有 slot 共用的可学习参数。slot 数量之所以能在测试时改变,原因就在这里,要几个就采样几个。
接着重复 次(论文用 )。每一轮先用三个线性投影,把输入变成键 、值 ,把 slot 变成查询 ,算出点积注意力的分数:
一般的注意力,是对每个查询在输入这个方向上做 softmax;Slot Attention 反过来,对每个输入在 slot 这个方向上做 softmax:
也就是说,每一个输入特征,都要把自己的 1 分配给 个 slot。
接着,每个 slot 对分到的输入取加权平均,作为更新的内容:
最后用一个 GRU,以上一轮的 slot 为状态、这一轮的更新为输入,算出新的 slot,再接一个可有可无的残差 MLP。输入和 slot 在每一轮开头都会先做 LayerNorm。
算一次看看
我们用 4 个输入、2 个 slot 走一遍。假设算出来的分数 是:
| slot 1 | slot 2 | |
|---|---|---|
| 输入 1 | 2.0 | 0.0 |
| 输入 2 | 1.5 | 0.5 |
| 输入 3 | 0.0 | 1.8 |
| 输入 4 | 0.2 | 2.2 |
对每一行做 softmax,每个输入把自己分给两个 slot:
| slot 1 | slot 2 | |
|---|---|---|
| 输入 1 | 0.881 | 0.119 |
| 输入 2 | 0.731 | 0.269 |
| 输入 3 | 0.142 | 0.858 |
| 输入 4 | 0.119 | 0.881 |
slot 1 主要拿到输入 1、2,slot 2 主要拿到输入 3、4。再对每一列做归一化,slot 1 的加权平均权重是 0.470、0.390、0.076、0.064,slot 2 是 0.056、0.126、0.403、0.414。两个 slot 就像两个聚类中心,各自分走了一群输入。
为什么要反过来做 softmax?假设两个 slot 刚好长得一样,查询相同,分数的两列都是 2.0、1.5、0.0、0.2。
- 用一般的注意力,对输入做 softmax,两个 slot 会得到一模一样的权重 0.524、0.318、0.071、0.087,两个都盯着输入 1、2,没有人去管输入 3、4。
- 用 Slot Attention 的做法,每个输入在两个 slot 之间平分,各拿 0.5。谁也抢不走谁的,输入 3、4 也一定有人分到。
每个输入都必须被分给某个 slot,slot 之间于是有了竞争:一个 slot 想多拿一点,别的 slot 就得少拿一点。经过 GRU 更新、再进入下一轮,原本微小的差异会被放大,最后各自锁定一个物体。作者在附录的消融中也验证了这一点,把 softmax 改回对输入做,两个任务的表现都明显变差。
至于为什么用加权平均、不用加权和?因为分数是对 slot 归一化的,每个 slot 拿到的总量并不固定,上例是 1.873 和 2.127,一个没分到物体的 slot 可能趋近于 0。用加权和,更新的大小会跟着忽大忽小;用平均,训练才稳定。
整个模块的计算量是 。
对称性
作者证明了 Slot Attention 有两个性质:对输入的顺序不变,对 slot 的顺序等变。打乱输入,输出不变;打乱初始 slot 的顺序,输出也只是跟着打乱。
这保证了每个 slot 都用同一种格式表示物体,不会出现「1 号 slot 专门负责立方体」这种事。DETR 的目标查询则不同,每个查询有自己的参数,训练久了常会各自偏好某些位置或大小。
两种用法
无监督的物体发现。 把 Slot Attention 放进一个自编码器。编码器是卷积网络加上位置嵌入,再接 Slot Attention;解码器把每个 slot 各自展开成一张图,输出 RGB 和一张掩码。所有 slot 的掩码在 slot 之间做 softmax,当作混合权重,把各自的图合成一张,和原图比较重建误差。整个过程不需要任何标注。
有监督的集合预测。 编码器一样,每个 slot 接一个共用的 MLP,预测物体的属性。预测和标签的顺序都是任意的,所以用匈牙利算法匹配,和 DETR 的做法相同。
讨论
物体发现
作者在三个合成数据集上评估:CLEVR6(最多 6 个物体的 CLEVR 立体场景)、Multi-dSprites(彩色的 2D 形状)和 Tetrominoes(俄罗斯方块)。指标是 ARI,衡量分割结果和真实物体的吻合程度,排除背景,100 是完美。
| 方法 | CLEVR6 | Multi-dSprites | Tetrominoes |
|---|---|---|---|
| Slot Attention | 98.8 | 91.3 | 99.5 |
| IODINE | 98.8 | 76.7 | 99.2 |
| MONet | 96.2 | 90.4 | — |
| Slot MLP | 60.4 | 60.3 | 25.1 |
整理自原论文 Table 1,ARI(%),五个随机种子的平均。Tetrominoes 排除了一次失败的训练。
Slot MLP 是把 Slot Attention 换成一个 MLP 的基准,输出的 slot 有固定顺序。它的分数低得多,说明「每个 slot 格式相同、可以绑定任何物体」这个设计是必要的。
Slot Attention 和 IODINE 打平或更好,真正的差距在效率。在 CLEVR6 上,一张 16 GB 的 V100 可以用 64 的批大小,IODINE 只能用 4;用 8 张 V100 训练约 24 小时,IODINE 要大约 7 天。
作者也坦白了一个失败模式。在 Tetrominoes 上,偶尔会有一次训练卡在把画面切成横条纹的解,五次里有一次。这种情况的重建误差明显偏高,训练时就看得出来;表上的分数排除了这一次。
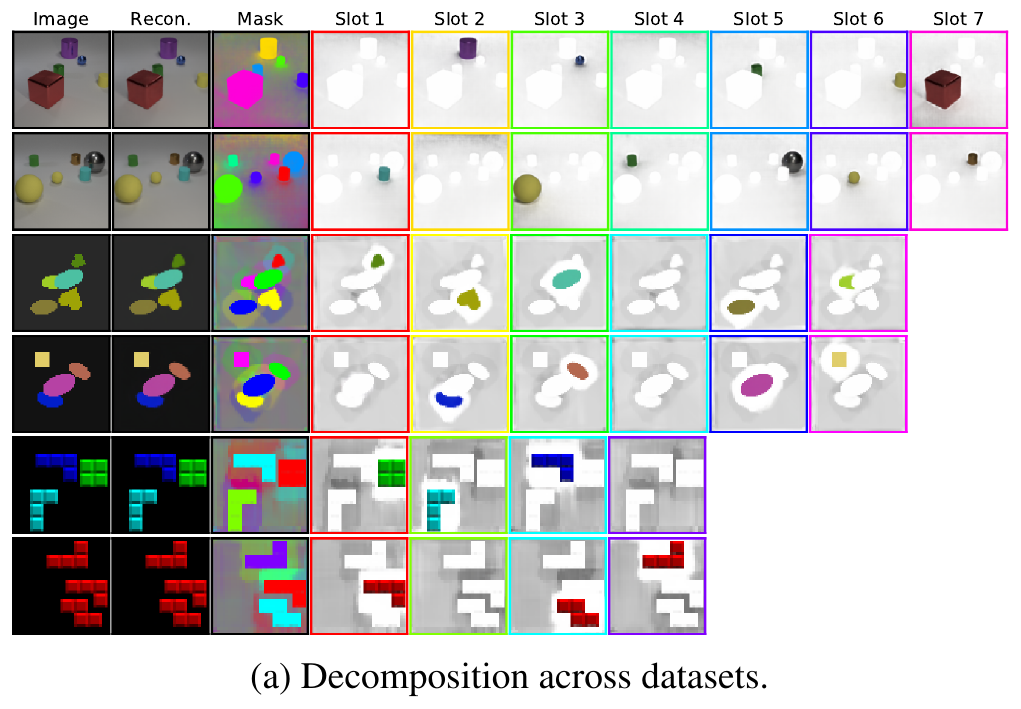
从这张图可以看到,slot 比物体多的时候,多出来的 slot 会保持空白,只分到一点背景。作者也观察到,均匀的背景常常被分散到所有 slot,而不是集中在其中一个;这不影响物体的分离和重建。
如果把每一轮迭代的注意力画出来,第二轮时各个 slot 就已经开始专注在单一物体上,第一轮则还会把几个物体混在同一个 slot 里。
比训练时更多的迭代、更多的物体
训练时用 3 轮迭代,测试时增加到 7 轮,分数还会继续上升。用 CLEVR6 训练、在最多 10 个物体的 CLEVR10 上测试,把 slot 从 7 个增加到 11 个,分割的表现仍然很好。这正是共用初始分布带来的好处,DETR 那种每个查询各有参数的设计做不到。
为了确认它不只是靠颜色在聚类,作者也试了只看形状的版本。在黑底白色的二值化 Multi-dSprites 上,ARI 是 69.4,IODINE 是 64.8;在灰度的 CLEVR6 上是 98.5。
集合预测
在 CLEVR10 上预测每个物体的形状、材质、颜色、大小和位置,以 AP 衡量。Slot Attention 和先前的 DSPN 相当或更好,而 DSPN 用的是更深的 ResNet-34 编码器。增加测试时的迭代次数同样有帮助;用 6 个物体的场景训练、在物体更多的场景测试,AP 只会缓慢下降。
这个任务只训练模型预测属性,从没给过任何分割标注,但 slot 的注意力图却自然地把物体分开了,ARI 达到 78.0。
消融与局限
附录的消融里,几个设计都被证明有用。加权平均比加权和稳定;位置嵌入对预测物体位置不可或缺;所有 slot 共用初始分布,在无监督任务上比每个 slot 各自一组参数好,也才能在测试时增加 slot;至少要迭代两轮以上。slot 的数量只需要给一个大致的上限,不必刚好等于物体数。
作者也说明了局限。所有实验都在受控的合成数据上进行;物体发现用的解码器和重建损失和 IODINE 相同,预计遇到复杂的背景和纹理时一样会吃力,可能需要换成感知损失或对比损失。
结论
Slot Attention 用一个很小的改动,把注意力的 softmax 从输入那一侧换到 slot 那一侧,让一组长得一样的 slot 互相竞争,最后各自认领画面中的一个物体。加上共用的初始分布和 GRU 更新,它不用标注就能把合成场景分解成物体,训练比 IODINE 快好几倍,slot 的数量和迭代次数都能在测试时调整。
作者在结论里列出的第一个下一步,就是把它用在视频上。一年多后,同样出自 Kipf 等人之手的 SAVi 把 slot 延伸到视频,让上一帧的 slot 成为下一帧的初始值,同一个物体就能跨帧被同一个 slot 抓住。这听起来已经很像跟踪了。
再过一年多,有人把这套以物体为中心的做法,正式带进了多目标跟踪。