原始论文
Matching Anything by Segmenting Anything
- 发表版本
- CVPR 2024会议
- arXiv 首次提交
- arXiv:2406.04221
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingmasa2024,
  title = {{Matching Anything by Segmenting Anything}},
  author = {Siyuan Li and Lei Ke and Martin Danelljan and Luigi Piccinelli and Mattia Segu and Luc Van Gool and Fisher Yu},
  year = {2024},
  eprint = {2406.04221},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2406.04221}
}
2023 年前后,检测和分割有了「什么都认得」的基础模型。SAM 能把一张图里所有东西都切出来;Detic、Grounding-DINO 能根据文字检测上千种类别。
跟踪却还停在原地。学关联的方法,几乎都要用标好 ID 的视频来训练,而这种数据很贵,也很窄:MOT17 只有行人,BDD100K 只有路上的八类东西。在行人数据上学到的外观特征,拿去跟踪动物、跟踪卡通人物,就不灵了。
苏黎世联邦理工学院(ETH)的 Siyuan Li、Lei Ke、Fisher Yu 等人想找一个办法,让关联也能像检测一样「什么都跟得了」。他们完全不用视频,只用一堆没有标注的照片。
定义问题
学关联,需要知道「这一帧的这个东西,和那一帧的那个东西,是同一个」。这就是 ID 标注,是跟踪数据里最贵的部分。
过去也有人试过不用标注。UniTrack 这类方法,直接拿自监督学到的图像特征来做关联。问题是这些特征通常在 ImageNet 这种「一张图一个主角」的数据上训练,学的是整张图的相似度。到了一张图里有几十个东西的街景,它们分不太清楚谁是谁。
作者要解决的是两件事:
- 对应关系从哪里来。 没有视频,怎么知道两个东西是同一个?
- 怎么接到现有的模型上。 检测和分割已经有很强的基础模型,关联的能力最好能直接加上去,不要动到它们原本的能力。
解决问题
一张照片,两个视角
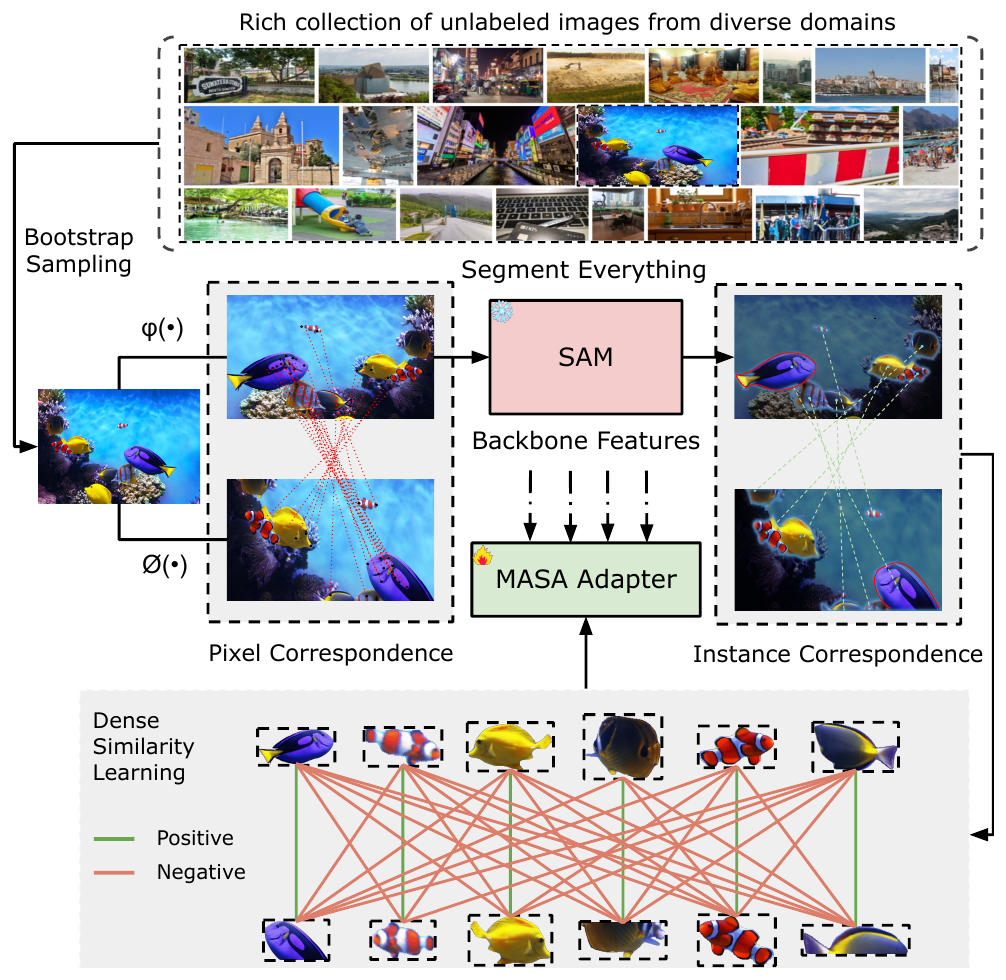
MASA 拿一张照片,做两种不同的强增强,例如一边放大、平移、改颜色,另一边缩小、翻转、混进别的图。两个视角看起来差很多,但因为是我们自己变换的,哪个像素对到哪个像素都知道。
这模拟的是视频里同一个物体在两帧之间的变化:位置变了、大小变了、光线变了,东西还是同一个。
光有像素对应还不够,要的是「物体」的对应。SAM 会把照片里的每个东西都切成一块掩码。同一块掩码里的像素属于同一个物体,像素对应就变成了物体对应。
让同一条鱼靠近,不同的鱼远离
有了物体对应,训练就是标准的对比学习。同一个物体在两个视角的特征是正样本,要拉近;和其他所有物体都是负样本,要推远:
是余弦相似度,温度 。
这里 SAM 的价值在于负样本。一张复杂的照片,SAM 可以切出上百个物体,每个物体都是其他物体的负样本。温度这么低,最像的那几个负样本会主导损失,用几个数字算算看。
| 情况 | 正样本相似度 | 负样本相似度 | 损失 |
|---|---|---|---|
| 负样本都不像 | 0.80 | 0.30、0.20、0.10 | 0.001 |
| 有一个很像的 | 0.80 | 0.75、0.20、0.10 | 0.40 |
本文整理的算例。
只把一个负样本换成「长得很像的另一条鱼」,损失就大了将近 400 倍。模型被迫去学那些能分辨相似物体的细节。跟踪最难的,正是分辨长得很像的东西。
接在基础模型后面的适配器
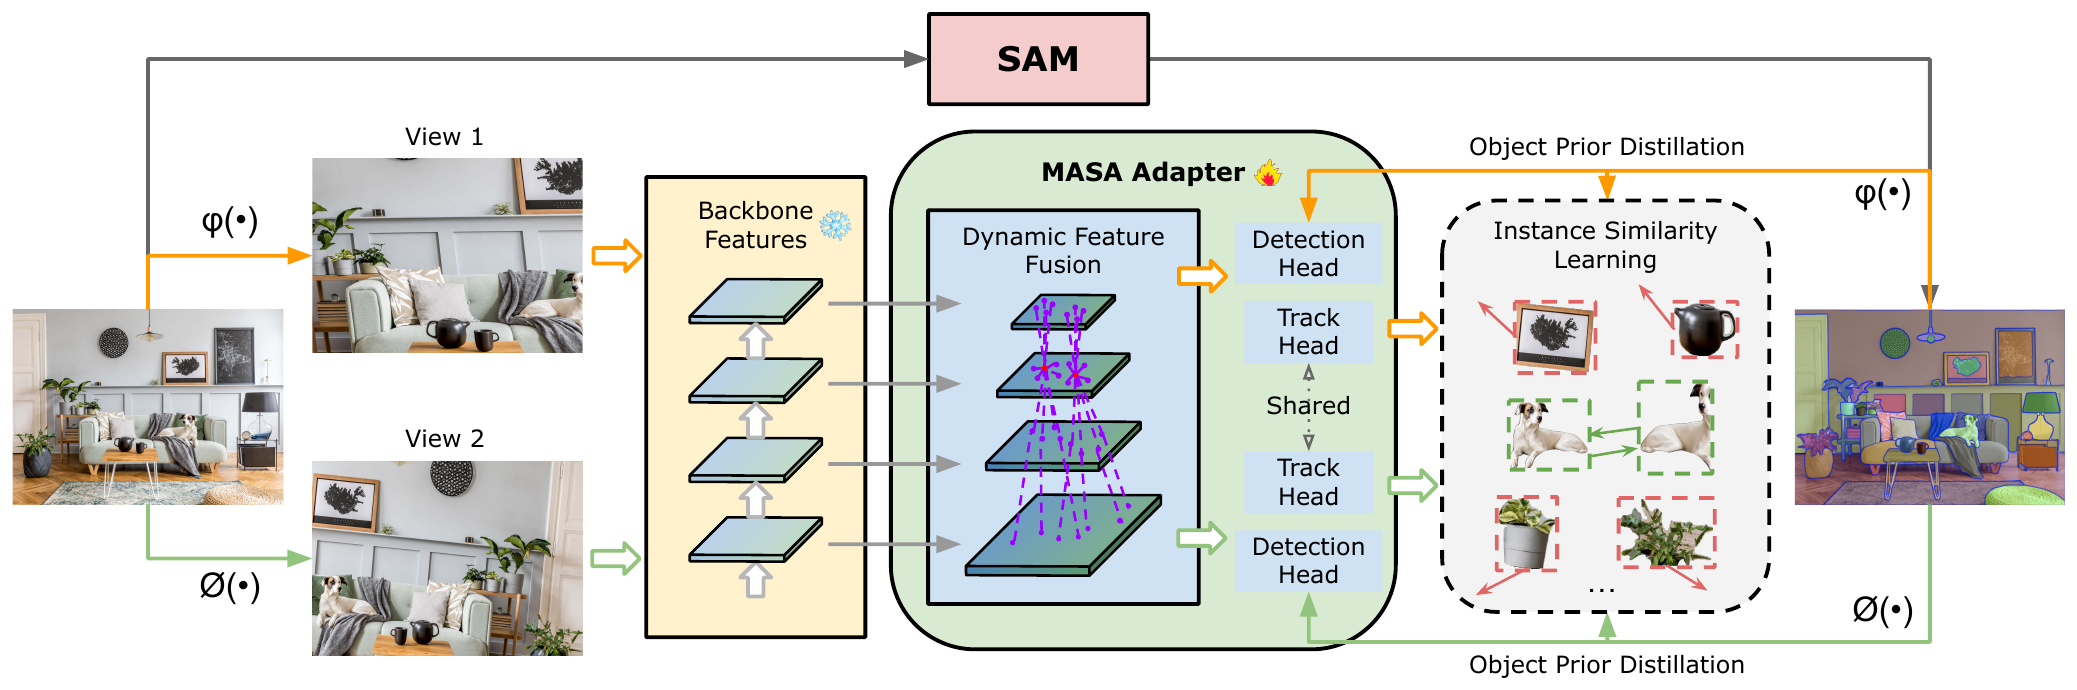
学到的关联能力,要能加到任何检测或分割模型上。作者设计了一个 MASA 适配器,接在冻结的骨干网络后面。骨干不动,原本的检测、分割能力就不受影响。
适配器做三件事:
- 建特征金字塔。 Swin Transformer 本身有多尺度特征,直接接 FPN;SAM 的 ViT 只有单一尺度,就用转置卷积和池化造出四个尺度。
- 动态特征融合。 用可变形卷积跨位置、跨尺度聚合信息。作者的理由是,要分辨不同的物体,每个位置的特征最好也知道别的地方长什么样子。
- 跟踪头。 根据物体框用 RoI-Align 取出特征,经过 4 层卷积和 1 层全连接,输出每个物体的嵌入向量。
训练时还有一个辅助任务:一个检测头,学着预测 SAM 掩码的外框。这等于把 SAM 对「什么算一个物体」的知识,蒸馏到适配器的特征里。
推理时的两种用法
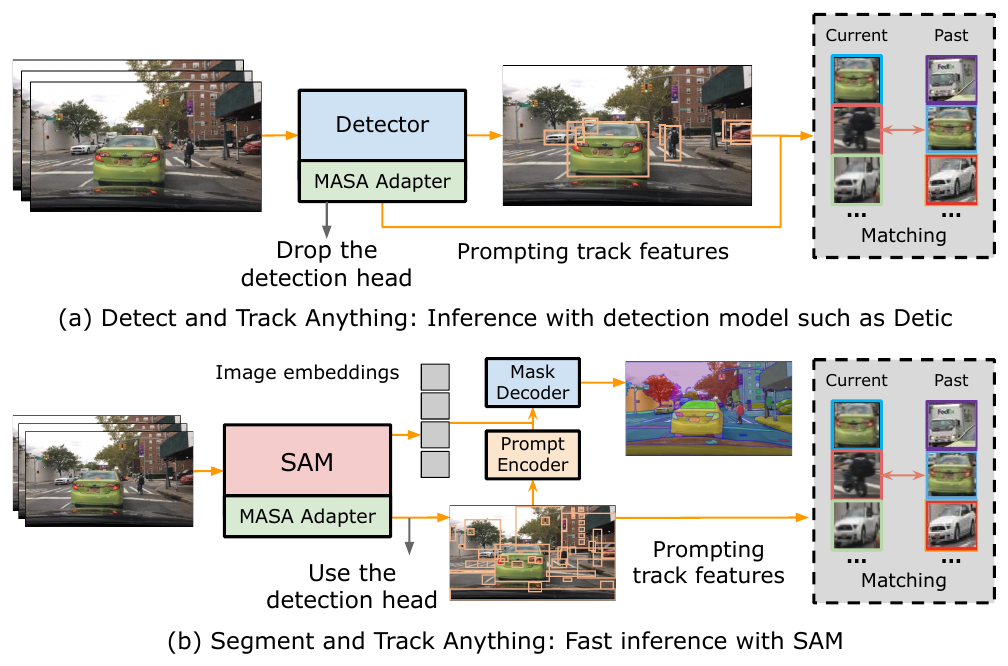
接检测器的时候,训练用的检测头就丢掉,检测器给什么框,适配器就为那些框生成跟踪特征。
接 SAM 的时候,检测头反而派上用场。SAM 原本要「切出所有东西」,得在画面上撒大约一千个点当提示,再做繁琐的后处理。MASA 的检测头直接给出物体框当提示,作者在 UVO 上测得,达到同样的召回率,速度大约快 10 倍。
匹配的方式沿用 QDTrack 系列的双向 softmax:一个物体和一条轨迹的分数,要同时在「这条轨迹的所有候选」和「这个物体的所有轨迹」两个方向都高,才算配得上;再和余弦相似度平均。
训练数据是从 SA-1B 抽出的 50 万张照片。所有基准测试用的都是同一组权重,没有在任何一个测试领域上训练过,也就是零样本关联。
讨论
和领域内训练的方法比
为了只比较关联能力,作者在每个基准上都使用和当时最强方法相同的检测结果:
| 基准 | 对手(领域内训练) | 对手 AssocA | MASA AssocA |
|---|---|---|---|
| TAO TETA | TETer | 36.7 | 37.6 |
| BDD MOTS | UNINEXT-H | 53.2 | 54.5 |
| BDD MOT | ByteTrack | 51.5 | 52.9 |
TAO 整理自原论文 Table 1,BDD MOTS 整理自原论文 Table 4,BDD MOT 整理自原论文 Table 5,均为验证集;MASA 各取表中最佳的变体。
这些对手都在各自的领域里用了完整的视频标注,MASA 一张 TAO、BDD 的图都没看过,关联的分数还是略高。差距不大,但方向一致。
BDD MOT 上的 mMOTA,ByteTrack 是 45.5,MASA 约 44.5。ByteTrack 会把低分框也接进轨迹,这对偏重检测的指标有利。
如果不给相同的检测,让接上 Detic 的 MASA 自己检测、自己跟踪,在 TAO 上的 TETA 是 46.3,远高于表中其他方法的 34.6。这部分主要来自 Detic 本身的检测能力,MASA 让它可以直接拿来跟踪。
没见过的类别
开放词汇跟踪的基准只允许用常见类别的标注训练,罕见类别当作「新类别」来测。MASA 接 Detic,新类别的 TETA 是 40.8、AssocA 41.2,专为这个任务设计的 OVTrack 是 32.0 和 33.2。
每个设计的贡献
消融用 BDD 和 COCO 的原始照片训练,在 BDD MOT 上测:
| 设置 | AssocA | mIDF1 |
|---|---|---|
| 直接用 SAM 的特征 | 32.9 | 37.3 |
| +MASA 训练与跟踪头 | 48.5 | 51.7 |
| +动态特征融合 | 50.1 | 53.3 |
| +物体先验蒸馏 | 51.9 | 54.9 |
整理自原论文 Table 8,BDD MOT 验证集。
SAM 原本的特征是为分割优化的,直接拿来分辨个体,AssocA 只有 32.9。MASA 的训练方式一加上去,就多了 15.6,这是整篇论文里最大的一次提升。
其他几个消融也呼应前面的分析:
- 提议来源。 把 SAM 换成在 COCO 上训练的 Mask2Former,TAO 的 AssocA 从 34.1 掉到 29.8。SAM 切得更细、更多样,提供的负样本更好。
- 提议数量。 每批的物体上限从 64 增加到 256,TAO 的 AssocA 从 31.5 升到 35.8。
- 增强强度。 只用翻转、裁剪这类基本增强,BDD 的 mIDF1 是 48.2;加上随机仿射、MixUp 和大尺度抖动,升到 54.9。照片要变得够多,才模拟得出视频里的变化。
和其他自监督方法比,在同样的 BDD、COCO 照片上训练,MoCo v2 的 BDD MOT AssocA 是 42.7,DINO 只有 23.1,MASA 是 51.9。这些方法学的是整张图的相似度,不擅长多物体的场景。
局限
附录里作者列了两点。第一,基础模型在相邻帧之间的检测不一定一致,这一帧切出来的东西,下一帧可能就不见了,跟踪结果会闪烁;MASA 只管关联,修不了检测的错。第二,MASA 没有长期记忆,只有一个存放每个物体嵌入的队列,严重遮挡时容易失败。
结论
MASA 证明了学跟踪的关联不一定要视频,更不一定要 ID 标注。一张照片做两次变换,SAM 帮忙把像素对应升级成物体对应,对比学习就有了大量的正负样本。
适配器的设计,让这个能力可以接到 SAM、Detic、Grounding-DINO 这些基础模型上,不动它们原本的检测和分割。在 TAO、BDD 这些它从没见过的领域,零样本的关联分数还略高于在领域内用完整标注训练的方法。
至于检测不稳、遮挡太久这两件事,它还是交给前端的基础模型和一个简单的队列处理;要跟得更久,还得另外补上记忆。