原始论文
Performance Measures and a Data Set for Multi-Target, Multi-Camera Tracking
- 发表版本
- ECCV Workshops 2016研讨会(Workshop)
- arXiv 首次提交
- arXiv:1609.01775
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingidf12016,
  title = {{Performance Measures and a Data Set for Multi-Target, Multi-Camera Tracking}},
  author = {Ergys Ristani and Francesco Solera and Roger S. Zou and Rita Cucchiara and Carlo Tomasi},
  year = {2016},
  eprint = {1609.01775},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1609.01775}
}
跟踪论文的主表,MOTA 旁边几乎都会跟着一列 IDF1。
它出自一篇多相机跟踪的论文。2016 年,杜克大学的 Ergys Ristani、Carlo Tomasi 和意大利摩德纳大学的 Francesco Solera、Rita Cucchiara 等人,在这篇论文里一次提出三样东西:一组新的评估指标、一份当时最大的多相机数据集 DukeMTMC,以及一套参考用的跟踪系统。
后来的发展有点出乎意料。数据集在 2019 年被撤下,参考系统也很少有人提起;反倒是论文里的指标,成了单相机跟踪的标准配置。
定义问题
多目标、多相机跟踪(Multi-Target, Multi-Camera tracking,MTMC),要在一整个相机网络里持续跟着每个人。一个人从一台相机的画面走出去,经过没有相机看得到的盲区,再出现在另一台相机前面,系统要认得出这还是同一个人。
机场里的嫌犯
作者用一个机场的场景说明他们想衡量的东西。
保安在大厅发现了嫌犯 A,手上有两套跟踪系统可以选。两套系统都把嫌犯标成身份 1,一路跟到安检口。
- 系统甲在安检口犯了一次错,之后都把嫌犯标成身份 2。只错了一次,但保安从此跟丢了嫌犯。
- 系统乙过了安检之后,在身份 1 和 2 之间反复切换。换了很多次 ID,但在安检口到登机口之间,它有好几段时间都正确地报出了嫌犯的位置,正确的总时间也比较长。
保安会选系统乙,因为最后是靠它在登机口抓到人的。但用 CLEAR MOT 的算法,系统甲只错一次,系统乙错了很多次。
作者的说法是,传统上把多目标跟踪定义成「持续跟着多个目标」,所以已有的指标报告的是跟踪器「哪一种错犯得有多频繁」;但有些用户真正在乎的,是「每一个时刻,能不能知道谁在哪里」。
作者并不主张哪一种指标更好。像 CLEAR MOT 这种以事件为单位的指标,能指出错误从哪里来,适合设计某个组件的工程师;在体育分析、安保、监控这类身份至关重要的应用里,用户需要的是以身份为单位的指标,不管错在哪里、为什么错。
一个人,两个身份
先看单个相机内的问题。
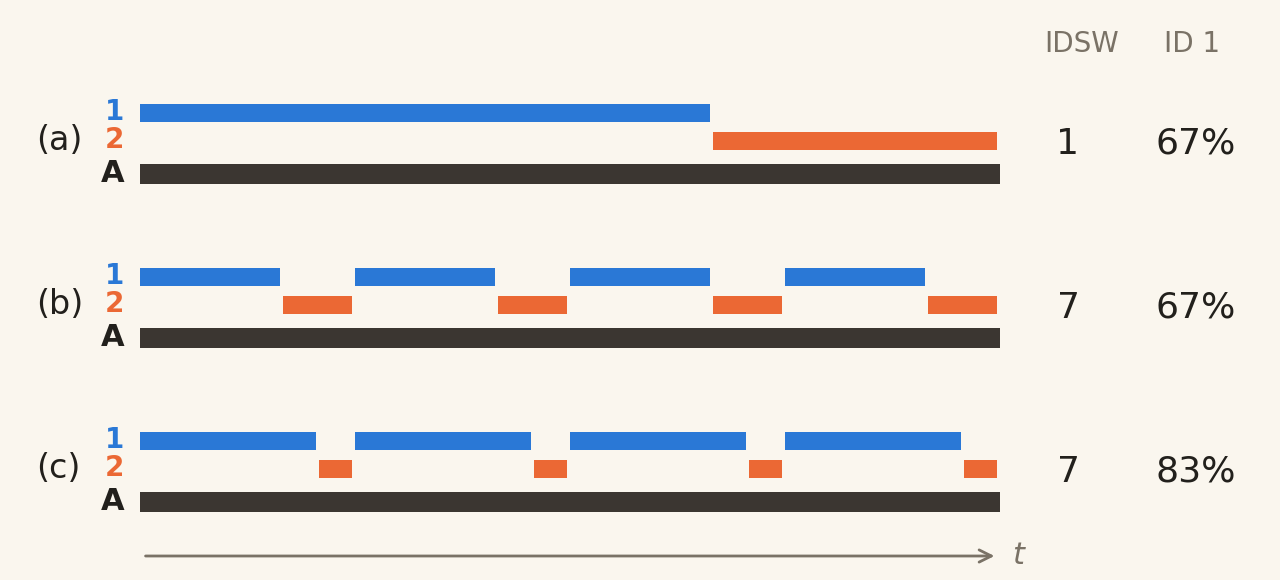
三种情况里,跟踪器都把一个真实的人 A,拆成了身份 1 和身份 2。
按事件计数的指标,(a) 只换了一次 ID,(b) 和 (c) 都换了 7 次。所以 (a) 远比另外两个好,(b) 和 (c) 一样差。
作者认为,跟踪器真正犯的错只有一种,就是把一个人看成了两个人。要衡量这个错有多严重,评估时得先决定,A 到底该对应身份 1 还是身份 2。对应一旦确定,A 被标成另一个身份的每一帧,都是跟踪器出错的一帧。
这个选择由评估者来做,而不是跟踪器,所以应该尽量对跟踪器有利。三种情况里,把 A 对应到身份 1 都最有利,因为身份 1 解释了 A 最多的部分。接着只要数,A 有多少帧没被标成身份 1:(a) 和 (b) 都是 33%,(c) 是 17%。
照这个算法,(a) 和 (b) 一样好,(c) 最好,排序和事件计数正好相反。跟踪器在 (c) 有 83% 的时间知道 A 在哪里,在 (a)、(b) 只有 67%。
把图上的粗线和细线对调,同样的推论也适用于另一种错:两个真实的人被跟踪器合成同一个身份。这时就给这个计算出的身份,挑它覆盖最多的那条真实轨迹。
换相机的那一刻
多相机还有交接(handover)的问题。
已有的指标会另外计算「交接错误」:一个人从相机 I 走到相机 II,如果系统在两边给了不同的身份,就记一次。至于这算交接错误还是相机内的错误,只看轨迹在相机 I 的最后一帧、和在相机 II 的第一帧拿到什么身份。
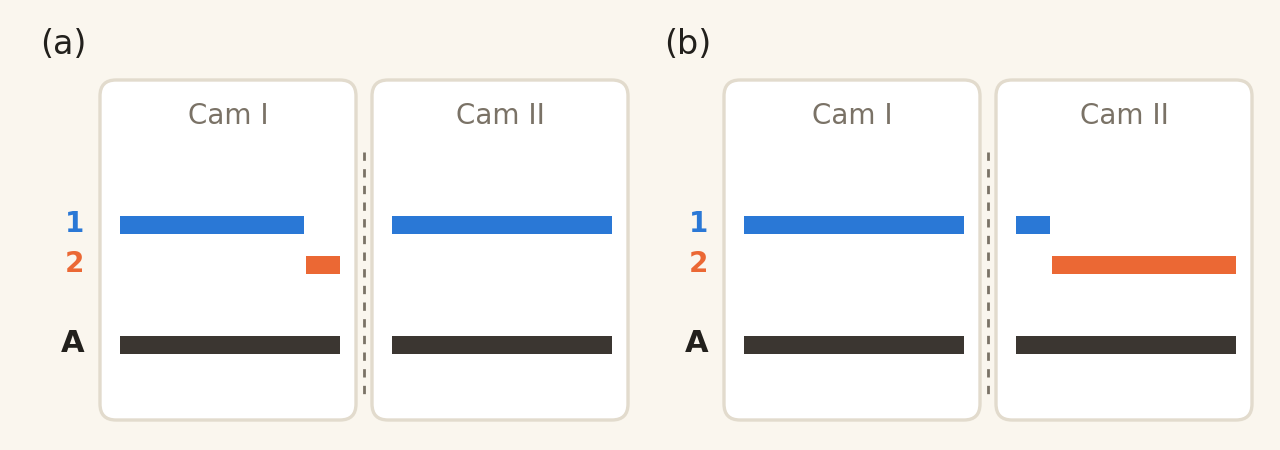
只看交接前后的两帧,结论就很脆弱:
- (a) 交接其实是对的,A 在两台相机都被认成身份 1。只因为相机 I 结尾有一小段被错标成身份 2,已有指标就同时记一次相机内的分裂和一次交接的分裂。
- (b) 交接其实是错的,A 进了相机 II 之后几乎都被标成身份 2。但相机 II 开头刚好有一小段还是身份 1,已有指标便认为交接成功,只记一次相机内的分裂。
用作者的新算法,(a) 只罚错标的那一小段,(b) 则罚在相机 II 几乎整段的轨迹。
当时多相机跟踪常用的综合指标 MCTA,把检测的 F1 分数、相机内的错误和交接错误三项相乘。这让问题更严重:上面这种情况一旦让一个错误从相机内那一项移到交接那一项,它对分数的影响就会剧烈改变,因为它被乘上的是另外两项的值。作者也直说,用乘法组合的理由并不清楚。
另外,MOTA 本身也不适合多相机。一条横跨 台相机、共 帧的轨迹,相邻两帧跨越相机的连接只有大约 个,相机内的有 个,而 远小于 。跨相机认错人,在 MOTA 里几乎看不到。
解决问题
作者改成不算错误发生了几次,而算跟踪器有多长时间认对了人。
整条轨迹,一对一匹配
第一步,把真实的身份和计算出的身份配成对。
这里的匹配单位是整条轨迹,而且是一对一:一条真实轨迹只能配一条计算轨迹,反之亦然。挑选的标准是让错配的帧数,在所有数据上加起来最少。
作者把它写成一个二分图的匹配问题。左边放每一条真实轨迹 ,右边放每一条计算轨迹 。此外,每条计算轨迹在左边多一个「误报」替身 ,每条真实轨迹在右边多一个「漏检」替身 。这两种替身让某条轨迹可以不跟任何人匹配,代价是它所有的帧都算错。
两条轨迹在某一帧「对不上」,记为 。在图像上,两个框的 IoU 小于 就算对不上;在地面坐标上,两个位置相距超过 1 米就算对不上。和替身匹配时,另一边的每一帧都算对不上。
一组匹配 的代价,是它会造成的漏检帧数加上误报帧数:
和 分别是两条轨迹出现的帧。
解出代价最小的一对一匹配后,每一帧的结果就分成三类:
- IDTP: 配上的真实轨迹和计算轨迹,在同一帧确实对得上。
- IDFN: 真实轨迹的某一帧,没有被它配到的计算轨迹对上(包括根本没配到任何轨迹)。
- IDFP: 计算轨迹的某一帧,没有对上它配到的真实轨迹(包括根本没配到)。
三个分数
有了这三个计数,就能套用一般的精确率和召回率:
IDP 是计算出的框里,身份标对的比例;IDR 是真实的框里,身份被认对的比例。IDF1 是两者的调和平均,也可以读成「标对身份的框数,除以真实框数和计算框数的平均」。
算一次看看
我们用一个小例子走一遍。画面里有两个人 、,出现 10 帧;跟踪器输出两条轨迹 、,每一帧都检测得很准,只是两条轨迹在中途互换了一次。
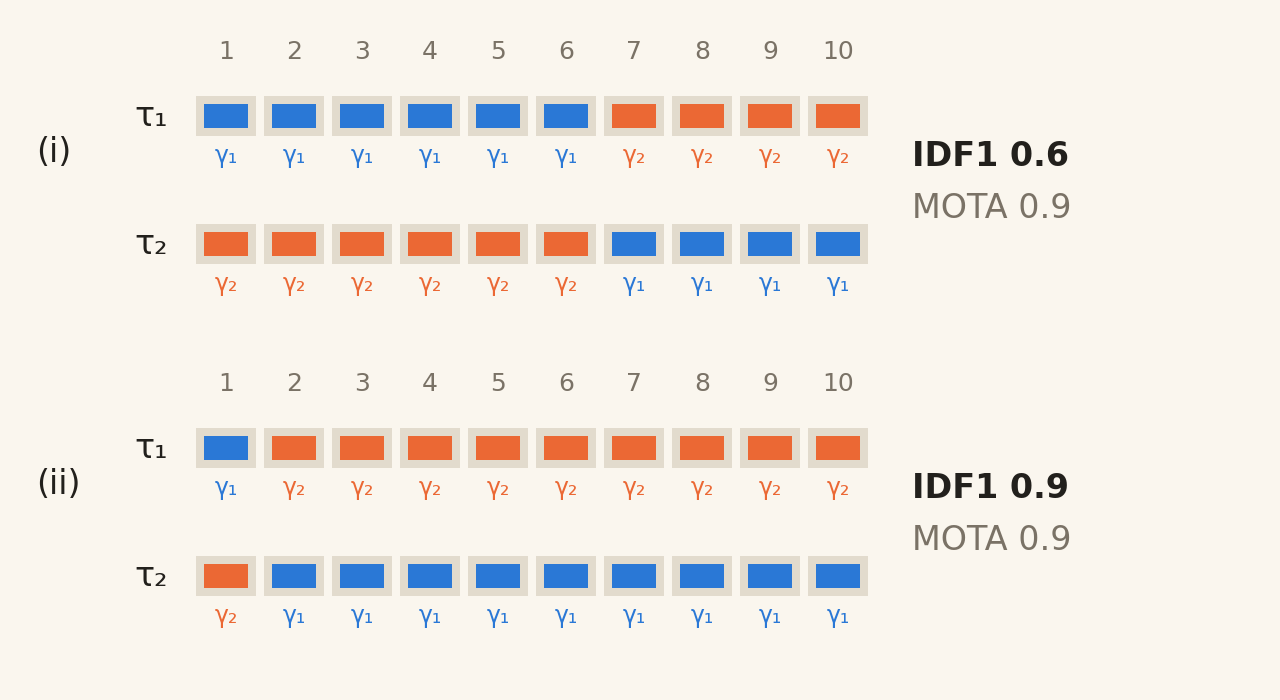
先看上半部分的情况 (i),第 7 帧互换。把 配给 : 在第 7 到 10 帧没被 对上,漏检 4 帧; 在第 7 到 10 帧跑去对 ,误报 4 帧,代价 8。改配 则各错 6 帧,代价 12。和替身匹配的代价更大,整条轨迹 10 帧都算错。完整的代价表如下:
| 8 | 12 | 10 | — | |
| 12 | 8 | — | 10 | |
| 10 | — | 0 | 0 | |
| — | 10 | 0 | 0 |
本文整理。「—」表示两个节点之间没有边;两个替身互配的代价是 0。
最小代价的匹配是 、,总代价 16。于是 IDFN = 8、IDFP = 8,两人共 20 帧,IDTP = 20 − 8 = 12:
同一个例子用 CLEAR MOT 算:没有漏检、没有误报,第 7 帧两个人各换一次假设,错配 2 次,MOTA 。
再看下半部分的情况 (ii),互换提前到第 2 帧。MOTA 一样是 0.9,还是错配两次。IDF1 这边,最好的匹配变成 、,两人各有 9 帧对得上,IDTP = 18,IDF1 = 0.9。如果恰好在第 6 帧互换,前后各 5 帧,IDF1 会掉到最低的 0.5。
CLEAR MOT 的作者特意设计,让「同一次交换发生得早或晚」不影响扣分,并把相反的做法称为反直觉。IDF1 则正好相反:交换的时间点决定了跟踪器标错身份的时间有多长,这正是它想衡量的东西。
两种指标的分歧,从一开始就是刻意的。
和 CLEAR MOT 的差别
作者把两者并排比较:
- 匹配的范围。 CLEAR MOT 一帧一帧地配,上一帧的匹配只要还在阈值内就沿用。每一帧是一对一,但放到整段视频,一个真实的人可能先后配过好几条轨迹,是多对多。IDF1 在整段视频上只配一次,全程一对一。
- 没有「分裂」的概念。 既然整段只配一次,就没有「换 ID」这种事件可数,只检查每一帧有没有被正确的身份解释。
- 错误的单位。 IDF1 只数帧,不混入距离。作者的理由是,如果把二元计数和欧氏距离混在一起,就分不清一个跟踪器是「身份认得久」还是「位置跟得近」。
作者归纳这套匹配的三个性质:一对一、对跟踪器最有利、所有错误同一种货币。重叠和不重叠的相机视野,也用完全相同的方式处理。
如果真的想知道跨相机有多难,作者也给了做法:匹配做两次,一次把所有相机的数据放在一起,一次每台相机各自匹配、再把错误加总。前者的错误数一定不少于后者,两者的差距,就是跨相机关联额外犯的错。
DukeMTMC
论文的第二个贡献是数据集。
八台同步的静态相机架在杜克大学校园里,在下课的人流时段录像,每台 1 小时 25 分钟,分辨率 1080p、每秒 60 帧,总计超过 10 小时、200 万帧。画面里有 2,834 个不同的人、6,791 条单相机轨迹,平均每个人有 2.5 条单相机轨迹,最多 7 条。
它难在哪里,看几个数字:
- 单个相机每帧 0 到 54 人,因相机而异。
- 全部共有 4,159 次交接,最多同时有 50 人在盲区里。
- 超过 1,800 次遮挡(重叠 50% 以上),平均持续 60 帧。
- 891 个人只出现在一台相机前,对容易把不同相机的人误配在一起的跟踪器是个考验。
- 大部分相机的视野不重叠,只有两对相机有一小块重叠区,约 100 人经过。
标注是每个人的脚与地面接触点的轨迹。五个人花了一年,在自制的界面上标了将近 10 万个关键点,再插值到每一帧;图像上的框则是半自动生成的。每台相机前 5 分钟作为训练和验证,其余 80 分钟作为测试。
作者在比较表上列了当时已知的十几个多相机数据集,身份数最多的也只有 255 个。DukeMTMC 的 2,834 个身份,比之前所有数据集加起来还多,录像时间最长、帧率也最高。
数据量大,计算量也大。作者提到,用标准算法算完所有前景掩码,单机要 6 天;用 DPM 检测器跑完所有检测,192 核的集群要 7 天。
作者也列出了局限:只有一个户外场景、相机固定、阴天的柔光可能让跟踪比较容易,视野大多不重叠,对依赖重叠视野的方法比较不利。
这份数据集后来被大量使用,也衍生出行人重识别用的 DukeMTMC-reID。2019 年,杜克大学撤下了数据集网站。据杜克校报的报道,校方表示数据集的发布明显偏离了获批的研究方案,不打算重新开放。
参考系统
第三个贡献是一套参考用的多相机跟踪器,扩展自 Ristani 和 Tomasi 先前的单相机系统。
它分层把观测合并起来:检测先合成短的轨迹片段,短到可以用简单的运动模型;片段再合成单相机轨迹;最后把各相机的轨迹连成跨相机的身份。每一层都是一张图,节点是观测,边上的权重介于 −1 和 1 之间,表示两个观测是同一人的证据强弱。把节点分组、让同组的权重总和最大,是一个相关聚类(correlation clustering)问题,用二元整数规划求解。
这个问题是 NP-hard,也很难近似,所以才拆成好几层,让每个子问题都够小;时间上则用滑动窗口,处理没有尽头的视频。
在已有的 NLPR MCT 四个数据集上,照惯例给定真实的单相机轨迹、只比较跨相机关联,用 MCTA 评分,这套系统在六个方法中平均排第二。
讨论
两种指标衡量的是不同的东西
作者在 DukeMTMC 上跑参考系统,检查每一条真实轨迹的 ID 召回率、ID 精确率,和它被记到的分裂、合并次数有没有关系。四组相关系数分别是 −0.24、−0.05、−0.38、−0.41,相关性都很弱。
换句话说,一条轨迹被记了多少次分裂或合并,很难用来推测它的身份有多少时间被认对。事件式的指标和身份式的指标,衡量的确实是不同的东西。
交接的问题不只是理论
前面那两种交接的反例,在实际结果里有多常见?参考系统在数据集上共做了 5,549 次交接,其中约 74%(4,119 次)在交接附近有一小段短轨迹,让传统指标和新指标的判断明显不同:
| 情况 | 次数 | 比例 |
|---|---|---|
| 交接实际上正确,却被记成分裂 | 1,692 + 738 | 30.5% + 13.3% |
| 交接实际上正确,却被记成合并 | 1,065 + 496 | 19.2% + 8.9% |
| 交接实际上错误,却没被记成分裂 | 70 | 1.3% |
| 交接实际上错误,却没被记成合并 | 58 | 1.0% |
整理自原论文 Figure 5,比例为占全部 5,549 次交接的百分比;前两行分别合并了两种图示情况。
大部分的落差,是「交接明明做对了,却被传统指标罚了」。
同一个系统,两种排序
最后,作者把参考系统在 DukeMTMC 测试集上的成绩列成基准:
| 相机 | MOTA | IDP | IDR | IDF1 |
|---|---|---|---|---|
| 1 | 37.36 | 79.17 | 44.97 | 57.36 |
| 2 | 49.17 | 69.11 | 63.78 | 66.34 |
| 3 | 53.50 | 81.46 | 55.11 | 65.74 |
| 4 | 55.92 | 79.23 | 61.16 | 69.03 |
| 5 | 73.09 | 84.86 | 67.97 | 75.48 |
| 6 | 12.94 | 48.35 | 43.71 | 45.91 |
| 7 | 62.03 | 85.23 | 67.08 | 75.07 |
| 8 | 36.98 | 90.54 | 35.86 | 51.37 |
整理自原论文 Table 3 下半部分,单相机结果;另有 FP、FN、ID 切换、MT、ML 等列未收录。
两种指标对相机难度的判断并不一致。按 MOTA,相机 3 比相机 2 容易;按 IDF1,相机 2 反而稍好。相机 6 和 7 的差距更明显:MOTA 差了将近 50 分(12.94 对 62.03),IDF1 只差 29 分(45.91 对 75.07)。作者说,实际看跟踪结果,相机 6 也没有 MOTA 说的那么糟。
也可以注意相机 8:IDP 高达 90.54,IDR 只有 35.86。标出来的身份大多是对的,但很多人根本没被认出来。这种取舍,只看 IDF1 一个数字是看不出来的,这也是作者同时提供精确率和召回率的原因。
跨所有相机的结果,IDP、IDR、IDF1 分别是 52.35、36.46、42.98。表上另有一行标为上限的跨相机数字,IDF1 是 59.77。
结论
这篇论文用一个机场的例子,把「犯错有多频繁」和「多长时间认对人」这两件事分开。IDF1 在整段视频上把真实身份和计算身份一对一匹配,让匹配对跟踪器尽量有利,再数有多少帧的身份被认对。所有错误都以帧为单位计价,不管它发生在相机内还是交接时。
它和 CLEAR MOT 的分歧是刻意的。CLEAR MOT 认为一次交换就是一次错,不该因为发生得早晚而有差别;IDF1 认为,交换发生得早,说明跟踪器有更长的时间报错了人。两种看法各自回答一个合理的问题,作者也没有要取代谁的意思。
后来 MOTChallenge 把 IDF1 放上排行榜,和 MOTA 并列。再过四年,HOTA 指出 IDF1 走到了另一个极端,几乎只在乎关联,检测的好坏很少反映在分数上。
回到机场。保安要的从来不是「错几次」,而是在登机口前,系统能不能指着屏幕说:「他在那里。」