原始论文
DiffusionTrack: Diffusion Model For Multi-Object Tracking
- 发表版本
- AAAI 2024会议
- arXiv 首次提交
- arXiv:2308.09905
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingdiffusiontrack2023,
  title = {{DiffusionTrack: Diffusion Model For Multi-Object Tracking}},
  author = {Run Luo and Zikai Song and Lintao Ma and Jinlin Wei and Wei Yang and Min Yang},
  year = {2023},
  eprint = {2308.09905},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2308.09905}
}
扩散模型最有名的用途是生成图片:从一张纯噪声开始,一步一步去掉噪声,最后得到一张清晰的图。
2022 年底,DiffusionDet 把这个想法搬到了目标检测上。它不生成图片,而是生成框:在画面上撒一堆随机框,让网络一步一步把它们修正到物体上。
深圳先进院和华中科大的 Run Luo、Zikai Song 等人想再往前走一步。如果一次生成的不是一个框,而是一对框,一个在前一帧、一个在这一帧,而且两个框框住的是同一个人,那检测和跟踪就在同一个去噪过程里一起完成了。
定义问题
作者把当时的跟踪器分成两类,认为它们有三个共同的毛病:
- 不一致。 先检测再跟踪的方法,检测器和跟踪器是分开训练的。联合检测与跟踪的方法虽然放在同一个网络里,检测和跟踪还是各走各的分支。
- 鲁棒性和复杂度难以兼顾。 先检测再跟踪的方法结构简单,但检测一有偏差,跟踪就跟着出错。联合的方法比较稳,结构却复杂,检测准确度也比不上专门的检测器。
- 不够灵活。 同一段视频里,有的片段人很少、有的很挤,有的人走得慢、有的跑得快,但大部分方法整段视频只能用同一组设置。
DiffusionTrack 想用一个统一的框架同时处理这三件事。
解决问题
一次生成一对框
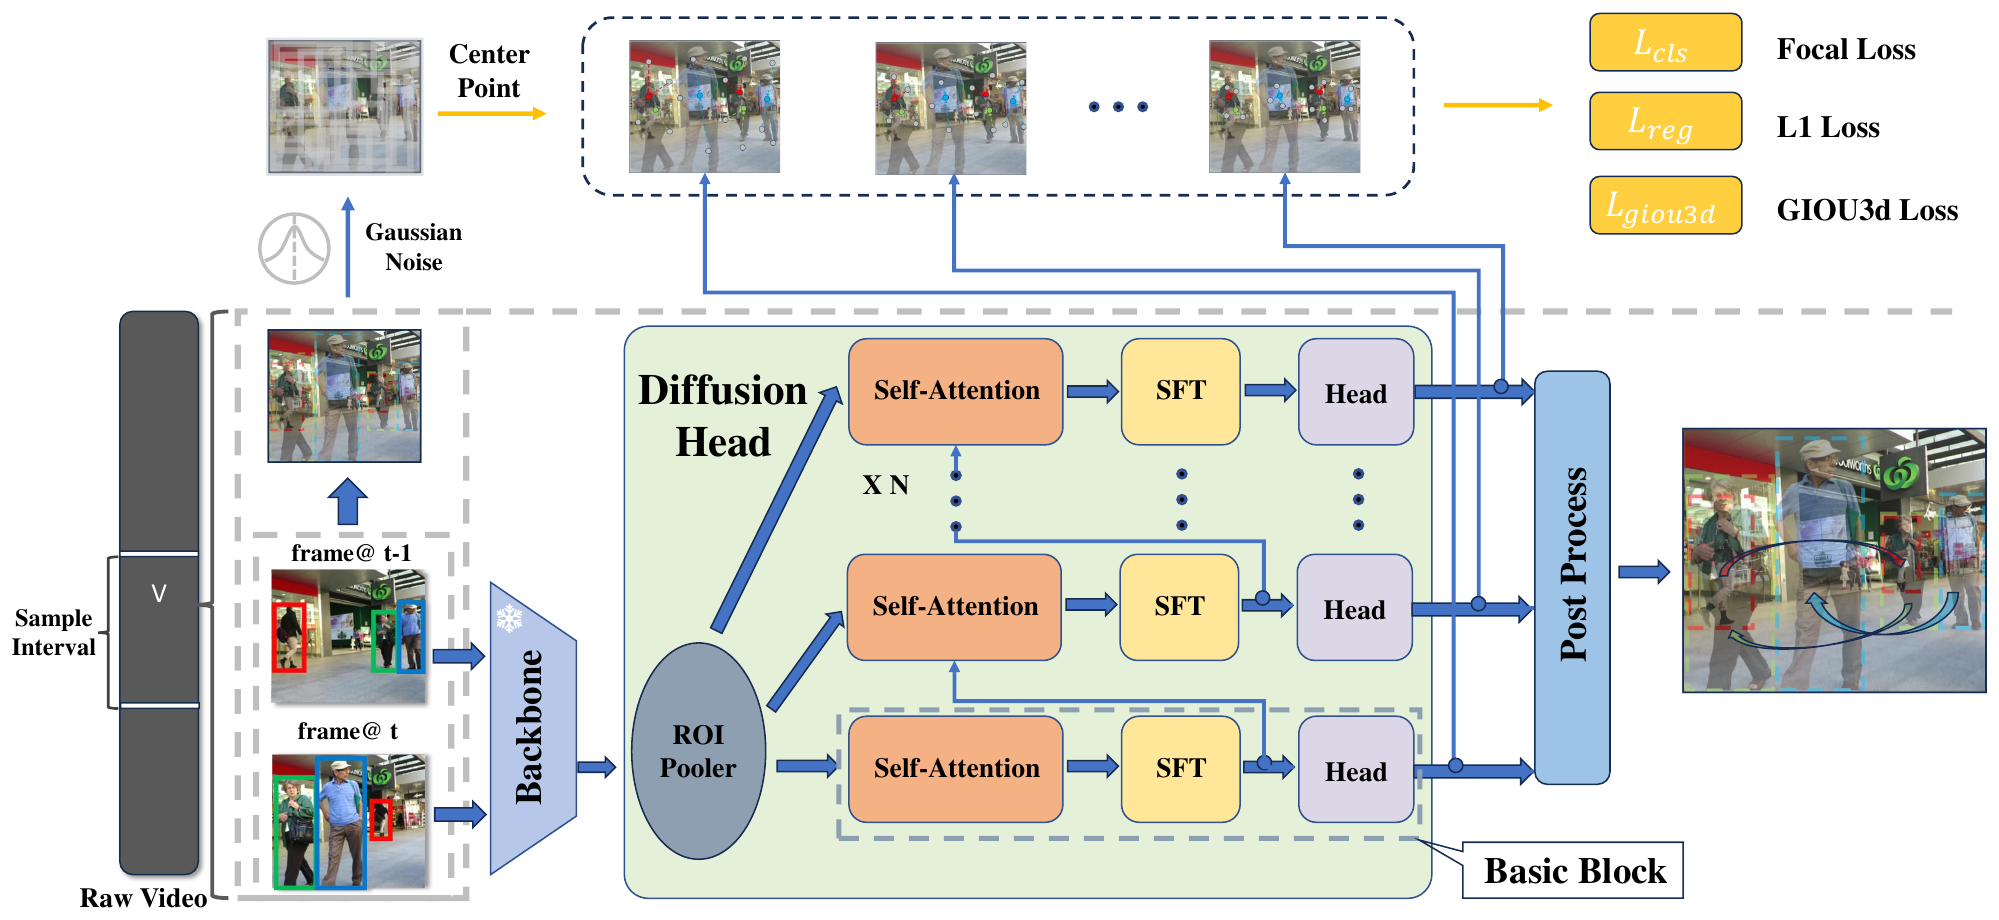
DiffusionTrack 处理的数据单位是一对框:同一个物体在第 帧和第 帧的框,一共八个数字。网络的工作,是从一对被噪声弄乱的框,还原出真正的那一对。
如果两帧是同一张图,这个问题就退化成一般的目标检测。作者强调这一点,因为它说明检测和跟踪真的是在同一个模型、同一个目标下训练的。
网络分成两部分:
- 骨干网络。 用 ByteTrack 预训练好的 YOLOX,加上 FPN,两帧各跑一次,之后冻结不动。
- 扩散头。 按照每一对噪声框,从两帧的特征图上各取一块 RoI 特征,经过好几个块反复修正。每个块输出框的位置、类别,和一个关联分数,表示这对框是不是同一个物体。
每个块里有一个时空融合模块,让配对的两个框交换信息。前一帧的框看得到这一帧,这一帧的框也看得到前一帧,两边一起决定这对框该往哪里修。
训练:把正确答案弄脏
训练时,从同一段视频里取两帧,相隔最多 5 帧。两帧都出现的物体,各组成一对正确的框,再补一些额外的框,凑满 500 对。
接着按照扩散模型的噪声调度,在这 500 对框上加入不同程度的高斯噪声,让网络学着把它们还原。匹配时用匈牙利算法,损失有三项:类别用 focal loss、坐标用 L1,还有一项 3D GIoU。
3D GIoU 是 GIoU 的延伸。一对框在时间轴上叠起来,像一个棱台;两个棱台的交集和并集,用两帧的面积加总来算。这让网络同时顾及两帧的框,而不是各算各的。
推理:用上一帧的框起头
检测从纯随机的框开始;跟踪不必,因为上一帧已经知道每个人在哪里。
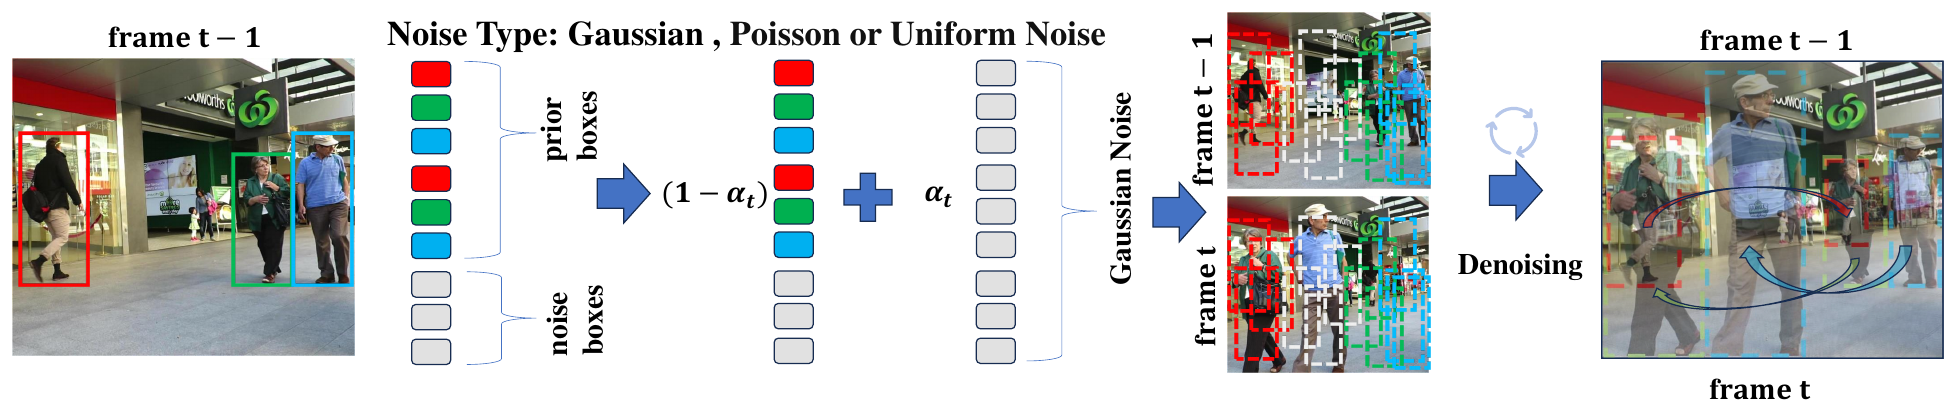
推理分三步:
- 凑框。 把上一帧的框重复几次,剩下的位置补上随机的高斯框,凑满固定数量。
- 加噪声。 按照 混入噪声。
- 去噪。 用 DDIM 跑几步,得到配对框。
举个例子。MOT17 上设置 800 个框,其中 25% 用上一帧的框。如果上一帧跟踪到 40 个人,就有 200 个先验框,每个人重复 5 次;剩下 600 个是随机框。
从先验框出发的那几对,负责把已经在跟踪的人延续到这一帧;从随机框出发的那几对,负责找新出现的人,或把之前跟丢的人捡回来。
本文整理的算例。
去噪之后,关联分数低于 0.25 的配对先丢掉,再做两次 NMS 去掉重复。剩下的配对,用 IoU 接上已有的轨迹。因遮挡而跟丢的轨迹,则用一个简单的卡尔曼滤波推算位置,和新找到的框再配一次。
噪声要加多少,取决于物体动得多快。作者让扩散的时间步 随着两帧之间的平均移动量变化:动得越多,噪声越大,让网络有更大的空间去修正。同一段视频的不同片段,因此可以用不同的噪声量,这就是前面说的「灵活」。
讨论
多少先验、什么噪声
消融都在 MOT17 训练集的前半训练、后半测试:
| 先验框比例 | MOTA | IDF1 | HOTA |
|---|---|---|---|
| 0% | 71.2 | 65.9 | 58.1 |
| 25% | 73.6 | 70.0 | 60.7 |
| 50% | 74.5 | 71.2 | 61.8 |
| 75% | 74.1 | 71.4 | 61.9 |
| 100% | 72.9 | 66.8 | 58.4 |
整理自原论文 Table 1(a),MOT17 验证集。
0% 等于完全不用上一帧的信息,每一帧都从头检测;100% 则完全不补随机框。两个极端都比较差,中间的比例最好。前者少了跟踪的线索,后者没有随机框去找新出现的人。
补框用什么噪声也有差别。高斯噪声最好,HOTA 60.7;改成泊松或均匀分布,或者干脆补整张图大小的框,HOTA 都掉到 59 以下。
噪声量和移动量的关系,用对数函数最好,HOTA 62.6;用线性函数是 60.7,用固定值是 58.2。
框越多、步数越多
| 框数 | 去噪步数 | MOTA | HOTA | 计算量 | FPS |
|---|---|---|---|---|---|
| 500 | 1 | 71.5 | 58.4 | 229.6G | 21.05 |
| 500 | 2 | 71.7 | 59.5 | 459.2G | 10.47 |
| 800 | 1 | 73.6 | 60.7 | 367.3G | 15.89 |
| 1000 | 1 | 74.1 | 61.3 | 459.1G | 13.37 |
整理自原论文 Table 1(d),MOT17 验证集,单张 RTX 3090、FP16。
扩散模型的一个好处是,训练完之后,框的数量和去噪步数都可以在推理时调整。多一点框、多走几步,成绩就好一点,速度就慢一点,不用重新训练。
不过从表上看,加框比加步数划算。同样大约 459G 的计算量,1000 个框走 1 步的 HOTA 是 61.3,500 个框走 2 步只有 59.5。附录里作者也承认,多步去噪带来的提升有限。
检测被干扰的时候
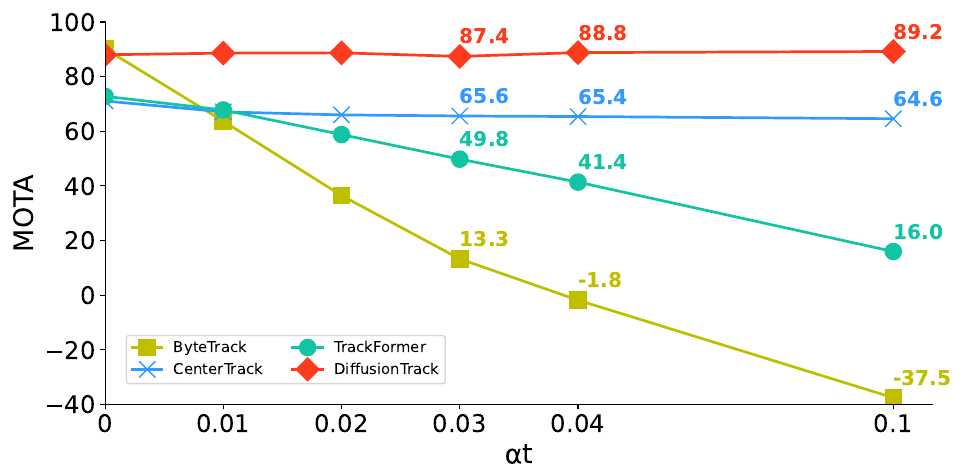
这是论文里最醒目的一张图。作者在检测框上混入噪声,比例从 0 加到 0.1。ByteTrack 完全依赖检测框,扰动到 0.04 时 MOTA 已经变成负的;DiffusionTrack 几乎不受影响。
这个结果不难理解。对 DiffusionTrack 来说,带噪声的框本来就是它的输入,去噪是它每天在做的事。
读这张图时要注意实验设置。按照图注,四个跟踪器都用 MOT17 训练集训练,再在 val-half 上评估,而 val-half 本来就是训练集的后半。所以 DiffusionTrack 在没有扰动时的 MOTA 接近 89,比前面消融的 73.6 高出许多。能比较的是曲线的走势,数值本身不能和其他表格对照。
和其他方法比
| 数据集 | 方法 | MOTA | IDF1 | HOTA | AssA |
|---|---|---|---|---|---|
| MOT17 | ByteTrack | 80.3 | 77.3 | 63.1 | 62.0 |
| MOT17 | DiffusionTrack | 77.9 | 73.8 | 60.8 | 58.8 |
| MOT20 | ByteTrack | 77.8 | 75.2 | 61.3 | 59.6 |
| MOT20 | DiffusionTrack | 72.8 | 66.3 | 55.3 | 51.3 |
| DanceTrack | OC-SORT | 89.6 | 54.6 | 54.6 | 40.2 |
| DanceTrack | DiffusionTrack | 89.3 | 47.5 | 52.4 | 33.5 |
MOT17、MOT20 整理自原论文 Table 2,DanceTrack 整理自原论文 Table 3,均为测试集、私有检测。
在联合检测与跟踪的方法里,DiffusionTrack 是原论文表上最好的:MOT17 的 MOTA 77.9,高于 TrackFormer 的 74.1 和 MOTR 的 71.9。但和先检测再跟踪的 ByteTrack、OC-SORT 相比,三个数据集上都还落后。
拆开来看,DiffusionTrack 强在检测。DanceTrack 上它的 DetA 是 82.2,比 OC-SORT 的 80.4 还高;AssA 却只有 33.5,比 OC-SORT 低了 6.7。MOT17 上它的 ID 切换是 3,819 次,ByteTrack 只有 2,196 次。
作者也做了只在第 帧加噪声的基准版本。它在 MOT17 上的 HOTA 是 55.9,比 DiffusionTrack 低 4.9;到了拥挤的 MOT20 只有 42.5,到了动作复杂的 DanceTrack 只有 44.0。作者的解释是,基准版本只学到从上一帧的框回归到这一帧,两帧一起加噪声的过程,则逼着网络学会分辨不同的物体。
代价
扩散头有 2.36 亿个可训练参数,在 8 张 RTX 3090 上要训练约 30 小时。推理时 800 个框走一步,每帧 367G 的计算量,大约 16 FPS。作者在附录里也提到,MOT20 的小物体处理得不好。
结论
DiffusionTrack 把跟踪写成一个去噪问题:同一个人在两帧的框,是从一对噪声框慢慢修出来的。检测和跟踪用同一个网络、同一个目标训练;框的数量和去噪步数可以在推理时调;检测框被干扰时也很稳。
它的弱点在关联。检测的指标很好,身份的指标却还追不上几个靠卡尔曼滤波和 IoU 的方法,而它自己最后也用了 IoU 和卡尔曼滤波来接轨迹。
扩散模型在跟踪里还有另一种用法。半年后的 DiffMOT 不拿它来生成框,而是拿来预测人下一步往哪里走。