原始论文
Iterative Scale-Up ExpansionIoU and Deep Features Association for Multi-Object Tracking in Sports
- 发表版本
- WACV Workshops 2024研讨会(Workshop)
- arXiv 首次提交
- arXiv:2306.13074
引用此论文 · BibTeX
引用信息对应所链接的论文版本,作者为原论文作者。
@misc{multiobjecttrackingdeepeiou2023,
  title = {{Iterative Scale-Up ExpansionIoU and Deep Features Association for Multi-Object Tracking in Sports}},
  author = {Hsiang-Wei Huang and Cheng-Yen Yang and Jiacheng Sun and Pyong-Kun Kim and Kwang-Ju Kim and Kyoungoh Lee and Chung-I Huang and Jenq-Neng Hwang},
  year = {2023},
  eprint = {2306.13074},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/2306.13074}
}
SportsMOT 那篇有一张消融表很让人在意。同样是用 IoU 关联,先用卡尔曼滤波预测位置的版本,HOTA 是 64.1;不预测、直接拿轨迹上一帧的框去比,反而是 71.5。
如果预测只会帮倒忙,那何必预测?
华盛顿大学 Jenq-Neng Hwang 实验室的 Hsiang-Wei Huang、Cheng-Yen Yang、Jiacheng Sun,和韩国电子通信研究院(ETRI)、台湾国家高速网络与计算中心的合作者,提出了 Deep-EIoU。它把卡尔曼滤波整个拿掉,改用一个撑得很大的框来找人,再加上外观特征分辨是谁。
这个方法在 SportsMOT 上拿到 77.2 的 HOTA,比 SportsMOT 论文里最好的方法高出 3 分。
定义问题
作者列出体育场景难跟踪的三个原因:
- 遮挡严重。 比赛的对抗很激烈,球员常常挤成一团、互相挡住,比行人跟踪严重得多。
- 外观相似。 同一队的球员穿一样颜色的球衣。
- 动作无法预测。 篮球的胯下运球、足球的铲球、排球的扣杀,速度和方向都会在一瞬间改变。
主流的跟踪器,不管是融合外观和运动的,还是只靠运动的,大多用卡尔曼滤波预测位置。卡尔曼滤波假设线性运动和高斯噪声,物体的运动一旦不符合,预测就会偏。OC-SORT 试着修补卡尔曼滤波;C-BIoU 用平均位移取代它,再把框撑大来弥补估计误差。
Deep-EIoU 更进一步,连运动估计都不做了。
解决问题
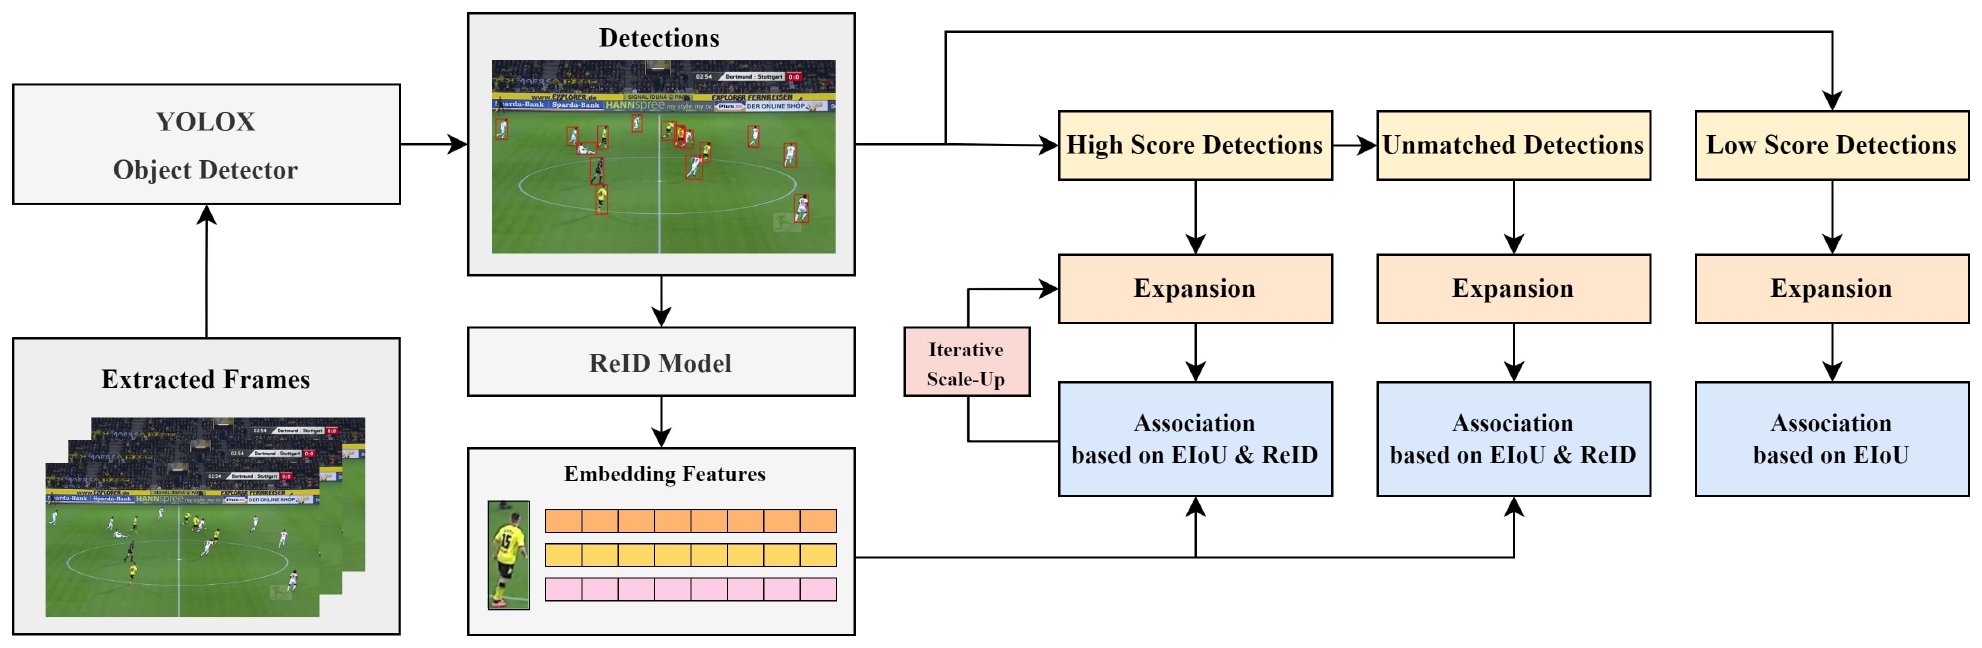
整体仍是先检测、再关联的架构,只用过去和现在的信息,可以在线运行。每一帧先用 YOLOX 检测球员,再用 ReID 模型提取每个框的外观特征,接着算出轨迹和检测之间的代价,交给匈牙利算法匹配。
和一般跟踪器最大的差别,在于轨迹用来比对的那个框。Deep-EIoU 不预测轨迹这一帧会在哪里,直接拿轨迹最后一次被看到的框,和新的检测比。
撑得很大的框
位置的部分,用的是扩张 IoU(ExpansionIoU,EIoU)。作者说明这个想法来自 C-BIoU,但他们发现,在运动员身上,框要撑得更大才好。
扩张由比例 控制。一个宽 、高 的框,扩张长度是
这个长度再分成两半,加到框的两侧:左上角往外移 ,右下角也一样。所以扩张后的框,宽和高都是原本的 倍。官方代码的写法和这个定义一致。
默认的 ,框的宽高就变成原本的 3.4 倍,面积将近 12 倍。换算成 C-BIoU 的写法,相当于缓冲比例 1.2;C-BIoU 在 DanceTrack 上最好的缓冲只有 0.3 到 0.4。
我们沿用 C-BIoU 笔记里的例子来比较。一个宽 40、高 100 像素的球员,下一帧往右移了 50 像素,原本的 IoU 是 0:
| 扩张后的框 | 同一人(50 px) | 邻居(70 px) | 邻居(100 px) | |
|---|---|---|---|---|
| C-BIoU() | 64 × 160 | 0.12 | 0 | 0 |
| Deep-EIoU() | 136 × 340 | 0.46 | 0.32 | 0.15 |
本文整理的算例,两个框大小相同、高度对齐。
扩到这么大,球员就算瞬间移动了一个多身宽,也还找得到。代价也很明显,左右三个身宽以内的人,全都成了候选人。这时就得靠外观把人分开。
外观和位置怎么合起来
外观的代价是轨迹和检测特征向量的余弦距离:
很多方法会把外观代价和 IoU 代价加权相加,作者没有这样做,而是采用 BoT-SORT 的做法。先调整外观代价,如果 或 ,调整后的外观代价 ;否则 。第一阶段的代价再取两者中较小的那个:
这里 、。
外观要能派上用场,两者得长得够像,位置也要够近(EIoU 至少 0.5)。只要有一项不满足,外观代价就设成 1,相当于不参考外观;两项都满足时,外观代价再打对折。最后在外观和位置的代价里取较小的那个。
所以外观只能让本来就靠得近的匹配「更确定」,不能把两个离得远、只是长得像的人硬凑在一起。这在同队球员球衣都一样的情况下特别重要。
先匹配有把握的
匹配沿用 ByteTrack 的分层。置信度至少 0.6 的高分检测,通常比较少被遮住,外观特征也比较可靠,所以先拿高分检测和轨迹匹配,用的就是上面结合外观和 EIoU 的代价;置信度在 0.1 到 0.6 之间的低分检测,第二轮只用 EIoU 和剩下的轨迹匹配;低于 0.1 的直接丢掉。
另外,作者去掉了一般跟踪器对框的长宽比限制,因为球员可能倒在地上,不像行人大多是站着走路。丢失的轨迹保留 60 帧,比行人跟踪常用的 30 帧长,因为球场上的遮挡更严重。
逐步放大,不必调参
C-BIoU 的消融已经显示,缓冲比例是一个敏感的超参数。作者指出,实际的运动员跟踪系统很难调它:系统要在线实时运行,没办法事后反复实验;真实场景也拿不到测试数据的真值,根本无从找起。
于是他们不找最佳的 ,而是在高分检测的匹配阶段,让 从小到大逐步增加,重复匹配:
从 0 开始。第一轮用 ,把重叠最多、最有把握的匹配先配好;没匹配上的,下一轮用大一点的框再找。默认 、步长 ,共两轮,也就是 0.7 和 0.8。
讨论
SportsMOT
检测器是 YOLOX-X,从 COCO 预训练权重开始,在 SportsMOT 的训练集和验证集上微调 80 个 epoch。ReID 模型用 OSNet,从行人重识别数据集 Market-1501 的权重开始,再用 SportsMOT 真值框裁出的 31,279 张球员图像微调。
| 方法 | 训练数据 | HOTA | AssA | DetA | IDF1 |
|---|---|---|---|---|---|
| BoT-SORT | 训练集 | 68.7 | 55.9 | 84.4 | 70.0 |
| OC-SORT | 训练集 | 71.9 | 59.8 | 86.4 | 72.2 |
| Deep-EIoU | 训练集 | 74.1 | 63.1 | 87.2 | 75.0 |
| OC-SORT | 训练+验证 | 73.7 | 61.5 | 88.5 | 74.0 |
| MixSort-OC | 训练+验证 | 74.1 | 62.0 | 88.5 | 74.4 |
| Deep-EIoU | 训练+验证 | 77.2 | 67.7 | 88.2 | 79.8 |
整理自原论文 Table 2,SportsMOT 测试集。BoT-SORT 用官方代码重跑,其他基准数字取自 SportsMOT 论文。
用同样的训练数据比,Deep-EIoU 在两种设置下都是最好的。用训练加验证集时,HOTA 比 MixSort-OC 高 3.1 分,关联的 AssA 高 5.7 分;检测的 DetA 则差不多,甚至略低。差距几乎全部来自关联。
SoccerNet
SoccerNet-Tracking 有 201 段足球视频,每段 30 秒,要跟踪的不只是球员,还有守门员、裁判和球。为了只比跟踪,所有方法都直接使用数据集提供的真值框。
Deep-EIoU 的 HOTA 是 85.4,第二名的 OC-SORT 是 78.1,BoT-SORT 是 77.0,ByteTrack 和 DeepSORT 只有 71.5 和 69.6。
每个部件的贡献
| 设置 | HOTA |
|---|---|
| 基准(只有 EIoU) | 71.4 |
| +外观(ReID) | 75.3 |
| +逐步放大 | 77.2 |
| +线性插值 | 77.2 |
整理自原论文 Table 4,SportsMOT 测试集。
- 外观贡献最多,3.9 分。 虽然同队球员长得很像,外观仍是重要的线索。这和 SportsMOT 论文「相似但可分辨」的结论一致。
- 逐步放大再加 1.9 分。 作者也说明,这一步同时把丢失轨迹的保留时间从 30 帧延长到 60 帧,所以这 1.9 分是两者合起来的效果。
- 线性插值几乎没有影响,多不到 0.1 分。
只用 EIoU、没有外观的基准是 71.4,和 SportsMOT 论文里「不用卡尔曼的 IoU」那一行(71.5)很接近。两篇的检测器训练方式不同,只能粗略对照;从这组数字来看,单靠把框撑大,并没有比不预测的 IoU 好多少;Deep-EIoU 多出来的分数,主要来自外观和逐步放大。
扩张比例真的不用调吗
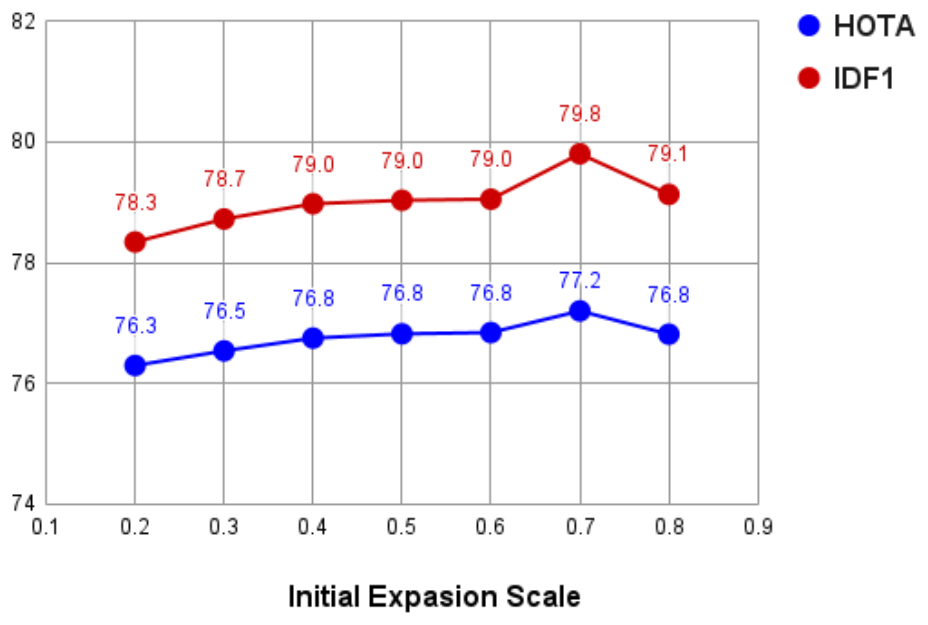
作者把初始扩张比例从 0.2 改到 0.8,其他设置不变。HOTA 都在 76.3 到 77.2 之间,全部高于先前最好的 74.1。作者据此认为,逐步放大让这个方法不需要调参。
这张图也可以换个角度读。初始比例 0.2 时,两轮的扩张是 0.2 和 0.3,框的宽高放大到 2.4 到 2.6 倍;调到 0.7,放大到 3.4 到 3.6 倍,HOTA 也只多 0.9 分。在这个范围内,扩多大其实影响不大。
不过图上最小的扩张也有 2.4 倍,已经比 C-BIoU 的设置大。作者说「比 C-BIoU 扩得更大明显更好」,这张图并没有直接比较到;真正让 Deep-EIoU 拉开距离的,从消融表看,还是外观和逐步放大。
EIoU 也能帮卡尔曼滤波
最后,作者把 EIoU 直接放进两个基于卡尔曼滤波的跟踪器,预测框和检测框都先扩张再算 IoU。ByteTrack 的 HOTA 从 62.8 升到 67.5,BoT-SORT 从 68.7 升到 71.3。
所以 EIoU 不只适用于不预测的跟踪器,也可以当作一个即插即用的小技巧。但即使加了 EIoU,这两个卡尔曼跟踪器仍然输给什么都不预测的 Deep-EIoU。
局限
作者在论文里列了两个局限:
- 没有离线的轨迹修正。 球员离开画面再回来,在线跟踪器很难认回来。作者提到可以加上后处理或更强的记忆机制,但这篇没有做。
- 速度。 加上检测器和 ReID 模型,整套流程在一张 RTX 4080 上约每秒 14.6 帧,比只看运动的跟踪器慢;换成更轻量的检测器和 ReID 模型,可以加快。
结论
Deep-EIoU 在体育场景做了一个大胆的选择。它不预测球员下一帧会在哪里,只拿最后一次看到的位置,把框撑到 3.4 倍大去找人,再用外观把撑大后涌进来的候选人筛掉。外观只能让已经够近的匹配更确定,不能把远处长得像的人拉过来;扩张比例则从小到大试两轮,省去调参。
消融显示,三个设计里贡献最大的是外观,其次是逐步放大。只用 EIoU 的基准,和 SportsMOT 论文里不预测的 IoU 相差不远。
2025 年的一篇多目标跟踪综述,把 Deep-EIoU 描述为 C-BIoU 的推广,从固定两段扩张变成逐步放大,并在 SportsMOT 的比较表上列为第二,只输给综述作者自己的方法。综述也提醒,Deep-EIoU 只在 SportsMOT 和 SoccerNet 上评测过。
至于论文自己承认的第一个局限,球员出画面再回来认不得,同一个实验室在一年多后用 GTA 给出了回答。