原始論文
Essentially No Barriers in Neural Network Energy Landscape
- 發表版本
- ICML 2018會議
- arXiv 首次提交
- arXiv:1803.00885
引用此論文 · BibTeX
引用資料對應所連結的論文版本,作者為原論文作者。
@misc{modelmergingnobarriers2018,
  title = {{Essentially No Barriers in Neural Network Energy Landscape}},
  author = {Felix Draxler and Kambis Veschgini and Manfred Salmhofer and Fred A. Hamprecht},
  year = {2018},
  eprint = {1803.00885},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1803.00885}
}
談神經網路的損失地形,最常見的畫面是一座座山谷。
訓練就是從某個地方滾下山,最後停在某個谷底。谷底有寬有窄,寬的谷底據說泛化比較好;不同的隨機種子會滾進不同的谷底,彼此之間隔著山脊。把兩個谷底的權重連一條直線,沿途的損失會先升後降,這也是很多人實際量過的結果。
海德堡大學的 Draxler、Veschgini、Salmhofer 與 Hamprecht 對這個畫面有不同的看法。作者群橫跨影像處理實驗室與理論物理研究所,他們從分子統計力學借來一個找反應路徑的工具,想看看兩個谷底之間能不能繞出一條不必翻山的路。
答案出乎意料。在 CIFAR 上的 ResNet 和 DenseNet,他們找到的路幾乎是平的。
幾乎在同一時間,Garipov 等人的模式連通也獨立得到相同的觀察。兩篇找路徑的方法完全不同。
定義問題
固定架構與訓練資料,損失只是參數 的函數 。拿兩組各自訓練到收斂的參數 、,我們想找一條從 走到 的連續路徑,讓沿途最高的損失盡可能低:
這條路徑叫做最小能量路徑(minimum energy path, MEP),路徑上的最高點就是兩個極小值之間真正的鞍點。
作者把「損失」和「能量」當同義詞用,這是物理學的習慣。損失地形上的谷底是穩定的狀態,鞍點則是兩個狀態之間必須翻過的障礙。
二維時可以把網格畫出來,用動態規劃找 MEP;但網路參數動輒上百萬維,只能從一條初始路徑出發,用局部資訊一點一點把它彎到低處。找到的路徑未必是精確的 MEP,它的最高點只能當作鞍點能量的上界。
所以這篇的邏輯是這樣的。只要我們能找到一條最高點很低的路,就證明了兩個極小值之間的障礙不會比這個值更高。
解決問題
彈簧串起來的樞紐點
先把路徑離散化。 個樞紐點(pivot) 串成一條鏈,頭尾固定在兩個極小值:、。
最直覺的做法,是把樞紐點之間用彈簧連起來,最小化
第一項把每個點往低處拉,第二項讓點與點之間保持距離。
問題在彈簧係數 。 太小,樞紐點會滑向低處,損失高的區域反而變得稀疏,偏偏我們最想量清楚的就是最高點。 太大,彈簧能量隨路徑總長平方成長,整條鏈被拉直,切過角落,錯過真正的鞍點。
Nudged Elastic Band
NEB(Nudged Elastic Band)用一個簡單的修改解決這個兩難。它把兩種力拆開,只留下各自有用的方向:
設 是樞紐點 的局部切線方向,
損失力只保留垂直於路徑的分量,負責把路徑往低處推;彈簧力只保留平行於路徑的分量,負責把點排均勻。這樣一來,高處的點不會順著路徑滑下去,彈簧也不會把路徑拉直。
切線方向的取法也有講究。 指向兩個鄰居中損失比較高的那一個,這個選擇能避免路徑出現折角,在鞍點附近的近似也比較好。
作者在實作上又往前一步。他們找不到一個在不同損失地形、不同樞紐點數量下都好用的 ,乾脆把彈簧力設成零,改成每一輪先把樞紐點沿路徑重新等距排好,再施加垂直方向的損失力。這種變體在文獻裡又叫 string method。
用一個二維小例子走一遍
神經網路的參數太多,沒辦法畫。我們換一個二維的地形來看 NEB 在做什麼:
第一項讓單位圓上的損失為零,第二項給圓周加一點傾斜,使 和 成為兩個極小值。兩點之間的直線經過原點,那裡的損失是 1;沿著圓周繞過去,最高點只有大約 0.1。
import numpy as np

def loss(p):
    x, y = p[..., 0], p[..., 1]
    return (x**2 + y**2 - 1) ** 2 + 0.1 * y**2

def grad(p):
    x, y = p[..., 0], p[..., 1]
    r = x**2 + y**2 - 1
    return np.stack([4 * r * x, 4 * r * y + 0.2 * y], axis=-1)

def redistribute(path):
    seg = np.linalg.norm(np.diff(path, axis=0), axis=1)
    s = np.concatenate([[0], np.cumsum(seg)])
    t = np.linspace(0, s[-1], len(path))
    return np.stack([np.interp(t, s, path[:, d]) for d in range(2)], axis=1)

a, b = np.array([-1.0, 0.0]), np.array([1.0, 0.0])
path = np.linspace(a, b, 12)               # 起點:直線上的 12 個樞紐點
path[1:-1, 1] += 0.05                      # 輕推一下,避免停在完全對稱的鞍點上
line_max = loss(np.linspace(a, b, 201)).max()

for step in range(2000):
    path = redistribute(path)              # 作者的做法:拿掉彈簧,每輪重新等距排好
    for i in range(1, len(path) - 1):
        lo, hi = path[i - 1], path[i + 1]
        tau = (hi - path[i]) if loss(hi) > loss(lo) else (path[i] - lo)
        tau /= np.linalg.norm(tau)
        g = grad(path[i])
        f_perp = -(g - (g @ tau) * tau)    # 只保留垂直於路徑的損失力
        path[i] = path[i] + 0.05 * f_perp

fine = np.concatenate([np.linspace(p, q, 20, endpoint=False) for p, q in zip(path[:-1], path[1:])] + [path[-1:]])
print(f"直線上的最高損失:{line_max:.3f}")
print(f"NEB 路徑的最高損失:{loss(fine).max():.3f}")
x, y = fine[loss(fine).argmax()] + 0.0
print(f"最高點位置:({x:.2f}, {y:.2f})")
直線上的最高損失:1.000
NEB 路徑的最高損失:0.098
最高點位置:(-0.00, 0.96)
直線上的障礙是 1.0;NEB 把中間的樞紐點往上推到圓周附近,障礙降到 0.098。這個值就是這個地形的鞍點能量。沿 求 的最小值,可以算出鞍點在 、。
切線那一行就是剛才說的規則:指向損失較高的鄰居。如果把 f_perp 換成完整的 -g,中間的點會順著圓周往兩端滑,最後全擠到兩個谷底附近,路徑最高處反而沒有點在量。
AutoNEB 與最小生成樹
在百萬維空間裡,一開始不知道要多少個樞紐點。AutoNEB 先用少量樞紐點跑幾輪 NEB,再檢查路徑:如果兩個相鄰樞紐點之間的損失,比兩端線性插值的估計高出「整條路徑能量差」的 20% 以上,就在那裡插入新的樞紐點。每對相鄰樞紐點之間另外評估 9 個點,用來發現這種漏掉的高峰。
AutoNEB 仍可能卡在局部的最小能量路徑上,得到一個偏高的鞍點。作者用一個不等式處理這個問題。已知 A 到 B、B 到 C 的路徑,把兩段接起來就是 A 到 C 的一條路,所以
這是一個超度量(ultrametric)性質。有了它,只要所有極小值透過已知路徑連成一張圖,每一對極小值之間的障礙就都有上界;某條路徑太高,也可以靠其他路徑繞過去替換掉。
作者因此把問題變成找最小生成樹。先把第一個極小值連到其他所有極小值,再反覆挑出樹上最高的那條邊,嘗試用 AutoNEB 在兩側子樹之間找一條更低的路。找到就換,找不到就放回去,直到每一對都算過或計算預算用完。每一條 AutoNEB 路徑的成本,大約相當於把網路完整訓練一次。
討論
實驗設定
每種架構訓練 10 個極小值,全部來自不同的隨機初始化。作者確認它們真的不一樣:ResNet 和 DenseNet 的任兩個極小值之間,測試集上被分錯的樣本最多只有 70% 重疊。
架構涵蓋三類:
- 無跳接的基本 CNN:寬度 12 到 96 個通道的單層 CNN,以及 48 通道的二層、三層 CNN。
- ResNet:ResNet-8、20、32、44、56,依原論文流程訓練 136 個 epoch。
- DenseNet:DenseNet-40-12 與 DenseNet-100-12-BC,訓練 266 個 epoch。
資料集是 CIFAR-10 與 CIFAR-100。AutoNEB 每對極小值跑 14 個 NEB 循環,用帶動量的 SGD,學習率從 0.1 分段降到 0.001。
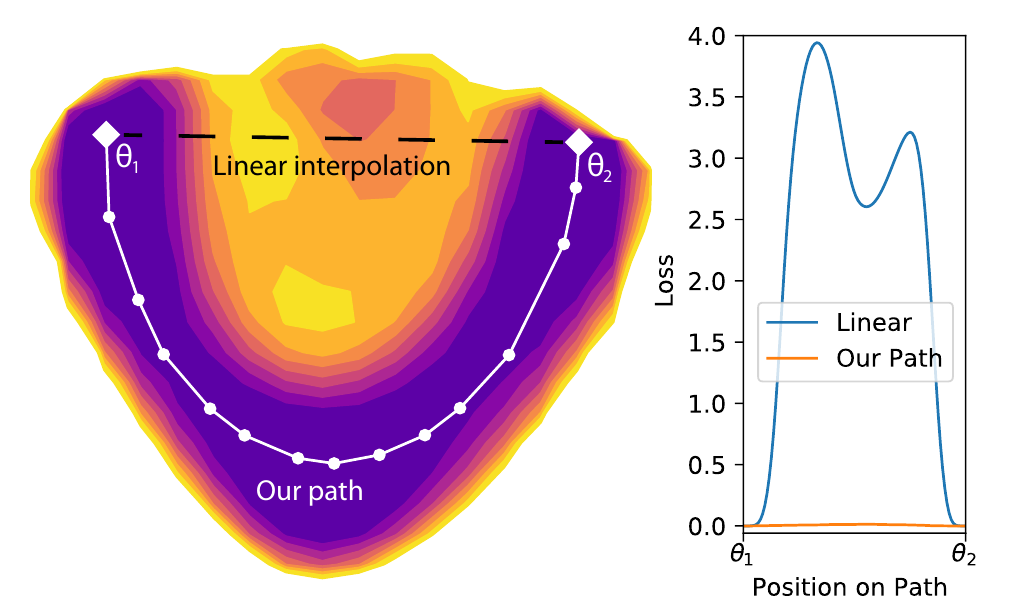
這張圖是一個百萬維損失函數的二維切面。直線在中間撞上一大片高損失區,最高接近 4;AutoNEB 找到的路徑從旁邊繞過去,整段損失幾乎沒有起伏。
鞍點有多低
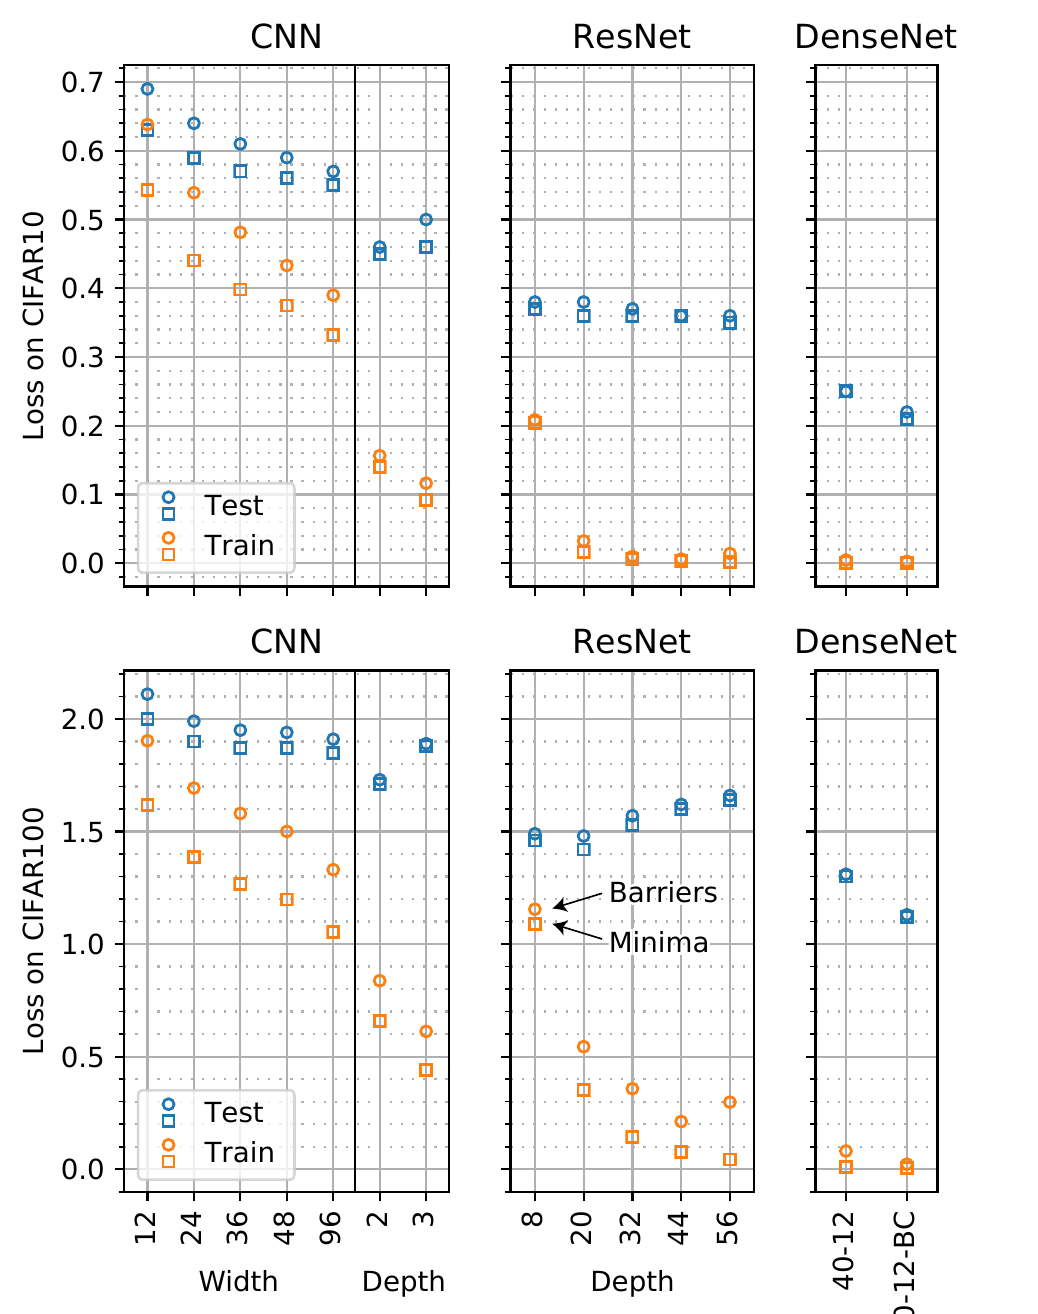
這張是全篇的核心結果。看法是比較同一顏色的方塊和圓點:方塊是極小值的平均損失,圓點是路徑上鞍點的平均損失,兩者越接近,代表障礙越低。
左邊的基本 CNN 可以看到趨勢。寬度從 12 增加到 96,訓練集鞍點逐漸往極小值靠;加深到兩層、三層,差距縮得更快。到了 ResNet 和 DenseNet,CIFAR-10 上的訓練鞍點幾乎貼著極小值。
附錄 Table B.1 給了數字。以 CIFAR-10 的 ResNet-56 為例,極小值的平均訓練損失是 0.0022,鞍點是 0.0141;DenseNet-100-12-BC 分別是 0.0005 和 0.0026。比例看起來差了好幾倍,但對照基準很重要。未訓練網路在 CIFAR-10 上的損失是 ,深層殘差網路的鞍點比這個值小了大約兩個數量級,也比同一個模型在測試集上的損失小一個數量級左右。
CIFAR-100 比較難,障礙也比較高。ResNet-56 的訓練損失從 0.0428 升到 0.2978,DenseNet-100-12-BC 從 0.0050 升到 0.0223;和隨機初始化網路約 4.6 的損失相比,差距仍然很小。
分類錯誤率的變化也不大。附錄列出,沿路徑最高的錯誤率,ResNet 比極小值多最多 0.7(CIFAR-10)與 2.9 個百分點(CIFAR-100),DenseNet 則是 0.4 與 1.5 個百分點。
另一個量法是看訓練曲線,損失要到哪個時候才降到鞍點以下。答案是很晚,所有架構都要等到第一次學習率衰減之後;多數 ResNet 和 DenseNet 甚至要到第二次衰減之後,也就是訓練的最後階段。換句話說,這些鞍點和「訓練到快結束時的模型」差不多好。
路徑長什麼樣子
路徑本身也很規矩。沿著路徑看個別參數相對於直線插值的偏離,每個座標都走得很平滑,最大的偏離集中在鞍點附近。整條路徑比兩點間的直線長 50% 到 2.5 倍。
作者在結論提出,這些路徑也許可以當成一個龐大的模型集成來用,因為路徑上的測試損失甚至略低一點。這個方向後來由 Garipov 等人的 FGE 做得更完整。
為什麼會這麼平
論文沒有證明,作者給了兩個定性的解釋。
第一個是韌性。現代網路每層有幾十到幾百個通道,還有跳接。對一個參數做小擾動,其他大量參數可以一起調整來彌補,所以模型能一步一步改變結構,損失卻不明顯上升。Dropout 與集成正是利用並強化這種韌性;網路能大幅壓縮而損失不明顯上升,也是同樣的原因。
第二個是冗餘,作者用 XOR 舉例。
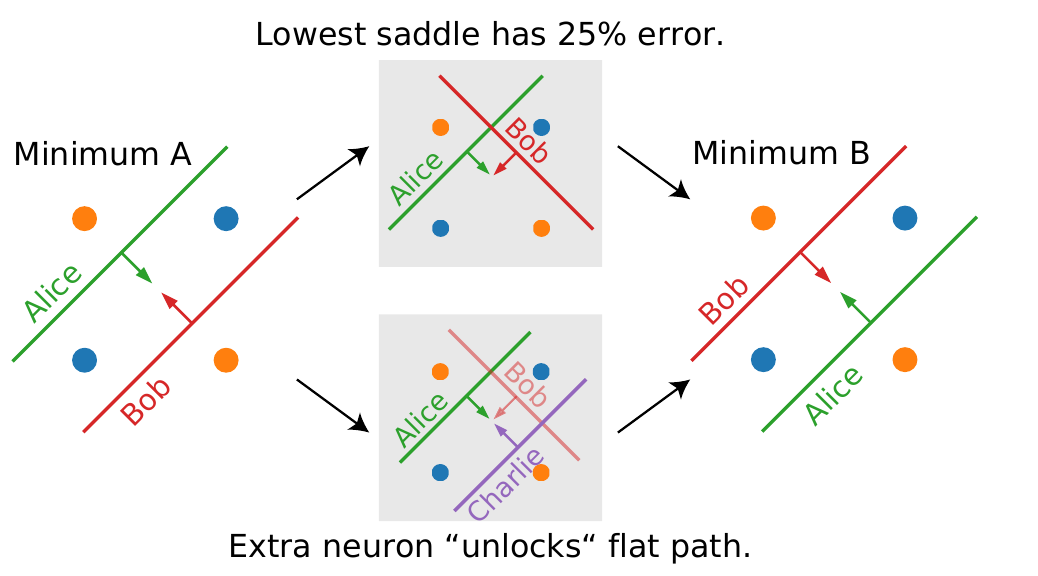
教科書上解 XOR 的兩層感知器,隱藏層有兩個神經元,作者叫它們 Alice 和 Bob。把兩人互換位置(下一層權重跟著交換),得到另一個等價的極小值。只有兩個神經元時,從 A 走到 B 的任何連續路徑,中途至少會分錯一個點,最低的鞍點有 25% 的錯誤率。
多加一個神經元 Charlie,就能安排一段接力。Charlie 先頂替 Bob,Bob 慢慢移到 Alice 的位置,Alice 再接手 Charlie 的工作,最後 Charlie 退場。只要下一層暫時忽略正在移動的那個神經元,全程都不會分錯。
這個例子把神經元互換(排列對稱)和額外容量連在一起。後來 Entezari 等人與 Git Re-Basin 一路追問的,正是排列對稱在障礙中扮演什麼角色。
限制
AutoNEB 找到的只是上界,作者也承認目前無法刻畫這個現象在什麼條件下成立。實驗只有 CIFAR-10/100 上的影像分類,模型最大到 DenseNet-100;每條路徑的成本接近完整訓練一次,所以每種架構只取 10 個極小值。
另一個容易混淆的地方是「連通」的形式。這篇證明的是存在一條彎曲的低損失路徑,直線插值仍然會撞上高峰。權重平均需要的是直線上沒有障礙,這是更嚴格的條件;後來的線性模式連通、排列對齊研究,處理的就是這一段距離。
結論
這篇論文把一個化學裡找反應路徑的工具帶進深度學習,對 ResNet 和 DenseNet 得到一個乾淨的觀察。兩個獨立訓練的極小值之間,存在一條幾乎不用爬坡的路;網路越寬、越深,這條路越平。
谷底的畫面因此要改一改,低損失區域更像是一整片相連的低地,各個極小值只是低地上的不同位置。
PyTorch 實作在 fdraxler/PyTorch-AutoNEB。真要拿來跑大模型之前,先想清楚預算,每連一對極小值,大概就是再訓練一次網路的時間。