原論文
Performance Measures and a Data Set for Multi-Target, Multi-Camera Tracking
- 発表先
- ECCV Workshops 2016ワークショップ
- arXiv への初回投稿
- arXiv:1609.01775
この論文を引用 · BibTeX
引用情報はリンク先の論文の版に対応し、原論文の著者を記載しています。
@misc{multiobjecttrackingidf12016,
  title = {{Performance Measures and a Data Set for Multi-Target, Multi-Camera Tracking}},
  author = {Ergys Ristani and Francesco Solera and Roger S. Zou and Rita Cucchiara and Carlo Tomasi},
  year = {2016},
  eprint = {1609.01775},
  archivePrefix = {arXiv},
  url = {https://arxiv.org/abs/1609.01775}
}
追跡論文のメインの表では、MOTA の隣にほぼ必ず IDF1 の列が並んでいる。
この指標は、マルチカメラ追跡の論文から生まれた。2016 年、デューク大学の Ergys Ristani、Carlo Tomasi と、イタリアのモデナ大学の Francesco Solera、Rita Cucchiara らは、この論文で三つのものを一度に提案した。新しい評価指標一式、当時最大のマルチカメラデータセット DukeMTMC、そして参照用の追跡システムだ。
その後の展開は少し意外なものだった。データセットは 2019 年に取り下げられ、参照システムに触れる人もほとんどいない。むしろ論文の中の指標のほうが、単一カメラ追跡の標準装備になった。
問題の定義
複数ターゲット・複数カメラ追跡(Multi-Target, Multi-Camera tracking、MTMC)では、カメラのネットワーク全体を通して、一人ひとりを追い続けなければならない。ある人が一台のカメラの画面から出ていき、どのカメラにも映らない死角を通って別のカメラの前に再び現れたとき、システムはそれがまだ同じ人だと見分けられなければならない。
空港の容疑者
著者らは空港の場面を使って、自分たちが測りたいものを説明している。
警備員がロビーで容疑者 A を見つけた。手元には選べる追跡システムが二つある。どちらのシステムも容疑者に ID 1 をつけ、保安検査場まで追っていく。
- システム甲は保安検査場で一回誤り、それ以降は容疑者を ID 2 としてしまう。誤りは一回だけだが、警備員はそこから容疑者を見失う。
- システム乙は保安検査を過ぎてから、ID 1 と ID 2 の間を何度も行き来する。ID は何回も入れ替わるが、保安検査場から搭乗口までの間に容疑者の位置を正しく示していた時間帯が何度もあり、正しかった時間の合計も長い。
警備員が選ぶのはシステム乙だ。最後に搭乗口で容疑者を捕まえられたのは、こちらのおかげだからだ。ところが CLEAR MOT の数え方では、システム甲は一回しか誤っておらず、システム乙は何回も誤っている。
著者らによれば、従来は複数物体追跡を「複数のターゲットを追い続けること」と定義してきたので、既存の指標はトラッカーが「どの種類の誤りをどれだけ頻繁に犯すか」を報告する。しかし利用者によっては、本当に気にしているのは「どの時刻でも、誰がどこにいるかわかるかどうか」だ。
著者らは、どちらの指標が優れているとも主張していない。CLEAR MOT のようなイベント単位の指標は、誤りがどこから来たかを示せるので、特定のコンポーネントを設計するエンジニアに向いている。スポーツ分析、警備、監視のように ID が何より重要な用途では、利用者に必要なのは ID 単位の指標で、どこで誤ったか、なぜ誤ったかは問わない。
一人に、二つの ID
まず、単一カメラ内の問題を見よう。
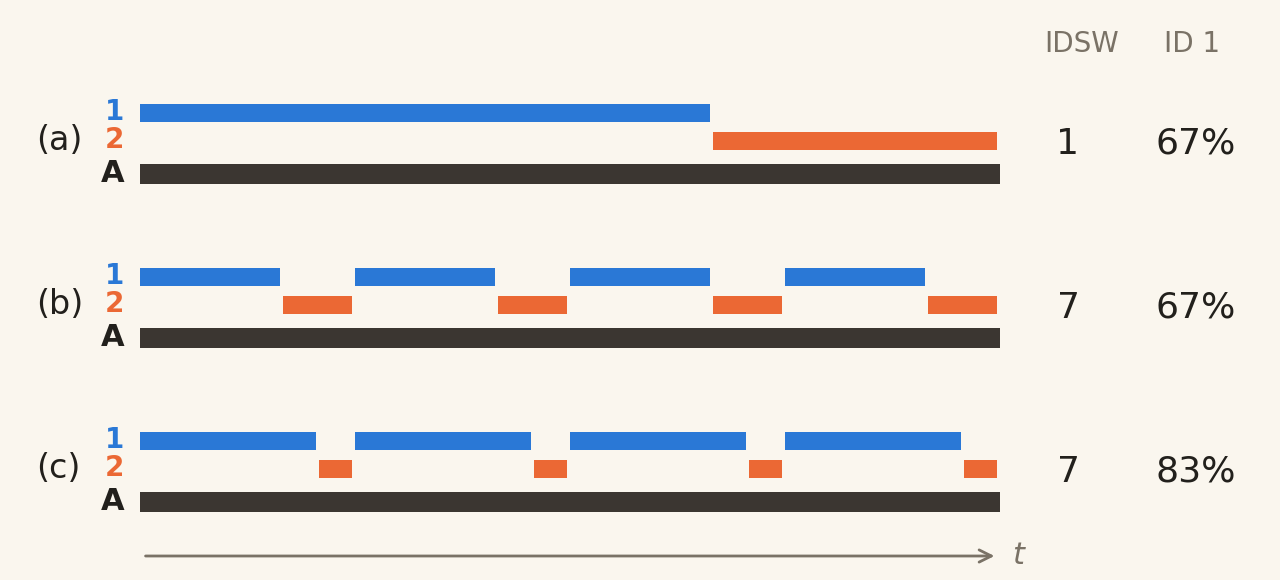
三つの場合のどれでも、トラッカーは一人の実在の人物 A を ID 1 と ID 2 に分けてしまった。
イベントを数える指標では、(a) は ID が一回入れ替わっただけで、(b) と (c) はどちらも 7 回入れ替わっている。だから (a) はほかの二つよりはるかに良く、(b) と (c) は同じくらい悪い。
著者らの考えでは、トラッカーが本当に犯した誤りは一種類だけで、一人を二人と見なしたことだ。この誤りがどれほど深刻かを測るには、評価の際にまず、A が ID 1 と ID 2 のどちらに対応すべきかを決めなければならない。対応がいったん決まれば、A が別の ID をつけられたフレームはすべて、トラッカーが誤ったフレームになる。
この選択をするのはトラッカーではなく評価する側なので、できるだけトラッカーに有利になるようにすべきだ。三つの場合のどれでも、A を ID 1 に対応させるのが最も有利だ。ID 1 が A の最も多くの部分を説明しているからだ。あとは、A のフレームのうちどれだけが ID 1 になっていないかを数えればよい。(a) と (b) はどちらも 33%、(c) は 17% だ。
この数え方では、(a) と (b) は同じくらい良く、(c) が最も良い。順位はイベントの計数とちょうど逆になる。トラッカーは (c) では 83% の時間 A がどこにいるかわかっているが、(a) と (b) では 67% しかない。
図の太線と細線を入れ替えれば、同じ推論がもう一種類の誤りにも当てはまる。二人の実在の人物が、トラッカーによって同じ ID にまとめられてしまう場合だ。そのときは、この計算された ID に対して、それが最も多くの部分を占める真の軌跡を選ぶ。
カメラが替わる瞬間
マルチカメラにはハンドオーバー(handover)の問題もある。
既存の指標は「ハンドオーバーの誤り」を別に数える。ある人がカメラ I からカメラ II へ移ったとき、システムが両側で違う ID をつけていれば、一回と記録する。それがハンドオーバーの誤りなのかカメラ内の誤りなのかは、軌跡がカメラ I の最後のフレームとカメラ II の最初のフレームでどの ID を得たかだけで決まる。
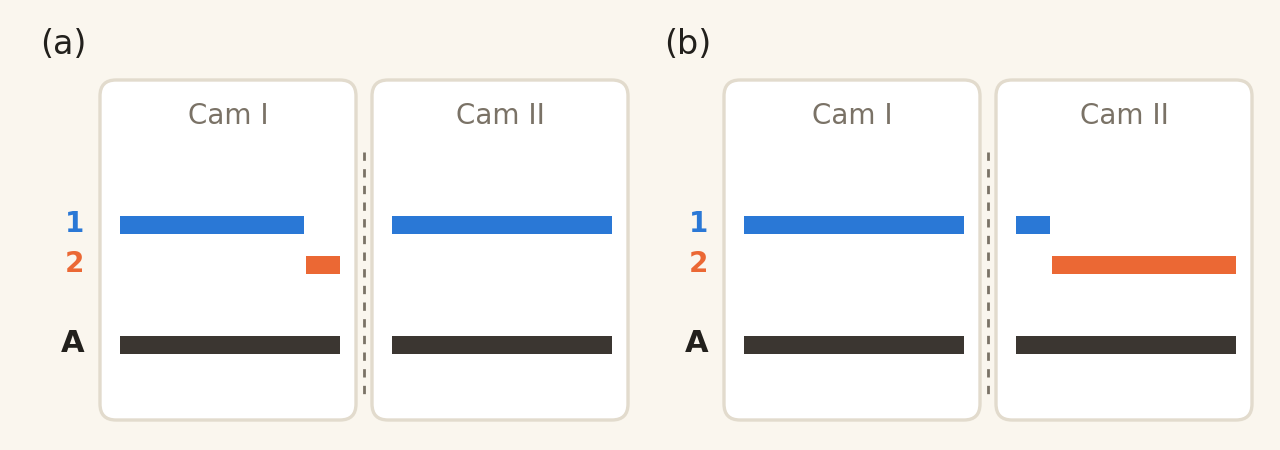
ハンドオーバー前後の二つのフレームだけを見ていると、結論はとても脆い。
- (a) ハンドオーバーは実は正しく、A は二台のカメラのどちらでも ID 1 と認識されている。カメラ I の終わりのごく一部が誤って ID 2 とされただけで、既存の指標はカメラ内の分裂とハンドオーバーの分裂を一回ずつ記録してしまう。
- (b) ハンドオーバーは実は誤っていて、A はカメラ II に入ってからほとんど ID 2 とされている。ところがカメラ II の冒頭のごく一部がたまたままだ ID 1 だったので、既存の指標はハンドオーバーが成功したとみなし、カメラ内の分裂を一回記録するだけだ。
著者らの新しい数え方では、(a) は誤ってラベル付けされたごく一部だけが罰せられ、(b) はカメラ II にいる軌跡のほぼ全体が罰せられる。
当時のマルチカメラ追跡でよく使われていた総合指標 MCTA は、検出の F1 スコア、カメラ内の誤り、ハンドオーバーの誤りの三項を掛け合わせる。これが問題をさらに深刻にする。上のような状況で、ある誤りがカメラ内の項からハンドオーバーの項へ移っただけで、スコアへの影響が劇的に変わってしまう。その誤りに掛けられるのが、ほかの二項の値だからだ。著者らも、掛け算で組み合わせる理由ははっきりしないと率直に述べている。
さらに、MOTA そのものもマルチカメラには向かない。 台のカメラにまたがり、全部で フレームある軌跡では、隣り合う二フレームを結ぶリンクのうち、カメラをまたぐものはおよそ 個しかなく、カメラ内のものは 個ある。しかも は よりはるかに小さい。カメラをまたいで人を取り違えても、MOTA ではほとんど見えない。
問題を解く
著者らは、誤りが何回起きたかを数えるのをやめ、トラッカーがどれだけ長い時間人を正しく認識できたかを数えることにした。
軌跡全体で、一対一に対応付ける
第一段階では、真の ID と計算された ID を組にする。
ここでの対応付けの単位は軌跡全体で、しかも一対一だ。一本の真の軌跡には一本の計算された軌跡しか対応させられず、その逆も同じだ。選ぶ基準は、誤って対応したフレームの数が、全データで合計して最小になることだ。
著者らはこれを二部グラフのマッチング問題として書いた。左側に真の軌跡 をすべて、右側に計算された軌跡 をすべて置く。さらに、計算された軌跡ごとに左側へ「誤検出」の身代わり を一つ、真の軌跡ごとに右側へ「検出漏れ」の身代わり を一つ加える。この二種類の身代わりがあるので、ある軌跡を誰とも対応させないこともできる。その代わり、その軌跡のフレームはすべて誤りと数えられる。
二本の軌跡があるフレームで「合わない」ことを、 と書く。画像上では、二つのボックスの IoU が より小さければ合わないとみなす。地面の座標では、二つの位置が 1 メートルより離れていれば合わないとみなす。身代わりと対応させたときは、相手側のフレームはすべて合わないとみなす。
組 のコストは、それによって生じる検出漏れのフレーム数と誤検出のフレーム数の和だ。
と は、それぞれ二本の軌跡が現れるフレームだ。
コスト最小の一対一の対応を解いたら、各フレームの結果は三種類に分かれる。
- IDTP: 対応させた真の軌跡と計算された軌跡が、同じフレームで実際に合っている。
- IDFN: 真の軌跡のあるフレームが、対応させた計算された軌跡と合っていない(そもそもどの軌跡とも対応していない場合を含む)。
- IDFP: 計算された軌跡のあるフレームが、対応させた真の軌跡と合っていない(そもそも対応していない場合を含む)。
三つのスコア
この三つの計数があれば、ふつうの適合率と再現率がそのまま使える。
IDP は計算されたボックスのうち ID が正しくつけられた割合、IDR は真のボックスのうち ID が正しく認識された割合だ。IDF1 は両者の調和平均で、「ID が正しくつけられたボックスの数を、真のボックスの数と計算されたボックスの数の平均で割ったもの」と読むこともできる。
一度計算してみる
小さな例で一通りたどってみよう。画面には二人の人物 、 がいて、10 フレームにわたって現れる。トラッカーは二本の軌跡 、 を出力し、どのフレームでも検出は正確だが、二本の軌跡は途中で一回入れ替わっている。
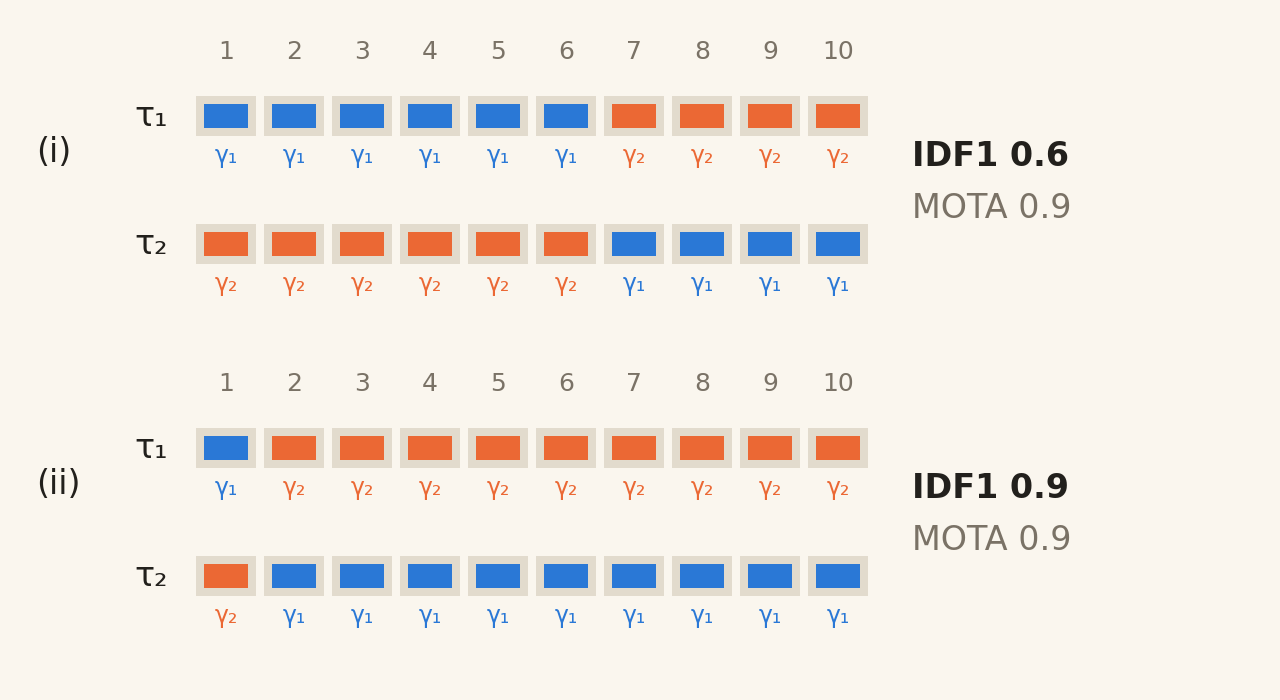
まず上半分の場合 (i) を見よう。7 フレーム目で入れ替わる。 を に対応させると、 は 7 から 10 フレーム目で と合わないので検出漏れが 4 フレーム、 は 7 から 10 フレーム目で のほうに合ってしまうので誤検出が 4 フレームで、コストは 8 だ。 に対応させると、それぞれ 6 フレームずつ誤ってコストは 12。身代わりと対応させるとさらに高くつき、軌跡全体の 10 フレームがすべて誤りになる。コスト表の全体は次のとおりだ。
| 8 | 12 | 10 | — | |
| 12 | 8 | — | 10 | |
| 10 | — | 0 | 0 | |
| — | 10 | 0 | 0 |
本稿で整理。「—」は二つのノードの間に辺がないことを示す。身代わりどうしを対応させるコストは 0。
コスト最小の対応は 、 で、総コストは 16 だ。したがって IDFN = 8、IDFP = 8 で、二人合わせて 20 フレームなので IDTP = 20 − 8 = 12 となる。
同じ例を CLEAR MOT で計算すると、検出漏れも誤検出もなく、7 フレーム目で二人がそれぞれ一回仮説を替えるので誤対応が 2 回、MOTA だ。
次に下半分の場合 (ii) を見る。入れ替わりは 2 フレーム目まで早まる。MOTA は同じく 0.9 で、誤対応はやはり二回だ。IDF1 のほうでは、最良の対応は 、 に変わり、二人ともそれぞれ 9 フレームが合うので IDTP = 18、IDF1 = 0.9 になる。ちょうど 6 フレーム目で入れ替わると前後 5 フレームずつになり、IDF1 は最低の 0.5 まで下がる。
CLEAR MOT の著者らは、「同じ一回の入れ替わりが早く起きたか遅く起きたか」で減点が変わらないようにわざわざ設計し、その逆のやり方を直感に反すると呼んだ。IDF1 はちょうどその逆だ。入れ替わりの時点によって、トラッカーが ID を誤ってつけていた時間の長さが決まり、それこそが IDF1 の測りたいものなのだ。
二つの指標の食い違いは、はじめから意図されたものだ。
CLEAR MOT との違い
著者らは両者を並べて比べている。
- 対応付けの範囲。 CLEAR MOT はフレームごとに対応付け、前のフレームの組み合わせはしきい値内にある限り引き継ぐ。各フレームでは一対一だが、動画全体で見ると、一人の実在の人物が次々に何本もの軌跡と対応することがあり、多対多になる。IDF1 は動画全体で一度だけ対応付け、最初から最後まで一対一だ。
- 「分裂」という概念がない。 全体で一度しか対応付けないので、「ID の入れ替わり」というイベントは数えようがない。各フレームが正しい ID で説明されているかどうかを調べるだけだ。
- 誤りの単位。 IDF1 はフレームを数えるだけで、距離を混ぜない。著者らの理由は、二値の計数とユークリッド距離を混ぜてしまうと、あるトラッカーが「ID を長く正しく認識している」のか「位置を近くで追えている」のか区別できなくなる、というものだ。
著者らはこの対応付けの性質を三つにまとめている。一対一であること、トラッカーにとって最も有利であること、すべての誤りが同じ通貨であることだ。視野が重なるカメラも重ならないカメラも、まったく同じやり方で扱う。
カメラをまたぐのがどれだけ難しいかを本当に知りたければ、著者らはそのやり方も示している。対応付けを二回行うのだ。一回はすべてのカメラのデータをまとめて、もう一回はカメラごとに別々に対応付けてから誤りを合計する。前者の誤りの数は必ず後者以上になり、両者の差が、カメラをまたぐ関連付けで余分に犯した誤りだ。
DukeMTMC
論文の二つ目の貢献はデータセットだ。
同期した八台の固定カメラをデューク大学のキャンパスに設置し、授業の合間の人通りが多い時間帯に録画した。各カメラ 1 時間 25 分、解像度 1080p、毎秒 60 フレームで、合計 10 時間以上、200 万フレームを超える。映っているのは 2,834 人の異なる人物と 6,791 本の単一カメラの軌跡で、一人あたりの単一カメラの軌跡は平均 2.5 本、最大 7 本だ。
何が難しいのかは、いくつかの数字を見ればわかる。
- 単一カメラの 1 フレームあたりの人数は、カメラによって 0 人から 54 人。
- ハンドオーバーは全部で 4,159 回あり、同時に最大 50 人が死角にいる。
- 遮蔽(重なり 50% 以上)が 1,800 回を超え、平均 60 フレーム続く。
- 891 人は一台のカメラの前にしか現れない。異なるカメラの人を誤って結びつけがちなトラッカーにとっては試練だ。
- ほとんどのカメラは視野が重ならず、重なる小さな領域があるのは二組のカメラだけで、そこを約 100 人が通る。
アノテーションは、各人の足が地面に接する点の軌跡だ。五人が一年かけて、自作のインターフェースで 10 万近いキーポイントをつけ、それを各フレームに補間した。画像上のボックスは半自動で生成している。各カメラの最初の 5 分を訓練と検証に、残りの 80 分をテストに使う。
著者らは比較表に、当時知られていた十数個のマルチカメラデータセットを並べているが、ID の数が最も多いものでも 255 個しかない。DukeMTMC の 2,834 個の ID は、それまでのすべてのデータセットを合わせたよりも多く、録画時間も最も長く、フレームレートも最も高い。
データ量が多ければ計算量も多い。著者らによると、標準的なアルゴリズムですべての前景マスクを計算するのに単一のマシンで 6 日、DPM 検出器ですべての検出を走らせるのに 192 コアのクラスタで 7 日かかった。
著者らは限界も挙げている。屋外の場面が一つしかないこと、カメラが固定であること、曇り空の柔らかい光で追跡が比較的易しくなっているかもしれないこと、視野がほとんど重ならないので、重なる視野に頼る手法には不利なことだ。
このデータセットはその後広く使われ、人物再識別向けの DukeMTMC-reID も派生した。2019 年、デューク大学はデータセットのウェブサイトを取り下げた。デューク大学の学生新聞の報道によると、大学側は、データセットの公開が承認された研究計画から大きく逸脱していたとし、再公開するつもりはないとしている。
参照システム
三つ目の貢献は参照用のマルチカメラトラッカーで、Ristani と Tomasi が以前に作った単一カメラのシステムを拡張したものだ。
このシステムは観測を階層的にまとめていく。まず検出を短い軌跡の断片にまとめる。単純な運動モデルが使えるほど短い断片だ。次に断片を単一カメラの軌跡にまとめ、最後に各カメラの軌跡をつないでカメラをまたぐ ID にする。どの階層も一つのグラフで、ノードは観測、辺の重みは −1 から 1 の間の値をとり、二つの観測が同一人物であることを示す証拠の強さを表す。ノードをクラスタに分け、同じクラスタ内の重みの合計を最大にするのは相関クラスタリング(correlation clustering)問題で、二値整数計画法で解く。
この問題は NP-hard で、近似も難しい。だからこそいくつもの階層に分けて、各部分問題を十分小さくしている。時間方向にはスライディングウィンドウを使い、終わりのない動画を処理する。
既存の NLPR MCT の四つのデータセットで、慣例どおり真の単一カメラ軌跡を与えてカメラ間の関連付けだけを比べ、MCTA で評価すると、このシステムは六つの手法の中で平均二位だった。
議論
二種類の指標は別のものを測っている
著者らは DukeMTMC で参照システムを走らせ、真の軌跡一本ごとの ID 再現率と ID 適合率が、その軌跡に記録された分裂や併合の回数と関係があるかどうかを調べた。四組の相関係数はそれぞれ −0.24、−0.05、−0.38、−0.41 で、どれも相関は弱い。
つまり、ある軌跡に分裂や併合が何回記録されたかからは、その ID がどれだけの時間正しく認識されていたかを推測しにくい。イベント型の指標と ID 型の指標は、確かに別のものを測っている。
ハンドオーバーの問題は理論だけの話ではない
先ほどの二種類のハンドオーバーの反例は、実際の結果でどれくらいよく起きるのか? 参照システムはデータセット上で合計 5,549 回のハンドオーバーを行い、そのうち約 74%(4,119 回)では、ハンドオーバーの近くに短い軌跡があって、従来の指標と新しい指標の判断がはっきり食い違った。
| 状況 | 回数 | 割合 |
|---|---|---|
| 実は正しいハンドオーバーが分裂と記録される | 1,692 + 738 | 30.5% + 13.3% |
| 実は正しいハンドオーバーが併合と記録される | 1,065 + 496 | 19.2% + 8.9% |
| 実は誤ったハンドオーバーが分裂と記録されない | 70 | 1.3% |
| 実は誤ったハンドオーバーが併合と記録されない | 58 | 1.0% |
原論文 Figure 5 をもとに整理。割合は全 5,549 回のハンドオーバーに占める百分率。上の二行は、それぞれ図の二つの状況を合わせたもの。
食い違いの大部分は、「ハンドオーバーはちゃんとできていたのに、従来の指標に罰せられた」ケースだ。
同じシステム、二通りの順位
最後に、著者らは参照システムの DukeMTMC テストセットでの成績を、ベースラインとして示している。
| カメラ | MOTA | IDP | IDR | IDF1 |
|---|---|---|---|---|
| 1 | 37.36 | 79.17 | 44.97 | 57.36 |
| 2 | 49.17 | 69.11 | 63.78 | 66.34 |
| 3 | 53.50 | 81.46 | 55.11 | 65.74 |
| 4 | 55.92 | 79.23 | 61.16 | 69.03 |
| 5 | 73.09 | 84.86 | 67.97 | 75.48 |
| 6 | 12.94 | 48.35 | 43.71 | 45.91 |
| 7 | 62.03 | 85.23 | 67.08 | 75.07 |
| 8 | 36.98 | 90.54 | 35.86 | 51.37 |
原論文 Table 3 の下半分をもとに整理。単一カメラの結果。FP、FN、ID スイッチ、MT、ML などの列は省略。
二つの指標は、カメラの難しさの判断が一致しない。MOTA で見るとカメラ 3 はカメラ 2 より易しいが、IDF1 で見るとむしろカメラ 2 のほうがわずかに良い。カメラ 6 と 7 の差はもっとはっきりしている。MOTA では 50 ポイント近く(12.94 対 62.03)の差があるのに、IDF1 では 29 ポイント(45.91 対 75.07)しか違わない。著者らによれば、実際に追跡結果を見ても、カメラ 6 は MOTA が言うほどひどくはない。
カメラ 8 にも注目したい。IDP は 90.54 と高いのに、IDR は 35.86 しかない。つけられた ID はほとんど正しいが、多くの人がそもそも認識されていない。こうしたトレードオフは、IDF1 という一つの数字だけでは見えない。著者らが適合率と再現率もあわせて示しているのは、そのためだ。
すべてのカメラをまたいだ結果では、IDP、IDR、IDF1 はそれぞれ 52.35、36.46、42.98 だ。表にはほかに上限と記されたカメラ間の数字の行もあり、その IDF1 は 59.77 だ。
結論
この論文は空港の例を使って、「どれだけ頻繁に誤るか」と「どれだけ長い時間、人を正しく認識できるか」という二つのことを切り分けた。IDF1 は動画全体で真の ID と計算された ID を一対一に対応付け、その対応付けをできるだけトラッカーに有利にしたうえで、何フレームで ID が正しく認識されたかを数える。すべての誤りは、カメラ内で起きたかハンドオーバーで起きたかにかかわらず、フレーム単位で値付けされる。
CLEAR MOT との食い違いは意図的なものだ。CLEAR MOT は、一回の入れ替わりは一回の誤りであって、早く起きたか遅く起きたかで差をつけるべきではないと考える。IDF1 は、入れ替わりが早く起きたなら、トラッカーはそれだけ長い時間、人を取り違えて報告していたと考える。どちらの見方もそれぞれ妥当な問いに答えていて、著者らもどちらかを置き換えるつもりはない。
その後 MOTChallenge は IDF1 をリーダーボードに載せ、MOTA と並べた。さらに四年後、HOTA は IDF1 が反対の極端に振れていると指摘した。ほとんど関連付けのことしか気にかけず、検出の良し悪しはスコアにあまり反映されない、と。
空港に話を戻そう。警備員が欲しいのは、そもそも「何回誤ったか」ではない。搭乗口の前で、システムが画面を指して「あそこにいる」と言えるかどうかだ。